


Anreicherungsaufgaben sind autonome Agenten in Knowledge Catalog, die Data Stewards und Plattform-Engineers dabei unterstützen, ihre Metadatenvorgänge zu skalieren. Bei einer Anreicherungsaufgabe werden Ihre Datenschemas kontinuierlich analysiert, Ihre Unternehmensdokumentation gelesen und vorgeschlagene Beschreibungen für Ihre Daten-Assets generiert. Damit Sie Anreicherungsaufgaben optimal nutzen können, müssen Sie mit den wichtigsten Konzepten von Knowledge Catalog und der Datenarchitektur Ihrer Organisation vertraut sein.
Durch die Automatisierung der Metadatengenerierung reduzieren Anreicherungsaufgaben den Aufwand für die manuelle Kuratierung und sorgen gleichzeitig dafür, dass Ihr Katalog den genauen, geschäftsspezifischen Kontext widerspiegelt.
Vorteile von Anreicherungstasks
Anreicherungsaufgaben lösen das Problem, große Data Catalogs korrekt und auf dem neuesten Stand zu halten.
| Aspekt | Herkömmlicher Ansatz | Knowledge Studio-Ansatz |
|---|---|---|
| Prozess | Handschriftliche Beschreibungen. Stewards überprüfen manuell Tausende von Tabellen und befragen Domainexperten. | Agentengesteuert. Ein autonomer Agent analysiert Daten und liest Standardbetriebsverfahren. |
| Geschwindigkeit und Skalierbarkeit | Langsam und schwierig zu pflegen, da sich Schemas im Laufe der Zeit ändern. | Hoch skalierbar. Es werden kontinuierlich hochwertige Metadatenvorschläge generiert. |
| Menschlicher Aufwand | Hoch. Umfangreiche manuelle Dateneingabe und laufende Wartung. | Niedrig. Data Stewards müssen die generierten Vorschläge nur prüfen und genehmigen. |
Anwendungsfälle für Anreicherungsaufgaben
Mit Anreicherungsaufgaben können Organisationen die folgenden häufigen Metadatenprobleme lösen:
Integration von Akquisitionen: Ein Unternehmen erwirbt eine neue Geschäftseinheit mit Tausenden von nicht dokumentierten Daten-Assets. Data Engineers richten eine Anreicherungsaufgabe auf das neue Dataset aus und verwenden die Datenverzeichnisse des übernommenen Unternehmens als Wissenssignal. Der Agent schlägt geschäftsorientierte Beschreibungen für das gesamte Dataset in Stunden statt Monaten vor.
Kontinuierliche Dokumentation: Ein Plattformentwicklungsteam erstellt ein dynamisches Lakehouse, in dem sich Schemas täglich ändern. Sie konfigurieren eine Anreicherungsaufgabe, die täglich mit aktivierter automatischer Veröffentlichung ausgeführt wird, damit der Katalog immer die neuesten Schemaänderungen widerspiegelt.
Semantische Governance: Ein zentrales Datenbüro möchte die Terminologie in allen Abteilungen standardisieren. Sie stellen eine Anreicherungsaufgabe bereit, die auf ein kuratiertes Knowledge Catalog-Glossar verweist. Der Agent kennzeichnet automatisch alle Tabellenbeschreibungen, die gegen die genehmigten Begriffe des Unternehmensglossars verstoßen, und schlägt Überschreibungen vor.
Wichtige Konzepte
Wenn Sie eine Anreicherungsaufgabe konfigurieren, definieren Sie die folgenden Kernkomponenten:
- Anreicherungstask
-
Die Konfiguration, die definiert, was der Agent tun muss. Eine Aufgabe enthält die von Ihnen ausgewählte Kontextgruppe, Zielressourcen, den Zeitplan und alle von Ihnen bereitgestellten Wissenssignale.
Beispiel: Eine Aufgabe, die den Agenten anweist, jeden Sonntag um Mitternacht Ihre GitHub-Repositories zu lesen und Ihr
finance-Dataset anzureichern. - Anreicherungsjob
- Der Backend-Orchestrierungsprozess in Knowledge Studio, der eine Anreicherungsaufgabe ausführt.
- Anreicherungsausführung
-
Eine einzelne Ausführungsinstanz einer Aufgabe zu einem bestimmten Zeitpunkt. Die Knowledge Studio-Konsole enthält den Tab Jobs, auf dem die bisherigen Ausführungen für eine Aufgabe aufgeführt sind. Sie können eine bestimmte Ausführung öffnen, um die generierten Metadatenvorschläge zu prüfen.
Beispiel: Die spezifische Ausführungsinstanz, die am 24. Oktober aufgetreten ist und zu 15 vorgeschlagenen Spaltenänderungen geführt hat.
- Kontextset
-
Ein begrenzter Container mit Zieldaten-Assets und Metadaten. Jede Anreicherungsaufgabe muss so konfiguriert sein, dass sie genau auf einen Kontextsatz abzielt. Der Kontextsatz kann Zielressourcen wie ein BigQuery-Dataset oder ein Lakehouse enthalten. Sie können aber auch einen leeren Kontextsatz erstellen, wenn noch keiner vorhanden ist.
Beispiel: Ein Marketingkontext-Set, das Ihre Kampagnentabellen, ROAS-Messwerte und Terminologieglossare logisch in einer einzigen KI-Kontextgrenze zusammenfasst.
- Wissenssignale
- Externe Materialien, die den Agenten in die Realität Ihres Unternehmens einbinden. Wenn Sie Cloud Storage-Buckets mit Datenwörterbüchern, Knowledge Catalog-Glossaren oder URLs für interne Dokumentation bereitstellen, verwendet der Agent Ihre spezifische Geschäftslogik, anstatt allgemeine Vermutungen anzustellen.
- Bewertungs-Datasets
-
Testfragen und entsprechende SQL-Abfragen (im
.jsonl-Format), die zur Bewertung der Accuracy des KI-Agenten verwendet werden. Wenn der Agent neue Metadaten vorschlägt, führt er diese Testfragen für die Vorschläge aus, um sicherzustellen, dass die Genauigkeit vor der Veröffentlichung nicht sinkt.Beispiel: Sie stellen eine Testfrage wie „Wie hoch ist unser MRR?“ zusammen mit der genauen SQL-Abfrage, die zur Berechnung des monatlich wiederkehrenden Umsatzes erforderlich ist. Wenn der Agent verwirrende Metadaten vorschlägt, die dazu führen, dass diese Testabfrage fehlschlägt, wird der Vorschlag gekennzeichnet.
- Quellen für eigenständiges Lernen
-
Live-Konversationsprotokolle aus Ihren Gemini Enterprise-Apps oder BigQuery Agent Analytics. Der Agent liest diese Chatprotokolle, um herauszufinden, wonach Nutzer fragen, erkennt Wissenslücken und schlägt automatisch neue Metadaten vor, um diese Lücken zu schließen.
Wenn aus Chatprotokollen beispielsweise hervorgeht, dass Nutzer häufig fragen: „Was bedeutet Statuscode 42?“ und der Agent nicht antwortet, löst das selbstständige Lernen einen Metadatenvorschlag aus, um diesen fehlenden Statuscode zu dokumentieren.
Unterstützte Datenquellen und Integrationen für Anreicherungsaufgaben
Anreicherungsaufgaben können sowohl in Google Cloud als auch in Drittanbietersysteme eingebunden werden.
Zieldaten-Assets
Der Anreicherungs-Agent kann die folgendenGoogle Cloud -Zieldaten-Assets direkt anreichern und Ihren Kontext-Sets hinzufügen:
BigQuery-Datasets, -Tabellen und -Ansichten
Lakehouse-Lakes, -Zonen und -Assets
Über die Lakehouse-Integration unterstützt Knowledge Studio indirekt die Anreicherung von Metadaten aus Drittanbieterquellen, die über Iceberg REST Catalog-Integrationen (z. B. Databricks Unity, Snowflake Horizon, AWS Glue Data Catalog und SAP Geschäftsdaten-Cloud) verbunden sind.
Wissenssignale
Während eines Anreicherungslaufs extrahiert der Agent semantische Regeln, Geschäftskontext und Fachwissen aus den folgenden Quellen mit Lesezugriff:
Google Cloud:
- Cloud Storage-Buckets mit unterstützten Dateiformaten (z. B. PDFs, CSVs, Markdown, Konfiguration, Datasets und unstrukturierte Textdateien)
- Knowledge Catalog-Unternehmensglossare im selben regionalen Bereich
- Google Workspace-Anwendungen, einschließlich Google Drive-Dateien (z. B. Dokumente, Tabellen, Präsentationen, PDFs, Dateien und allgemeine Textdokumente)
Drittanbietersysteme (nicht Google Cloud):
- Microsoft SharePoint-Dateien unter 5 MB (z. B. PDFs, Office-Dateien und allgemeine Textdokumente, ausgenommen Legacy-Formate oder Bilder)
- GitHub-Repositories (jede Datei, die lesbaren Text enthält)
- Atlassian Confluence-Seiteninhalte
Quellen für eigenständiges Lernen
Um Wissenslücken aus echten Interaktionsprotokollen zu identifizieren, extrahiert der Anreicherungs-Agent Trajektorien aus den folgenden Quellen:
- Gemini Enterprise-Anwendungen
- BigQuery Agent Analytics-Tabellen
- Cloud Logging mit Logansichten mit eingeschränktem Bereich
Funktionsweise des Anreicherungs-Agenten
Wenn Sie eine Anreicherungsaufgabe auslösen – entweder on demand oder nach einem wiederkehrenden Zeitplan –, wird ein Anreicherungslauf gestartet. Der Anreicherungs-Agent wird asynchron im Hintergrund ausgeführt und analysiert Ihre Daten-Assets, Abfrage-Traces und Dokumentation, um verifizierte Metadatenvorschläge zu erstellen.
Das folgende Diagramm zeigt die allgemeine Workflow-Architektur eines Anreicherungs-Agenten:
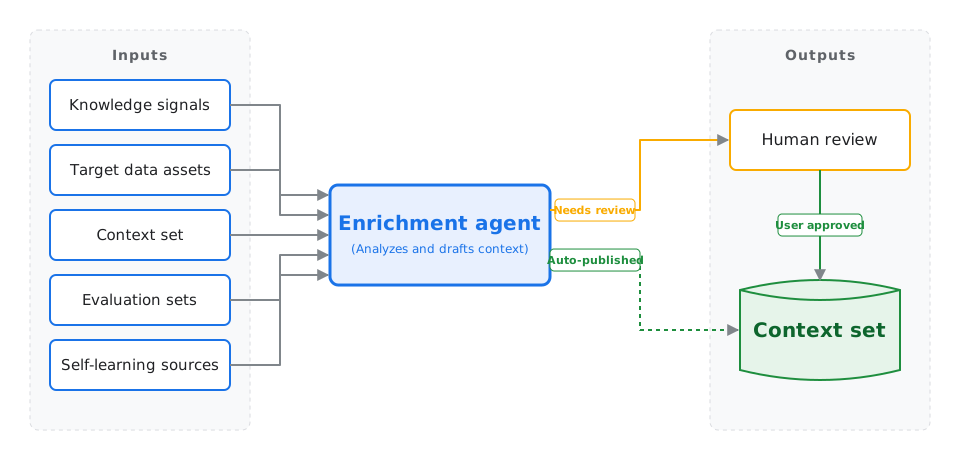
Der KI-Agent verwaltet Ihren Kontextsatz in vier wichtigen Phasen:
- Signale und Dokumentation analysieren: Der KI-Agent durchsucht Interaktionsprotokolle, um herauszufinden, wo nachgelagerte KI-Agenten Probleme hatten oder eine Mehrdeutigkeitsauflösung erforderlich war. Es scannt Unternehmensdokumente in Cloud Storage oder verknüpften Drittanbieter-Apps und untersucht den Abfrageverlauf, um häufige Tabellenverknüpfungen und Upstream-Abhängigkeiten zu ermitteln.
- Kontextvorschläge entwerfen: Der Agent entwirft basierend auf Ihrem Kuratierungsziel strukturierten Kontext für Ihre Ziel-Assets. Dazu gehören geschäftsorientierte Tabellenübersichten, formale Messwertformeln, verifizierte Join-Bedingungen und SQL-Abfragevorlagen, die auf Golden Parameters basieren.
- Benchmarking und Optimierung: Der Agent testet seine eigenen Metadatenentwürfe iterativ anhand der Testfragen aus Ihrem Bewertungssatz und verfeinert die Beschreibungen, bis die Genauigkeit der nachgelagerten Abfragen maximiert ist. Anschließend werden zurückgehaltene Testabfragen ausgeführt, um eine Regressionsfehlerrate zu berechnen. Jedem vorgeschlagenen Beschreibungs- oder Messwertregel wird ein Konfidenzwert zugewiesen.
- Überprüfungsrichtlinien anwenden: Vorschläge, die den Konfidenzschwellenwert erreichen, lösen Ihre Richtlinienregeln aus. Wenn Sie die automatische Veröffentlichung aktiviert haben und die Regressionsfehlerrate innerhalb des zulässigen Limits liegt, werden die Änderungen automatisch zusammengeführt. Wenn der Regressionsfehler den zulässigen Schwellenwert überschreitet, wird die automatische Veröffentlichung sofort beendet und alle Vorschläge werden in einer einzigen Änderungsanfrage zusammengefasst, die manuell überprüft werden muss.
Datensicherheit und Governance
Da bei Knowledge Studio-Anreicherungsaufgaben künstliche Intelligenz verwendet wird, um Ihre Datenschemas und interne Dokumentation zu analysieren, werden auf der Plattform strenge Grenzen implementiert, um Ihre proprietären Informationen zu schützen.
Foundation-Model-Training: Ihre Daten bleiben Ihre Daten. Ausführungs-Traces, Datenbankschemas und bereitgestellte Wissenssignale (z. B. Dokumente oder interne Glossare) von Kunden werden niemals zum Trainieren der Foundation Models von Google verwendet.
Datenbereinigung: Bevor vorgeschlagene Metadaten in einen Kontextsatz geschrieben werden, entfernt der Agent automatisch personenidentifizierbare Informationen aus Systemprotokollen und Generierungs-Traces.
Ausführungsgrenzen: Der Anreicherungs-Agent wird in einem sicheren, von Google verwalteten Mandanten ausgeführt. Ihre privaten Datenquellen werden über eine Private Service Connect-Schnittstelle und einen vom Kunden gesteuerten Proxy für ausgehenden Traffic sicher erreicht.
Compliance-Status: Während der aktuellen Vorschauphase werden VPC Service Controls (VPC-SC), vom Kunden verwaltete Verschlüsselungsschlüssel (CMEK) und Assured Workloads nicht von Anreicherungsaufgaben unterstützt.
Empfohlene Konfigurationen
Knowledge Catalog bietet mehrere optionale Einstellungen für Anreicherungsaufgaben. Wir empfehlen, mit einer einfachen Konfiguration zu beginnen und nach und nach erweiterte Funktionen zu aktivieren, wenn Sie Ihre Metadatenvorgänge skalieren.
| Konfiguration | Enthaltene Komponenten | Automatisch veröffentlichen | Empfohlen für |
|---|---|---|---|
| Basic | Kontextset | Deaktiviert | Testen des Tools. Hier sehen Sie, wie der Agent Metadaten ausschließlich aus dem Schema Ihres Datasets ableitet. Sie müssen alle Vorschläge manuell prüfen. |
| Grounded |
|
Deaktiviert | Produktionsumgebungen. Verankert den KI-Agenten in Ihrer spezifischen Geschäftslogik und verwendet Ihre Standardarbeitsanweisungen und Glossare, um die Genauigkeit zu verbessern. |
| Automatisiert |
|
Aktiviert | Skalierung von Metadatenvorgängen. Das Bewertungsset dient als Sicherheitsleitlinie. Wenn ein automatisch generierter Vorschlag zu einer Verschlechterung der Genauigkeit bei nachgelagerten Aufgaben führt, wird die Veröffentlichung für eine manuelle Überprüfung angehalten. |
| Selbstlernend |
|
Aktiviert | Erweiterte und autonome Kataloge. Der KI-Agent passt sich kontinuierlich an, indem er Live-Nutzerinteraktionen und Chatprotokolle analysiert, um Wissenslücken zu identifizieren und zu schließen. |
Einschränkungen und Grenzen der Vorabversion
Während der Vorschau gelten für Anreicherungsaufgaben die folgenden Einschränkungen:
Verwaltung über die Console: Sie konfigurieren und verwalten Aufgaben ausschließlich über die Google Cloud Console. Direkte öffentliche REST APIs und
gcloud-CLI-Befehle sind in der Vorabversion nicht verfügbar.Kontingente und Limits: Für Anreicherungsaufgaben und Aufgabenausführungen gelten regionale Ressourcen- und Ratenkontingente pro Projekt. Weitere Informationen finden Sie im Abschnitt zu Knowledge Studio-Anreicherungsaufgaben unter Kontingente und Limits.
Lebenszyklus der Bereitstellung
Der Prozess zum Erstellen und Bereitstellen einer Anreicherungsaufgabe folgt einem linearen Lebenszyklus:
- Voraussetzungen konfigurieren: Gewähren Sie die erforderlichen Rollen, konfigurieren Sie die Dienstkonten und aktivieren Sie Datenprofilerstellung und KI-Dateneinblicke für häufig verwendete Tabellen. Weitere Informationen finden Sie unter Voraussetzungen für Anreicherungsaufgaben konfigurieren.
- Externes Wissen verknüpfen: Autorisieren Sie die Aufgabe, Dateien aus Ihrem Google Drive oder externen Git-Repositories für die Fundierung zu lesen.
- Aufgabe erstellen: Definieren Sie das Kontextset, die Zielressourcen, die Wissenssignale und die Bewertungsstrategie.
- KI-Vorschläge prüfen: Prüfen Sie die Ausführungsdiagnose, die vorgeschlagenen Beschreibungen und genehmigen Sie die Metadatenänderungen.
Nächste Schritte
Knowledge Studio – Übersicht
Hier erfahren Sie mehr über die wichtigsten Konzepte und die Architektur von Knowledge Studio.
Kontextsets – Übersicht
Hier erfahren Sie, wie Metadaten, die durch Anreicherungsaufgaben generiert werden, in Kontextsets gespeichert werden, um KI-Agenten zu fundieren.
Voraussetzungen für die Anreicherung konfigurieren
-Rollen und -Dienstkonten zum Ausführen von Anreicherungsaufgaben konfigurieren
Anreicherungstasks erstellen
Hier erfahren Sie, wie Sie Metadaten generieren, indem Sie automatisierte Anreicherungsaufgaben ausführen.
Anreicherungsausführungen verwalten
Hier erfahren Sie, wie Sie Jobs überwachen und Metadatenvorschläge manuell prüfen oder genehmigen.
Anreicherungsaufgaben verwalten
Hier erfahren Sie, wie Sie geplante Anreicherungsjobs bearbeiten, pausieren und löschen.