


Knowledge Studio(プレビュー版)は、メタデータをアクティブなコンテキスト エンジンに変換し、生成 AI アプリケーションの信頼性を向上させます。Knowledge Studio を使用すると、BigQuery や Gemini の会話分析などの AI エージェントをビジネス コンテキストにグラウンディングすることで、ハルシネーションを防止できます。
Knowledge Studio は、スキーマ、Wiki、過去の SQL クエリから断片化されたナレッジを統合することで、メタデータのキュレーションを自動化します。自然言語を使用してデータを探索し、データアセットをビジネス セマンティクスに接続するビジュアル コンテキスト グラフを操作できます。また、人間によるレビュー用にカタログの更新をドラフトする自動ワークフローを実行できます。その後、Model Context Protocol(MCP)または Knowledge Catalog API を使用して、これらのキュレートされたコンテキスト ブロックをエージェントに動的に提供できます。
このドキュメントは、Knowledge Studio の仕組みを理解したいデータ アーキテクト、ガバナンス リード、AI エンジニアを対象としています。
受動的なカタログから能動的なコンテキスト エンジンへ
一般的なメタデータ カタログには、静的スキーマ、説明、データ ディクショナリが保存されます。静的メタデータは、テーブルを検索する人間のデータ アナリストには十分ですが、次の要件を満たす生成 AI エージェントには不十分です。
深いセマンティック関係: スキーマ間でテーブルがどのように結合されるか、どの列が主要なビジネス指標を表しているか、ビジネス用語集が基盤となるストレージにどのようにマッピングされるかを理解します。
運用上のグラウンディング: 実際の SQL 使用パターン、クエリ頻度、実際のエージェントのプロンプトとレスポンスをコンテキストに組み込みます。
継続的な自己学習: ユーザーのフィードバックとエージェントの実行成功率に基づいて、テーブルの説明、アスペクト、列定義を自動的に改良します。
Knowledge Studio は、運用シグナルを継続的にマイニングし、高忠実度のメタデータ提案を生成し、Model Context Protocol(MCP)または Knowledge Catalog Catalog API を介してエージェントに事前フォーマットされたコンテキスト ブロックを提供する、常時稼働のコンテキスト エンジンを通じてこれらの機能を提供します。
Knowledge Studio のインターフェース
Knowledge Studio では、ワークフローが次の 3 つの主要な領域に整理されます。
新しいチャット: 自然言語を使用したデータ検出、調査、セマンティック クエリ検証ツール のための会話型チャット インターフェースとインタラクティブなコンテキスト グラフ。詳細については、データアセットを探索するをご覧ください。
コンテキスト セット: 拡充されたメタデータをパッケージ化して、ダウンストリーム AI エージェントを安全にグラウンディングする論理コンテナ(エントリ グループ)を作成して管理するためのインターフェース。詳細については、コンテキスト セットを管理するをご覧ください。
エンリッチメント: メタデータの生成を自動化し、評価ベンチマークを構成し、AI が提案したカタログの更新(変更リクエスト)を人間参加型のキュレーション ワークフローで確認するためのコントロール センター。詳細については、拡充タスクについてをご覧ください。
実際のマルチプロダクト シナリオ
Knowledge Studio は、データ ウェアハウス、エンタープライズ ナレッジ リポジトリ、生成 AI アプリケーションを接続します。次のシナリオは、Knowledge Studio がエンタープライズ アーキテクチャの複数のプロダクトでどのように動作するかを示しています。
BigQuery で自然言語クエリをグラウンディングする
課題: ビジネス アナリストは、会話型分析で自然言語を使用して、「前四半期の地域別の純維持率はどのくらいでしたか?」などの質問をします。ビジネス セマンティクスがキュレートされていないと、モデルが結合キーをハルシネーションしたり、総予約数を純収益と誤認したりする可能性があります。
Knowledge Studio ソリューション: アナリストは、新しいチャット インターフェースを使用して、販売ステージング テーブルと認定済みの
SZBank Business Glossaryの関係を確認します。Knowledge Studio は、アクティブなコンテキスト グラフを使用して会話分析をグラウンディングし、生成された SQL に検証済みの結合条件と標準の KPI 式が含まれるようにします。
エンタープライズ SOP からメタデータを拡充する
課題: データ エンジニアリング チームは BigQuery で数十のデータセットを管理していますが、重要なビジネスルールとパイプライン リネージは外部の Confluence wiki や Jira チケットに存在します。スキーマが進化するにつれて、カタログのドキュメントは古くなります。
Knowledge Studio ソリューション: ガバナンス リードが、分析データセットをターゲットとする定期的なエンリッチメント タスクを構成します。Knowledge Studio は、Confluence から非構造化 SOP を、Cloud Logging から過去のクエリログを取り込み、更新された列定義とテーブル関係を自動的に提案します。キュレーターは、[実行の詳細] ページで提案された差分を検査し、検証済みのカタログの更新を承認します。
エージェントにキュレートされたコンテキストを提供する
- 課題: LangChain または ADK を使用して、顧客対応のサポート エージェントやアドバイザリー エージェントを構築する AI 開発者は、データベース認証情報をハードコードしたり、大規模なテーブル定義をプロンプトに詰め込んだりすることなく、最新のスキーマ セマンティクスを必要としています。
- Knowledge Studio ソリューション: Knowledge Studio は、キュレートされたメタデータと検証済みの結合グラフをコンテキスト セット(
entryGroups/customer-360など)にキャプチャします。コンテキストにアクセスするには、エージェントは Model Context Protocol(MCP)を介して Knowledge Studio に接続するか、Knowledge Catalog Catalog API を使用します。推論時に、エージェントは MCP エンドポイントまたは Catalog API にクエリを実行し、ユーザーの意図に関連する認定済みのビジネス コンテキストとサンプルクエリを動的に取得します。
アーキテクチャの概要
次の図は、Knowledge Studio コンポーネントがデータ資産、基盤モデル、AI アプリケーションとどのようにやり取りするかを示しています。
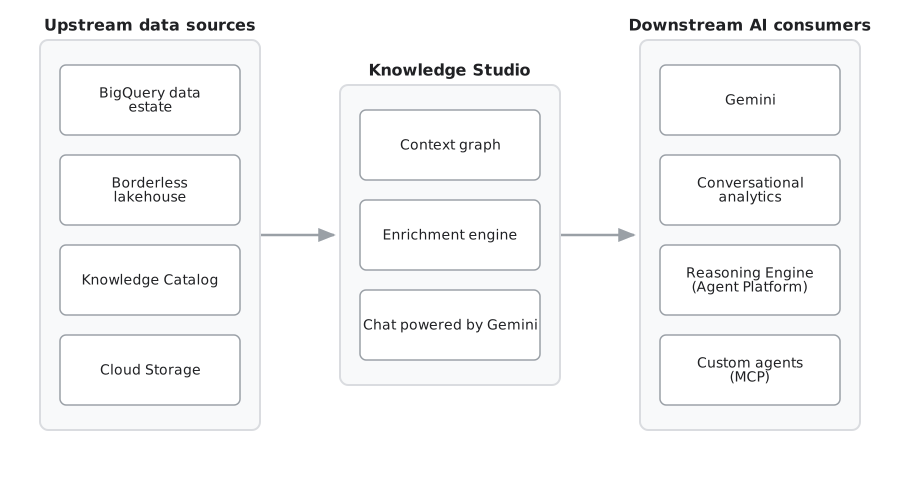
基本コンセプト
Knowledge Studio を効果的に使用するには、エンタープライズ メタデータがどのようにモデル化、パッケージ化、キュレートされるかを理解する必要があります。
コンテキスト グラフ
コンテキスト グラフは、Knowledge Studio の中心となるインタラクティブなビジュアル トポロジです。データアセット(BigQuery テーブル、ビュー、レイクハウスなど)をビジネス セマンティクス(ビジネス用語集の用語、指標の数式、データ プロダクトなど)と統合します。一般的なカタログでは、データテーブルとそれに関連するビジネス用語集の定義は、別々のサイロに存在します。コンテキスト グラフでは、
同じキャンバスに表示されます。データ アナリストとエンジニアは、推測された使用状況、テーブルの結合条件などによって、データ間の関係を視覚的に確認できます。Gemini は、グラフを使用して自然言語による探索をグラウンディングします。詳細については、Knowledge Studio でデータアセットを探索するをご覧ください。
コンテキスト グラフでサポートされているリソースと接続タイプ
コンテキスト グラフは、次の Knowledge Catalog リソースをノードまたはコンテナとしてレンダリングすることをサポートしています。
- テーブルとビュー: テクニカル BigQuery とレイクハウスのテーブル、ビュー、データセット、カタログ。
- データベースとストレージ: 運用データベース(Spanner、AlloyDB など)と Cloud Storage リソース。
- 分析とモデリング: Looker プロジェクトと dbt モデル、テスト、エクスポージャー。
- 用語集の用語: ビジネス用語集の個々のビジネス定義。
- データ プロダクト: チーム間で利用するためのデータアセットのキュレートされたバンドル。
- コンテキスト: カスタム コンテキスト セットと添付ドキュメント。
- カスタム アセット: カスタム エントリ グループとサポートされていないエントリタイプ。
このグラフは、次のセマンティック関係エッジを可視化することで、これらのリソースがどのように接続されているかを定義します。
スキーマ結合: テーブル間の構造的および運用的な結合関係。システムは、異なるテーブルの列が同じ意味を共有し、結合できることを示すクエリを BigQuery ジョブで自動的にスキャンします。
定義: テクニカル データアセットまたは列を、対応するビジネス用語集の定義にマッピングするリンク。
コンテキスト: 特殊なコンテキスト セットまたはカスタム ドメイン ドキュメントをターゲット データアセットに関連付けるリンク。
パッケージ: 特定のデータ プロダクトにバンドルされているデータアセットを示す集計リンク。
エントリリンク
エントリリンクは、コンテキスト グラフ内の有向または無向のセマンティック エッジを表します。これらのリンクは、キャンバス上のデータアセットと他の統合リソースを視覚的に結合します。これらのリンクを選択的にフィルタして、データ資産全体で特定の関係を分離できます。
エントリリンクは、企業全体の異なるエンティティを接続します。
定義リンク: 基盤となるテーブル列を、認定されたビジネス用語集の用語と KPI 式に直接接続します。
リレーションシップ リンク: 検証済みの主キー、外部キー、マルチテーブル結合パスをマッピングします。
エージェント トレースリンク: 実際の AI ユーザー プロンプトを、回答に使用された特定のテーブルに関連付けます。
パッケージ リンク: データアセットのセットをキュレートされたデータ プロダクトに結合します。
エントリリンクは、コンテキスト セットを組み立てるために走査される個々の接続として機能します。自動エンリッチメントの実行中に、エージェントは候補の結合またはリンクされていない用語を識別するたびに、キュレーターの承認を得るために新しいエントリリンクを提案します。
コンテキスト セット
コンテキスト セットは、セマンティック情報とデータアセット参照の境界付きコンテナです。各コンテキスト セットは、特殊なエントリ グループ(type="context-set")として実装されます。
コンテキスト セットは、エージェントが企業カタログ全体で自由回答式の検索を実行できないように、密閉された実行境界を確立します。この方法により、ハルシネーションとトークンの消費が削減されます。
コンテキスト セットがデータ プロダクトやセマンティック コンテキスト グラフなどの関連する構成要素とどのように異なるか、または詳細なアーキテクチャ機能、カテゴリ、名前空間、エージェント コンサルト パターンについては、コンテキスト セットの概要をご覧ください。
エンリッチメント タスクと実行
Knowledge Studio でのメタデータの自動拡張は、拡張タスク、拡張ジョブ、拡張実行に分類されます。
拡充タスク: 拡充エージェントがターゲット データアセットのセットを分析する方法を定義する永続的な構成。拡充タスクでは、ターゲット コンテキスト セット、コンテキスト入力ソース、評価ベンチマークを指定します。
拡充ジョブ: 拡充タスクを実行する Knowledge Studio 内のバックエンド オーケストレーション プロセス。
拡充実行: タスクの 1 回限りの実行インスタンス。各実行では、ターゲット アセットを検査し、セマンティック シグナルを抽出して、データ スチュワードが確認できる変更リクエスト(提案)を生成します。
拡充ワークフローの詳細については、拡充タスクについてをご覧ください。
コンテキスト グラフとデータリネージの比較
適切なツールを選択するには、Knowledge Studio のコンテキスト グラフと Knowledge Catalog のデータリネージの違いを理解することが重要です。
データリネージは、経時的なデータの運用移動と基盤となる変換を追跡します。リネージは、次のような疑問に答えます。このデータはどこから来たのか?このテーブルにデータを入力した ETL パイプラインは何か。このアップストリーム スキーマが変更された場合、どのダウンストリーム ダッシュボードが破損するか。ノードは、基盤となるアセットと変換ジョブ(Dataflow パイプラインや BigQuery ジョブなど)を表し、有向エッジは基盤となるデータフローを表します。
コンテキスト グラフは、ビジネス セマンティクス、関係、ドメイン知識をモデル化します。コンテキスト グラフは、「この列はビジネス用語で何を意味するのか?」、これら 2 つのテーブルは概念的にどのように関連していますか?AI エージェントは、質問に回答するためにこれらのアセットをどのように結合すればよいでしょうか。ノードは、概念エンティティ(用語集の用語、KPI 式、データ プロダクトなど)とともに基盤となるアセットを表し、エッジはセマンティック接続(列から用語集の定義へのリンク、検証済みの結合条件など)を表します。
パイプラインのトレーサビリティの詳細については、 Knowledge Catalog のデータリネージをご覧ください。
エンタープライズ セキュリティとガバナンス
Knowledge Studio は、厳格に管理された環境向けに設計されたエンタープライズ グレードのセキュリティ アーキテクチャに基づいて構築されています。
ユーザー管理の実行 ID: 拡充タスクは、ユーザー管理のサービス アカウントを使用して実行されます。これは、サービスがユーザーに代わって操作できるように、プロジェクトで作成して管理する ID です。Dataplex サービス エージェント(P4SA)は、サービス アカウント トークン作成者ロール(
roles/iam.serviceAccountTokenCreator)を使用してこのサービス アカウントの権限を借用し、有効期間の短い OAuth 2.0 認証情報を生成します。これらの有効期間が短い認証情報を生成すると、アクセス トークンの有効期間が制限され、有効期間が長いサービス アカウント キーを使用する場合と比較して、認証情報が漏洩するリスクが最小限に抑えられます。サードパーティ認証: リモート SaaS ナレッジソース(Microsoft SharePoint、Atlassian Confluence、Jira、GitHub など)の接続には、Google Cloudの Agent Identity Auth Manager が使用されます。これにより、人間のオペレーターが生のクライアント シークレットを処理することはありません。
これらのセキュリティ機能を構成する方法については、拡充の前提条件を構成するをご覧ください。
制限事項
Assured Workloads コンプライアンス レジーム(FedRAMP、CJIS、IL4/IL5、HIPAA など)。
データ所在地(DRZ)に関するコミットメント。この機能によって処理されたデータは、厳密に構成された地理的境界の外に保存または処理される場合があります。
顧客管理の暗号鍵(CMEK)。この機能によって保存または処理されるデータは、Cloud Key Management Service または Cloud EKM 鍵ではなく、Google が所有するGoogle-owned and Google-managed encryption keys を使用して暗号化されます。
VPC Service Controls。VPC Service Controls はサポートされていません。
アクセスの透明性(AXT)通知とアクセス承認コントロール。このプレビューをサポートまたは維持するために Google の担当者が行った操作は、アクセスの透明性の Cloud Access Ledger(CAL)に記録されません。
プレビュー期間中、Knowledge Studio は次の追加の境界内で動作します。
コンテキスト セットのリージョン スコープ: リージョン データアセットにリンクされたグローバル コンテキスト セットはサポートされていません。コンテキスト セットは、パッケージ化するアセットのリージョン境界と一致している必要があります。
コンソール ファーストの管理: エンリッチメント タスクと探索セッションは、 Google Cloud コンソールで管理されます。タスク管理用のダイレクト REST API と
gcloudCLI コマンドは、プレビュー版では使用できません。ただし、ダウンストリーム エージェントは、Knowledge Catalog Catalog API(ListEntries、LookupEntry)と Model Context Protocol(MCP)を使用して、キュレートされたコンテキスト セットをプログラムで検出してクエリできます。一元化されたキュレーション: メタデータのレビューと承認はすべて、[拡充実行の詳細] ページで行われます。
スタンドアロンの課金 SKU なし: Knowledge Studio には、個別のプロダクト SKU は導入されていません。使用料金は、基盤となるリソース(Gemini 推論エンジン、BigQuery、Cloud Storage)の標準的な使用量を反映しています。
次のステップ
コンテキスト セットの概要
ダウンストリーム AI エージェントを安全にグラウンディングするために使用される、Knowledge Studio のパッケージ化されたコンテキスト コンテナについて説明します。
MCP を使用してエージェントをグラウンディングする
Model Context Protocol を使用して、AI エージェントとデベロッパー ツールを Knowledge Catalog に接続します。