


拡充タスクは、データ スチュワードとプラットフォーム エンジニアがメタデータ オペレーションをスケーリングできるようにする、Knowledge Catalog の自律型エージェントです。拡充タスクは、データセット スキーマを継続的に分析し、会社のドキュメントを読み取り、データアセットの提案された説明を生成します。拡充タスクを最大限に活用するには、Knowledge Catalog のコアコンセプトと組織のデータ アーキテクチャを理解している必要があります。
メタデータの生成を自動化することで、拡充タスクは手動キュレーションの負担を軽減しながら、カタログに正確なビジネス固有のコンテキストが反映されるようにします。
拡充タスクを使用する理由
拡充タスクは、大規模な Data Catalog を正確かつ最新の状態に保つという課題に対処します。
| アスペクト | 従来のアプローチ | Knowledge Studio のアプローチ |
|---|---|---|
| プロセス | 手書きの説明。スチュワードは、数千のテーブルを手動で確認し、ドメイン エキスパートにインタビューします。 | エージェント主導。自律型エージェントは、データを分析し、標準的な運用手順を読み取ります。 |
| スピードと規模 | スキーマが時間の経過とともに変化するため、メンテナンスが遅く、困難。 | 優れたスケーラビリティ。高品質なメタデータ提案が継続的に生成されます。 |
| 人間の労力 | 高。広範な手動データ入力と継続的なメンテナンス。 | 低。データ スチュワードは、生成された候補を確認して承認するだけで済みます。 |
拡充タスクのユースケース
拡充タスクは、組織が次の一般的なメタデータの課題を解決するのに役立ちます。
買収の統合: 企業が、文書化されていない数千のデータアセットを持つ新しいビジネス ユニットを買収します。データ エンジニアは、買収した企業のデータ ディクショナリをナレッジ シグナルとして使用して、新しいデータセットにエンリッチメント タスクをポイントします。このエージェントは、数か月ではなく数時間で、データセット全体に対してビジネスに沿った説明を提案します。
継続的なドキュメント化: プラットフォーム エンジニアリング チームが、スキーマが毎日変更される動的なレイクハウスを構築します。自動公開を有効にして、拡充タスクを毎日実行するように構成します。これにより、カタログに最新のスキーマ変更が常に反映されます。
セマンティック ガバナンス: 中央データ オフィスは、すべての部門で用語を標準化したいと考えています。キュレートされた Knowledge Catalog の用語集を参照する拡充タスクをデプロイします。エージェントは、承認済みの企業用語集の用語に違反するテーブルの説明を自動的に報告し、オーバーライドを提案します。
基本コンセプト
拡充タスクを構成するときに、次のコア コンポーネントを定義します。
- 拡充タスク
-
エージェントが行う必要があることを定義する構成。タスクには、選択したコンテキスト セット、ターゲット リソース、スケジュール、提供するナレッジ シグナルが含まれます。
たとえば、毎週日曜日の午前 0 時に GitHub リポジトリを読み取り、
financeデータセットを拡充するようにエージェントに指示するタスク。 - エンリッチメント ジョブ
- エンリッチメント タスクを実行する Knowledge Studio 内のバックエンド オーケストレーション プロセス。
- エンリッチメント実行
-
タスクの単一のポイントインタイム実行インスタンス。Knowledge Studio コンソールには、タスクの過去の実行を一覧表示する [ジョブ] タブがあります。特定の実行を開いて、生成されたメタデータの提案を確認できます。
たとえば、10 月 24 日に発生し、15 件の列変更が提案された特定の実行インスタンスなどです。
- コンテキスト セット
-
ターゲット データアセットとメタデータの境界付きコンテナ。すべての拡充タスクは、1 つのコンテキスト セットをターゲットとするように構成する必要があります。コンテキスト セットには、BigQuery データセットやレイクハウスなどのターゲット リソースを含めることができます。また、コンテキスト セットが存在しない場合は、空のコンテキスト セットを作成することもできます。
たとえば、キャンペーン テーブル、ROAS 指標、用語集を 1 つの AI コンテキスト境界に論理的にバインドするマーケティング コンテキスト セットなどです。
- 知識シグナル
- エージェントを自社の実態にグラウンディングする外部資料。データ ディクショナリ、Knowledge Catalog の用語集、内部ドキュメントの URL を含む Cloud Storage バケットを提供することで、エージェントが一般的な推測ではなく、特定のビジネス ロジックを使用するようにできます。
- 評価セット
-
エージェントの精度を評価するために使用されるテスト用の質問と対応する SQL(
.jsonl形式で提供)。エージェントが新しいメタデータを提案すると、これらのテスト質問を提案に対して実行し、公開前に精度が低下しないことを確認します。たとえば、「MRR はいくらですか?」などのテスト用の質問と、月間経常収益の計算に必要な正確な SQL クエリをペアで指定します。エージェントが、このテストクエリの失敗の原因となる紛らわしいメタデータを提案した場合、その提案はフラグが付けられます。
- 自己学習リソース
-
Gemini Enterprise アプリまたは BigQuery エージェント分析からのライブ会話ログ。エージェントはこれらのチャットログを読み取り、ユーザーが何を尋ねているかを特定し、不足しているナレッジギャップを検出して、それらのギャップを埋める新しいメタデータを自動的に提案します。
たとえば、チャットログから、ユーザーが「ステータス コード 42 の意味」を頻繁に尋ねているにもかかわらず、エージェントが回答できていないことが判明した場合、自己学習によって、不足しているステータス コードをドキュメント化するためのメタデータ提案がトリガーされます。
拡充タスクでサポートされているデータソースと統合
拡充タスクは、 Google Cloud とサードパーティ システムの両方と統合されます。
ターゲット データアセット
拡充エージェントは、次のGoogle Cloud ターゲット データアセットを直接拡充してコンテキスト セットに追加できます。
BigQuery のデータセット、テーブル、ビュー
レイクハウスのレイク、ゾーン、アセット
Lakehouse 統合により、Knowledge Studio は、Iceberg REST Catalog 統合(Databricks Unity、Snowflake Horizon、AWS Glue Data Catalog、SAP Business Data Cloud など)を介して接続されたサードパーティ ソースからのメタデータの拡充を間接的にサポートします。
知識シグナル
拡充の実行中、エージェントは次の読み取り専用ソースからセマンティック ルール、ビジネス コンテキスト、ドメイン知識を抽出します。
Google Cloud:
- サポートされているファイル形式(PDF、CSV、Markdown、構成、データセット、非構造化テキスト ファイルなど)を含む Cloud Storage バケット
- 同じリージョン スコープにある Knowledge Catalog のビジネス用語集
- Google Workspace アプリケーション(Google ドライブ ファイル(ドキュメント、スプレッドシート、スライド、PDF、ファイル、一般的なテキスト ドキュメントなど)を含む)
サードパーティ システム(Google Cloud 以外):
- 5 MB 未満の Microsoft SharePoint ファイル(PDF、Office ファイル、一般的なテキスト ドキュメントなど。以前の形式や画像は除く)
- GitHub リポジトリ(読み取り可能なテキストを含むファイル)
- Atlassian Confluence ページの本文
自己学習リソース
実際のインタラクション ログからナレッジギャップを特定するために、拡充エージェントは次の軌跡をマイニングします。
- Gemini Enterprise アプリケーション
- BigQuery エージェント分析テーブル
- スコープ付きログビューを使用した Cloud Logging
拡充エージェントの仕組み
オンデマンドまたは定期的なスケジュールで拡充タスクをトリガーすると、拡充実行が開始されます。拡充エージェントはバックグラウンドで非同期に実行され、データアセット、クエリトレース、ドキュメントを分析して、検証済みのメタデータ提案を生成します。
次の図は、拡充エージェントのワークフロー アーキテクチャの概要を示しています。
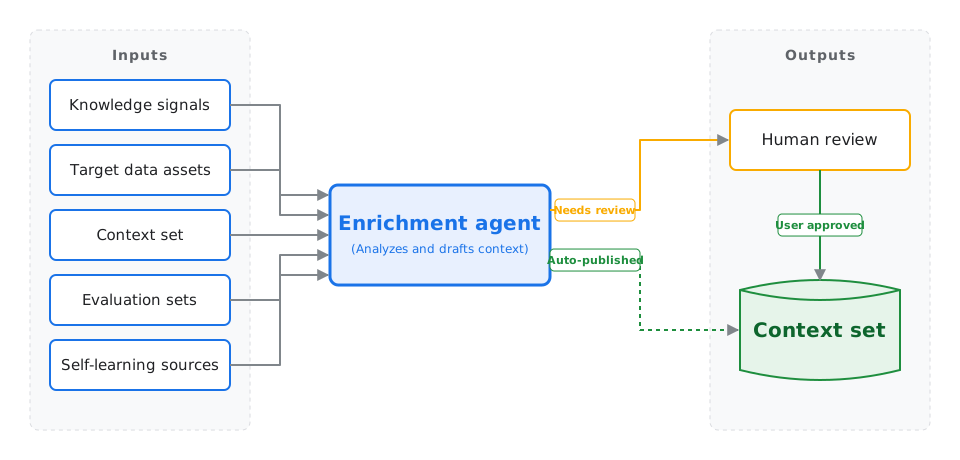
エージェントは、次の 4 つの主要なフェーズを通じてコンテキスト セットをキュレートします。
- シグナルとドキュメントの分析: エージェントは、インタラクション ログをマイニングして、ダウンストリーム AI エージェントが苦労した場所や曖昧性除去が必要だった場所を特定します。Cloud Storage またはリンクされたサードパーティ製アプリ内のエンタープライズ ドキュメントをスキャンし、クエリ履歴を調べて、高頻度のテーブル結合とアップストリーム依存関係を検出します。
- コンテキスト提案のドラフト作成: エージェントは、キュレーション目標に沿って、ターゲット アセットの構造化されたコンテキストをドラフトします。これには、ビジネス指向のテーブルの概要、正式な指標式、検証済みの結合条件、ゴールデン パラメータベースの SQL クエリ テンプレートが含まれます。
- ベンチマークと最適化: エージェントは、評価セットのテスト質問を使用して、独自に作成したメタデータを繰り返しテストし、ダウンストリーム クエリの精度が最大になるまで説明を改良します。次に、ホールドアウト テストクエリを実行して、回帰エラー率を計算します。提案された説明または指標ルールには、信頼スコアが割り当てられます。
- 審査ポリシーの適用: 信頼度のしきい値を満たす提案が、ポリシールールをトリガーします。自動公開を有効にしていて、回帰エラー率が許容範囲内にある場合、変更は自動的にマージされます。回帰エラーが許容しきい値を超えると、自動公開は直ちに停止され、すべての提案が 1 つの変更リクエストにパッケージ化され、人間によるレビューが行われます。
データ セキュリティとガバナンス
Knowledge Studio の拡充タスクでは、AI を使用してデータスキーマと内部ドキュメントを分析するため、プラットフォームには独自の情報を保護するための厳格な境界が実装されています。
基盤モデルのトレーニング: お客様のデータはお客様のものです。お客様の実行トレース、データベース スキーマ、提供されたナレッジ シグナル(ドキュメントや内部用語集など)が Google の基盤モデルのトレーニングに使用されることはありません。
データのサニタイズ: 提案されたメタデータがコンテキスト セットに書き込まれる前に、エージェントはシステムログと生成トレースから個人を特定できる情報(PII)を自動的に秘匿化します。
実行境界: 拡充エージェントは、Google が管理する安全なテナント内で動作します。Private Service Connect インターフェースと、お客様が管理する下り(外向き)プロキシを使用して、プライベート データソースに安全にアクセスします。
コンプライアンス ステータス: 現在のプレビュー フェーズでは、拡充タスクは VPC Service Controls(VPC-SC)、顧客管理の暗号鍵(CMEK)、Assured Workloads をサポートしていません。
推奨構成
Knowledge Catalog には、拡充タスク用のオプション設定がいくつか用意されています。基本的な構成から始めて、メタデータ オペレーションのスケールに合わせて高度な機能を段階的に有効にすることをおすすめします。
| 構成 | 含まれるコンポーネント | 自動公開 | 最適な用途 |
|---|---|---|---|
| Basic | コンテキスト セット | 無効 | ツールのテスト。エージェントがデータセットのスキーマからメタデータを厳密に推論する方法を確認できます。すべての提案を手動で審査する必要があります。 |
| 根拠づけ |
|
無効 | 本番環境。標準作業手順書と用語集を使用して、エージェントを特定のビジネス ロジックにグラウンディングし、精度を向上させます。 |
| 自動化 |
|
有効 | メタデータ オペレーションのスケーリング。評価セットは安全ガードレールとして機能します。自動生成された提案によって下流の精度が低下した場合、公開は停止され、手動審査が行われます。 |
| 自己学習 |
|
有効 | 高度な自律型カタログ。エージェントは、ライブ ユーザー インタラクションとエージェント チャットログを分析して、ナレッジのギャップを特定して修正することで、継続的に適応します。 |
制限事項とプレビューの境界
プレビュー期間中、拡充タスクは次の範囲内で動作します。
コンソール ファーストの管理: タスクの構成と管理は、 Google Cloud コンソールからのみ行います。直接公開 REST API と
gcloudCLI コマンドは、プレビュー版では使用できません。割り当てと上限: 拡充タスクとタスク実行には、プロジェクトごとのリージョン リソースとレートに基づく割り当てが適用されます。詳細については、割り当てと上限の Knowledge Studio エンリッチメント タスクのセクションをご覧ください。
デプロイのライフサイクル
拡充タスクの構築とデプロイのプロセスは、次のような線形ライフサイクルに沿って行われます。
- 前提条件を構成する: 必要なロールを付与し、サービス アカウントを構成して、頻繁に使用されるテーブルでデータ プロファイリングと AI データ分析情報を有効にします。詳細については、拡充タスクの前提条件を構成するをご覧ください。
- 外部ナレッジをリンクする: タスクに、Google ドライブまたは外部 Git リポジトリからファイルを読み取ってグラウンディングすることを許可します。
- タスクを作成する: コンテキスト セット、ターゲット リソース、ナレッジ シグナル、評価戦略を定義します。
- AI の提案を確認する: 実行診断を確認し、提案された説明を確認して、メタデータの変更を承認します。