


באמצעות Knowledge Catalog (לשעבר Dataplex Universal Catalog) אתם יכולים לאכוף מדיניות אבטחה עקבית במנועי שאילתות כמו BigQuery SQL ו-Apache Spark, בטבלאות Apache Iceberg ב-Google Cloud storage. במדריך הזה תשתמשו בסקריפטים עם Knowledge Catalog ו-Lakehouse ללא גבולות כדי ליצור lakehouse מנוהל של נתונים, שיעזור לכם להגן על מידע רגיש כמו רשומות פיננסיות.
סקירה כללית של הארכיטקטורה
כשמאחסנים נתונים במערכות אחסון שונות, יכול להיות קשה לנהל את האבטחה המפוצלת. כדי להגדיר בקרת גישה מפורטת בפורמט טבלה פתוח כמו Apache Iceberg, צריך ליצור ארכיטקטורת אבטחה קפדנית ומאוחדת.
בעיצוב הזה, Knowledge Catalog פועל כמישור הבקרה המרכזי ומתפקד כמנוע תלוי הקשר אוניברסלי. הוא מכיל את המטא-נתונים שנדרשים כדי לאכוף באופן דינמי את הקשר האבטחה בכל המנועים הנתמכים, לא משנה איזה מנוע שולח שאילתה לנתונים.
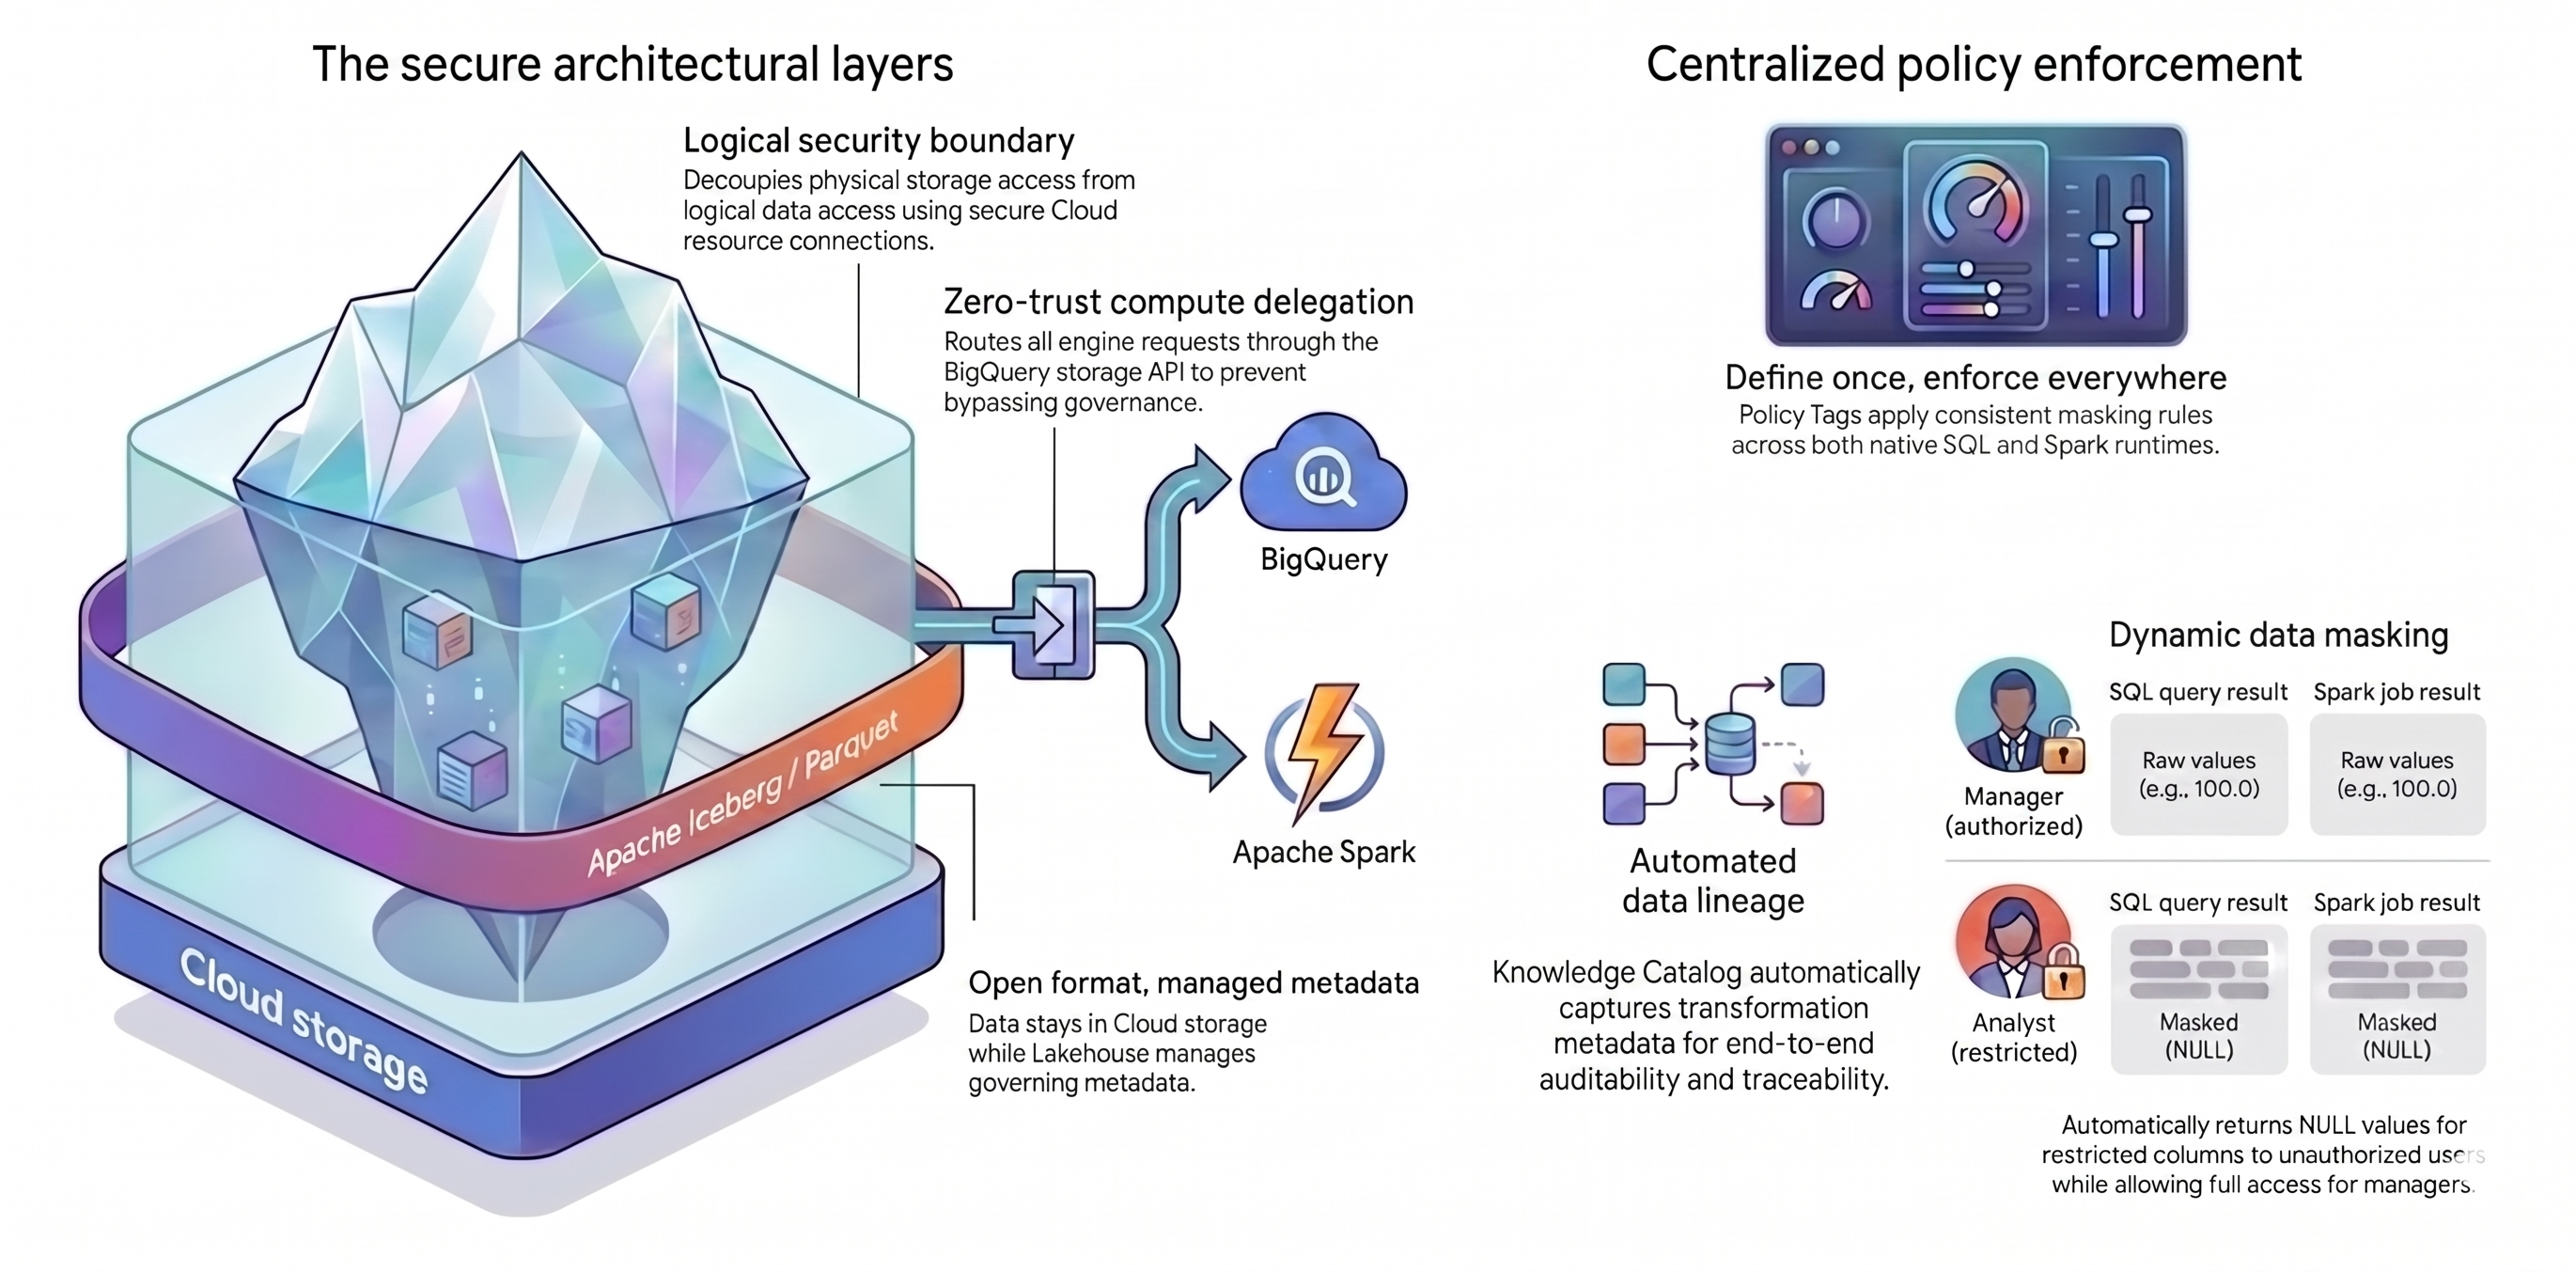
המדריך הזה מתבסס על שני מושגים עיקריים ליצירת הארכיטקטורה המאוחדת הזו:
- שכבות ארכיטקטורה מאובטחות: במקום לאפשר למשתמשים או למנועי שאילתות לגשת ישירות לקטגוריות של Cloud Storage, אתם בונים בסיס מאובטח עם שכבות שמבוסס על המאפיינים הבאים:
- פורמט פתוח עם מטא-נתונים מנוהלים: הנתונים נשארים בפורמט הפתוח של Apache Iceberg (Parquet) ב-Cloud Storage, ו-Lakehouse מנהל את המטא-נתונים של הטבלה.
- גבול אבטחה לוגי: אתם מפרידים בין הרשאות האחסון לבין שאילתות הנתונים באמצעות חיבור מאובטח למשאבים ב-Cloud. אתם אף פעם לא נותנים למשתמשי הקצה גישה ישירה לקבצים.
- הקצאת משאבי מחשוב: כדי למנוע ממנועי שאילתות לעקוף את הכללים שלכם, אתם מנתבים את כל בקשות הנתונים דרך BigQuery Storage API. ניתוב בקשות דרך BigQuery Storage API מבטיח ש-Knowledge Catalog יוכל ליירט ולאכוף כללי מדיניות גם במנועי עיבוד חיצוניים.
- אכיפת מדיניות מרכזית: אחרי שיוצרים בסיס מאובטח, משתמשים ב-Knowledge Catalog כדי להחיל את הכללים באופן אוניברסלי:
- מגדירים פעם אחת, אוכפים בכל מקום: מגדירים תגי מדיניות ב-Knowledge Catalog פעם אחת בלבד, והפלטפורמה מחילה כללי הסתרה עקביים בכל מנועי השאילתות הנתמכים.
- אנונימיזציה דינמית של נתונים: המערכת בודקת את זהות המשתמש במהלך השאילתות. משתמשים מורשים רואים ערכים גולמיים, ומשתמשים מוגבלים מקבלים פלטים של
NULLבכל מנועי השאילתות. - שושלת נתונים אוטומטית: ב-Knowledge Catalog מתבצע מעקב אוטומטי אחרי טרנספורמציות של נתונים, ונוצר נתיב ביקורת בלי קוד רישום ביומן בהתאמה אישית.
מטרות
- יוצרים טבלאות Apache Iceberg שמנוהלות על ידי BigQuery. Lakehouse מנהל את המטא-נתונים של Iceberg.
- להגדיר כללי אבטחה מרכזיים באמצעות תגי מדיניות כדי להסתיר ולהגן על עמודות רגישות.
- הפרדה בין הרשאות אחסון פיזיות לבין שאילתות נתונים לוגיות באמצעות קישור למשאבים ב-Cloud.
- מנתבים שאילתות בצורה מאובטחת דרך Managed Service for Apache Spark כדי שמנועים חיצוניים לא יוכלו לעקוף את כללי האבטחה. מידע נוסף זמין במסמכי התיעוד של Managed Service for Apache Spark.
- אפשר לעיין במפה אינטראקטיבית של הנתונים באמצעות שושלת נתונים.
לפני שמתחילים
לפני שמתחילים, צריך לבצע את הפעולות הבאות:
- בוחרים פרויקט ב- Google Cloud בשביל המדריך הזה.
- מוודאים שהחיוב מופעל בפרויקט.
הכנת הסביבה
במדריך הזה משתמשים ב-Cloud Shell, סביבה של שורת פקודה שפועלת בענן.
במסוףGoogle Cloud , לוחצים על הסמל של Cloud Shell בסרגל הכלים שבפינה הימנית העליונה.
מגדירים את משתני הפרויקט:
export PROJECT_ID=$(gcloud config get-value project) export REGION="us-central1" export ICEBERG_BUCKET="iceberg-retail-demo-${PROJECT_ID}" export DATASET_ID="lakehouse_retail_demo" export CONN_NAME="iceberg-bq-conn-demo"מגדירים משתנים לשני פרופילים של משתמשים, מנתח נתונים קמעונאי ומנהל קמעונאי:
export USER_ANALYST="retail-analyst-demo"
export EMAIL_ANALYST="${USER_ANALYST}@${PROJECT_ID}.iam.gserviceaccount.com"

export USER_MANAGER="retail-manager-demo"
export EMAIL_MANAGER="${USER_MANAGER}@${PROJECT_ID}.iam.gserviceaccount.com"
export CURRENT_USER=$(gcloud config get-value account)
מפעילים את ממשקי ה-API הנדרשים של Google Cloud .
gcloud services enable \
  bigquery.googleapis.com \
  bigqueryconnection.googleapis.com \
  datacatalog.googleapis.com \
  bigquerydatapolicy.googleapis.com \
  datalineage.googleapis.com \
  dataplex.googleapis.com \
  dataproc.googleapis.com \
  storage-component.googleapis.com
הורדת קוד המקור של המדריך
מורידים את הסקריפטים של Python למדריך הזה מ Google Cloud מאגר DevRel:
# Shallow clone without full history
git clone --depth 1 --filter=blob:none --sparse https://github.com/GoogleCloudPlatform/devrel-demos.git
cd devrel-demos

# Download only the specific folder
git sparse-checkout set data-analytics/governed-lakehouse
cd data-analytics/governed-lakehouse
יצירה של קטגוריית אחסון
יוצרים קטגוריה חדשה שתכיל את קובצי הטבלה של Iceberg:
gcloud storage buckets create gs://${ICEBERG_BUCKET} --location=${REGION}
הכנת זהויות ואבטחה
בשלב הזה, אתם מגדירים את הקצאת החישוב על ידי יצירת קישור למשאבים ב-Cloud. החיבור הזה פועל כזהות מאובטחת ומוענקת שבה BigQuery משתמש כדי לנהל ולקרוא את קובצי Iceberg. כך אפשר לוודא שלמשתמשים בודדים אף פעם לא תהיה גישה ישירה לקטגוריה של Cloud Storage.
מריצים את הפקודות הבאות כדי ליצור את החיבור, לאחזר את חשבון השירות שנוצר אוטומטית ולהעניק לחשבון הזה את ההרשאות שנדרשות כדי לנהל את נתוני Iceberg:
# Create the Cloud resource connection
bq mk --connection \
    --connection_type=CLOUD_RESOURCE \
    --location=${REGION} \
    ${CONN_NAME}

# Retrieve the connection's automatically generated Service Account
export BQ_CONN_SVC_ACCT=$(bq show --format=json --connection ${REGION}.${CONN_NAME} \
    | jq -r '.cloudResource.serviceAccountId')

# Grant Storage Object Admin to the connection for the Iceberg bucket
gcloud storage buckets add-iam-policy-binding gs://${ICEBERG_BUCKET} \
    --member="serviceAccount:${BQ_CONN_SVC_ACCT}" \
    --role="roles/storage.objectAdmin" \
    --quiet
יוצרים חשבונות שירות לשתי פרסונות: אנליסט ומנהל. הפקודות הבאות מגדירות את חשבונות השירות האלה, מאפשרות למשתמש הנוכחי להתחזות אליהם לצורך בדיקה, ומעניקות להם תפקידים ספציפיים להרצת שאילתות ולהצגת נתונים.
echo "Creating Service Accounts..."
for USER in "${USER_ANALYST}" "${USER_MANAGER}"; do
    gcloud iam service-accounts create ${USER} --display-name="Lakehouse ${USER}"
done

echo "⏳ Waiting 15 seconds for rules to apply..."
sleep 15

echo "Granting roles to service accounts..."
for USER in "${USER_ANALYST}" "${USER_MANAGER}"; do
    EMAIL="${USER}@${PROJECT_ID}.iam.gserviceaccount.com"

    # Allow Cloud Shell to impersonate them for testing
    gcloud iam service-accounts add-iam-policy-binding ${EMAIL} \
        --member="user:${CURRENT_USER}" \
        --role="roles/iam.serviceAccountTokenCreator" \
        --quiet

    # Allow logical viewing of the catalog, querying, and running Dataproc jobs
    for ROLE in "roles/datacatalog.viewer" "roles/bigquery.dataViewer" "roles/bigquery.user" "roles/bigquery.connectionUser" "roles/serviceusage.serviceUsageConsumer" "roles/dataproc.worker"; do
        gcloud projects add-iam-policy-binding ${PROJECT_ID} \
            --member="serviceAccount:${EMAIL}" \
            --role="${ROLE}" \
            --quiet
    done
done

# Grant the Manager data creation rights
gcloud projects add-iam-policy-binding ${PROJECT_ID} \
    --member="serviceAccount:${EMAIL_MANAGER}" \
    --role="roles/bigquery.dataEditor" \
    --quiet

echo "✅ Identity and Security setup completed!"
יצירת טבלאות Apache Iceberg
אתם יכולים להשתמש במנוע ה-SQL של BigQuery כדי ליצור טבלאות Apache Iceberg. למרות שאתם מריצים את פקודות היצירה באמצעות BigQuery, Lakehouse פועל כשכבת הניהול שמאחסנת את המטא-נתונים של הטבלה ומאבטחת את קובצי ה-Parquet הבסיסיים ב-Cloud Storage.
אחרי שיוצרים את הטבלאות, מריצים טרנספורמציה מהירה כדי לראות איך Knowledge Catalog מטפל באבטחה ועוקב באופן אוטומטי אחרי מסלול הנתונים.
יצירת מערך נתונים ב-BigQuery
קודם כל, יוצרים מערך נתונים ב-BigQuery כדי לקבץ את הטבלאות:
echo "Creating BigQuery Dataset..."
bq mk --location=${REGION} --dataset ${PROJECT_ID}:${DATASET_ID}
יצירת טבלאות Iceberg
מריצים את הפקודות הבאות כדי ליצור טבלאות מלאי וטבלאות עסקאות:
echo "Creating Iceberg tables..."

# Inventory table
bq query --use_legacy_sql=false \
"CREATE OR REPLACE TABLE \`${PROJECT_ID}.${DATASET_ID}.inventory\` (
    product_id INT64,
    product_name STRING,
    stock_count INT64
)
WITH CONNECTION \`${REGION}.${CONN_NAME}\`
OPTIONS (
    file_format = 'PARQUET',
    table_format = 'ICEBERG',
    storage_uri = 'gs://${ICEBERG_BUCKET}/inventory/'
);"

# Transactions table
bq query --use_legacy_sql=false \
"CREATE OR REPLACE TABLE \`${PROJECT_ID}.${DATASET_ID}.transactions\` (
    id INT64,
    item STRING,
    amount FLOAT64,
    transaction_date DATE
)
WITH CONNECTION \`${REGION}.${CONN_NAME}\`
OPTIONS (
    file_format = 'PARQUET',
    table_format = 'ICEBERG',
    storage_uri = 'gs://${ICEBERG_BUCKET}/transactions/'
);"
הוספת נתונים לדוגמה
מוסיפים נתונים לדוגמה לטבלאות:
echo "Inserting data into Iceberg tables..."

# Insert into Inventory table
bq query --use_legacy_sql=false \
"INSERT INTO \`${PROJECT_ID}.${DATASET_ID}.inventory\` (product_id, product_name, stock_count)
VALUES (101, 'Widget A', 500), (102, 'Widget B', 250), (103, 'Widget C', 800);"

# Insert into Transactions table
bq query --use_legacy_sql=false \
"INSERT INTO \`${PROJECT_ID}.${DATASET_ID}.transactions\` (id, item, amount, transaction_date)
VALUES
    (1, 'Widget A', 100.0, DATE '2024-01-01'),
    (2, 'Widget B', 150.0, DATE '2024-01-02'),
    (3, 'Widget C', 50.0, DATE '2024-01-03');"
עכשיו יש לכם שתי טבלאות Iceberg עם נתונים גולמיים לדוגמה. Lakehouse מנהל את המטא-נתונים, אבל קובצי ה-Parquet עצמם נמצאים בקטגוריה של Cloud Storage.
טרנספורמציה של נתונים לשושלת נתונים אוטומטית
צוברים את העסקאות הגולמיות לסיכום מכירות יומי. הטרנספורמציה הזו יוצרת טבלה חדשה ומפיקה את המטא-נתונים שמשמשים את Knowledge Catalog כדי למפות באופן אוטומטי את מסלול הנתונים.
echo "Creating transactions summary table..."
bq query --use_legacy_sql=false \
"CREATE TABLE \`${PROJECT_ID}.${DATASET_ID}.transactions_summary\` AS
 SELECT transaction_date, SUM(amount) as total_sales, COUNT(id) as transaction_count
 FROM \`${PROJECT_ID}.${DATASET_ID}.transactions\`
 GROUP BY transaction_date;"
הגדרת כללי מדיניות של Access Governance
בסביבת ייצור, כתיבת כללי האבטחה כקוד (תשתית כקוד) הופכת את כללי המדיניות שלכם לניתנים לחזרה, לניהול גרסאות ולקלים יותר לתחזוקה. בקטע הזה, אתם משתמשים ב-Python SDK כדי להגדיר ולאכוף את הכללים באופן אוטומטי. Google Cloud
הכנת הסביבה הווירטואלית של Python
מגדירים סביבה וירטואלית מבודדת של Python כדי לנהל את יחסי התלות ולוודא שהסקריפטים פועלים בצורה מהימנה:
# Create and activate a virtual environment
python3 -m venv lakehouse_env
source lakehouse_env/bin/activate

# Install required Knowledge Catalog and BigQuery governance libraries
pip install google-cloud-datacatalog google-cloud-bigquery-datapolicies google-cloud-bigquery --quiet

echo "✅ Python environment is ready!"
הגדרת טקסונומיות ותגים של אבטחה
קודם כל, צריך לבנות את הבסיס לכללי האבטחה. בשלב הזה יוצרים טקסונומיה שתשמש כמאגר, ותג מדיניות שישמש כתווית אבטחה ספציפית לנתונים רגישים.
מריצים את הסקריפט כדי ליצור את המשאבים:
python 1_create_taxonomy.py
כדאי לעיין ב-1_create_taxonomy.py כדי לראות את הלוגיקה העיקרית:
# Create Taxonomy with Fine-Grained Access Control enabled
taxonomy = datacatalog_v1.Taxonomy(
    display_name="BusinessCritical",
    activated_policy_types=[datacatalog_v1.Taxonomy.PolicyType.FINE_GRAINED_ACCESS_CONTROL]
)
created_taxonomy = client.create_taxonomy(parent=parent, taxonomy=taxonomy)

# Create Policy Tag inside the Taxonomy
policy_tag = datacatalog_v1.PolicyTag(display_name="RestrictedFinancial")
created_policy_tag = client.create_policy_tag(parent=created_taxonomy.name, policy_tag=policy_tag)
הגדרה מפורשת של סוג המדיניות FINE_GRAINED_ACCESS_CONTROL הופכת תג מטא-נתונים רגיל לגבול אבטחה קפדני שמוגדר כ"דחייה כברירת מחדל". כברירת מחדל, כל עמודה עם התג הזה חוסמת את הגישה לכל המשתמשים.
יצירת מדיניות דינמית להסתרת נתונים
עכשיו, מגדירים מה קורה כשמישהו בלי הרשאות שולח שאילתה לעמודה מתויגת. יוצרים מדיניות הסתרת מידע שמחליפה באופן אוטומטי ערכים רגישים ב-NULL בשביל הפרסונה Analyst.
מריצים את הסקריפט כדי להגדיר את כלל ההסתרה:
python 2_create_masking.py
בתוך 2_create_masking.py, הסקריפט מחפש את המזהה של תג המדיניות שיצרתם ומחיל את מדיניות הנתונים על חשבון השירות Analyst:
# Define a Masking Policy that always returns NULL
data_policy = bigquery_datapolicies_v1.DataPolicy(
    data_policy_id="mask_financial_null",
    policy_tag=policy_tag_id,
    data_policy_type=bigquery_datapolicies_v1.DataPolicy.DataPolicyType.DATA_MASKING_POLICY,
    data_masking_policy=bigquery_datapolicies_v1.DataMaskingPolicy(
        predefined_expression=bigquery_datapolicies_v1.DataMaskingPolicy.PredefinedExpression.ALWAYS_NULL
    )
)

# ... (Policy creation code) ...

# Bind the Masked Reader role to the Analyst
iam_policy.bindings.add(
    role="roles/bigquerydatapolicy.maskedReader",
    members=[f"serviceAccount:{analyst_email}"]
)
מתן גישה מיוחדת לנתונים שלכם
בגלל הגדרת ברירת המחדל לדחייה, אף אחד לא יכול לקרוא את העמודה המתויגת. אתם צריכים לתת גישה באופן מפורש למשתמשים מורשים. מקצים למשתמש Manager ולחשבון שלכם את התפקיד Fine-Grained Reader (roles/datacatalog.categoryFineGrainedReader). כך המשתמשים הספציפיים האלה יכולים לעקוף את כללי ההסתרה ולקרוא את הנתונים הלא מוסתרים.
מריצים את הסקריפט כדי לתת גישה:
python 3_grant_access.py
בתוך 3_grant_access.py, הסקריפט משנה את מדיניות ה-IAM של תג המדיניות:
# Grant original data read access
iam_policy.bindings.add(
    role="roles/datacatalog.categoryFineGrainedReader",
    members=[f"serviceAccount:{manager_email}", f"user:{current_user}"]
)
client.set_iam_policy(request=iam_policy_pb2.SetIamPolicyRequest(resource=policy_tag_id, policy=iam_policy))
הוספת תגי אבטחה לסכימת הטבלה
בשלב האחרון, אתם יכולים לקשר את הכללים הלוגיים לנתונים בפועל. מעדכנים את הסכימה של טבלת Iceberg כדי לצרף את תג המדיניות ישירות לעמודה amount. אחרי שתעשו את זה, Lakehouse יאכוף באופן מיידי את ההגנות על קובצי הטבלה של Iceberg בקטגוריה.
מריצים את הסקריפט כדי לצרף את תג המדיניות:
python 4_attach_tag.py
בדיקת 4_attach_tag.py. הסקריפט מאחזר את הסכימה של הטבלה ב-BigQuery, עובר על השדות ומצרף את התג באופן ספציפי לעמודה amount:
new_schema =[]
for field in table.schema:
    if field.name == 'amount':
        # Wrap the Policy Tag ID and attach it to the column
        policy_tags_list = bigquery.PolicyTagList(names=[policy_tag_id])
        new_field = bigquery.SchemaField(
            name=field.name, field_type=field.field_type, mode=field.mode,
            description=field.description, policy_tags=policy_tags_list
        )
        new_schema.append(new_field)
    else:
        new_schema.append(field)

# Update the table schema in BigQuery
table.schema = new_schema
client.update_table(table, ["schema"])
אימות של מדיניות האבטחה
מריצים כמה שאילתות בדיקה כדי לוודא שההרשאות פועלות כמו שצריך. כדי להוכיח ש-Knowledge Catalog פועל כמנוע הקשר אוניברסלי על ידי אכיפת אותן מדיניות אבטחה כשמחליפים מנועי שאילתות, מריצים את הבדיקות האלה גם באמצעות BigQuery וגם באמצעות Apache Spark.
בדיקה באמצעות BigQuery SQL
קודם כל, בודקים את כללי המדיניות ישירות ב-BigQuery. זו הדרך המהירה ביותר לוודא שכללי ההסתרה וההרשאות שלכם פעילים.
בדיקה כמנהל/ת
למשתמשים בתפקיד מנהל יש גישת קריאה מפורטת עם הרשאות. הם צריכים לראות כל פרט בטבלה, כולל הערכים בעמודה amount.
# Impersonate the Manager
gcloud config set auth/impersonate_service_account ${EMAIL_MANAGER}

# Query the transactions table
bq query --use_legacy_sql=false "SELECT * FROM \`${PROJECT_ID}.${DATASET_ID}.transactions\`"
למנהל יש את התפקיד קורא עם הרשאות גישה מפורטות (roles/datacatalog.categoryFineGrainedReader), ולכן השאילתה מציגה את ערכי הסכומים הגולמיים:
+----+----------+--------+------------------+
| id |   item   | amount | transaction_date |
+----+----------+--------+------------------+
|  1 | Widget A |  100.0 |       2024-01-01 |
|  3 | Widget C |   50.0 |       2024-01-03 |
|  2 | Widget B |  150.0 |       2024-01-02 |
+----+----------+--------+------------------+
בדיקה בתפקיד "ניתוח נתונים"
עוברים לפרופיל Analyst ומריצים את אותה שאילתה.
gcloud config set auth/impersonate_service_account ${EMAIL_ANALYST}

bq query --use_legacy_sql=false "SELECT * FROM \`${PROJECT_ID}.${DATASET_ID}.transactions\`"
למרות שאתם מריצים את אותה שאילתה, הערכים הרגישים בעמודה amount מוסתרים על ידי Knowledge Catalog:
+----+----------+--------+------------------+
| id |   item   | amount | transaction_date |
+----+----------+--------+------------------+
|  1 | Widget A |   NULL |       2024-01-01 |
|  3 | Widget C |   NULL |       2024-01-03 |
|  2 | Widget B |   NULL |       2024-01-02 |
+----+----------+--------+------------------+
חזרה לחשבון
מנקים את מצב האימות של Cloud Shell כדי לחזור למשתמש האדמין.
gcloud config unset auth/impersonate_service_account
בדיקה באמצעות Apache Spark
האבטחה נפגעת לעיתים קרובות כשמשתמשים ניגשים ישירות לקובצי נתונים ב-Cloud Storage. אם מדען נתונים משתמש ב-Apache Spark כדי לקרוא ישירות את קובצי הטבלה של Iceberg, בדרך כלל הוא יעקוף את הכללים שלכם כי Cloud Storage מבין רק הרשאות ברמת הקטגוריה.
כדי למנוע את זה, צריך להשתמש בהקצאת משאבי מחשוב. באמצעות מחבר Spark-BigQuery, אתם יוצרים גשר מאובטח שמנתב את כל הבקשות של Spark דרך BigQuery Storage API. כך אפשר לוודא ש-Knowledge Catalog בודק את ההרשאות ומחיל כללי הסתרה לפני שהנתונים מגיעים לאשכול Spark.
מעלים את הסקריפט read_transactions.py לקטגוריה של Cloud Storage כדי של-Managed Service for Apache Spark תהיה גישה אליו:
# Upload script to Cloud Storage
gsutil cp read_transactions.py gs://${ICEBERG_BUCKET}/scripts/read_transactions.py
בודקים את הלוגיקה העיקרית בסקריפט שהעליתם:
# Reading data via Compute Delegation (Knowledge Catalog policies are applied dynamically here)
df = spark.read \
    .format("bigquery") \
    .option("table", f"{project_id}.{dataset_id}.{table_name}") \
    .load()

print("\n=== 📊 Data Preview ===")
df.show(truncate=False)
הסקריפט לא מפנה את Spark לנתיב gs:// של קובצי Iceberg. כשמציינים את .format("bigquery"), ה-BigQuery Storage API מיירט את בקשת הקריאה, בודק את הזהות של המשתמש שמריץ את משימת Spark, מחיל את כללי ההסתרה של Knowledge Catalog ומחזיר רק את הנתונים המורשים ל-Spark DataFrame.
הפעלת Spark כמנהל
שולחים משימת Spark בתפקיד Manager. Managed Service for Apache Spark הוא שירות מנוהל שמאפשר להריץ עומסי עבודה של Spark בלי לנהל אשכולות בעצמכם:
echo "🚀 Submitting Dataproc Serverless Job as [MANAGER]..."
gcloud dataproc batches submit pyspark gs://${ICEBERG_BUCKET}/scripts/read_transactions.py \
    --project=${PROJECT_ID} \
    --region=${REGION} \
    --service-account=${EMAIL_MANAGER} \
    --version=2.3 \
    -- ${PROJECT_ID} ${DATASET_ID} \
    --format="value(name)"
בודקים את יומני הפלט של המשימה במסוף. למנהל יש את התפקיד קורא עם הרשאות גישה מפורטות (roles/datacatalog.categoryFineGrainedReader), ולכן Spark מאחזר בהצלחה את הסכומים ללא המסכה:
=== 📊 Data Preview ===
+---+--------+------+-------------------+
|id |item    |amount|transaction_date   |
+---+--------+------+-------------------+
|1  |Widget A|100.0 |2024-01-01         |
|2  |Widget B|150.0 |2024-01-02         |
|3  |Widget C|50.0  |2024-01-03         |
+---+--------+------+-------------------+
הפעלת Spark בתפקיד "ניתוח נתונים"
לסיום, מריצים את אותו קוד Spark כמו של מנתח הנתונים:
echo "🚀 Submitting Dataproc Serverless Job as [ANALYST]..."
gcloud dataproc batches submit pyspark gs://${ICEBERG_BUCKET}/scripts/read_transactions.py \
    --project=${PROJECT_ID} \
    --region=${REGION} \
    --service-account=${EMAIL_ANALYST} \
    --version=2.3 \
    -- ${PROJECT_ID} ${DATASET_ID} \
    --format="value(name)"
בודקים שוב את היומנים. למרות שמנתח הנתונים הריץ את אותו קוד Spark, ה-BigQuery Storage API יירט את הבקשה ואכף את המדיניות של Knowledge Catalog. ב-Spark DataFrame של האנליסט מוצג הערך null בסכומים.
=== 📊 Data Preview ===
+---+--------+------+-------------------+
|id |item    |amount|transaction_date   |
+---+--------+------+-------------------+
|1  |Widget A|null  |2024-01-01         |
|2  |Widget B|null  |2024-01-02         |
|3  |Widget C|null  |2024-01-03         |
+---+--------+------+-------------------+
הוכחתם ש-Knowledge Catalog, בתור מישור הבקרה המרכזי, אוכף את מדיניות האבטחה באופן עקבי, בלי קשר למנוע השאילתות שבו אתם משתמשים.
הצגת מסלול הנתונים באמצעות שושלת נתונים אוטומטית
כדי ש-lakehouse יעמוד בדרישות המדיניות, לא מספיק להגדיר בקרת גישה, אלא צריך גם נתיב ביקורת ברור. שושלת נתונים עוזרת לכם להבין מה המקור של הנתונים ואיך הם משתנים. מענה על שאלות חיוניות כמו "באילו טבלאות גולמיות השתמשו כדי ליצור את דוח המכירות הזה?" עוזר לכם לשמור על תאימות, לנפות באגים בפייפליינים במהירות ולבנות בסיס נתונים אמין.
במקום לכתוב קוד רישום מורכב ביומן באופן ידני, Knowledge Catalog עוקב באופן אוטומטי אחרי מחזור החיים הזה בכל הארכיטקטורה. לדוגמה, כשיצרתם טבלת סיכום קודם לכן במדריך הזה, BigQuery תיעד את פרטי הטרנספורמציה באופן מיידי ושלח אותם ל-Knowledge Catalog. ההקשר וההיסטוריה של הנתונים מתעדכנים באופן דינמי.
עיון בתרשים השושלת האינטראקטיבי
בודקים את המפה האינטראקטיבית שנוצרה על ידי Knowledge Catalog. הוא מראה איך הנתונים הגולמיים זורמים מהטבלה transactions לטבלה transactions_summary. מכיוון ש-Knowledge Catalog אוסף מטא-נתונים כמנוע תלוי הקשר דינמי, התרשים הזה מציג את יכולת המעקב האמינה בזמן אמת שנדרשת לביקורת נתונים.
- במסוף Google Cloud , נכנסים אל Knowledge Catalog > Search.
- מקלידים
lakehouse_retail_demo.transactions_summaryבשורת החיפוש ולוחצים על הטבלה. - לוחצים על הכרטיסייה Lineage.
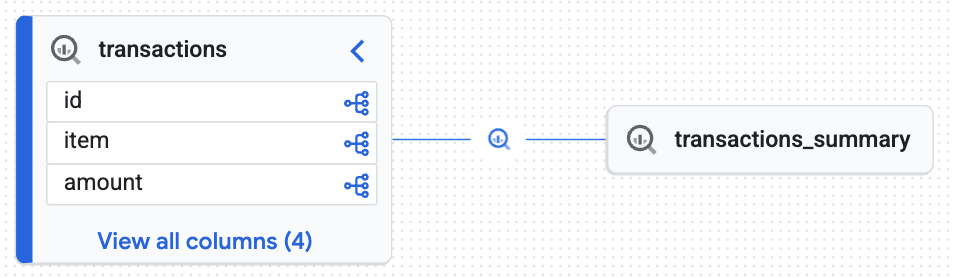
התרשים האינטראקטיבי מאשר שטבלת היעד (transactions_summary) נגזרת מטבלת Iceberg הגולמית המנוהלת (transactions). התצוגה החזותית הזו מדגימה את יכולת המעקב מקצה לקצה של הנתונים.
הסרת המשאבים
כדי למנוע חיובים מתמשכים, הסירו את המשאבים שיצרתם בשביל המדריך הזה.
הסרת נכסי מדיניות ומטא-נתונים
לפני שמוחקים את מערך הנתונים ב-BigQuery או את הקטגוריה ב-Cloud Storage, צריך למחוק את כללי מדיניות משילות המידע ואת נכסי המטא-נתונים.
מריצים את סקריפט הניקוי של Python:
python cleanup_governance.py
בודקים את הסקריפט cleanup_governance.py מהמאגר כדי למצוא את הלוגיקה הבאה של הפירוק. סדר המחיקה הוא קריטי. קודם כל, מוחקים את המדיניות של הסתרת נתונים. לאחר מכן, מוחקים את הטקסונומיה הראשית, מה שמסיר באופן אוטומטי את כל תגי המדיניות הבסיסיים ומונע שגיאות של תלות במשאבים.
# 1. Delete Data Policy
data_policy_name = f"{parent_loc}/dataPolicies/mask_financial_null"
dp_client.delete_data_policy(name=data_policy_name)

# 2. Find and Delete Taxonomy (This auto-deletes child Policy Tags)
taxonomies = catalog_client.list_taxonomies(parent=parent_loc)
taxonomy_id = next((t.name for t in taxonomies if t.display_name == "BusinessCritical"), None)
catalog_client.delete_taxonomy(name=taxonomy_id)
הסרת זהויות, אחסון ונכסי מחשוב
מוחקים את הטבלאות ב-BigQuery, את הקטגוריות של Cloud Storage, את חשבונות השירות ואת הסביבה הווירטואלית המקומית של Python.
מעתיקים את סקריפט הניקוי הבא ומריצים אותו ב-Cloud Shell:
echo "Deleting Service Accounts and Impersonation Bindings..."
export CURRENT_USER=$(gcloud config get-value account)

for USER in "${USER_ANALYST}" "${USER_MANAGER}"; do
    EMAIL="${USER}@${PROJECT_ID}.iam.gserviceaccount.com"

    # Remove impersonation binding
    gcloud iam service-accounts remove-iam-policy-binding ${EMAIL} \
        --member="user:${CURRENT_USER}" \
        --role="roles/iam.serviceAccountTokenCreator" \
        --quiet > /dev/null 2>&1

    # Delete the Service Account
    gcloud iam service-accounts delete ${EMAIL} --quiet
done

echo "Removing BigQuery Dataset and Tables..."
bq rm -f ${DATASET_ID}.transactions_summary
bq rm -f ${DATASET_ID}.transactions
bq rm -f ${DATASET_ID}.inventory
bq rm -f -d ${DATASET_ID}

echo "Removing BigQuery Cloud Resource Connection..."
bq rm --connection --location=${REGION} ${CONN_NAME}

echo "Removing Iceberg Cloud Storage Bucket..."
gcloud storage rm --recursive gs://${ICEBERG_BUCKET} --quiet

echo "Removing Auto-generated Dataproc Staging & Temp Buckets..."
for BUCKET in $(gcloud storage ls | grep -E "gs://dataproc-(staging|temp)-${REGION}"); do
    gcloud storage rm --recursive $BUCKET --quiet
done

echo "✅ Clean up completed successfully!"
מנקים את קובצי הפרויקט:
echo "Deactivating and removing the local Python environment..."
deactivate
cd ../..
rm -rf devrel-demos
סיכום
יצרתם בהצלחה lakehouse מאובטח של נתונים. כשמשתמשים ב-Lakehouse כדי לנהל טבלאות Iceberg, קובצי הטבלה הבסיסיים נשארים מאובטחים ב-Cloud Storage. הגדרתם את Knowledge Catalog כמנוע ההקשר האוניברסלי שלכם, ויצרתם תגי מדיניות במיקום מרכזי והחלתם אותם באופן עקבי על מנועי שאילתות שונים כמו BigQuery SQL ו-Apache Spark. לבסוף, עקבתם באופן אוטומטי אחרי כל המסלול של הנתונים באמצעות שושלת נתונים בזמן אמת.
המאמרים הבאים
- אחזור הקשר של נתונים לסוכני AI: אחזור הקשר של נתונים באמצעות Context API.
- מידע נוסף על שושלת נתונים: איך צופים במידע על שושלת נתונים.
- בקרת גישה מתקדמת: כדי להטמיע תרחישי אבטחה מורכבים יותר, כדאי לעיין במסמכים הרשמיים בנושא התאמה אישית של Lakehouse באמצעות תכונות נוספות.
- Managed Service for Apache Spark: במסמכי התיעוד של Managed Service for Apache Spark מוסבר איך להגדיל את היקף צינורות עיבוד הנתונים בלי להקצות אשכולות.
- תרחישי שימוש אחרים: נסו תרחישי שימוש אחרים של Knowledge Catalog.