


אתם יכולים להציג את שושלת הנתונים כדי להבין את הקשרים בין המשאבים של הפרויקט לבין התהליכים שיצרו אותם. הקשרים האלה מראים איך נכסי נתונים, כמו טבלאות ומערכי נתונים, משתנים בתהליכים כמו שאילתות וצינורות עיבוד נתונים. במדריך הזה מוסבר איך להציג את פרטי שושלת הנתונים במסוף Google Cloud או לאחזר אותם באמצעות Data Lineage API.
תפקידים והרשאות
כשמפעילים את Data Lineage API, המערכת עוקבת באופן אוטומטי אחרי פרטי שושלת הנתונים. אתם לא צריכים תפקידי אדמין או עריכה כדי לתעד את שושלת היוחסין של נכסי הנתונים.
כדי לצפות בשושלת הנתונים, אתם צריכים הרשאות ספציפיות לניהול זהויות והרשאות גישה (IAM). פרטי שושלת היוחסין נאספים בפרויקטים שונים, ולכן צריך הרשאות בכמה פרויקטים.
כשצופים בשושלת היוחסין ב-Knowledge Catalog, ב-BigQuery או ב-Vertex AI: צריך הרשאות לצפייה במידע על שושלת היוחסין בפרויקט שבו צופים בה.
כשצופים בשושלת נתונים שתועדה בפרויקטים אחרים: צריך הרשאות לצפייה במידע על שושלת הנתונים בפרויקטים שבהם היא תועדה.
כדי לקבל את ההרשאות שדרושות לצפייה בשושלת הנתונים, בקשו מהאדמין להקצות לכם את התפקידים הבאים ב-IAM:
-
הכול:
צפייה בשושלת נתונים (
roles/datalineage.viewer) בפרויקט שבו מתועדת שושלת הנתונים, ובפרויקט שבו צופים בשושלת הנתונים -
צפייה בפרטי הטבלה ב-BigQuery:
BigQuery Metadata Viewer (
roles/bigquery.metadataViewer) בפרויקט האחסון של הטבלה -
צפייה בפרטי המשימה ב-BigQuery:
BigQuery Resource Viewer (
roles/bigquery.resourceViewer) בפרויקט המחשוב של המשימה -
צפייה בפרטים של נכסים אחרים בקטלוג:
Dataplex Catalog Viewer (
roles/dataplex.catalogViewer) בפרויקט שבו מאוחסנות הרשומות בקטלוג
להסבר על מתן תפקידים, ראו איך מנהלים את הגישה ברמת הפרויקט, התיקייה והארגון.
התפקידים המוגדרים מראש האלה כוללים את ההרשאות שנדרשות כדי לצפות בשושלת הנתונים. כדי לראות בדיוק אילו הרשאות נדרשות, אפשר להרחיב את הקטע ההרשאות הנדרשות:
ההרשאות הנדרשות
כדי לצפות בשושלת הנתונים, נדרשות ההרשאות הבאות:
-
הצגת פרטי הטבלה ב-BigQuery:
bigquery.tables.get– הפרויקט שבו מאוחסנת הטבלה -
הצגת פרטי המשימה ב-BigQuery:
bigquery.jobs.get– פרויקט המחשוב של המשימה
יכול להיות שתקבלו את ההרשאות האלה באמצעות תפקידים בהתאמה אישית או תפקידים מוגדרים מראש אחרים.
סוגים של תצוגות שושלת נתונים
אפשר לראות את פרטי שושלת היוחסין בתרשים אינטראקטיבי או ברשימה מובנית במסוף Google Cloud .
לתיאור מפורט של רכיבי התרשים (כמו צמתים, קצוות, סמלי תהליכים ותוויות) והעמודות שזמינות בתצוגות הרשימה, קראו את המאמר מידע על תצוגה חזותית של שושלת נתונים ב-Knowledge Catalog.
הפעלת שושלת נתונים
כדי להתחיל לעקוב באופן אוטומטי אחרי מידע על שושלת נתונים במערכות נתמכות, צריך להפעיל את שושלת הנתונים. כברירת מחדל, הפעלת ה-API מפעילה את מעקב השושלת ברוב השירותים הנתמכים. למידע נוסף, קראו את המאמרים מעקב אוטומטי אחרי שושלת נתונים ומידע על בקרת הטמעת שושלת נתונים.
החיוב על Data Lineage API מתבצע במסגרת המק"ט Knowledge Catalog Premium Processing. מידע נוסף זמין במאמר התמחור של Knowledge Catalog.
צריך להפעיל את Data Lineage API גם בפרויקט שבו אתם רוצים לראות את שושלת היוחסין וגם בפרויקטים שבהם היא מתועדת. מידע נוסף זמין במאמר סוגי פרויקטים.
- כדי לתעד את פרטי שושלת היוחסין:
-
בדף Project selector במסוף Google Cloud , בוחרים את הפרויקט שבו רוצים לתעד את שושלת היוחסין.
מפעילים את Data Lineage API.
- חוזרים על השלבים הקודמים בכל פרויקט שבו רוצים לתעד את שושלת היוחסין.
-
בפרויקט שבו אתם רוצים לראות את שושלת הנתונים, מפעילים את Data Lineage API ואת Dataplex API.
שליטה בהטמעת שושלת נתונים בשירות
אתם יכולים להפעיל או להשבית באופן סלקטיבי את המעקב האוטומטי אחרי שושלת היוחסין של שירותים ספציפיים ברמת הפרויקט, התיקייה או הארגון.
במאמר מידע על בקרת הטמעת נתונים של שושלת נתונים מוסבר איך ההגדרות האלה מיושמות באופן היררכי דרך עץ המשאבים.
הצגת השושלת
כדי לעקוב אחרי האופן שבו הנתונים משתנים ועוברים בין מערכות, אתם יכולים להציג את שושלת הנתונים באמצעות מסוף Google Cloud או ה-API.
המסוף
אפשר לגשת למידע על שושלת הנתונים במסוף Google Cloud מנקודות התחלה שונות:
- Knowledge Catalog: נכנסים לדף Knowledge Catalog Search, בוחרים באפשרות Knowledge Catalog כמצב החיפוש, מחפשים את הרשומה שרוצים לראות ולוחצים עליה. מידע נוסף זמין במאמר חיפוש נכסי נתונים ב-Knowledge Catalog.
- BigQuery: נכנסים לדף BigQuery ופותחים את הטבלה שרוצים לראות את שושלת הנתונים שלה.
- Vertex AI: נכנסים לדף Datasets או Model Registry ולוחצים על מערך הנתונים או המודל שרוצים לראות את שושלת הנתונים שלו.
כדי לראות את תרשים השושלת:
לוחצים על הכרטיסייה Lineage.
תיפתח תצוגת ברירת המחדל Graph, שבה מוצג שושלת היוחסין ברמת הטבלה במערכות ובאזורים שונים. מידע נוסף זמין במאמר תצוגת תרשים שושלת.
כדי לבחון ידנית את תרשים השושלת, לוחצים על Expand ליד צומת כדי לטעון חמישה צמתים נוספים בכל פעם.
למידע נוסף, קראו את המאמר עיון בתרשים שושלת היוחסין.
לוחצים על צומת בתצוגה Graph.
החלונית Details נפתחת עם מידע על הנכס, כמו השם המלא והסוג. מידע נוסף זמין במאמר הצגת פרטי צומת של שושלת נתונים.
בתצוגת תרשים, לוחצים על קצה עם סמל תהליך.
החלונית Query נפתחת. למידע נוסף, קראו את המאמרים בדיקת לוגיקת הטרנספורמציה וביקורת והיסטוריית הרצות.
- כדי לבדוק את לוגיקת הטרנספורמציה, לוחצים על הכרטיסייה Details.
- כדי לראות את הביקורת וההיסטוריה של ההרצות, לוחצים על הכרטיסייה Runs.
בחלונית Lineage explorer, בוחרים קריטריונים לסינון, למשל Direction, Dependency type או Time range, ולוחצים על Apply.
הפעולה הזו פותחת תצוגה ממוקדת באזור ספציפי (גרסת טרום-השקה). בתצוגה הזו, התרשים מתרחב באופן אוטומטי עד לשלוש רמות של צמתים. מידע נוסף מופיע במאמר סינון והדגשה של תצוגות של שושלת נתונים.
בתצוגת Graph הממוקדת, בוחרים צומת, ואז בחלונית הפרטים של הצומת לוחצים על Visualize Path כדי להציג את נתיב שושלת היוחסין מהצומת שנבחר בחזרה לרשומת הבסיס (רק בתצוגה ממוקדת).
מידע נוסף זמין במאמר הצגה חזותית של נתיב שושלת נתונים.
כדי לראות את שושלת היוחסין ברמת העמודה (רק למשימות של BigQuery ו-Managed Service for Apache Spark), מבצעים אחת מהפעולות הבאות:
- בתצוגת תרשים ממוקדת, לוחצים על סמל העמודה בטבלה.
סמל העמודות - בחלונית Lineage explorer, מסננים לפי שם העמודה ולוחצים על Apply.
מידע נוסף זמין במאמר מתי להשתמש בשושלת נתונים ברמת העמודה.
- בתצוגת תרשים ממוקדת, לוחצים על סמל העמודה בטבלה.
לוחצים על איפוס.
הפעולה הזו מסירה את כל המסננים שהופעלו ומעבירה אתכם לתחילת התצוגה של התרשים.
לוחצים על רשימה כדי לעבור לתצוגת רשימה.
בתצוגת הרשימה מוצגות טבלאות פשוטות ומפורטות של שושלת היוחסין ברמת הטבלה וברמת העמודה, שמסונכרנות עם תצוגת התרשים. כברירת מחדל, מוצגת תצוגת רשימה פשוטה, ואפשר לעבור לתצוגת רשימה מפורטת כדי לנתח קשרים ספציפיים בין מקור ליעד. אתם יכולים להגדיר אילו עמודות יוצגו ולייצא את נתוני שושלת היוחסין. מידע נוסף זמין במאמר תצוגת רשימה של שושלת נתונים.
Java
import com.google.api.gax.rpc.ApiException;
import com.google.cloud.datacatalog.lineage.v1.BatchSearchLinkProcessesRequest;
import com.google.cloud.datacatalog.lineage.v1.EntityReference;
import com.google.cloud.datacatalog.lineage.v1.EventLink;
import com.google.cloud.datacatalog.lineage.v1.LineageClient;
import com.google.cloud.datacatalog.lineage.v1.LineageEvent;
import com.google.cloud.datacatalog.lineage.v1.Link;
import com.google.cloud.datacatalog.lineage.v1.ListLineageEventsRequest;
import com.google.cloud.datacatalog.lineage.v1.ListRunsRequest;
import com.google.cloud.datacatalog.lineage.v1.LocationName;
import com.google.cloud.datacatalog.lineage.v1.ProcessLinks;
import com.google.cloud.datacatalog.lineage.v1.Run;
import com.google.cloud.datacatalog.lineage.v1.SearchLinksRequest;
import java.io.IOException;
import java.util.ArrayList;
import java.util.HashSet;
import java.util.LinkedList;
import java.util.List;
import java.util.Queue;
import java.util.Set;

public class ViewLineageExample {

  public static void main(String[] args) throws IOException {
    // TODO(developer): Replace these variables before running the sample.
    String projectId = "my-project-id";
    String location = "us";
    String targetFullyQualifiedName = "bigquery:my-project-id.my_dataset.my_table";
    int maxDepth = 3;

    viewLineage(projectId, location, targetFullyQualifiedName, maxDepth);
  }

  static class Node {
    String fqn;
    int depth;
    Node(String fqn, int depth) {
      this.fqn = fqn;
      this.depth = depth;
    }
  }

  public static void viewLineage(
      String projectId, String location, String targetFullyQualifiedName, int maxDepth)
      throws IOException {
    // Initialize client that will be used to send requests. This client only needs
    // to be created once, and can be reused for multiple requests.
    try (LineageClient client = LineageClient.create()) {
      String parent = LocationName.of(projectId, location).toString();

      Set<String> visitedNodes = new HashSet<>();
      Queue<Node> queue = new LinkedList<>();

      visitedNodes.add(targetFullyQualifiedName);
      queue.offer(new Node(targetFullyQualifiedName, 0));

      while (!queue.isEmpty()) {
        Node current = queue.poll();
        System.out.printf("\nExploring node (Depth %d): %s\n", current.depth, current.fqn);

        if (current.depth >= maxDepth) {
          continue;
        }

        EntityReference targetEntity =
            EntityReference.newBuilder().setFullyQualifiedName(current.fqn).build();
        SearchLinksRequest searchLinksRequest =
            SearchLinksRequest.newBuilder().setParent(parent).setTarget(targetEntity).build();

        List<String> linkNames = new ArrayList<>();
        try {
          // 1. Search for links related to the target entity
          for (Link link : client.searchLinks(searchLinksRequest).iterateAll()) {
            linkNames.add(link.getName());
          }
        } catch (ApiException e) {
          System.out.printf("  Failed to retrieve links for %s: %s\n", current.fqn, e.getMessage());
          continue;
        }

        if (linkNames.isEmpty()) {
          continue;
        }

        // 2. Batch search for processes in chunks of 100
        for (int i = 0; i < linkNames.size(); i += 100) {
          List<String> batch = linkNames.subList(i, Math.min(linkNames.size(), i + 100));
          BatchSearchLinkProcessesRequest batchSearchRequest =
              BatchSearchLinkProcessesRequest.newBuilder()
                  .setParent(parent)
                  .addAllLinks(batch)
                  .build();

          try {
            for (ProcessLinks processLinks :
                client.batchSearchLinkProcesses(batchSearchRequest).iterateAll()) {
              String processName = processLinks.getProcess();
              System.out.printf("  Process: %s\n", processName);

              // 3. List runs for the process
              ListRunsRequest runsRequest =
                  ListRunsRequest.newBuilder().setParent(processName).build();
              for (Run run : client.listRuns(runsRequest).iterateAll()) {
                System.out.printf("    Run: %s\n", run.getName());

                // 4. List events for the run
                ListLineageEventsRequest eventsRequest =
                    ListLineageEventsRequest.newBuilder().setParent(run.getName()).build();
                for (LineageEvent event : client.listLineageEvents(eventsRequest).iterateAll()) {
                  for (EventLink eventLink : event.getLinksList()) {
                    String sourceFqn = eventLink.getSource().getFullyQualifiedName();
                    // If exploring upstream, queue the source
                    if (!sourceFqn.isEmpty() && !visitedNodes.contains(sourceFqn)) {
                      visitedNodes.add(sourceFqn);
                      queue.offer(new Node(sourceFqn, current.depth + 1));
                    }
                  }
                }
              }
            }
          } catch (ApiException e) {
            System.out.printf("  Failed to retrieve processes/runs: %s\n", e.getMessage());
          }
        }
      }
    }
  }
}
Python
from google.cloud import datacatalog_lineage_v1
from google.api_core.exceptions import GoogleAPICallError

def view_lineage(project_id: str, location: str, target_fully_qualified_name: str, max_depth: int = 3):
    """Retrieves lineage for a given entity using a depth-limited search."""
    client = datacatalog_lineage_v1.LineageClient()
    parent = f"projects/{project_id}/locations/{location}"

    # Store visited nodes to avoid infinite loops in cyclic graphs
    visited_nodes = set([target_fully_qualified_name])
    queue = [(target_fully_qualified_name, 0)]

    while queue:
        current_node, current_depth = queue.pop(0)
        print(f"\nExploring node (Depth {current_depth}): {current_node}")

        if current_depth >= max_depth:
            continue

        target_entity = datacatalog_lineage_v1.EntityReference(
            fully_qualified_name=current_node
        )
        search_links_request = datacatalog_lineage_v1.SearchLinksRequest(
            parent=parent,
            target=target_entity,
        )

        try:
            links = list(client.search_links(request=search_links_request))
        except GoogleAPICallError as e:
            print(f"  Failed to retrieve links for {current_node}: {e.message}")
            continue

        if not links:
            continue

        # Extract link names to query processes in batches
        link_names = [link.name for link in links]

        # Batch max size is 100
        for i in range(0, len(link_names), 100):
            batch = link_names[i:i + 100]
            batch_request = datacatalog_lineage_v1.BatchSearchLinkProcessesRequest(
                parent=parent,
                links=batch
            )

            try:
                for process_links in client.batch_search_link_processes(request=batch_request):
                    process_name = process_links.process
                    print(f"  Process: {process_name}")

                    runs_request = datacatalog_lineage_v1.ListRunsRequest(parent=process_name)
                    for run in client.list_runs(request=runs_request):
                        print(f"    Run: {run.name}")

                        events_request = datacatalog_lineage_v1.ListLineageEventsRequest(parent=run.name)
                        for event in client.list_lineage_events(request=events_request):
                            for event_link in event.links:
                                source_fqn = event_link.source.fully_qualified_name

                                # If exploring upstream, queue the source
                                if source_fqn and source_fqn not in visited_nodes:
                                    visited_nodes.add(source_fqn)
                                    queue.append((source_fqn, current_depth + 1))

            except GoogleAPICallError as e:
                 print(f"  Failed to retrieve processes/runs: {e.message}")
שיפור התצוגה החזותית של שושלת היוחסין
כדי לשפר את התצוגה החזותית של שושלת היוחסין, אתם יכולים להשתמש באפשרויות ההדגשה והסינון ב-Lineage explorer:
כדי לחפש פרויקטים, מערכי נתונים או שמות ישויות ספציפיים, משתמשים בחלונית Filters.
אחרי שמפעילים מסננים, צומתי שושלת שמתאימים לקריטריונים של הסינון נחשבים לצמתים תואמים. אתם יכולים לשנות את האופן שבו מוצגים צמתים תואמים ולא תואמים.
בתרשים השושלת, לוחצים על סמל האפשרויות הנוספות שנמצא ליד הלחצן Clear filters כדי לראות את אפשרויות התצוגה.
בוחרים אחת מהאפשרויות הבאות או את שתיהן:

אפשר לבחור את שתי האפשרויות בו-זמנית. אם שתי האפשרויות נבחרו, הצמתים שלא סוננו מוסתרים והצמתים התואמים מודגשים בתצוגת התרשים המסונן.
השבתה של שושלת הנתונים
כדי להפסיק את המעקב אחרי שושלת הנתונים ולהימנע מחיובים על שושלת נתונים, צריך להשבית את Data Lineage API (datalineage.googleapis.com) בכל פרויקט שבו הוא מופעל.
השבתת Dataplex API לא משביתה את שושלת היוחסין של הנתונים ולא מפסיקה את החיובים עליה. צריך להשבית את Data Lineage API.
כדי להשבית את שושלת היוחסין של הנתונים, בוחרים באחת מהכרטיסיות הבאות ומבצעים את השלבים בכל פרויקט שבו הופעל מעקב אחר שושלת היוחסין:
המסוף
במסוף Google Cloud , נכנסים לדף Enabled APIs & services.
ברשימת ממשקי ה-API, לוחצים על Data Lineage API.
לוחצים על השבתת ה-API.
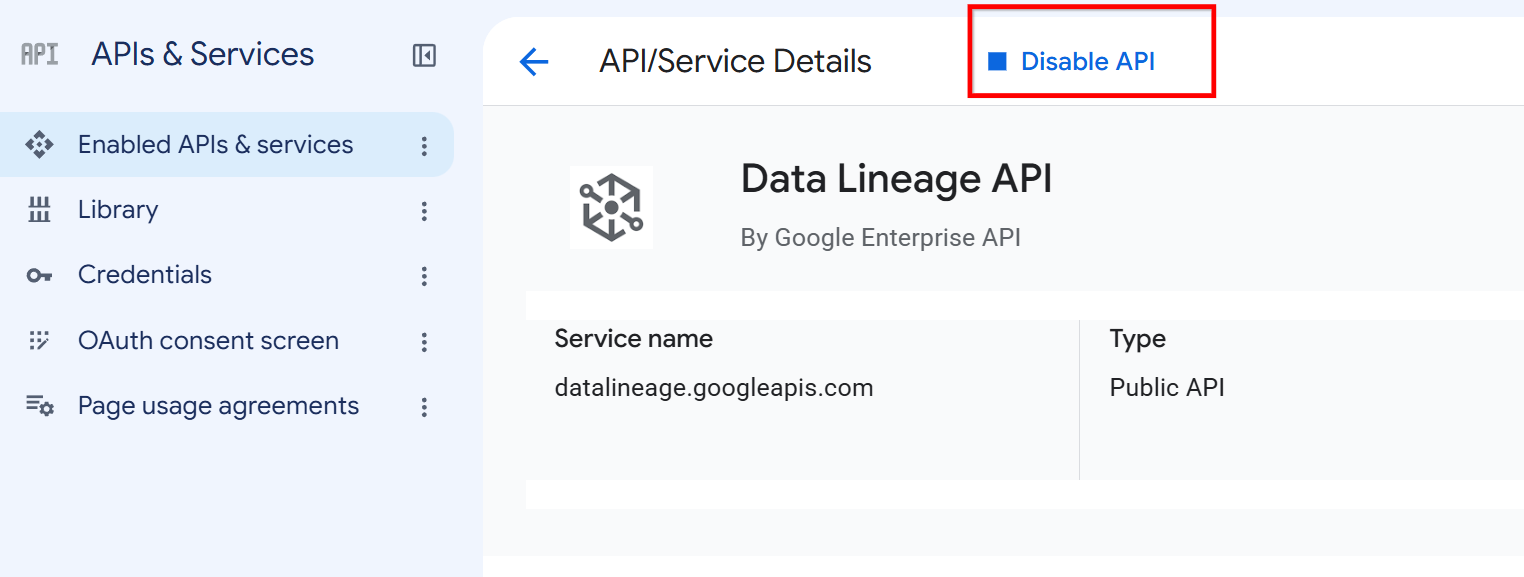
הלחצן Disable API בדף הפרטים של Data Lineage API כשמופיעה בקשה, לוחצים על השבתה.
gcloud
כדי להשבית את Data Lineage API, משתמשים בפקודה gcloud services
disable:
gcloud services disable datalineage.googleapis.com --project=PROJECT_ID
מחליפים את מה שכתוב בשדות הבאים:
-
PROJECT_ID: מזהה הפרויקט ב- Google Cloud
אם רוצים להפסיק את המעקב אחרי שושלת הנתונים בשירותים ספציפיים בלי להשבית את ה-API לגמרי, אפשר לעיין במאמר הגדרת הטמעת שושלת נתונים לשירות.
המאמרים הבאים
- מעקב אחרי שושלת נתונים של טבלה ב-BigQuery.
- מידע על מודל המידע של שושלת נתונים
- מידע ולמידה על שיקולים ומגבלות בנוגע למעקב אחר שושלת נתונים
- מידע על רישום ביומן הביקורת של Data Lineage API
- פתרון בעיות בשושלת נתונים
- שילוב עם OpenLineage.
- שימוש בשושלת נתונים עם Managed Service for Apache Spark