


משימות איכות הנתונים ב-Knowledge Catalog מאפשרות להגדיר כללים שמבוססים על YAML כדי לאמת טבלאות ב-BigQuery וב-Cloud Storage בלי לנהל את התשתית. אתם יכולים לתזמן בדיקות כדי להחיל אפשרויות לניהול השימוש בנתונים קבועות בסביבות BigQuery, לעקוב אחרי קבוצות נתונים בפייפליינים בסביבת הייצור וליצור דוחות בהתאם לדרישות הרגולטוריות.
מתי ליצור משימות לבדיקת איכות הנתונים ב-Knowledge Catalog
משימות איכות הנתונים של Knowledge Catalog יכולות לעזור לכם:
- אימות נתונים כחלק מצינור עיבוד נתונים.
- עוקבים באופן קבוע אחרי איכות מערכי הנתונים בהתאם לציפיות שלכם.
- ליצור דוחות על איכות הנתונים כדי לעמוד בדרישות הרגולטוריות.
יתרונות
- מפרטים שניתנים להתאמה אישית. אתם יכולים להשתמש בתחביר YAML הגמיש מאוד כדי להצהיר על כללי איכות הנתונים.
- הטמעה ללא שרת (serverless). לא צריך להגדיר תשתית בשביל Knowledge Catalog.
- העתקה אפסית ודחיפה אוטומטית. בדיקות YAML מומרות ל-SQL ומועברות ל-BigQuery, כך שאין צורך להעתיק נתונים.
- בדיקות איכות נתונים שאפשר לתזמן. אתם יכולים לתזמן בדיקות של איכות הנתונים באמצעות המתזמן ללא שרת ב-Knowledge Catalog, או להשתמש ב-Dataplex API באמצעות מתזמנים חיצוניים כמו Managed Airflow לשילוב צינור עיבוד נתונים.
- חוויית שימוש מנוהלת. ב-Knowledge Catalog נעשה שימוש במנוע קוד פתוח לבדיקת איכות הנתונים, CloudDQ, כדי להריץ בדיקות של איכות הנתונים. עם זאת, Knowledge Catalog מספק חוויה מנוהלת וחלקה לביצוע בדיקות של איכות הנתונים.
איך פועלות משימות של איכות נתונים
בתרשים הבא מוצג איך פועלות משימות איכות הנתונים של Knowledge Catalog:
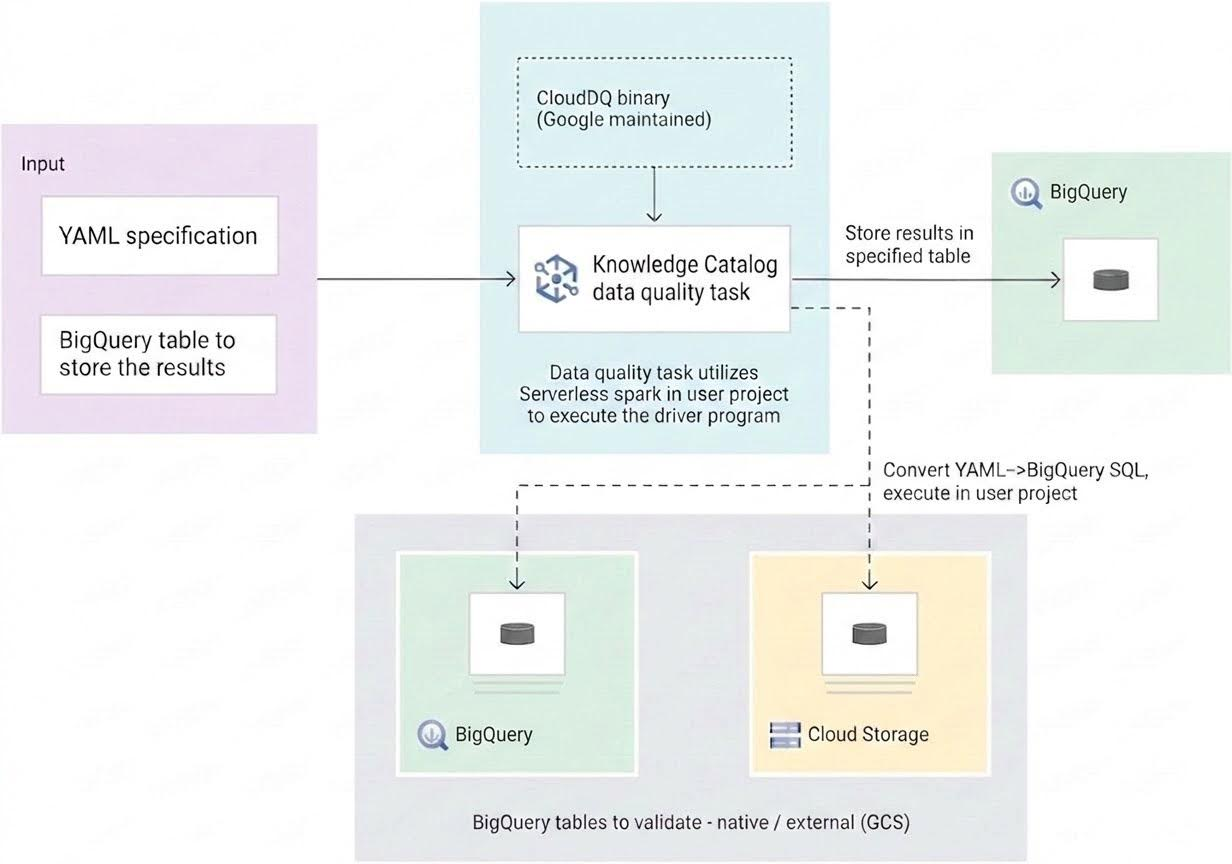
- קלט ממשתמשים
- מפרט YAML: קבוצה של קובץ YAML אחד או יותר שמגדירים כללים לאיכות הנתונים על סמך תחביר המפרט. אתם מאחסנים את קובצי ה-YAML בקטגוריה של Cloud Storage בפרויקט. המשתמשים יכולים להריץ כמה כללים בו-זמנית, ולהחיל אותם על טבלאות שונות ב-BigQuery, כולל טבלאות במערכי נתונים או בפרויקטים שונים ב- Google Cloud. המפרט תומך בהפעלות מצטברות לאימות נתונים חדשים בלבד. כדי ליצור מפרט YAML, קראו את המאמר יצירת קובץ מפרט.
- טבלת תוצאות ב-BigQuery: טבלה שהמשתמשים מציינים, שבה נשמרות תוצאות האימות של איכות הנתונים. הפרויקט ב- Google Cloud שבו נמצאת הטבלה הזו יכול להיות פרויקט שונה מהפרויקט שבו משתמשים במשימה של בקרת איכות הנתונים ב-Knowledge Catalog.
- טבלאות לאימות
- במפרט ה-YAML, צריך לציין אילו טבלאות רוצים לאמת לפי אילו כללים, פעולה שנקראת גם קישור כללים. הטבלאות יכולות להיות טבלאות מקוריות של BigQuery או טבלאות חיצוניות של BigQuery ב-Cloud Storage. מפרט ה-YAML מאפשר לכם לציין טבלאות בתוך או מחוץ לאזור של Knowledge Catalog.
- טבלאות ב-BigQuery וב-Cloud Storage שעוברות אימות בהרצה אחת יכולות להיות שייכות לפרויקטים שונים.
- משימת איכות נתונים ב-Knowledge Catalog: משימת איכות נתונים ב-Knowledge Catalog מוגדרת באמצעות קובץ בינארי מנוהל ומוכן מראש של CloudDQ PySpark, ומקבלת כקלט את מפרט ה-YAML ואת טבלת התוצאות של BigQuery. בדומה למשימות אחרות של Knowledge Catalog, המשימה של בקרת איכות הנתונים ב-Knowledge Catalog פועלת בסביבת Spark ללא שרת (serverless), ממירה את מפרט ה-YAML לשאילתות BigQuery ואז מריצה את השאילתות האלה בטבלאות שמוגדרות בקובץ המפרט.
תמחור
כשמריצים משימות של איכות נתונים ב-Knowledge Catalog, מחויבים על השימוש ב-BigQuery וב-Managed Service for Apache Spark (משימות באצ').
משימת איכות הנתונים של Knowledge Catalog ממירה את קובץ המפרט לשאילתות BigQuery ומריצה אותן בפרויקט של המשתמש. למחירון של BigQuery
ב-Knowledge Catalog נעשה שימוש ב-Spark כדי להריץ את תוכנית הדרייבר CloudDQ בקוד פתוח, שנוצרה מראש ומנוהלת על ידי Google, כדי להמיר את מפרט המשתמש לשאילתות BigQuery. התמחור של Managed Service for Apache Spark
אין חיובים על שימוש ב-Knowledge Catalog כדי לארגן נתונים או על שימוש בתזמון ללא שרת (serverless) ב-Knowledge Catalog כדי לתזמן בדיקות של איכות הנתונים. למחירון של Knowledge Catalog