


Knowledge Catalog 脈絡集可讓您將資料結構定義、語意定義和經過驗證的查詢模式,封裝至有界限的特定領域知識容器。這類特定領域知識可為 Gemini Enterprise 和自訂代理等自主 AI 應用程式提供可靠的基準,確保運作時能精準無誤。
本文適用對象為資料架構師、治理主管和 AI 工程師,旨在說明脈絡集如何為 AI 代理建構領域知識。
什麼是情境組合?
「情境集」是專門的 Knowledge Catalog 項目群組 (中繼資料記錄的邏輯容器),可封裝特定分析領域和 AI 代理的語意資訊和資料資產參照,且不含外部依附元件。
在這個容器中,知識會整理成項目,代表個別業務概念、文件或資料資產。這些項目會透過切面進行擴充,切面是模組化中繼資料屬性,可儲存業務條款、SQL 範本和 Markdown 說明文件等特定詳細資料。
如果強制代理搜尋整個企業目錄,會導致延遲、浪費提示詞元,並可能產生幻覺答案。相較之下,脈絡集可建立封閉、特定領域的知識容器,讓代理能精準查詢。
由於情境集可做為管理容器,您可以依專案擁有權整理中繼資料,並一次對所有套裝項目套用 Identity and Access Management (IAM) 存取控管政策,不必個別設定權限。如要進一步瞭解項目群組、項目和切面,請參閱「關於中繼資料管理」。
AI 代理基準建立需求
組織部署自主 AI 代理 (例如 Gemini Enterprise、Antigravity 和自訂 Agent Development Kit 代理) 來自動調度管理資料工作流程及生成數據分析時,代理需要可靠的基準:
- 語意定義:特定資料欄或指標在業務方面代表什麼意義?
- 經過驗證的查詢模式:領域專家如何成功查詢及彙整這些資料表?
- 作業規則:哪些業務政策、例外條件和標準作業程序 (SOP) 控管這項資料?
建議的脈絡資料集命名模式
下列架構圖說明四種核心邏輯命名慣例如何在項目群組邊界內共同運作,為下游 AI 應用程式奠定基礎:
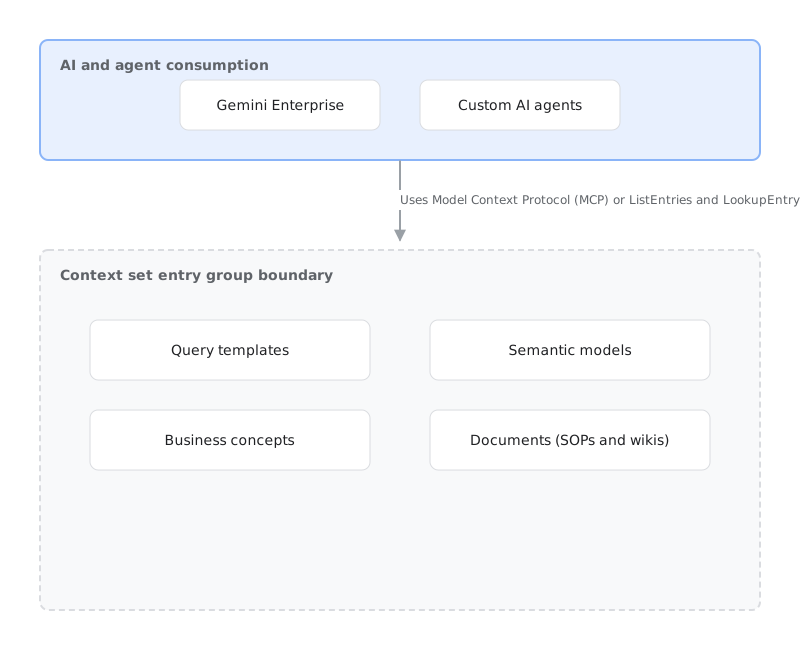
雖然情境集不一定要包含所有類型的項目才能運作,但建議您使用下列邏輯命名慣例來整理項目。使用這些命名慣例,有助於確保人類和自主代理能一致地探索及解讀知識:
| 命名模式 | 項目類型 | 說明和用途 | 附加的切面 |
|---|---|---|---|
業務概念 concepts_<id> |
generic |
組織詞彙、指標定義、縮寫和計算公式。 | glossary-term-aspect,contacts。 |
文件 documents_<path> |
document |
敘述背景、標準作業程序 (SOP)、新進人員訓練維基,以及外部說明文件的指標。 | Document、overview (RTF 格式 Markdown 和連結)。 |
查詢範本 query-templates_<path> |
query-template |
預先驗證的參數化 SQL 查詢範本、高頻率彙整邏輯和執行模式。 | query-template (包含來源、意圖、nlQuery、參數和查詢等欄位)。 |
語意模型 semantic-models_<id> |
semantic-model、semantic-entity、semantic-metric |
正式關聯模型、實體定義、維度階層和測量指標。 | semantic-model、semantic-entity、semantic-metric。 |
業務概念
業務概念項目 (使用 concepts_* 命名慣例的一般類型項目) 定義標準化業務術語、網域指標、縮寫和計算公式 (glossary-term-aspect)。
主要功能包括:
- 術語一致:消除各業務單位和分析團隊之間的術語模糊地帶。
- KPI 公式:提供特定領域主要成效指標 (KPI) 的數學公式和邏輯。
- 組織擁有權:透過附加的治理層面 (
contacts) 建立明確的組織擁有權。
舉例來說,在電子商務情境集中,concepts_net_items_sold 的項目會指定確切的淨售出單位計算方式。當代理收到要求「淨銷售商品數」的提示時,會參考概念項目,套用經過驗證的計算方式,而非自行建立 SQL 邏輯。
資源表示法範例:
name: projects/cymbal-style/locations/us-central1/entryGroups/online-apparel-store/entries/concepts_net_items_sold
entryType: generic
aspects:
  dataplex-types.global.glossary-term-aspect:
    definition: "Calculates the absolute number of items sold minus customer returns in a given time period."
文件
文件項目 (使用 documents_* 命名慣例的文件類型項目) 會以結構化 Markdown (Document、overview) 儲存敘述和程序背景資訊。
主要功能包括:
- 標準作業程序 (SOP):直接在目錄中擷取 SOP、執行手冊檢查清單和新進人員訓練指南。
- 法規遵循政策:記錄法規遵循政策、法規限制 (例如 GDPR 或 HIPAA 處理規則) 和例外條件。
- 外部參考維基:透過來源 URI 指標 (
overview連結) 參考外部即時維基 (例如 Google 文件、Atlassian Confluence、Notion 或 GitHub)。
舉例來說,服飾情境集包含 documents_return_policy_rules,指示代理在計算標準退貨率時,如何排除已完成的銷售和運送途中損壞的商品。
資源表示法範例:
name: projects/cymbal-style/locations/us-central1/entryGroups/online-apparel-store/entries/documents_return_policy_rules
entryType: document
aspects:
  dataplex-types.global.overview:
    content: "## Return Policy Rules\nItems marked FINAL_SALE or DAMAGED_IN_TRANSIT are excluded from return rates..."
查詢範本
查詢範本項目 (使用 query-templates_* 命名慣例的 query-template 類型項目) 包含經人工驗證的參數化 SQL 查詢,這些查詢會對應至常見的自然語言分析意圖 (使用 query-template 方面)。
主要功能包括:
- 預先驗證的查詢:儲存預先驗證的彙整路徑、篩選條件和匯總模式,用於高頻率的業務問題。
- 執行階段參數化:支援執行階段參數替換 (例如
@start_date、@region和@limit),以便動態執行代理。 - 預防錯誤:避免幻覺資料表彙整和 SQL 方言語法錯誤。
舉例來說,當代理需要回答有關成效最佳帳戶的問題時,會比對 query-templates_sales_top_accounts_by_arr,並將要求的日期範圍代入已驗證的 SQL 範本。
資源表示法範例:
name: projects/cymbal-style/locations/us-central1/entryGroups/online-apparel-store/entries/query-templates_top_categories_by_season
entryType: query-template
aspects:
  dataplex-types.global.query-template:
    intent: "Which e-commerce product categories performed best this season?"
    query: "SELECT category, SUM(revenue) FROM sales WHERE season = @season GROUP BY category ORDER BY 2 DESC LIMIT @limit"
    parameters:
      -   name: "season"
        type: "STRING"
      -   name: "limit"
        type: "INTEGER"
語意模型
語意模型項目 (使用 semantic-models_* 命名慣例的 semantic-model、semantic-entity 和 semantic-metric 項目類型) 會將正規化資料表中的關聯結構、維度階層和匯總測量結果正規化。
主要功能包括:
關係定義:定義主鍵、外鍵和彙整基數 (例如一對多或多對多關係)。
業務維度對應:將原始基礎資料欄對應至業務維度、時間精細度和可重複使用的測量指標。
代理引導:在沒有確切查詢範本的情況下,引導自主代理組合複雜的多資料表分析查詢。
抽象化底層複雜性:原始結構定義彙整項目連結只會記錄來源資料集中的機械資料表連線,語意模型則在邏輯業務層運作,可防止 AI 代理產生錯誤的 ER 圖表遍歷幻覺。
舉例來說,服飾情境集會使用 semantic-models_apparel_sales_model 定義 warehouses、shipments 和 line_items 如何在星形結構定義事實和維度資料表之間彙整。
資源表示法範例:
name: projects/cymbal-style/locations/us-central1/entryGroups/online-apparel-store/entries/semantic-models_apparel_sales_model
entryType: semantic-model
aspects:
  dataplex-types.global.semantic-model:
    entities:
      -   name: "products"
      -   name: "orders"
    relationships:
      -   sourceEntity: "orders"
        foreignKey: "product_id"
        targetEntity: "products"
        primaryKey: "id"
        type: "MANY_TO_ONE"
範例:線上服飾店情境組合
為了說明這四種命名慣例如何搭配運作,我們以線上服飾零售商為例,假設他們為商店商品經理部署 AI 助理。如果沒有限定情境,代理可能會查詢原始暫存資料表,或未扣除顧客退貨商品,導致熱門商品數量計算錯誤。
為了建立代理的基準,資料管理員會建立名為 online-apparel-store 的情境集:
EntryGroup: projects/cymbal-style/locations/us-central1/entryGroups/online-apparel-store
(EntryGroup.type = "context-set")
│
├── concepts_* (Business concepts)
│   ├── concepts_net_items_sold
│   │     Formula: SUM(orders.quantity) - SUM(returns.quantity)
│   └── concepts_bestseller
│         Definition: Any clothing item with >= 500 net units sold within a 30-day window
│
├── documents_* (Documents and SOPs)
│   ├── documents_return_policy_rules
│   │     Markdown SOP: Exclude items marked 'FINAL_SALE' or 'DAMAGED_IN_TRANSIT' from standard return rates
│   └── documents_size_chart_guide
│         Markdown guide: Sizing conversions across US, UK, and EU clothing labels
│
├── query-templates_* (Golden SQL queries)
│   └── query-templates_top_categories_by_season
│         Verified SQL template with parameters: @season, @limit
│
└── semantic-models_* (Semantic models)
    └── semantic-models_apparel_sales_model
          Join keys: orders.product_id = products.product_id (many-to-one)
                     orders.order_id = returns.order_id (one-to-many)
代理如何解析提示
當商品企劃人員詢問代理:「前 5 大暢銷冬季外套款式為何?請排除因損壞而退貨的商品」,代理會透過設定的脈絡解析提示:
查詢範本查詢:代理會檢查
query-templates_*並比對query-templates_top_categories_by_season,然後替換@season = 'Winter'和@limit = 5。概念驗證:代理檢查
concepts_net_items_sold和concepts_bestseller,確認退貨商品必須從訂單總數量中扣除。SOP 規則強制執行:代理讀取
documents_return_policy_rules,並新增篩選條件WHERE return_reason != 'DAMAGED_IN_TRANSIT'。結構定義和彙整驗證:代理會使用
semantic-models_apparel_sales_model和連結的@bigquery資料表,透過經過驗證的外鍵彙整store.orders、store.products和store.returns,並執行 SQL 查詢。
架構功能
情境集可為企業資料環境提供多項核心功能:
Hermetic execution boundaries: By bounding context to a curated set of assets and semantic entries, agents operate within a hermetic sandbox. 這能消除目錄中的多餘雜訊、確保評估結果確定,並盡可能減少權杖用量。
快速上傳和大量建立索引:團隊可以將一組概念、查詢和文件上傳並建立索引,做為單一原子作業,以便與持續整合和部署 (CI/CD) 管道整合。
零複製封裝:Context 會設定套件中繼資料和關係,而不複製或移動基礎資料儲存庫,避免產生多餘的儲存費用和資料同步延遲。
代理諮詢模式
下游代理會透過 Model Context Protocol (MCP) 或直接使用 Knowledge Catalog API,來取用情境集。詳情請參閱「使用 Catalog API 擷取資料情境」。為縮短回應延遲時間並盡量減少詞元用量,代理會遵循三層諮詢階層:
查詢範本比對:代理會搜尋
query-templates_*。如果經過驗證的範本符合使用者意圖,代理會將查詢參數化並直接執行。這種做法的回應速度最快,且查詢錯誤的風險趨近於零。語意模型組合:如果沒有相符的查詢範本,代理會評估
semantic-models_*,瞭解實體關係並建構多資料表 SQL 陳述式。文件和概念諮詢:對於模稜兩可的極端案例 (例如會計年度截止日期或爭議排除),代理會讀取
concepts_*和documents_*,以套用業務規則。
在生成式 AI 應用程式中使用脈絡
生成式 AI 應用程式會使用精選情境組合,瞭解企業領域語意、瀏覽複雜結構定義,並生成可靠的 SQL,不會產生幻覺。應用程式通常會透過兩種主要模式使用這些情境組合:
動態情境探索:在對話式或自助式數據分析環境中,使用者會以自然語言提出臨時問題。應用程式會動態評估使用者的意圖,從 Knowledge Catalog 中找出並擷取最相關的背景資訊集,然後將擷取的領域知識插入有效的提示中。
預先設定的脈絡資料集:如果是專用代理應用程式,您可以提供資源 URI,預先設定代理,並明確參照脈絡資料集。繫結專屬情境集可提供確定性的基準,確保所有互動都使用經過認證的業務定義,不會產生執行階段搜尋負擔。隨著週期性擴充工作流程不斷精進情境集,代理會自動繼承品質改善成果。
為充分發揮這些擴充和自我學習功能,建議在 Gemini Enterprise 應用程式中指定 Gemini 3.8 Flash 或更新的模型。如要進一步瞭解模型選取步驟,請參閱「在 Agent Studio 設計代理」中的「使用流程建構工具建立代理」一節。
情境集與相關建構的比較
如要為架構選擇合適的中繼資料建構,請參閱 Knowledge Catalog 脈絡資料集與相關平台功能的比較。
脈絡資料集與脈絡圖的比較
內容圖和內容集是兩個獨立的建構,在 Knowledge Studio 架構中扮演不同的角色:
情境圖:整個組織的即時、全面語意拓撲。可連結基礎資料資產、組織詞彙字詞和互動追蹤記錄。您可以在「Explore」(探索) 介面中,以互動方式探索及遍歷這個開放圖譜。
情境組合:有界限、區域性且經過挑選的包裝單位。它會擷取特定領域知識子集,並密封封裝至項目群組 (
type="context-set"),供下游 AI 代理透過 Model Context Protocol (MCP) 查詢。在更廣泛的情境圖中,情境集會做為具凝聚力的高密度子圖。
Knowledge Catalog 脈絡資料集與資料庫脈絡資料集的比較
Knowledge Catalog 和 Google Cloud作業資料庫都使用「情境集」一詞,指稱用於建立生成式 AI 模型基準的精選資訊。
雖然這兩種變化版本都採用相同的基礎架構,原生儲存為 Knowledge Catalog 情境集 (具有 type="context-set" 的可擴充項目群組),並使用標準 Knowledge Catalog API,但兩者針對企業資料堆疊的不同層級:
- 資料庫情境集 (QueryData):專為提供營運、交易資料庫 (例如 AlloyDB for PostgreSQL、Cloud SQL 和 Spanner) 而建構。這些情境集經過高度最佳化,適用於 SQL 設定。這些資料集會彙整精確查詢範本、結構定義中繼資料和篩選層面,並由專屬的脈絡工程代理評估,以提升作業執行階段的自然語言轉 SQL (NL2SQL) 翻譯品質。
- Knowledge Catalog 情境集 (Knowledge Studio):專為分析資料資產 (例如 BigQuery、資料湖泊和 Knowledge Catalog 資料產品) 而建構。這些脈絡集會封裝更廣泛的多模態知識,涵蓋多種命名慣例,包括業務概念、Markdown 文件維基和語意模型。這些資料會透過 Knowledge Studio 擴充工作流程進行整理,並透過 Model Context Protocol (MCP) 提供給下游分析代理。
情境集與資料產品的比較
瞭解情境集如何與 Knowledge Catalog 資料產品互動,有助於您建立明確的資料和 AI 治理界線:
資料產品會管理基礎資源:資料產品會安全地整合具體資源,例如 BigQuery 資料表、bucket 和串流,建立資料共用、資料合約和資料層存取控管的主要單位。
情境集會彙整對話語意:情境集不會授予資料存取權,而是彙整 AI 代理和人員理解資料所需的領域知識,例如概念、查詢範本和文件。資料管理員只要在產品的
additional_context參照中宣告,即可將情境集連結至資料產品。
企業級安全防護和治理機制
情境集與 Google Cloud 安全性和管理控制項整合,有助於保護機密的企業中繼資料:
情境集 IAM 角色:情境集通常包含機密語意資訊,因此存取權是由直接套用至
context-set項目群組的 IAM 角色控管。這樣一來,您就能依地理區域和網域擁有權整理精選知識,並將修改權限授予網域管理員,以及將讀取權限授予使用的 AI 代理。如要建立情境集,您必須具備dataplex.entryGroups.setIamPolicyIAM 權限。必須具備這項權限,系統才能在建立情境集時自動授予擁有者權限。您可以透過預先定義的角色取得這項權限,例如 Dataplex Catalog 管理員 (roles/dataplex.catalogAdmin) 或 Dataplex 項目群組擁有者 (roles/dataplex.entryGroupOwner) 角色。零複製基礎資料安全性:授予代理存取情境集的權限,可讓代理讀取語意中繼資料和查詢範本,但不會略過基礎資料表的存取控管。如要對 BigQuery 執行 SQL 查詢,或讀取 Cloud Storage 中的檔案,執行查詢的身分必須具備這些基礎資源所需的資料層 IAM 權限。
人工介入迴路管理:當自主 Knowledge Studio 擴充工作從作業記錄中擷取新概念、SOP 或查詢範本時,提案會暫存為可審查的變更要求。資料管理員會先檢查差異比較和評估分數,再核准正式版情境集的變更。如要進一步瞭解提案審查,請參閱「管理要求」。
使用者自行管理的執行身分:Dataplex 服務代理會透過服務帳戶權杖建立者角色 (
roles/iam.serviceAccountTokenCreator) 模擬使用者自行管理的服務帳戶,並在該帳戶下執行自動擴充工作,填入內容集。
預覽範圍和界線
在預先發布版期間,情境集會受到下列限制:
區域範圍:不支援連結至區域資料資產的全域情境集。情境組合必須與其封裝資產的區域邊界一致。
編寫和使用介面:您可以透過 Google Cloud 控制台中的 Knowledge Studio 容器建立情境集,在邏輯上與標準 Knowledge Catalog 管理項目群組區隔。您可以透過 Knowledge Studio 擴充工作流程,自動填入情境集。下游 AI 代理可使用 Knowledge Catalog API (
ListEntries和LookupEntry) 和 Model Context Protocol (MCP),以程式輔助方式探索及查詢情境集。詳情請參閱「關於 MCP 伺服器」。計費:Knowledge Catalog 不會針對建立情境集項目群組,收取獨立 SKU 費用。
共用配額:脈絡資料集基本上是特殊項目群組 (
type="context-set"),因此會與標準 Knowledge Catalog 項目群組共用相同的資源配額。