


ב-Knowledge Catalog (לשעבר Dataplex Universal Catalog) אתם יכולים להגדיר ולמדוד את איכות הנתונים בטבלאות של BigQuery ושל Iceberg REST Catalog. אתם יכולים להגדיר שהסריקה של הנתונים תתבצע אוטומטית, לאמת את הנתונים לפי כללים מוגדרים ולרשום התראות ביומן אם הנתונים לא עומדים בדרישות האיכות. בעזרת Auto data quality אתם יכולים לנהל את הכללים והפריסות של איכות הנתונים כקוד, וכך לשפר את התקינות של צינורות עיבוד הנתונים.
כדי לסרוק נתונים ולחפש חריגות, אפשר לעיין במאמר סריקת פרופיל נתונים ב-Knowledge Catalog. הסריקה יכולה ליצור כללים לאיכות הנתונים. אפשר גם להשתמש בכללי איכות מובנים או ליצור כללים בהתאמה אישית.
Knowledge Catalog מספק מעקב, פתרון בעיות והתראות של Cloud Logging שמשולבים עם איכות נתונים אוטומטית.
מודל קונספטואלי
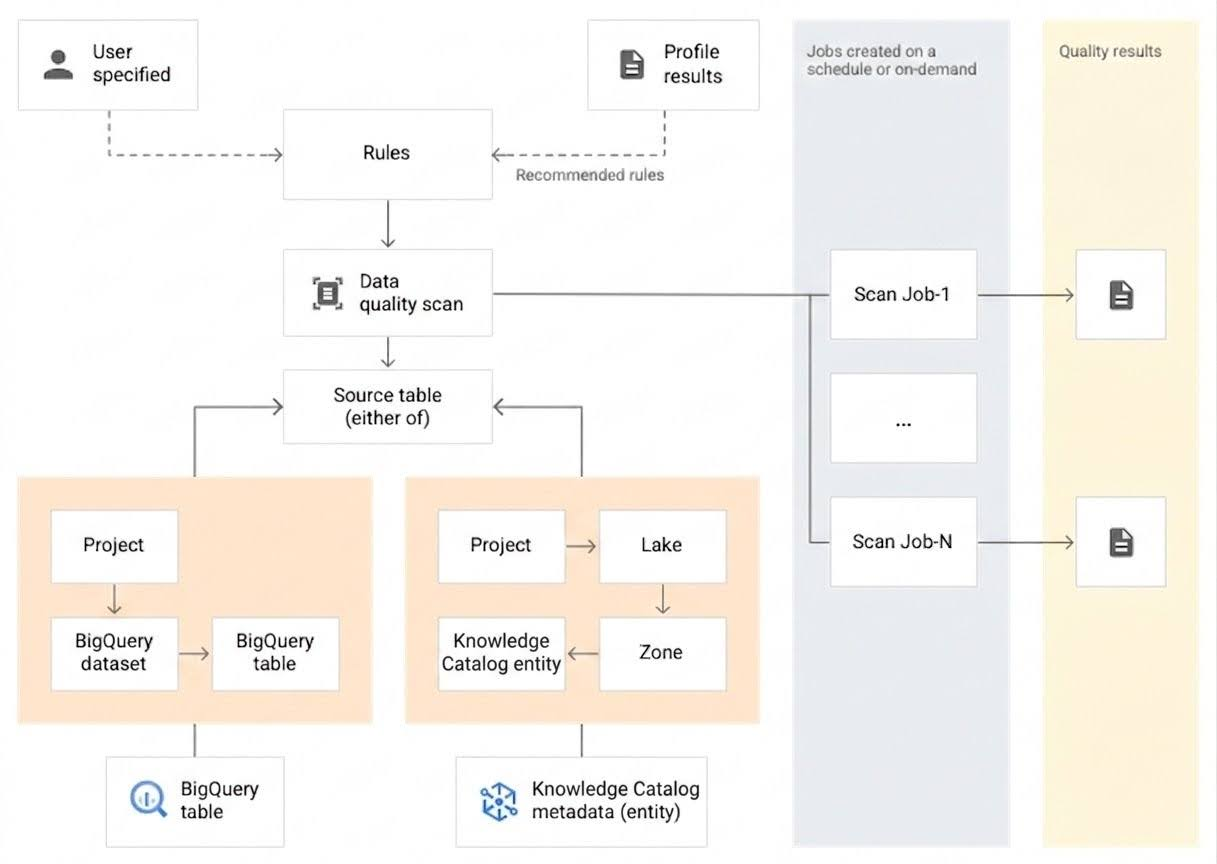
סריקה של איכות הנתונים היא סוג של סריקת נתונים ב-Knowledge Catalog שמאמתת את הנתונים שלכם בהתאם לקבוצה של כללים מובנים. סריקת נתונים היא משימה של Knowledge Catalog שדוגמת נתונים מ-BigQuery ומ-Cloud Storage (דרך טבלאות חיצוניות של BigQuery) ומסיקה סוגים שונים של מטא-נתונים. כדי למדוד את איכות הטבלה באמצעות איכות נתונים אוטומטית, יוצרים אובייקט DataScan מסוג data quality. הסריקה פועלת רק על טבלה אחת ב-BigQuery.
הסריקה משתמשת במשאבים בפרויקט דייר (tenant) של Google, כך שאין צורך להגדיר תשתית משלכם.
כדי ליצור סריקה של איכות הנתונים ולהשתמש בה, צריך לבצע את השלבים הבאים:
- הגדרת כללים לאיכות הנתונים
- הגדרת הפעלת הכללים
- ניתוח התוצאות של סריקת איכות הנתונים
- הגדרה של מעקב והתראות
- פתרון בעיות שקשורות לאיכות הנתונים
הגדרת הכלל
כללים לאיכות הנתונים שמשויכים לסריקה של איכות הנתונים מגדירים את הציפיות לגבי הנתונים. אפשר ליצור כללים לאיכות הנתונים בדרכים הבאות:
- להשתמש בהמלצות מפרופיל הנתונים של Knowledge Catalog
- שימוש בכללים המובנים או בתבניות של כללי מערכת
- יצירת כללי SQL בהתאמה אישית
- שימוש חוזר בכללים של איכות הנתונים
כללים מובְנים
ב-Knowledge Catalog יש תמיכה בקטגוריות הבאות של כללים מובנים:
- ברמת השורה
בכללים של קטגוריות ברמת השורה, הציפייה מוחלת על כל שורת נתונים. כל שורה עומדת בתנאי או לא עומדת בו באופן עצמאי. לדוגמה,
column_A_value < 1.בבדיקות ברמת השורה צריך לציין סף מעבר. כשאחוז השורות שעומדות בכלל נמוך מערך הסף, הכלל נכשל.
- צבירה
בכללים מצטברים, הציפייה מיושמת על ערך יחיד שמצטבר על פני כל הנתונים. לדוגמה,
Avg(someCol) >= 10. כדי שהבדיקה תעבור, הערך שלה צריך להיות בוליאניtrue. כללים מצטברים לא מספקים ספירה עצמאית של הצלחות או כישלונות לכל שורה.
בשתי קטגוריות הכללים אפשר להגדיר את הפרמטרים הבאים:
- העמודה שהכלל חל עליה
- מאפיין
בטבלה הבאה מפורטים סוגי הכללים הנתמכים ברמת השורה וברמת הצבירה:
| סוג הכלל (שם במסוף) Google Cloud |
כלל ברמת השורה או כלל מצטבר | תיאור | סוגי עמודות נתמכים | פרמטרים שספציפיים לכלל |
|---|---|---|---|---|
RangeExpectation(בדיקת טווח) |
ברמת השורה | בודקים אם הערך נמצא בין המינימום למקסימום. | כל העמודות מסוג מספר, תאריך וחותמת זמן. | חובה:
|
NonNullExpectation(בדיקת ערך Null) |
ברמת השורה | בודקים שערכי העמודות לא ריקים (NULL). | כל סוגי העמודות הנתמכים. | חובה:
|
SetExpectation(הגדרת המחאה) |
ברמת השורה | בדיקה אם הערכים בעמודה הם אחד מהערכים שצוינו בקבוצה. | כל סוגי העמודות הנתמכים, מלבד Record ו-Struct. |
חובה:
|
RegexExpectation(בדיקת ביטוי רגולרי) |
ברמת השורה | בודקים את הערכים מול ביטוי רגולרי מסוים. | String | חובה:
|
Uniqueness(בדיקת ייחודיות) |
צבירה | בודקים אם כל הערכים בעמודה הם ייחודיים. | כל סוגי העמודות הנתמכים, מלבד Record ו-Struct. |
חובה:
|
StatisticRangeExpectation(בדיקת נתונים סטטיסטיים) |
צבירה | בודקים אם המדד הסטטיסטי שצוין תואם לטווח הצפוי. | כל הסוגים הנתמכים של עמודות מספריות. | חובה:
|
סוגי כללי SQL נתמכים בהתאמה אישית
כללי SQL מאפשרים להרחיב את האימות באמצעות לוגיקה מותאמת אישית. הכללים האלה הם מהסוגים הבאים.
| סוג הכלל | כלל ברמת השורה או כלל מצטבר | תיאור | סוגי עמודות נתמכים | פרמטרים שספציפיים לכלל | דוגמה |
|---|---|---|---|---|---|
| תנאי השורה | ברמת השורה | מציינים ציפייה לכל שורה על ידי הגדרת ביטוי SQL בסעיף WHERE. הביטוי ב-SQL צריך להחזיר את הערך true (עבר) או false (נכשל) לכל שורה.ב-Knowledge Catalog מחושב אחוז השורות שעומדות בדרישה הזו, והערך הזה מושווה לאחוז הסף של השורות שעומדות בדרישה כדי לקבוע אם הכלל הצליח או נכשל. הביטוי יכול לכלול הפניה לטבלה אחרת, למשל כדי ליצור בדיקות של שלמות ההפניות. |
כל העמודות | חובה:
|
grossWeight <= netWeight |
| תנאי טבלה (ביטוי SQL מצטבר) |
צבירה | הכללים האלה מופעלים פעם אחת לכל טבלה. מזינים ביטוי SQL שהערך המחושב שלו הוא בוליאני true (עבר) או false (נכשל).ביטוי ה-SQL יכול לכלול הפניה לטבלה אחרת באמצעות שאילתות משנה של ביטויים. |
כל העמודות | חובה:
|
דוגמה פשוטה לחישוב מצטבר:avg(price) > 100שימוש בשאילתת משנה של ביטוי כדי להשוות ערכים בטבלה אחרת: (SELECT COUNT(*) FROM `example_project.example_dataset.different-table`) < COUNT(*) |
| טענת נכוֹנוּת (assertion) ב-SQL | צבירה | כלל אסרטיבי משתמש בשאילתת איכות נתונים כדי למצוא שורות שלא עומדות בתנאי אחד או יותר שצוינו בשאילתה. צריך לספק הצהרת SQL שמוערכת כדי להחזיר שורות שתואמות למצב לא תקין. אם השאילתה מחזירה שורות, הכלל נכשל. משמיטים את הנקודה-פסיק בסוף הצהרת ה-SQL. הצהרת ה-SQL יכולה לכלול הפניה לטבלה אחרת באמצעות שאילתות משנה של ביטויים. |
כל העמודות | חובה:
|
דוגמה פשוטה לצבירה כדי לוודא שהערך של discount_pct
לא גדול מ-100:SELECT * FROM example_project.example_dataset.table WHERE discount_pct > 100שימוש בשאילתת משנה של ביטוי כדי להשוות בין ערכים בטבלה אחרת: SELECT * FROM `example_project.example_dataset.different-table` WHERE gross_weight > (SELECT avg(gross_weight) FROM `example_project.example_dataset.different-table`)
|
דוגמאות לכללים מופיעות במאמר דוגמאות לכללים אוטומטיים לשיפור איכות הנתונים.
לרשימת פונקציות SQL נתמכות, ראו הפניה ל-GoogleSQL.
שימוש חוזר בכללים לאיכות הנתונים
אפשר לעשות שימוש חוזר בכללי איכות נתונים של Knowledge Catalog כדי לשתף הגדרות מורכבות או סטנדרטיות של כללים עסקיים בכמה כללי איכות נתונים באמצעות תבניות של כללים. לדוגמה, אפשר ליצור תבנית כלל לאימות של כתובת אימייל או לאימות של מפתח זר בין שתי טבלאות, ואז לעשות שימוש חוזר בתבניות האלה בסריקות הנתונים.
התכונות העיקריות של שימוש חוזר בכללים:
- תבניות של כללים לאיכות הנתונים: אתם יכולים ליצור תבניות של כללים בהתאמה אישית כדי לאחסן הגדרות מורכבות או סטנדרטיות של כללים עסקיים, שאפשר לשתף בין כמה כללים לאיכות הנתונים. יוצרים רשומה של
data-quality-rule-templateומוסיפים לה מאפיין שלdata-quality-rule-templateכדי להגדיר את הלוגיקה של התבנית. - כללי נתונים כמטא-נתונים: אפשר להצהיר על כללים לאיכות הנתונים כהיבטים ב-Knowledge Catalog ברשומות כמו טבלאות ב-BigQuery או מונחים במילון המונחים הארגוני. כדי לצרף את הכללים האלה לרשומות, משתמשים בסוג ההיבט
data-rules. - תבניות של כללי מערכת: אפשר להשתמש בתבניות של כללי מערכת לכללים שנמצאים בשימוש נפוץ.
מידע נוסף זמין במאמר בנושא שימוש חוזר בכללים לאיכות הנתונים.
מידות
מאפיינים מאפשרים לכם לצבור את התוצאות של כמה כללים לבדיקת איכות הנתונים לצורך מעקב והתראות. צריך לשייך כל כלל לאיכות הנתונים למאפיין. ב-Knowledge Catalog יש את המאפיינים הבאים:
- עדכניות
- עדכניות הנתונים מציינת מתי הנתונים עודכנו לאחרונה. המידע הזה יכול לעזור לכם להבין אם הנתונים עדכניים מספיק כדי להיות שימושיים.
- עוצמת הקול
- הנפח מציין אם כל הנתונים הצפויים קיימים.
- שלמות
- שלמות: האם הנתונים מכילים את כל המידע שנדרש למטרה שלשמה הם נאספו.
- תוקף
- תקינות: בודקים אם הנתונים עומדים בסטנדרטים מובְנים של פורמט, טווחים מקובלים או קריטריונים אחרים. לדוגמה, אם תאריך תקין צריך להיות בפורמט
YYYY/mm/dd, אז 08-12-2019 הוא נתון לא תקין. דוגמה נוספת: אם מחיר המבצע התקין של מוצר הוא בין 10 $ל-20$, מחיר מבצע של 100 $הוא נתון לא תקין. - עקביות
- עקביות מתייחסת לכך שיהיו אותם ערכים לנתונים בכמה מופעים, כמו טבלאות ועמודות. חוסר עקביות בנתונים מתרחש למשל כשההכנסה ממוצר מסוים שונה כשקוראים אותה ממסד נתונים של מכירות או ממסד נתונים של שימוש.
- דיוק
- הדיוק משקף את נכונות הנתונים. חשוב לזכור שנתונים תקינים הם לא בהכרח מדויקים. לדוגמה, צבע שיער חום הוא ערך תקין, אבל אם לאדם אין שיער חום, אלה נתונים לא מדויקים.
- ייחודיות
- המדד 'ייחודיות' בודק אם הנתונים שונים ואין כפילויות.
קלט שהוזן ידנית בכללים
כל הפרמטרים של הערכים מועברים ל-API כערכי מחרוזת. הקלט של Knowledge Catalog צריך להיות בפורמט שצוין ב-BigQuery.
אפשר להעביר פרמטרים מסוג בינארי כמחרוזת בקידוד Base64.
| סוג | פורמטים נתמכים | דוגמאות |
|---|---|---|
| בינארי | ערך בקידוד Base64 | YXBwbGU= |
| חותמת הזמן | YYYY-[M]M-[D]D[( |T)[H]H:[M]M:[S]S[.F]] [time_zone] OR YYYY-[M]M-[D]D[( |T)[H]H:[M]M:[S]S[.F]][time_zone_offset] |
2014-09-27 12:30:00.45-08 |
| תאריך | YYYY-M[M]-D[D] | 2014-09-27 |
| שעה | [H]H:[M]M:[S]S[.DDDDDD] | 12:30:00.45 |
| DateTime | YYYY-[M]M-[D]D [[H]H:[M]M:[S]S[.DDDDDD]] | 2014-09-27 12:30:00.45 |
פרמטר של הפניה לנתונים
כשיוצרים כלל SQL מותאם אישית, אפשר להפנות לטבלה של מקור נתונים ולכל המסננים של התנאים המוקדמים שלה באמצעות פרמטר ההפניה לנתונים ${data()} בכלל, במקום לציין במפורש את טבלת המקור והמסננים שלה.
Knowledge Catalog מפרש את הפרמטר כהפניה לטבלת המקור ולמסננים שלה. דוגמאות למסנני תנאי מוקדם: מסנני שורות, אחוזים של דגימה ומסננים מצטברים.
לדוגמה, נניח שיש לכם טבלה של מקור נתונים בשם my_project_id.dim_dataset.dim_currency. רוצים להריץ סריקה מצטברת של איכות הנתונים, שתסרוק רק נתונים יומיים חדשים. מסנן שורות שמסנן את הרשומות של היום, transaction_timestamp >= current_date(), מוחל על הטבלה.
כלל SQL מותאם אישית למציאת שורות עם discount_pct להיום נראה כך:
discount_pct IN (SELECT discount_pct FROM my_project_id.dim_dataset.dim_currency WHERE transaction_timestamp >= current_date())
אם משתמשים בפרמטר של הפניה לנתונים, אפשר לפשט את הכלל. מחליפים את האזכור של הטבלה ואת מסנני התנאים המוקדמים שלה בפרמטר ${data()}:
discount_pct IN (SELECT discount_pct FROM ${data()})
Knowledge Catalog מפרש את הפרמטר ${data()} כהפניה לטבלה של מקור הנתונים עם הרשומות של היום, my_project_id.dim_dataset.dim_currency WHERE transaction_timestamp >= current_date().
בדוגמה הזו, פרמטר ההפניה לנתונים מתייחס רק לנתונים המצטברים.
הפרמטר ${data()} הוא תלוי אותיות רישיות.
כשמשתמשים בכינוי בתוך שאילתת משנה כדי להפנות לעמודות בטבלת המקור,
צריך להשתמש בפרמטר של הפניה לנתונים כדי להפנות לטבלת המקור, או להשמיט את ההפניה לטבלה. אל תפנו לעמודות בטבלת המקור באמצעות הפניה ישירה לטבלה בקטע WHERE.
מומלץ:
משתמשים בפרמטר של הפניה לנתונים כדי להפנות לטבלת המקור:
discount_pct IN (
SELECT discount_pct FROM
`my_project_id.dim_dataset.dim_currency` AS temp-table
WHERE
temp-table.transaction_timestamp = ${data()}.timestamp
)
השמטת ההפניה לטבלה:
discount_pct IN (
SELECT discount_pct FROM
`another_project.another_dataset.another_table` AS temp-table
WHERE
temp-table.transaction_timestamp = timestamp
לא מומלץ:
אל תשתמשו בהפניה ישירה לטבלה כדי להפנות לעמודות בטבלת המקור:
discount_pct IN (
SELECT discount_pct FROM
`my_project_id.dim_dataset.dim_currency` AS temp-table
WHERE
temp-table.transaction_timestamp = `my_project_id.dim_dataset.dim_currency`.timestamp
)
שימוש תקין בטבלאות שונות:
אפשר להשתמש בהפניה ישירה לטבלה כשמשווים עמודות מטבלה אחרת:
discount_pct IN (
SELECT discount_pct FROM
`my_project_id.dim_dataset.dim_currency` AS temp-table
WHERE
temp-table.transaction_timestamp = `another_project.another_dataset.another_table`.timestamp
)
ניפוי באגים בשאילתות
כשיוצרים כלל, אפשר לכלול שאילתת ניפוי באגים שתופעל לצד הכלל. שאילתת ניפוי באגים היא הצהרת SQL שמחזירה עד 10 ערכים סקלריים. הערכים האלה יכולים לעזור לכם לאבחן את הסיבה לכך שהכלל נכשל. אפשר להוסיף לכל היותר שאילתת ניפוי באגים אחת לכל כלל, והאורך שלה לא יכול להיות יותר מ-1,024 תווים.
נניח שיש לנו את כלל טענת הנכוֹנוּת (assertion) הבא ב-SQL בטבלה example_project.example_dataset.table, שבודק אם ההכנסה הממוצעת לפריט גבוהה מ-100:
SELECT
  *
FROM
  `example_project.example_dataset.table`
WHERE
  SUM(revenue) / COUNT(DISTINCT item_id) > 100
אם הכלל הקודם נכשל, אתם יכולים לראות מדדים כמו סך ההכנסות, מספר הפריטים הייחודיים וההכנסה הממוצעת לפריט כדי לאבחן את הבעיה. שאילתת ניפוי הבאגים הבאה מחזירה את המדדים האלה:
SELECT
  SUM(revenue),
  COUNT(DISTINCT item_id),
  SUM(revenue) / COUNT(DISTINCT item_id)
FROM `example_project.example_dataset.table`
הפעלת הכלל
אתם יכולים לתזמן סריקות של איכות הנתונים כך שיפעלו במרווח זמן מסוים, או להריץ סריקה לפי דרישה.
זהות הביצוע
כברירת מחדל, ב-Knowledge Catalog נעשה שימוש בסוכן שירות מרכזי (service-PROJECT_NUMBER@gcp-sa-dataplex.iam.gserviceaccount.com) כדי להריץ סריקות של איכות הנתונים.
כדי לשנות את זהות הביצוע שמוגדרת כברירת מחדל, אתם יכולים לציין חשבון שירות בהתאמה אישית או להשתמש בפרטי הכניסה של משתמשי הקצה (EUC). יש לכך כמה יתרונות:
- עקרון ההרשאות המינימליות: מעניקים רק את הרשאות ה-IAM המדויקות שנדרשות למשימות ספציפיות שקשורות לאיכות הנתונים לחשבון שירות ייעודי, וכך מצמצמים את הגישה שניתנת מעבר לנדרש.
- בקרת גישה מדויקת: הגבלת ההרשאות למשאבים ספציפיים, כדי לאפשר שילוב עם כללי מדיניות של גישה ברמת השורה וברמת העמודה ב-BigQuery.
- יכולת ביקורת משופרת: הקצאת חשבונות שירות מותאמים אישית או פרטי כניסה של משתמש לסריקות ספציפיות מאפשרת לעקוב אחרי הפעילויות ולתעד אותן בצורה ברורה יותר ביומני ביקורת.
- איחוד החיוב: כשמשתמשים בזהות ביצוע מותאמת אישית, החיובים על העיבוד והאחסון מרוכזים ישירות ב-BigQuery (בלי לעבור דרך מק"טים של Knowledge Catalog Premium). כך תוכלו ליהנות מהנחות על BigQuery לארגונים ומהתחייבויות לשימוש במשבצות זמן.
במאמר הגדרת זהות להרצה מוסבר איך מגדירים זהות מותאמת אישית להרצה.
דרישות רשת
כדי להריץ סריקה, צריך להפעיל את הגישה הפרטית ל-Google בתת-הרשת של ה-VPC שבה משתמשים לסריקה. אם לא מציינים רשת משנה, צריך לוודא שמופעלת גישה פרטית ל-Google ברשת המשנה שמוגדרת כברירת מחדל.
כשמריצים סריקה של איכות הנתונים, נוצרת משימה ב-Knowledge Catalog. אם משימה מוגדרת באופן שגוי או פועלת יותר זמן מהצפוי, אפשר לבטל אותה.
במפרט של סריקת איכות הנתונים, אפשר להגדיר את היקף המשימה לאחת מהאפשרויות הבאות:
- טבלה מלאה
- כל עבודה מאמתת את כל הטבלה.
- מצטבר
- כל משימה מאמתת נתונים מצטברים. כדי לקבוע את הצעדים, צריך לספק עמודה
Date/Timestampבטבלה שאפשר להשתמש בה כסמן. בדרך כלל, זו העמודה שלפיה הטבלה מחולקת למחיצות.
סינון נתונים
אתם יכולים לסנן את הנתונים שנסרקים כדי לבדוק את איכות הנתונים באמצעות מסנן שורות. יצירת מסנן שורות מאפשרת לכם להתמקד בנתונים בפרק זמן מסוים או בפלח מסוים, כמו אזור מסוים. השימוש במסננים יכול לקצר את זמן הריצה ולהפחית את העלות. לדוגמה, אפשר לסנן נתונים עם חותמת זמן לפני תאריך מסוים.
נתונים לדוגמה
אתם יכולים לציין אחוז של רשומות מהנתונים שלכם לדגימה כדי להריץ סריקה של איכות הנתונים. יצירת סריקות של איכות הנתונים במדגם קטן יותר של נתונים יכולה לקצר את זמן הריצה ולהפחית את העלות בהשוואה לשאילתות על מערך הנתונים כולו.
כללי סינון
כשמריצים סריקה של איכות הנתונים, אפשר להשתמש בתחביר של מסנן AIP-160 כדי להריץ באופן סלקטיבי כללים ספציפיים. ב-Knowledge Catalog מתבצע סינון של המטא-נתונים של הכללים שהוגדרו בסריקה או של הכללים שצורפו לרשומה בקטלוג באמצעות ההיבט data-rules.
תחביר הסינון
תחביר המסנן תואם להנחיות של AIP-160. אפשר להשתמש באופרטורים רגילים של AIP-160 (כמו =, !=, >, <, =~) ולשלב כמה תנאים באמצעות AND או OR.
כשמשתמשים במחרוזת סינון של AIP-160, צריך לבצע את הפעולות הבאות:
- במסוף Google Cloud : מזינים את המסנן ישירות באמצעות תחביר AIP-160, לדוגמה
name = "critical_check". - בקריאה ל-API: מחרוזת המסנן היא בדרך כלל ערך בתוך מחרוזת ליטרל אחרת ב-JSON. כדי לעשות את זה, צריך להוסיף תו בריחה (escape) למירכאות הכפולות במחרוזת AIP-160. לדוגמה,
"filter": "name = \"critical_check\"".
שדות שניתן לסנן
אפשר לסנן לפי רוב השדות שזמינים בהגדרת הכלל:
-
name: השם המוצג של הכלל. dimension: מאפיין איכות הנתונים (לדוגמה,VALIDITY).-
column: שם העמודה שהכלל חל עליה. -
threshold: ערך הסף להעברה של הכלל. -
ignore_null: ערך בוליאני. כששורותtrueו-NULLנחשבות כשורות שעברו. -
attributes: צמדים מותאמים אישית של מפתח/ערך שהוקצו לכלל.
הדוגמאות הבאות מציגות דפוסי סינון נפוצים. ערכים מספריים ובוליאניים לא מוקפים במירכאות.
סינון לפי שם
- התאמה מדויקת:
name = "critical_check" - התאמה לתבנית:
name =~ "temp_.*"
סינון לפי מאפיין
- התאמה למאפיין ספציפי:
dimension = "COMPLETENESS" - התאמה של כמה מאפיינים:
dimension = "VALIDITY" OR dimension = "ACCURACY"
סינון לפי עמודה וסף
- התאמה לעמודה ספציפית:
column = "user_id" - התאמה לסף:
threshold > 0.95 - התאמה של טווח:
threshold >= 0.8 AND threshold < 0.9
סינון לפי ignore_null
- ערך בוליאני של התאמה:
ignore_null = true
סינון לפי מאפיינים מותאמים אישית
- בדיקה אם המפתח קיים:
attributes:environment - מפתח וערך תואמים:
attributes.environment = "prod" - התאמה באמצעות ביטויים רגולריים:
attributes.tag =~ "prio-.*" - שילובים תואמים:
attributes.environment = "prod" AND attributes.criticality = "high"
תוצאות סריקה של איכות הנתונים
התוצאות של סריקות איכות הנתונים זמינות ב-Knowledge Catalog וב-BigQuery. אפשר גם לבדוק ולנתח את תוצאות הסריקה בדרכים הבאות:
ייצוא תוצאות ל-BigQuery
אתם יכולים לייצא את תוצאות הסריקה לטבלה ב-BigQuery כדי לנתח אותן לעומק. כדי להתאים אישית את הדיווח, אפשר לקשר את נתוני הטבלה ב-BigQuery למרכז בקרה ב-Looker. כדי ליצור דוח מצטבר, אפשר להשתמש באותה טבלת תוצאות בכמה סריקות.
פרסום התוצאות כמטא-נתונים ב-Knowledge Catalog
אפשר לפרסם את תוצאות הסריקה של איכות הנתונים כמטא-נתונים ב-Knowledge Catalog. התוצאות האחרונות נשמרות ברשומה של Knowledge Catalog שמייצגת את טבלת המקור, בקטע
data-quality-scorecardשל סוג המערכת. אפשר לראות את התוצאות בדפים של BigQuery ושל Knowledge Catalog של טבלת המקור במסוף Google Cloud , בכרטיסייה איכות הנתונים. אפשר גם לאחזר את התוצאות באמצעות ה-API.מידע נוסף על מטא-נתונים ב-Knowledge Catalog זמין במאמר מידע על ניהול מטא-נתונים ב-Knowledge Catalog.
בדיקת ציוני איכות הנתונים
בכל תוצאת סריקה מוצגים ציוני איכות נתונים שמציינים את אחוז הכללים שעברו את הבדיקה. הציונים מדווחים ברמה הכוללת של העבודה, ברמת העמודה (אם הכלל מוערך ביחס לעמודה) וברמת המאפיין. אתם יכולים להשתמש בציוני איכות הנתונים כדי לנרמל את איכות הנתונים בטבלאות או בעמודות, לעקוב אחרי מגמות ולזהות נתונים שלא עומדים בדרישות האיכות.
מידע נוסף זמין במאמר בנושא צפייה בתוצאות הסריקה של איכות הנתונים.
מעקב והתראות
אפשר לעקוב אחרי סריקות של איכות הנתונים ולקבל התראות לגביהן באמצעות השיטות הבאות:
הגדרת התראות ב-Cloud Logging
אתם יכולים לעקוב אחרי משימות של איכות נתונים באמצעות היומנים
data_scanו-data_quality_scan_rule_resultב-Logs Explorer.לכל משימה של איכות נתונים, היומן
data_scanעם השדהdata_scan_typeשמוגדר כ-DATA_QUALITYמכיל את הפרטים הבאים:- מקור הנתונים ששימש לסריקת הנתונים.
- פרטים על ביצוע העבודה, כמו שעת היצירה, שעת ההתחלה, שעת הסיום ומצב העבודה.
- התוצאה של משימת איכות הנתונים: הצלחה או כישלון.
- האם המאפיין עבר או נכשל ברמת המאפיין.
כל משימה שהושלמה בהצלחה מכילה יומן
data_quality_scan_rule_resultעם הפרטים הבאים לגבי כל כלל במשימה:- פרטי ההגדרה, כמו שם הכלל, סוג הכלל, סוג ההערכה והמאפיין.
- מידע על התוצאות, כמו הצלחה או כישלון, מספר השורות הכולל, מספר השורות שעברו את הבדיקה, מספר השורות עם ערכי null ומספר השורות שנבדקו.
המידע ביומנים זמין דרך ה-API ודרך מסוףGoogle Cloud . אתם יכולים להשתמש במידע הזה כדי להגדיר התראות. מידע נוסף זמין במאמר בנושא הגדרת התראות ב-Logging.
שליחת דוחות של התראות באימייל
אתם יכולים לשלוח דוחות של התראות באימייל כדי לעדכן אנשים לגבי הסטטוס והתוצאות של משימה לבדיקת איכות הנתונים. דוחות ההתראות זמינים בתרחישים הבאים:
- ציון איכות הנתונים נמוך מציון היעד שצוין
- המשימה נכשלה
- העבודה הסתיימה
מגדירים דוחות התראות כשיוצרים סריקה של איכות הנתונים.
מעקב אחרי עלויות השימוש ביחידות DCU בחיוב ב-Cloud
מחשוב בלי שרת (serverless computing) של סריקת איכות הנתונים לא פולט מדדים של סדרת זמנים ל-Cloud Monitoring. כדי לעקוב אחרי עלויות ה-DCU של איכות הנתונים ולשייך אותן לפי פרויקט, מזהה סריקה או טבלה, שולחים שאילתה לייצוא של החיוב ב-Cloud ב-BigQuery באמצעות תוויות המערכת של
goog-dataplex-datascan-*. מידע נוסף מופיע במאמר בנושא מעקב אחר עלויות של יחידות DCU ב-Dataplex ושיוך שלהן באמצעות ייצוא נתוני חיוב ב-Cloud.
פתרון בעיות שקשורות לאיכות הנתונים
כשביצוע של כלל נכשל, Knowledge Catalog מספק שאילתה לקבלת הרשומות שנכשלו. מריצים את השאילתה הזו כדי לראות את הרשומות שלא תאמו לכלל. מידע נוסף זמין במאמר פתרון בעיות שקשורות לאיכות הנתונים.
מגבלות
- אין תמיכה בהמלצות לכללים ב-CLI של gcloud.
- הבחירה של המאפיינים קבועה לאחד משבעת המאפיינים המוגדרים מראש.
- מספר הכללים לכל סריקה של איכות הנתונים מוגבל ל-1,000.
- ציוני איכות הנתונים שמדווחים ברמת העמודה נתמכים רק ב-API.
- אפשר להריץ כללים של איכות נתונים רק בטבלאות של BigQuery, בטבלאות של Iceberg REST Catalog, בטבלאות של SAP Business Data Cloud Delta Lake ובטבלאות של Apache Hive.
תמחור
- למידע נוסף על התמחור, ראו התמחור של Knowledge Catalog.
- כדי לעקוב אחרי השימוש בעלויות של יחידות DCU של סריקת איכות הנתונים ולשייך אותן באמצעות ייצוא נתוני החיוב ב-Cloud ל-BigQuery, אפשר לעיין במאמר בנושא מעקב אחרי עלויות של יחידות DCU של Dataplex ושיוך שלהן באמצעות ייצוא נתוני החיוב ב-Cloud.
המאמרים הבאים
- איך משתמשים באיכות נתונים אוטומטית
- איך משתמשים מחדש בכללים לאיכות הנתונים
- איך מנהלים את כללי איכות הנתונים כקוד
- אפשר לפעול לפי הדרכה כדי ליצור תהליך עבודה של איכות נתונים שמבוסס על מדיניות כקוד.
- מידע על משאבי Terraform שזמינים ליצירת פרופיל נתונים תוכלו לעיין במקורות המידע הבאים:
- משאב סריקת נתונים של Dataplex במרשם של Terraform.
- המסמכים בנושא משאב סריקת הנתונים של Dataplex ב-GitHub, שכוללים תמיכה בהגדרת כללים מבוססי YAML.
- מידע נוסף על פרופילים של נתונים
- איך משתמשים ביצירת פרופילים של נתונים