


בעזרת Knowledge Catalog (לשעבר Dataplex Universal Catalog) קל יותר להבין ולנתח את הנתונים. המערכת יוצרת באופן אוטומטי פרופילים של טבלאות BigQuery,Google Cloud Lakehouse Iceberg REST Catalog, SAP Business Data Cloud (BDC) Delta Lake ו-Hive.
פרופיל דומה לקבלת דוח בריאות מפורט לגבי הנתונים שלכם. הוא כולל נתונים סטטיסטיים חשובים, כמו ערכים נפוצים, פיזור הנתונים (התפלגות) ומספר הרשומות החסרות (ספירת ערכי Null). המידע הזה עוזר לכם לנתח את הנתונים מהר יותר.
פרופיל נתונים ממליץ על כללים לבדיקת איכות הנתונים כדי לוודא שהנתונים שלכם יישארו אמינים.
מודל קונספטואלי
בעזרת Knowledge Catalog אפשר להבין טוב יותר את פרופיל הנתונים על ידי יצירת סריקת פרופיל נתונים. סריקת פרופיל נתונים היא סוג של סריקת נתונים ב-Knowledge Catalog,שבה מתבצע ניתוח של טבלה ב-BigQuery, ב- Google Cloud Lakehouse Iceberg REST Catalog, ב-SAP BDC Delta Lake או ב-Hive כדי ליצור תובנות סטטיסטיות.
בתרשים הבא אפשר לראות איך מתבצעת סריקה של נתונים בקטלוג הידע כדי לדווח על מאפיינים סטטיסטיים.
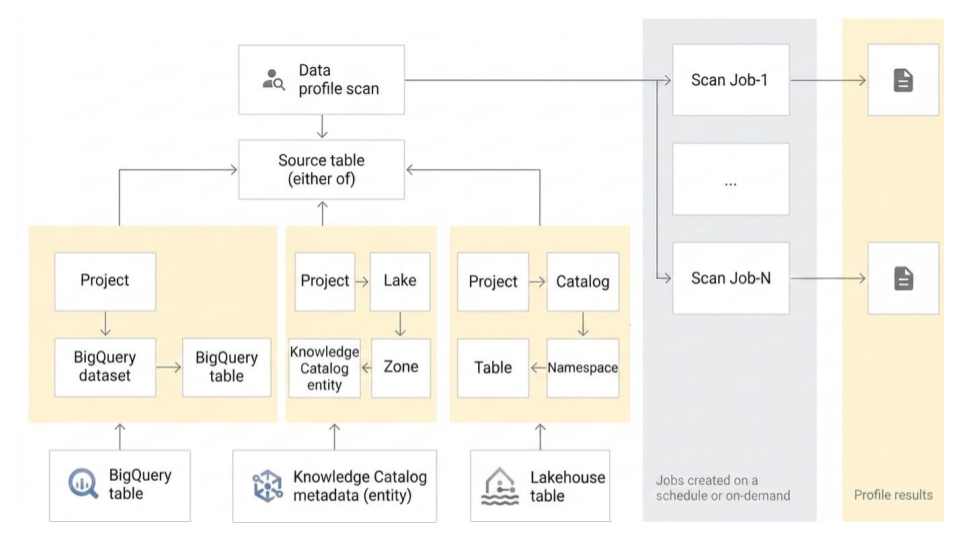
סריקת פרופיל נתונים משויכת לטבלה אחת ב-BigQuery, Google CloudLakehouse Iceberg REST Catalog, SAP BDC Delta Lake או Hive, והיא סורקת את הטבלה כדי ליצור את תוצאות פרופיל הנתונים. בסריקת פרופיל נתונים יש כמה אפשרויות הגדרה.
אפשרויות להגדרות אישיות
בקטע הזה מתוארות אפשרויות ההגדרה שזמינות להפעלת סריקות של פרופיל נתונים.
מצבי פרופיל
אפשר לבחור בין מצבי הפרופיילינג הבאים:
רגיל: זהו המצב שמוגדר כברירת מחדל. הוא מספק פרופיל מקיף וניתן להתאמה אישית על ידי סריקת הנתונים על סמך הדגימה והמסננים שאתם מציינים. מצב רגיל מתאים לניתוח מפורט ולמעקב ארוך טווח אחרי מאפייני הנתונים.
קל משקל (תצוגה מקדימה): במצב הזה מתבצעות סריקות פרופילים עם השהיה נמוכה, והתוצאות מתקבלות תוך שניות. הוא מותאם למהירות וליעילות מבחינת עלות, כדי לתמוך בתרחישי שימוש כמו אלה:
- עיגון תשובות של סוכני AI באמצעות מאפייני נתונים מיידיים
- יצירה מראש של פרופילים בקנה מידה גדול לחיפוש נתונים גלובלי, בצורה חסכונית
- הכנת דוחות בריאות מהירים במהלך ניתוח נתונים אינטראקטיבי
למצב הקל יש את המגבלות הבאות:
- בניגוד למצב פרופיל רגיל, לא ניתן לשנות את ההיקף, המסננים או גודל הדגימה בסריקות קלות.
- אין תמיכה בתצוגות מפורטות ובטבלאות חיצוניות ב-BigQuery.
אפשרויות תזמון
אתם יכולים לתזמן סריקת פרופיל נתונים בתדירות מוגדרת, או להפעיל את הסריקה לפי דרישה. אם עבודת סריקה נמשכת יותר זמן מהצפוי, אפשר לבטל את העבודה.
זהות הביצוע
כברירת מחדל, Knowledge Catalog משתמש בסוכן שירות מרכזי (service-PROJECT_NUMBER@gcp-sa-dataplex.iam.gserviceaccount.com) כדי להריץ סריקות של פרופילים של נתונים.
אתם יכולים גם לשנות את זהות ברירת המחדל לביצוע, על ידי ציון חשבון שירות בהתאמה אישית או שימוש בפרטי כניסה של משתמשי קצה (EUC) משלכם. היתרונות של הגישה הזו:
- העקרון של הרשאות מינימליות: מעניקים לחשבון שירות ייעודי רק את ההרשאות המדויקות של ניהול זהויות והרשאות גישה (IAM) שנדרשות למשימות ספציפיות של יצירת פרופיל נתונים, כדי לצמצם את הגישה שניתנת מעבר לנדרש.
- בקרת גישה ברמת פירוט גבוהה: אפשר להגדיר הרשאות למשאבים ספציפיים, וכך לשלב את מדיניות הגישה ברמת השורה וברמת העמודה ב-BigQuery.
- יכולת ביקורת משופרת: אתם יכולים להקצות חשבונות שירות בהתאמה אישית או פרטי כניסה של משתמשים לסריקות ספציפיות, וכך לעקוב אחרי הפעילויות ולתעד אותן בצורה ברורה יותר ביומני הביקורת.
- איחוד החיוב: כשמשתמשים בזהות ביצוע בהתאמה אישית, החיובים על העיבוד והאחסון מרוכזים ישירות ב-BigQuery (בלי לעבור דרך מק"טים של Knowledge Catalog Premium). כך תוכלו ליהנות מהנחות על BigQuery לעסקים ומהתחייבויות לשימוש ביחידות קיבולת.
הוראות להגדרת זהות הפעלה מותאמת אישית זמינות במאמר הגדרת זהות הפעלה.
דרישות הרשת
כדי להריץ סריקה, צריך להפעיל את הגישה הפרטית ל-Google בתת-הרשת של ה-VPC שבה משתמשים לסריקה. אם לא מציינים רשת משנה, צריך לוודא שברשת המשנה שמוגדרת כברירת מחדל מופעלת גישה פרטית ל-Google.
היקף
בסריקות פרופילים רגילות, אפשר לציין את היקף הנתונים שייסרקו:
טבלה מלאה: כל הטבלה נסרקת בסריקת פרופיל הנתונים. הדגימה, המסננים של השורות והמסננים של העמודות מוחלים על כל הטבלה לפני חישוב הנתונים הסטטיסטיים של הפרופיל.
מצטבר: נתונים מצטברים שאתם מציינים נסרקים בסריקת פרופיל הנתונים. מציינים עמודה
DateאוTimestampבטבלה שתשמש כתוספת. בדרך כלל זו העמודה שלפיה הטבלה מחולקת למחיצות. המערכת מחילה דגימה, מסנני שורות ומסנני עמודות על הנתונים המצטברים לפני שהיא מחשבת את נתוני הפרופיל.
סינון נתונים
בסריקות פרופילים רגילות, אפשר לסנן את הנתונים שייסרקו כדי ליצור פרופילים באמצעות מסנני שורות ומסנני עמודות. השימוש במסננים עוזר לצמצם את זמן הריצה והעלות, ולהחריג נתונים רגישים ומיותרים. סריקות פרופילים קלות לא תומכות במסנני עמודות ובמסנני שורות.
מסנני שורות: מסנני שורות מאפשרים לכם להתמקד בנתונים בתוך תקופה ספציפית או מפלח ספציפי, כמו אזור. לדוגמה, אפשר לסנן נתונים עם חותמת זמן שלפני תאריך מסוים.
מסנני עמודות: מסנני עמודות מאפשרים לכם לכלול או להחריג עמודות ספציפיות מהטבלה כדי להריץ את סריקת פרופיל הנתונים.
נתונים לדוגמה
בסריקות פרופיל רגילות, אפשר לציין אחוז של רשומות מהנתונים לדגימה כדי להריץ סריקת פרופיל נתונים. יצירת סריקות של פרופיל נתונים במדגם קטן יותר של נתונים יכולה לקצר את זמן הריצה ולהפחית את העלות של שאילתות על מערך הנתונים כולו.
סריקות מרובות של פרופיל נתונים
אפשר ליצור כמה סריקות של פרופילי נתונים בו-זמנית באמצעות מסוף Google Cloud . אתם יכולים לבחור עד 100 טבלאות ממערך נתונים אחד וליצור סריקה של פרופיל נתונים לכל מערך נתונים. מידע נוסף זמין במאמר יצירת כמה סריקות של פרופילי נתונים.
ייצוא של תוצאות הסריקה לטבלה ב-BigQuery
אתם יכולים לייצא את התוצאות של סריקת פרופיל הנתונים לטבלה ב-BigQuery כדי להמשיך לנתח אותן. כדי ליצור דוח בהתאמה אישית, אפשר לקשר את נתוני הטבלה ב-BigQuery ללוח בקרה ב-Looker. אפשר ליצור דוח מצטבר באמצעות אותה טבלת תוצאות בכמה סריקות.
תוצאות של יצירת פרופילים של נתונים
תוצאות פרופיל הנתונים כוללות את הערכים הבאים:
| סוג העמודה | תוצאות של פרופיל נתונים |
|---|---|
| עמודה מספרית |
|
| עמודת מחרוזת |
|
| עמודות אחרות שלא מקוננות (תאריך, שעה, חותמת זמן, בינארי וכו') |
|
| כל העמודות האחרות עם סוגי נתונים מורכבים או בתצוגת עץ (כמו Record, Array, JSON) או כל עמודה במצב repeated. |
|
התוצאות כוללות את מספר הרשומות שנסרקו בכל משימה.
דיווח ומעקב
אתם יכולים לעקוב אחרי התוצאות של יצירת פרופיל הנתונים ולנתח אותן באמצעות הדוחות והשיטות הבאים:
דוחות שפורסמו עם טבלת המקור בדפים של BigQuery ו-Knowledge Catalog
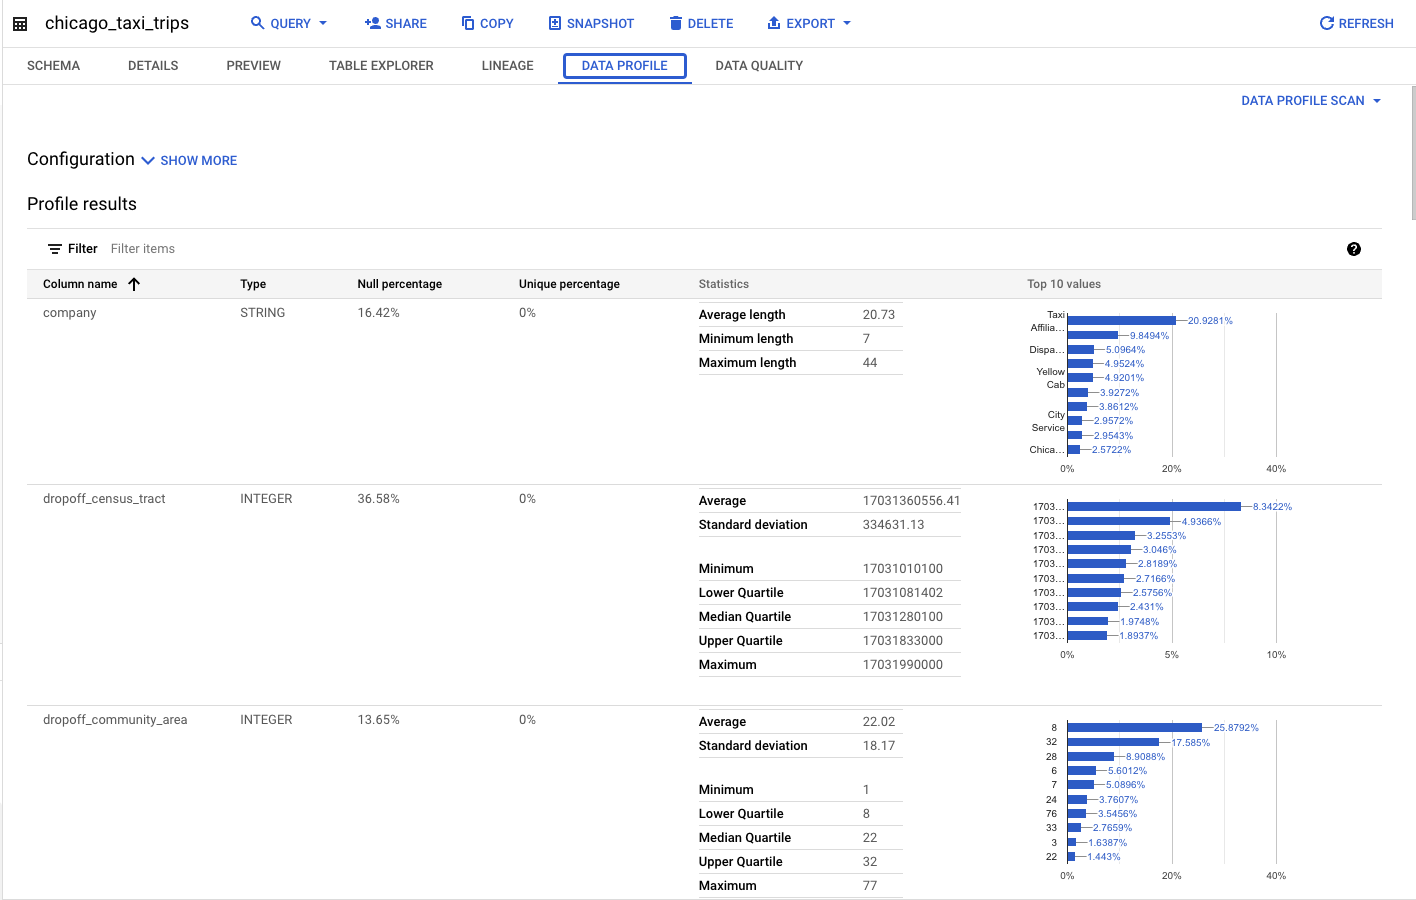
אם מגדירים סריקת פרופיל נתונים כדי לפרסם את התוצאות ב-BigQuery וב-Knowledge Catalog, אפשר לראות את התוצאות של סריקת פרופיל הנתונים האחרונה בכרטיסייה Data profile של טבלת המקור גם ב-BigQuery וגם ב-Knowledge Catalog. אפשר לגשת לתוצאות האלה מכל פרויקט.
דוח היסטורי לכל משרה
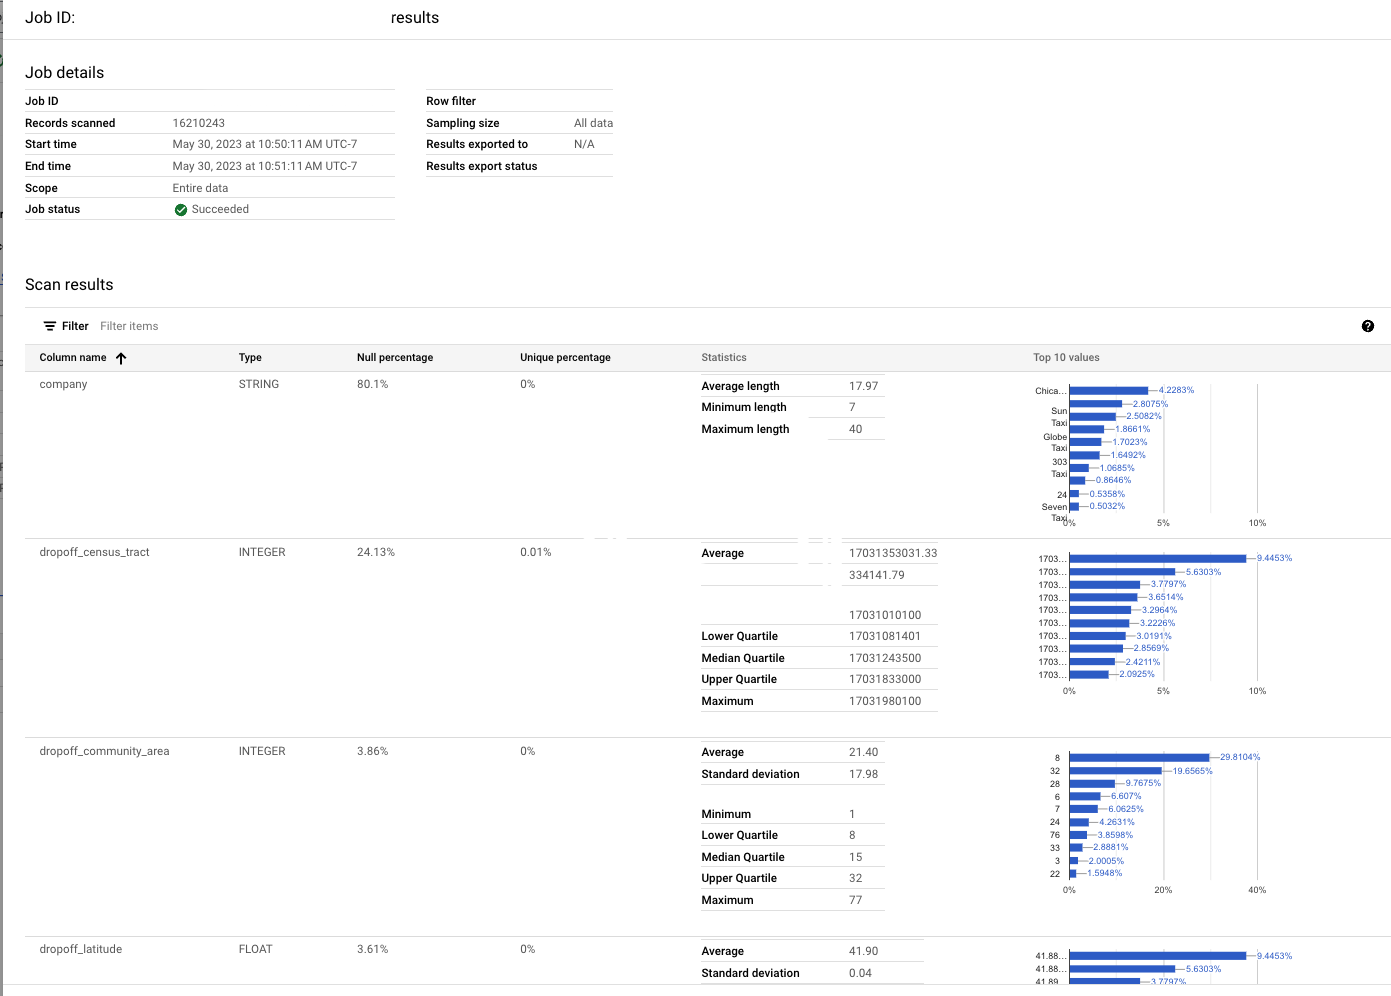
בדף Data profiling & quality > סריקת פרופיל נתונים ב-Knowledge Catalog וב-BigQuery, אתם יכולים לראות את הדוחות המפורטים של המשימות האחרונות וההיסטוריות. המידע הזה כולל את פרטי הפרופיל ברמת העמודה ואת ההגדרה שבה נעשה שימוש.
הכרטיסייה 'ניתוח'
בדף Data profiling & quality > סריקת פרופיל נתונים ב-Knowledge Catalog וב-BigQuery, אתם יכולים להשתמש בכרטיסייה Analysis כדי לראות את המגמות של נתון סטטיסטי מסוים בעמודה בכמה משימות סריקת פרופיל נתונים. לדוגמה, אם יש לכם סריקה מצטברת, אתם יכולים לראות את המגמה של ממוצע הערך לאורך זמן.

יצירת לוח בקרה או ניתוח נתונים משלכם
אם הגדרתם סריקה של פרופיל נתונים לייצוא תוצאות לטבלה ב-BigQuery, תוכלו ליצור לוחות בקרה משלכם באמצעות כלים כמו Data Studio.
מעקב אחרי עלויות השימוש ביחידות DCU בחיוב ב-Cloud
סריקות של פרופיל נתונים מורצות על מחשוב ללא שרת (serverless computing) ולא פולטות מדדים של סדרות זמן ל-Cloud Monitoring. כדי לעקוב אחרי עלויות של יחידות קיבולת לעיבוד נתונים (DCU) של Data Profiling ולשייך אותן לפי פרויקט, מזהה סריקה או טבלה, אפשר להריץ שאילתה על ייצוא של חיוב ב-Cloud ב-BigQuery באמצעות
goog-dataplex-datascan-*תוויות מערכת. מידע נוסף זמין במאמר מעקב אחר עלויות של יחידות Dataplex DCU ושיוך שלהן באמצעות ייצוא של נתוני החיוב ב-Cloud.
מגבלות
- אפשר להריץ סריקות פרופיל נתונים רק בטבלאות של BigQuery, Google Cloud, Lakehouse Iceberg REST Catalog, SAP BDC Delta Lake ו-Hive.
- פרופיל נתונים נתמך בטבלאות BigQuery עם כל סוגי העמודות, למעט
BIGNUMERIC. סריקה שנוצרה לטבלה עם עמודהBIGNUMERICלא מצליחה להיווצר ומוחזרת שגיאת אימות. - אי אפשר להפעיל כמה סריקות של פרופיל נתונים בטבלאות Lakehouse.
תמחור
- מידע נוסף על תמחור זמין במאמר בנושא תמחור של Knowledge Catalog.
- כדי לעקוב אחרי השימוש בעלויות של יחידות DCU בסריקת פרופיל הנתונים ולשייך אותן באמצעות ייצוא של נתוני החיוב ב-Cloud ל-BigQuery, אפשר לעיין במאמר מעקב אחרי עלויות של יחידות DCU ב-Dataplex ושיוך שלהן באמצעות ייצוא של נתוני החיוב ב-Cloud.
המאמרים הבאים
- איך משתמשים בפרופיל נתונים
- מידע נוסף על המשאבים הזמינים של Terraform ליצירת סריקות פרופיל נתונים:
- משאב סריקת נתונים של Knowledge Catalog במרשם של Terraform.
- מאמרי העזרה בנושא משאב סריקת הנתונים של Knowledge Catalog ב-GitHub, שכוללים תמיכה בהגדרת כללים מבוססת-YAML.
- מידע ולמידה על איכות נתונים אוטומטית
- איך משתמשים באיכות נתונים אוטומטית
- כך בוחנים את הנתונים באמצעות יצירת תובנות מהנתונים.