


丰富任务是 Knowledge Catalog 中的自主智能体,可帮助数据监管员和平台工程师扩缩其元数据操作。丰富任务会持续分析数据集架构、读取公司文档,并为数据资产生成建议的说明。为了充分利用丰富任务,您必须熟悉 Knowledge Catalog 的核心概念和组织的数据架构。
通过自动生成元数据,扩充任务可减轻手动整理的负担,同时确保目录反映准确且特定于业务的上下文。
为何要使用数据丰富化任务
丰富任务可解决保持大规模 Data Catalog 准确和最新的挑战。
| 切面 | 传统方法 | Knowledge Studio 方法 |
|---|---|---|
| 流程 | 手写说明。数据管理员手动审核数千个表,并采访领域专家。 | 智能体驱动。自主智能体分析数据并读取标准操作程序。 |
| 速度和规模 | 随着架构随时间变化,维护速度缓慢且困难。 | 伸缩能力强。系统会持续生成高质量的元数据建议。 |
| 人工工作量 | 高。需要大量手动数据录入和持续维护。 | 低。数据监管者只需审核并批准生成的建议。 |
丰富任务使用场景
丰富化任务可帮助组织解决以下常见的元数据挑战:
收购整合:一家公司收购了一个新的业务单位,该单位拥有数千个未记录的数据资产。数据工程师将扩充任务指向新数据集,并使用被收购公司的数据字典作为知识信号。代理会在数小时(而不是数月)内为整个数据集提出符合业务需求的说明。
持续文档化:平台工程团队构建了一个动态湖仓一体,其中的架构每天都在变化。他们将丰富任务配置为每天运行,并启用自动发布功能,以确保目录始终反映最新的架构更改。
语义治理:中央数据办公室希望在所有部门中标准化术语。他们部署了一项丰富化任务,该任务引用了精选的 Knowledge Catalog 术语库。智能体可以自动标记任何违反已批准的企业词汇表术语的表说明,并提出覆盖建议。
核心概念
配置丰富化任务时,您需要定义以下核心组件:
- 丰富化任务
-
定义代理必须执行的操作的配置。任务包含您选择的上下文集、目标资源、时间表以及您提供的任何知识信号。
例如,您可以配置一项任务,指示智能体在每周日午夜读取您的 GitHub 代码库并丰富您的
finance数据集。 - 丰富化作业
- Knowledge Studio 中执行丰富化任务的后端编排流程。
- 丰富化运行作业
-
任务的单个时间点执行实例。Knowledge Studio 控制台包含一个作业标签页,其中列出了任务的历史运行记录,您可以打开特定运行记录来查看其生成的元数据建议。
例如,10 月 24 日发生的特定执行实例,该实例导致了 15 项建议的列更改。
- 上下文集
-
目标数据资产和元数据的有界容器。每个丰富任务都必须配置为仅定位到一个上下文集。上下文集可以包含目标资源,例如 BigQuery 数据集或 Lakehouse,但如果不存在,您也可以创建一个空的上下文集。
例如,一个营销上下文集,它在逻辑上将广告系列表、ROAS 指标和术语表绑定到单个 AI 上下文边界。
- 知识信号
- 让智能体立足于公司真实业务场景的外部资料。通过提供包含数据字典、Knowledge Catalog 术语库或内部文档网址的 Cloud Storage 存储桶,您可以确保代理使用您的特定业务逻辑,而不是进行一般性猜测。
- 评估集
-
用于对代理的准确率进行评分的测试问题和相应 SQL(以
.jsonl格式提供)。当代理提出新的元数据时,它会针对这些建议运行这些测试问题,以确保在发布之前准确率不会下降。例如,提供一个测试问题,如“我们的 MRR 是多少?”,并搭配计算每月经常性收入所需的确切 SQL 查询。如果代理提出的元数据令人困惑,导致此测试查询失败,则该提案会被标记。
- 自学习来源
-
来自 Gemini Enterprise 应用或 BigQuery Agent Analytics 的实时对话日志。代理会读取这些聊天记录,以识别用户提出的问题,发现缺失的知识缺口,并自动提出新的元数据来填补这些缺口。
例如,如果聊天记录显示用户经常询问“状态代码 42 是什么意思?”,而智能体无法回答,则自学习会触发元数据建议来记录该缺失的状态代码。
支持的数据源和集成(适用于扩充任务)
丰富化任务可与 Google Cloud 和第三方系统集成。
目标数据资产
丰富化代理可以直接丰富以下Google Cloud 目标数据资产并将其添加到您的上下文集中:
BigQuery 数据集、表和视图
Lakehouse 数据湖、区域和资产
通过 Lakehouse 集成,Knowledge Studio 间接支持丰富通过 Iceberg REST Catalog 集成(例如 Databricks Unity、Snowflake Horizon、AWS Glue Data Catalog 和 SAP Business Data Cloud)附加的第三方来源的元数据。
知识信号
在丰富运行期间,代理会从以下只读来源中提取语义规则、业务上下文和领域知识:
Google Cloud:
- 包含受支持文件格式(例如 PDF、CSV、Markdown、配置、数据集和非结构化文本文件)的 Cloud Storage 存储桶
- 位于同一区域范围内的 Knowledge Catalog 业务术语库
- Google Workspace 应用,包括 Google 云端硬盘文件(例如文档、表格、幻灯片、PDF、文件和通用文本文档)
第三方系统(非 Google Cloud):
- 小于 5 MB 的 Microsoft SharePoint 文件(例如 PDF、Office 文件和通用文本文档,不包括旧版格式或图片)
- GitHub 代码库(任何包含可读文本的文件)
- Atlassian Confluence 页面正文
自学习来源
为了从实际互动日志中识别知识差距,扩充智能体会从以下来源挖掘轨迹:
- Gemini Enterprise 应用
- BigQuery Agent Analytics 表
- 使用限定范围的日志视图的 Cloud Logging
丰富化代理的工作原理
当您触发丰富任务(按需或按周期性时间表)时,系统会启动丰富运行。丰富代理在后台异步执行,分析您的数据资产、查询跟踪记录和文档,以生成经过验证的元数据建议。
下图展示了扩充智能体的高层级工作流架构:
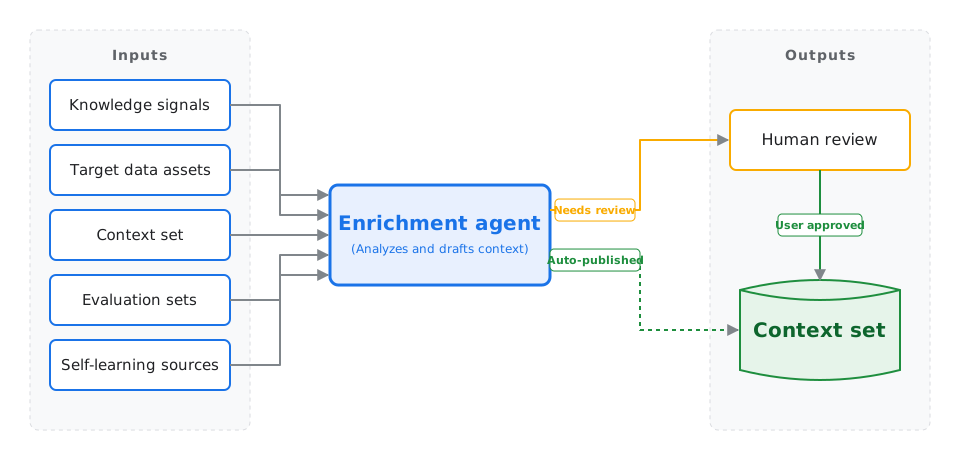
智能体通过四个关键阶段来精选上下文集:
- 分析信号和文档:智能体挖掘互动日志,找出下游 AI 智能体在哪些方面遇到困难或需要消除歧义。它会扫描 Cloud Storage 或关联的第三方应用中的企业文档,并检查查询历史记录,以发现高频表联接和上游依赖项。
- 起草上下文提案:在精选目标的指导下,智能体为目标资产起草结构化上下文。这包括面向业务的表概览、正式指标公式、经过验证的联接条件以及基于黄金参数的 SQL 查询模板。
- 基准化分析和优化:智能体使用评估集中的测试问题,以迭代方式测试自己起草的元数据,不断优化说明,直到下游查询准确率达到最高。然后,它会运行留存测试查询来计算回归错误率。每个建议的说明或指标规则都会分配一个置信度分数。
- 应用审核政策:满足置信度阈值的提案会触发您的政策规则。如果您启用了自动发布功能,并且回归错误率在允许的范围内,系统会自动合并更改。如果回归误差超过允许的阈值,系统会立即停止自动发布,并将所有提案打包成一个变更请求,以供人工审核。
数据安全和治理
由于 Knowledge Studio 扩充任务使用人工智能来分析您的数据架构和内部文档,因此该平台实施了严格的边界来保护您的专有信息。
基础模型训练:您的数据仍归您所有。客户执行轨迹、数据库架构和提供的知识信号(例如文档或内部词汇表)绝不会用于训练 Google 的基础模型。
数据清理:在将任何建议的元数据写入上下文集之前,智能体会自动从系统日志和生成轨迹中隐去个人身份信息 (PII)。
执行边界:扩充智能体在 Google 管理的安全租户中运行。它使用 Private Service Connect 接口和客户控制的出站流量代理安全地访问您的私有数据源。
合规状态:在当前的预览阶段,扩充任务不支持 VPC Service Controls (VPC-SC)、客户管理的加密密钥 (CMEK) 或 Assured Workloads。
建议的配置
Knowledge Catalog 为丰富任务提供了多项可选设置。我们建议您先从基本配置开始,然后随着元数据操作规模的扩大,逐步启用高级功能。
| 配置 | 包含的组件 | 自动发布 | 建议用于 |
|---|---|---|---|
| 基本版 | 上下文集 | 已停用 | 测试工具。让您了解代理如何严格根据数据集的架构推断元数据。您必须手动审核所有提案。 |
| 以事实为依据 |
|
已停用 | 生产环境。让智能体以您的特定业务逻辑为依据,使用您的标准运营规程和术语表来提高准确性。 |
| 自动 |
|
已启用 | 扩缩元数据操作。评估集充当安全防护措施。如果自动生成的提案导致下游准确率下降,发布流程会暂停,以便进行人工审核。 |
| 自学 |
|
已启用 | 高级目录和自主目录。该智能体通过分析实时用户互动和智能体聊天日志,不断发现并填补知识空白,从而持续调整和优化自身。 |
限制和预览边界
在预览版期间,丰富任务在以下范围内运行:
控制台优先管理:您只能通过 Google Cloud 控制台配置和管理任务。预览版中不提供直接公共 REST API 和
gcloudCLI 命令。配额和限制:扩充任务和任务运行受每个项目的区域级资源和速率配额限制。如需了解详情,请参阅配额和限制中的 Knowledge Studio 扩充任务部分。
Deployment 生命周期
构建和部署丰富化任务的过程遵循线性生命周期:
- 配置前提条件:授予所需角色、配置服务账号,并针对常用表启用数据分析和 AI 数据洞见。如需了解详情,请参阅配置丰富化任务的前提条件。
- 关联外部知识:授权任务从 Google 云端硬盘或外部 Git 代码库中读取文件,以进行接地。
- 创建任务:定义上下文集、目标资源、知识信号和评估策略。
- 查看 AI 提案:检查运行诊断、查看建议的说明并批准元数据更改。