


Knowledge Catalog 上下文集可让您将数据架构、语义定义和经过验证的查询句式打包到有边界的特定于网域的知识容器中。这些有针对性的领域知识可以可靠地为 Gemini Enterprise 和自定义智能体等自主 AI 应用提供依据,使其能够高精度运行。
本文档面向希望了解上下文集如何为 AI 智能体构建领域知识的数据架构师、治理主管和 AI 工程师。
什么是上下文集?
上下文集是一种专门的 Knowledge Catalog 条目组(元数据记录的逻辑容器),用于为特定分析领域和 AI 智能体打包一个自包含的语义信息和数据资产引用集合。
在此容器中,知识被整理为条目,这些条目代表单个业务概念、文档或数据资产。这些条目通过切面进行丰富,切面是模块化元数据属性,用于存储业务术语、SQL 模板和 Markdown 文档等特定详细信息。
如果强制智能体搜索整个企业目录,不仅会增加延迟、浪费提示词配额,还可能导致回答出现幻觉。而上下文集则能建立封闭的、限定于特定领域的知识容器,让智能体能够进行高精度的查询。
由于上下文集充当管理容器,因此您可以按项目所有权整理元数据,并一次性对所有捆绑条目应用 Identity and Access Management (IAM) 访问权限控制政策,而无需单独配置权限。如需详细了解条目组、条目和切面,请参阅元数据管理简介。
AI 智能体接地要求
随着组织部署自主 AI 智能体(例如 Gemini Enterprise、Antigravity 和自定义智能体开发套件智能体)来编排数据工作流并生成分析,智能体需要可靠的建立依据:
- 语义定义:特定列或指标在业务术语中的含义是什么?
- 经过验证的查询句式:领域专家如何成功查询和联接这些表?
- 运营规则:哪些业务政策、异常条件和标准运营规程 (SOP) 约束这些数据?
建议的上下文集命名模式
以下架构图展示了四个核心逻辑命名惯例如何在条目组边界内协同运作,从而为下游 AI 应用提供依据:
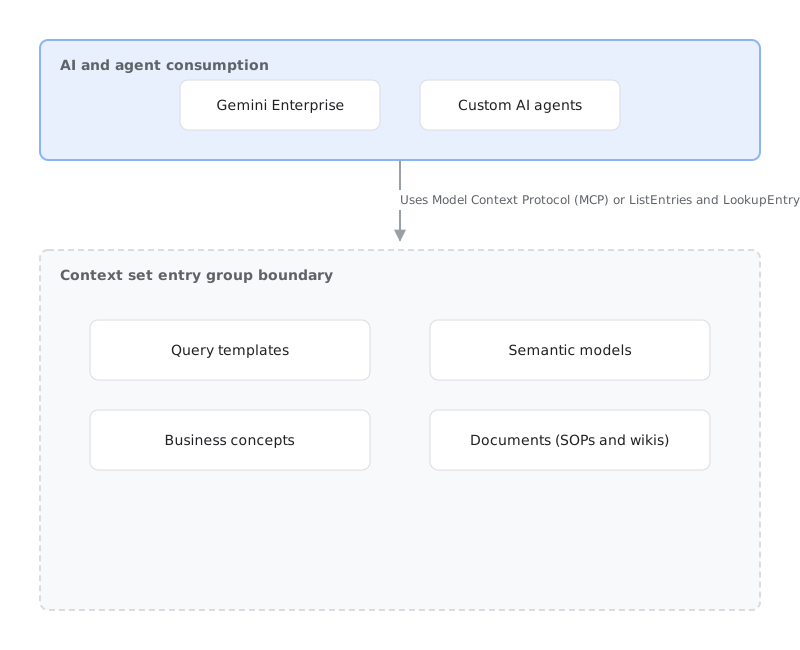
虽然上下文集并不严格要求每种类型的条目都能正常运行,但我们建议您使用以下逻辑命名惯例来整理条目。使用这些命名惯例有助于确保人类和自主智能体能够一致地发现和解读知识:
| 命名模式 | 条目类型 | 说明和用途 | 附加的切面 |
|---|---|---|---|
业务概念 concepts_<id> |
generic |
业务术语库、指标定义、首字母缩写词和计算公式。 | glossary-term-aspect、contacts。 |
文档 documents_<path> |
document |
叙述性背景信息、标准操作程序 (SOP)、新手入门 Wiki 以及指向外部文档的指针。 | Document、overview(富文本 Markdown 和链接)。 |
查询模板 query-templates_<path> |
query-template |
预先验证的参数化 SQL 查询模板、高频联接逻辑和执行模式。 | query-template(包含来源、intent、nlQuery、参数和查询等字段)。 |
语义模型 semantic-models_<id> |
semantic-model、semantic-entity、semantic-metric |
正式的关系模型、实体定义、维度层次结构和度量。 | semantic-model、semantic-entity、semantic-metric。 |
业务概念
业务概念条目(使用 concepts_* 命名惯例的通用类型条目)定义了标准化的业务术语、领域指标、首字母缩略词和计算公式 (glossary-term-aspect)。
主要功能包括:
- 术语一致性:消除业务部门和分析团队之间的术语歧义。
- KPI 公式:提供特定领域关键绩效指标 (KPI) 的数学公式和逻辑。
- 组织所有权:通过附加的治理方面 (
contacts) 建立明确的组织所有权。
例如,在电子商务上下文集中,concepts_net_items_sold 处的条目指定了确切的净售出单位数计算。当代理收到询问“净售出商品数”的提示时,它会参考概念条目来应用经过验证的计算,而不是自行创建 SQL 逻辑。
资源表示法示例:
name: projects/cymbal-style/locations/us-central1/entryGroups/online-apparel-store/entries/concepts_net_items_sold
entryType: generic
aspects:
  dataplex-types.global.glossary-term-aspect:
    definition: "Calculates the absolute number of items sold minus customer returns in a given time period."
文档
文档条目(使用 documents_* 命名惯例的文档类型条目)以结构化 Markdown(Document、overview)存储叙述和过程上下文。
主要功能包括:
- 标准操作程序 (SOP):直接在目录中捕获 SOP、Runbook 核对清单和新手入门指南。
- 合规性政策:记录合规性政策、监管限制(例如 GDPR 或 HIPAA 处理规则)和例外情况标准。
- 外部参考 Wiki:通过来源 URI 指针(
overview链接)引用外部实时 Wiki(例如 Google 文档、Atlassian Confluence、Notion 或 GitHub)。
例如,服装上下文集包含 documents_return_policy_rules,用于指导代理在计算标准退货率时如何排除已完成的销售和运输途中损坏的商品。
资源表示法示例:
name: projects/cymbal-style/locations/us-central1/entryGroups/online-apparel-store/entries/documents_return_policy_rules
entryType: document
aspects:
  dataplex-types.global.overview:
    content: "## Return Policy Rules\nItems marked FINAL_SALE or DAMAGED_IN_TRANSIT are excluded from return rates..."
查询模板
查询模板条目(使用 query-templates_* 命名惯例的 query-template 类型条目)包含映射到常见自然语言分析意图(使用 query-template 方面)的人工验证参数化 SQL 查询。
主要功能包括:
- 预先验证的查询:存储预先验证的联接路径、过滤条件和聚合模式,以应对高频业务问题。
- 运行时参数化:支持运行时参数替换(例如
@start_date、@region和@limit),以实现动态智能体执行。 - 错误防范:防止出现虚构的表联接和 SQL 方言语法错误。
例如,当代理需要回答有关效果最佳的账号的问题时,它会匹配 query-templates_sales_top_accounts_by_arr,并将请求的日期范围替换到经过验证的 SQL 模板中。
资源表示法示例:
name: projects/cymbal-style/locations/us-central1/entryGroups/online-apparel-store/entries/query-templates_top_categories_by_season
entryType: query-template
aspects:
  dataplex-types.global.query-template:
    intent: "Which e-commerce product categories performed best this season?"
    query: "SELECT category, SUM(revenue) FROM sales WHERE season = @season GROUP BY category ORDER BY 2 DESC LIMIT @limit"
    parameters:
      -   name: "season"
        type: "STRING"
      -   name: "limit"
        type: "INTEGER"
语义模型
语义模型条目(使用 semantic-model、semantic-entity 和 semantic-metric 条目类型,并采用 semantic-models_* 命名惯例)可对标准化表中的关系结构、维度层次结构和聚合度量进行形式化。
主要功能包括:
关系定义:定义主键、外键和联接基数(例如一对多或多对多关系)。
业务维度映射:将原始底层列映射到业务维度、时间粒度和可重复使用的度量。
智能体指导:在没有确切查询模板的情况下,指导自主智能体组合复杂的多表分析查询。
抽象化底层复杂性:与仅记录源数据集中机械表连接的原始架构联接条目链接不同,语义模型在逻辑业务层运行,可防止 AI 智能体产生错误的 ER 图遍历幻觉。
例如,服装上下文集使用 semantic-models_apparel_sales_model 来定义 warehouses、shipments 和 line_items 如何在星型架构事实表和维度表之间联接。
资源表示法示例:
name: projects/cymbal-style/locations/us-central1/entryGroups/online-apparel-store/entries/semantic-models_apparel_sales_model
entryType: semantic-model
aspects:
  dataplex-types.global.semantic-model:
    entities:
      -   name: "products"
      -   name: "orders"
    relationships:
      -   sourceEntity: "orders"
        foreignKey: "product_id"
        targetEntity: "products"
        primaryKey: "id"
        type: "MANY_TO_ONE"
示例:在线服装店上下文集
为了展示这四种命名惯例如何协同工作,我们以一家在线服装零售商为例,该零售商为商店商品策划人员部署了一个 AI 助理。如果没有限定上下文,代理可能会查询原始暂存表,或者由于未扣除客户退货而错误统计热门商品。
为了让代理能够提供依据,数据监管员创建了一个名为 online-apparel-store 的上下文集:
EntryGroup: projects/cymbal-style/locations/us-central1/entryGroups/online-apparel-store
(EntryGroup.type = "context-set")
│
├── concepts_* (Business concepts)
│   ├── concepts_net_items_sold
│   │     Formula: SUM(orders.quantity) - SUM(returns.quantity)
│   └── concepts_bestseller
│         Definition: Any clothing item with >= 500 net units sold within a 30-day window
│
├── documents_* (Documents and SOPs)
│   ├── documents_return_policy_rules
│   │     Markdown SOP: Exclude items marked 'FINAL_SALE' or 'DAMAGED_IN_TRANSIT' from standard return rates
│   └── documents_size_chart_guide
│         Markdown guide: Sizing conversions across US, UK, and EU clothing labels
│
├── query-templates_* (Golden SQL queries)
│   └── query-templates_top_categories_by_season
│         Verified SQL template with parameters: @season, @limit
│
└── semantic-models_* (Semantic models)
    └── semantic-models_apparel_sales_model
          Join keys: orders.product_id = products.product_id (many-to-one)
                     orders.order_id = returns.order_id (one-to-many)
智能体如何解析提示
当商品策划人员询问智能体“不包括因损坏而退货的商品,我们最畅销的 5 款冬季夹克是什么?”时,智能体会通过上下文集解析提示:
查询模板查找:智能体检查
query-templates_*并匹配query-templates_top_categories_by_season,替换@season = 'Winter'和@limit = 5。概念验证:代理检查
concepts_net_items_sold和concepts_bestseller,以确认必须从总订单数量中减去退货商品。SOP 规则强制执行:代理读取
documents_return_policy_rules并添加过滤条件WHERE return_reason != 'DAMAGED_IN_TRANSIT'。架构和联接验证:使用
semantic-models_apparel_sales_model和关联的@bigquery表,代理使用经过验证的外键联接store.orders、store.products和store.returns,并运行 SQL 查询。
架构能力
上下文集为企业数据环境提供了多项核心功能:
封闭式执行边界:通过将上下文限定在一组精选资产和语义条目中,智能体可在封闭式沙盒中运行。这可以消除无关的目录噪声,有助于确保确定性评估,并最大限度地减少 token 使用量。
快速上传和批量索引编制:团队可以上传概念、查询和文档集,并将其作为单个原子操作进行索引编制,从而与持续集成和部署 (CI/CD) 流水线集成。
零复制打包:Context 会打包元数据和关系,而无需复制或移动底层数据存储区,从而避免冗余存储费用和数据同步延迟。
智能体咨询模式
下游智能体通过 Model Context Protocol (MCP) 或直接通过 Knowledge Catalog API 使用上下文集。如需了解详情,请参阅使用 Catalog API 检索数据上下文。为了优化响应延迟时间并最大限度地减少 token 消耗,智能体遵循三层级咨询层次结构:
查询模板匹配:智能体搜索
query-templates_*。如果经过验证的模板与用户意图匹配,智能体会将查询参数化并直接运行。这样可以提供最快的响应,并且查询错误的风险几乎为零。语义模型组装:如果没有匹配的查询模板,代理会评估
semantic-models_*,以了解实体关系并构建多表 SQL 语句。文档和概念咨询:对于不明确的极端情况(例如会计日历截止日期或争议排除),智能体可以阅读
concepts_*和documents_*来应用业务规则。
在生成式 AI 应用中使用上下文
生成式 AI 应用使用精选上下文集来理解企业领域语义、浏览复杂架构并生成可靠的 SQL,而不会出现幻觉。应用通常通过两种主要模式使用这些上下文集:
动态上下文发现:在对话式或自助式分析环境中,用户会使用自然语言提出临时问题。应用会动态评估用户的意图,以识别并从 Knowledge Catalog 中检索最相关的上下文集,并将检索到的领域知识注入到活跃提示中。
预配置的上下文集:对于专用代理应用,您可以通过提供其资源 URI,使用显式上下文集引用预配置代理。绑定专用上下文集可提供确定性的接地,确保所有互动都使用经过认证的业务定义,而不会产生运行时搜索开销。随着周期性丰富工作流不断优化上下文集,智能体也会自动提升质量。
为了优化这些丰富和自学习功能,我们建议在 Gemini Enterprise 应用中指定 Gemini 3.8 Flash 或更高版本的模型。如需详细了解模型选择步骤,请参阅在 Agent Studio 中设计代理中的“使用流程构建器创建代理”部分。
上下文集与相关构造的比较
如需为您的架构选择合适的元数据构造,请参阅 Knowledge Catalog 上下文集与相关平台功能的比较。
上下文集与上下文图表的比较
上下文图和上下文集是两个独立的结构,在 Knowledge Studio 架构中扮演着不同的角色:
上下文图:整个组织的实时、全面的语义拓扑。它将底层数据资产、业务术语库术语和互动轨迹关联起来。您可以在探索界面中以交互方式探索和遍历此开放图谱。
情境集:一个有界限、有区域性且经过精选的打包单元。它会提取特定领域的知识子集,并将其封装到条目组 (
type="context-set") 中,供下游 AI 智能体通过 Model Context Protocol (MCP) 进行查询。上下文集在更广泛的上下文图中充当一个紧密、高密度的子图。
Knowledge Catalog 上下文集与数据库上下文集的比较
Knowledge Catalog 和 Google Cloud 操作型数据库都使用术语“上下文集”来指代为生成式 AI 模型提供依据的精选信息。
虽然这两种变体都采用相同的基础架构(它们以原生方式存储为 Knowledge Catalog 上下文集,即具有 type="context-set" 的可扩展条目组,并使用标准 Knowledge Catalog API),但它们针对的是企业数据堆栈的不同层:
- 数据库上下文集 (QueryData):专为运营型事务数据库(例如 AlloyDB for PostgreSQL、Cloud SQL 和 Spanner)而构建。这些上下文集针对 SQL 配置进行了深度优化。它们捆绑了黄金查询模板、架构元数据和过滤分面,专用上下文工程代理会评估这些内容,以改进操作运行时中的自然语言到 SQL (NL2SQL) 转换。
- Knowledge Catalog 上下文集 (Knowledge Studio):专为分析数据资产(例如 BigQuery、数据湖仓一体和 Knowledge Catalog 数据产品)而构建。这些上下文集涵盖多种命名惯例,包括业务概念、Markdown 文档 Wiki 和语义模型,可提供更广泛的多模态知识。这些知识图谱通过 Knowledge Studio 丰富工作流进行精选,并通过 Model Context Protocol (MCP) 提供给下游分析智能体。
上下文集与数据产品的比较
了解上下文集如何与 Knowledge Catalog 数据产品交互,有助于您建立清晰的数据和 AI 治理边界:
数据产品管理底层资源:数据产品安全地捆绑 BigQuery 表、存储桶和流等具体资源,为数据共享、数据协定和数据平面访问权限控制建立主要单元。
上下文集捆绑了对话语义:上下文集不授予数据访问权限,而是捆绑了 AI 智能体和人类理解数据所需的领域知识,例如概念、查询模板和文档。数据管家可以通过在数据产品的
additional_context引用中声明上下文集,将上下文集关联到数据产品。
企业安全与治理
上下文集与 Google Cloud 安全和治理控制措施集成,有助于保护敏感的企业元数据:
上下文集 IAM 角色:由于上下文集通常包含敏感的语义信息,因此访问权限由直接应用于
context-set条目组的 IAM 角色控制。这样,您就可以按地理区域和网域所有权整理精选知识,向网域管理员授予修改权限,并向使用这些知识的 AI 智能体授予读取权限。如需创建上下文集,您必须拥有dataplex.entryGroups.setIamPolicyIAM 权限。在创建上下文集期间,您需要此权限才能自动获得所有者权限。您可以通过预定义角色(例如 Dataplex Catalog Admin [roles/dataplex.catalogAdmin] 或 Dataplex Entry Group Owner [roles/dataplex.entryGroupOwner] 角色)获得此权限。零复制底层数据安全:向智能体授予对上下文集的访问权限后,智能体可以读取语义元数据和查询模板,但不会绕过对底层表的访问权限控制。如需对 BigQuery 运行 SQL 查询或读取 Cloud Storage 中的文件,运行查询的身份必须对这些底层资源拥有所需的数据平面 IAM 权限。
人机协同治理:当自主 Knowledge Studio 扩充任务从操作日志中提取新概念、SOP 或查询模板时,这些提案会作为可审核的变更请求进行暂存。数据监管者会先检查差异比较结果和评估分数,然后再批准对生产上下文集的更改。如需详细了解提案审核,请参阅管理请求。
用户管理的执行身份:填充上下文集的自动丰富任务在用户管理的服务账号下运行,该服务账号由 Dataplex 服务代理通过 Service Account Token Creator 角色 (
roles/iam.serviceAccountTokenCreator) 模拟。
预览范围和边界
在预览版期间,上下文集在以下边界内运行:
区域范围:不支持关联到区域数据资产的全局上下文集。上下文集必须与它所打包的资产的区域边界保持一致。
编写和使用界面:您可以通过 Google Cloud 控制台中的 Knowledge Studio 容器创建上下文集,使其在逻辑上与标准 Knowledge Catalog 管理条目组区分开来。您可以通过 Knowledge Studio 扩充工作流自动填充上下文集。下游 AI 智能体可以使用 Knowledge Catalog API(
ListEntries和LookupEntry)以及 Model Context Protocol (MCP) 以编程方式发现和查询上下文集。如需了解详情,请参阅 MCP 服务器简介。结算:Knowledge Catalog 不会针对创建上下文集条目组收取单独的独立 SKU 费用。
共享配额:由于上下文集本质上是专用条目组 (
type="context-set"),因此它们会与标准 Knowledge Catalog 条目组使用和共享相同的资源配额。