


As tarefas de enriquecimento são agentes autônomos no Knowledge Catalog que ajudam os gestores de dados e engenheiros de plataforma a escalonar as operações de metadados. Uma tarefa de enriquecimento analisa continuamente os esquemas do conjunto de dados, lê a documentação da empresa e gera descrições propostas para os recursos de dados. Para aproveitar ao máximo as tarefas de enriquecimento, você precisa conhecer os conceitos básicos do Knowledge Catalog e a arquitetura de dados da sua organização.
Ao automatizar a geração de metadados, as tarefas de enriquecimento reduzem o trabalho de curadoria manual e garantem que o catálogo reflita um contexto preciso e específico para os negócios.
Por que usar tarefas de enriquecimento
As tarefas de enriquecimento resolvem o desafio de manter catálogos de dados em grande escala precisos e atualizados.
| Aspecto | Abordagem convencional | Abordagem do Knowledge Studio |
|---|---|---|
| Processo | Descrições escritas à mão. Os administradores revisam manualmente milhares de tabelas e entrevistam especialistas do domínio. | Orientado por agentes. Um agente autônomo analisa dados e lê procedimentos operacionais padrão. |
| Velocidade e escala | Lento e difícil de manter, já que os esquemas mudam com o tempo. | Altamente escalonável. As propostas de metadados de alta qualidade são geradas continuamente. |
| Esforço humano | Alto. Entrada manual de dados e manutenção contínua. | Baixo. Os gestores de dados só precisam analisar e aprovar as sugestões geradas. |
Casos de uso de tarefas de enriquecimento
As tarefas de enriquecimento ajudam as organizações a resolver os seguintes desafios comuns de metadados:
Integração de aquisição: uma empresa adquire uma nova unidade de negócios com milhares de recursos de dados não documentados. Os engenheiros de dados apontam uma tarefa de enriquecimento para o novo conjunto de dados, usando os dicionários de dados da empresa adquirida como um sinal de conhecimento. O agente propõe descrições alinhadas aos negócios para todo o conjunto de dados em horas, não mais em meses.
Documentação contínua: uma equipe de engenharia de plataforma cria um lakehouse dinâmico em que os esquemas mudam diariamente. Eles configuram uma tarefa de enriquecimento para ser executada diariamente com a publicação automática ativada, garantindo que o catálogo sempre reflita as mudanças mais recentes no esquema.
Governança semântica: um escritório de dados central quer padronizar a terminologia em todos os departamentos. Eles implantam uma tarefa de enriquecimento que faz referência a um glossário selecionado do Knowledge Catalog. O agente sinaliza e propõe automaticamente substituições para todas as descrições de tabela que violam os termos aprovados do glossário corporativo.
Principais conceitos
Ao configurar uma tarefa de enriquecimento, você define os seguintes componentes principais:
- Tarefa de enriquecimento
-
A configuração que define o que o agente precisa fazer. Uma tarefa contém o conjunto de contexto selecionado, os recursos de destino, a programação e todos os indicadores de conhecimento que você fornecer.
Por exemplo, uma tarefa configurada para instruir o agente a ler seus repositórios do GitHub e enriquecer seu conjunto de dados do
financetodo domingo à meia-noite. - Job de enriquecimento
- O processo de orquestração de back-end no Knowledge Studio que executa uma tarefa de enriquecimento.
- Execução de enriquecimento
-
Uma única instância de execução pontual de uma tarefa. O console do Knowledge Studio inclui uma guia Jobs que lista as execuções históricas de uma tarefa. É possível abrir uma execução específica para analisar as propostas de metadados que ela gerou.
Por exemplo, a instância de execução específica que ocorreu em 24 de outubro e resultou em 15 mudanças de coluna propostas.
- Conjunto de contextos
-
Um contêiner limitado de recursos de dados e metadados de destino. Cada tarefa de enriquecimento precisa ser configurada para segmentar exatamente um conjunto de contexto. O conjunto de contexto pode conter recursos de destino, como um conjunto de dados do BigQuery ou Lakehouse, mas você também pode criar um conjunto de contexto vazio se não houver um.
Por exemplo, um conjunto de contexto de marketing que vincula logicamente suas tabelas de campanha, métricas de ROAS e glossários de terminologia em um único limite de contexto de IA.
- Indicadores de conhecimento
- Materiais externos que embasam o agente na realidade da sua empresa. Ao fornecer buckets do Cloud Storage com dicionários de dados, glossários do Knowledge Catalog ou URLs de documentação interna, você garante que o agente use sua lógica de negócios específica em vez de fazer suposições genéricas.
- Conjuntos de avaliação
-
Perguntas de teste e o SQL correspondente (fornecido no formato
.jsonl) usados para avaliar a precisão do agente. Quando o agente propõe novos metadados, ele executa essas perguntas de teste nas propostas para garantir que a precisão não caia antes da publicação.Por exemplo, fornecer uma pergunta de teste como "Qual é nossa receita recorrente mensal?" junto com a consulta SQL exata necessária para calcular a receita recorrente mensal. Se o agente propuser metadados confusos que façam com que essa consulta de teste falhe, a proposta será sinalizada.
- Fontes de autoaprendizagem
-
Registros de conversas em tempo real dos seus apps do Gemini Enterprise ou da análise de agentes do BigQuery. O agente lê esses registros de chat para identificar o que os usuários estão perguntando, descobre lacunas de conhecimento e propõe automaticamente novos metadados para preencher essas lacunas.
Por exemplo, se os registros de chat revelarem que os usuários perguntam com frequência "O que significa o código de status 42?" e o agente não responder, o autoaprendizado vai acionar uma proposta de metadados para documentar esse código de status ausente.
Fontes de dados e integrações compatíveis com tarefas de enriquecimento
As tarefas de enriquecimento se integram ao Google Cloud e a sistemas de terceiros.
Recursos de dados de destino
O agente de enriquecimento pode enriquecer e adicionar diretamente os seguintes Google Cloud recursos de dados de destino aos seus conjuntos de contexto:
Conjuntos de dados, tabelas e visualizações do BigQuery
Lakes, zonas e recursos do Lakehouse
Com a integração do Lakehouse, o Knowledge Studio oferece suporte indireto à complementação de metadados de fontes de terceiros anexadas por meio de integrações do Iceberg REST Catalog (como Databricks Unity, Snowflake Horizon, AWS Glue Data Catalog e SAP Business Data Cloud).
Indicadores de conhecimento
Durante uma execução de enriquecimento, o agente extrai regras semânticas, contexto de negócios e conhecimento de domínio das seguintes fontes somente leitura:
Google Cloud:
- Buckets do Cloud Storage que contêm formatos de arquivo compatíveis (como PDFs, CSVs, Markdown, configuração, conjuntos de dados e arquivos de texto não estruturados)
- Glossários empresariais do Knowledge Catalog localizados no mesmo escopo regional
- Aplicativos do Google Workspace, incluindo arquivos do Google Drive (como Documentos, Planilhas, Apresentações, PDFs, arquivos e documentos de texto genéricos)
Sistemas de terceiros (que não são do Google Cloud):
- Arquivos do Microsoft SharePoint com menos de 5 MB (como PDFs, arquivos do Office e documentos de texto genéricos, exceto formatos legados ou imagens)
- Repositórios do GitHub (qualquer arquivo que contenha texto legível)
- Corpos de página do Atlassian Confluence
Fontes de autoaprendizagem
Para identificar lacunas de conhecimento em registros de interação reais, o agente de enriquecimento extrai trajetórias do seguinte:
- Aplicativos do Gemini Enterprise
- Tabelas de análise de agentes do BigQuery
- Cloud Logging usando visualizações de registro com escopo
Como o agente de enriquecimento funciona
Quando você aciona uma tarefa de enriquecimento, seja on demand ou de forma recorrente, uma execução de enriquecimento é iniciada. O agente de enriquecimento é executado de forma assíncrona em segundo plano, analisando seus recursos de dados, traces de consulta e documentação para produzir propostas de metadados verificadas.
O diagrama a seguir ilustra a arquitetura de alto nível do fluxo de trabalho de um agente de enriquecimento:
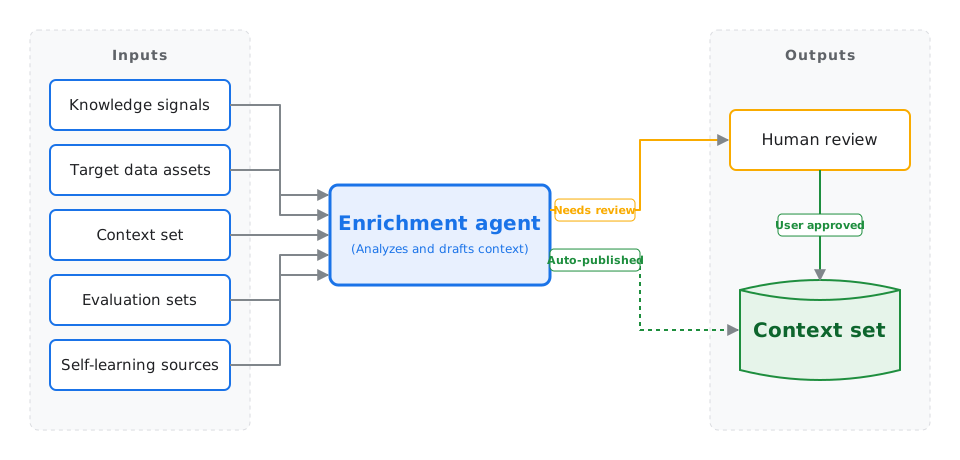
O agente organiza seu conjunto de contexto em quatro fases principais:
- Análise de sinais e documentação: o agente analisa os registros de interação para encontrar onde os agentes de IA downstream tiveram dificuldades ou precisaram de desambiguação. Ele verifica documentos corporativos no Cloud Storage ou em apps de terceiros vinculados e examina o histórico de consultas para descobrir mesclagens de tabelas de alta frequência e dependências upstream.
- Elaboração de propostas de contexto: guiado pela meta de curadoria, o agente elabora um contexto estruturado para os recursos de destino. Isso inclui visões gerais de tabelas orientadas para negócios, fórmulas de métricas formais, condições de mesclagem verificadas e modelos de consulta SQL baseados em parâmetros de ouro.
- Comparação de mercado e otimização: usando as perguntas de teste do conjunto de avaliação, o agente testa iterativamente os próprios metadados elaborados, refinando as descrições até que a acurácia da consulta downstream seja maximizada. Em seguida, ele executa consultas de teste retidas para calcular uma taxa de erro de regressão. Cada descrição ou regra de métrica proposta recebe uma pontuação de confiança.
- Aplicação de políticas de revisão: as propostas que atendem ao limite de confiança acionam as regras da política. Se você ativou a publicação automática e a taxa de erro de regressão está dentro do limite permitido, as mudanças são mescladas automaticamente. Se o erro de regressão exceder o limite permitido, a publicação automática será interrompida imediatamente, e todas as propostas serão agrupadas em uma única solicitação de mudança para revisão humana.
Segurança e governança de dados
Como as tarefas de enriquecimento do Knowledge Studio usam inteligência artificial para analisar seus esquemas de dados e documentação interna, a plataforma implementa limites rígidos para proteger suas informações reservadas.
Treinamento de modelos de fundação: seus dados continuam sendo seus. Os traces de execução, os esquemas de banco de dados e os indicadores de conhecimento fornecidos pelo cliente (como documentos ou glossários internos) nunca são usados para treinar os modelos de fundação do Google.
Sanitização de dados: antes que qualquer metadado proposto seja gravado em um conjunto de contexto, o agente oculta automaticamente as informações de identificação pessoal (PII) dos registros do sistema e dos traces de geração.
Limites de execução: o agente de enriquecimento opera em um locatário seguro gerenciado pelo Google. Ele acessa com segurança suas fontes de dados particulares usando uma interface do Private Service Connect e um proxy de saída controlado pelo cliente.
Status de compliance: durante a fase de pré-lançamento atual, as tarefas de enriquecimento não são compatíveis com o VPC Service Controls (VPC-SC), as chaves de criptografia gerenciadas pelo cliente (CMEK) ou o Assured Workloads.
Configurações recomendadas
O Knowledge Catalog oferece várias configurações opcionais para tarefas de enriquecimento. Recomendamos começar com uma configuração básica e ativar progressivamente os recursos avançados à medida que você escalona as operações de metadados.
| Configuração | Componentes incluídos | Publicação automática | Recomendado para |
|---|---|---|---|
| Basic | Conjunto de contextos | Desativado | Teste a ferramenta. Permite ver como o agente infere metadados estritamente do esquema do conjunto de dados. Você precisa revisar todas as propostas manualmente. |
| Empírico |
|
Desativado | Ambientes de Production. Baseia o agente na sua lógica de negócios específica, usando seus procedimentos operacionais padrão e glossários para melhorar a precisão. |
| Automatizado |
|
Ativado | Operações de metadados de escalonamento. O conjunto de avaliação funciona como uma proteção. Se uma proposta gerada automaticamente causar uma regressão na precisão downstream, a publicação será interrompida para revisão manual. |
| Autoaprendizado |
|
Ativado | Catálogos avançados e autônomos. O agente se adapta continuamente analisando as interações dos usuários em tempo real e os registros de chat do agente para identificar e corrigir lacunas de conhecimento. |
Limitações e limites de pré-lançamento
Durante o pré-lançamento, as tarefas de enriquecimento operam dentro dos seguintes limites:
Gerenciamento priorizando o console: você configura e gerencia tarefas exclusivamente pelo console do Google Cloud . As APIs REST públicas diretas e os comandos da CLI
gcloudnão estão disponíveis no pré-lançamento.Cotas e limites: as tarefas de enriquecimento e as execuções de tarefas estão sujeitas a cotas de taxa e recursos regionais por projeto. Para mais informações, consulte a seção "Tarefas de enriquecimento do Knowledge Studio" em Cotas e limites.
Ciclo de vida da implantação
O processo de criação e implantação de uma tarefa de enriquecimento segue um ciclo de vida linear:
- Configurar pré-requisitos: conceda os papéis necessários, configure as contas de serviço e ative a criação de perfis de dados e os insights de dados de IA em tabelas usadas com frequência. Para mais informações, consulte Configurar pré-requisitos para tarefas de enriquecimento.
- Vincular conhecimento externo: autorize a tarefa a ler arquivos do Google Drive ou de repositórios Git externos para embasamento.
- Criar a tarefa: defina o conjunto de contexto, os recursos de destino, os indicadores de conhecimento e a estratégia de avaliação.
- Analise as propostas de IA: verifique os diagnósticos de execução, analise as descrições propostas e aprove as mudanças de metadados.
A seguir
Visão geral do Knowledge Studio
Conheça os principais conceitos e a arquitetura do Knowledge Studio.
Visão geral dos conjuntos de contexto
Saiba como os metadados gerados por tarefas de enriquecimento são armazenados em conjuntos de contexto para embasar agentes de IA.
Configurar pré-requisitos de enriquecimento
Saiba como configurar papéis do e contas de serviço para executar tarefas de enriquecimento.
Criar tarefas de enriquecimento
Saiba como gerar metadados executando tarefas de enriquecimento automatizadas.
Gerenciar execuções de enriquecimento
Saiba como monitorar jobs e revisar ou aprovar manualmente propostas de metadados.
Gerenciar tarefas de enriquecimento
Saiba como editar, pausar e excluir jobs de enriquecimento programados.