


Os conjuntos de contexto do Knowledge Catalog permitem empacotar esquemas de dados, definições semânticas e padrões de consulta validados em contêineres de conhecimento limitados e específicos do domínio. Esse conhecimento de domínio direcionado embasa de forma confiável aplicativos de IA autônomos, como o Gemini Enterprise e agentes personalizados, para que eles possam operar com alta precisão.
Este documento é destinado a arquitetos de dados, líderes de governança e engenheiros de IA que querem entender como os conjuntos de contexto estruturam o conhecimento de domínio para agentes de IA.
O que é um conjunto de contexto?
Um conjunto de contexto é um grupo de entradas especializado do Knowledge Catalog (um contêiner lógico para registros de metadados) que empacota uma coleção independente de informações semânticas e referências de recursos de dados para domínios analíticos específicos e agentes de IA.
Dentro desse contêiner, o conhecimento é organizado em entradas, que representam conceitos de negócios, documentos ou recursos de dados individuais. Essas entradas são enriquecidas com aspectos, que são atributos de metadados modulares que armazenam detalhes específicos, como termos de negócios, modelos SQL e documentação do Markdown.
Em vez de forçar os agentes a pesquisar em todo o catálogo de uma empresa, o que introduz latência, desperdiça tokens de comando e corre o risco de gerar respostas alucinadas, os conjuntos de contexto estabelecem contêineres de conhecimento herméticos e com escopo de domínio que os agentes podem consultar com alta precisão.
Como os conjuntos de contexto funcionam como contêineres administrativos, é possível organizar os metadados por propriedade do projeto e aplicar políticas de controle de acesso do Identity and Access Management (IAM) em todas as entradas agrupadas de uma só vez, sem configurar permissões individualmente. Para mais informações sobre grupos de entrada, entradas e aspectos, consulte Sobre o gerenciamento de metadados.
Requisitos de embasamento do agente de IA
À medida que as organizações implantam agentes de IA autônomos (como o Gemini Enterprise, o Antigravity e agentes personalizados do Kit de Desenvolvimento de Agentes) para organizar fluxos de trabalho de dados e gerar análises, os agentes precisam de embasamento confiável:
- Definições semânticas: o que uma coluna ou métrica específica significa em termos de negócios?
- Padrões de consulta validados: como os especialistas em domínio consultaram e uniram essas tabelas?
- Regras operacionais: quais políticas de negócios, critérios de exceção e procedimentos operacionais padrão (SOPs) regem esses dados?
Padrões de nomenclatura recomendados para conjuntos de contexto
O diagrama de arquitetura a seguir ilustra como as quatro convenções de nomenclatura lógica principais operam juntas dentro do limite do grupo de entrada para fundamentar aplicativos de IA downstream:
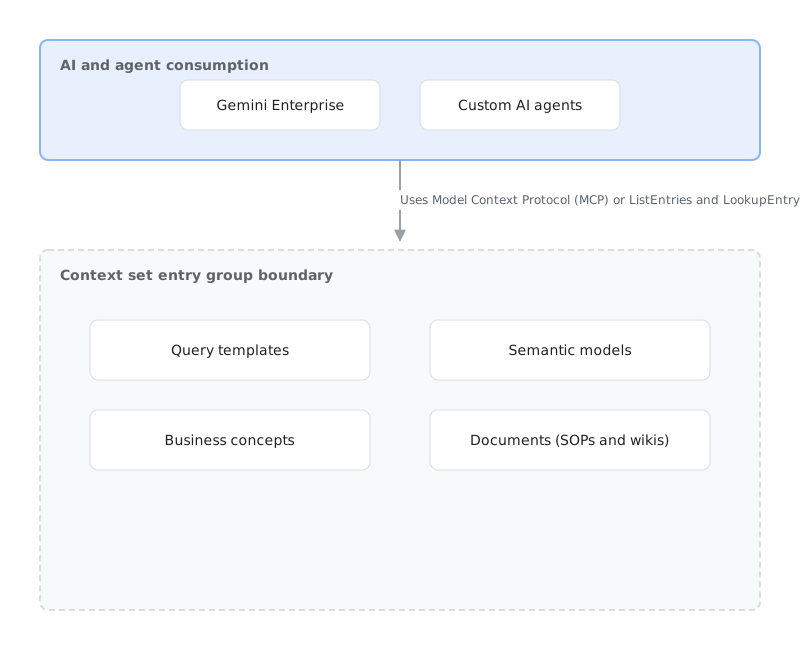
Embora um conjunto de contexto não exija estritamente que todos os tipos de entrada funcionem, recomendamos organizar as entradas usando as seguintes convenções de nomenclatura lógicas. O uso dessas convenções de nomenclatura ajuda a garantir que humanos e agentes autônomos possam descobrir e interpretar o conhecimento de forma consistente:
| Padrão de nomenclatura | Tipo de entrada | Descrição e finalidade | Aspectos anexados |
|---|---|---|---|
Conceitos de negócios concepts_<id> |
generic |
Termos do glossário empresarial, definições de métricas, acrônimos e fórmulas de cálculo. | glossary-term-aspect, contacts. |
Documentos documents_<path> |
document |
Contexto narrativo, procedimentos operacionais padrão (SOPs), wikis de integração e links para documentação externa. | Document, overview (links e Markdown de rich text). |
Modelos de consulta query-templates_<path> |
query-template |
Modelos de consulta SQL parametrizados e pré-validados, lógica de mesclagem de alta frequência e padrões de execução. | query-template (inclui campos como fontes, intent, nlQuery, parâmetros e consulta). |
Modelos semânticos semantic-models_<id> |
semantic-model, semantic-entity, semantic-metric |
Modelos relacionais formais, definições de entidade, hierarquias dimensionais e medições. | semantic-model, semantic-entity, semantic-metric. |
Conceitos de negócios
Uma entrada de conceito de negócios (entrada do tipo genérico que usa a convenção de nomenclatura concepts_*) define terminologia de negócios padronizada, métricas de domínio, acrônimos e fórmulas de cálculo (glossary-term-aspect).
As principais capacidades incluem:
- Alinhamento de terminologia: elimina a ambiguidade de terminologia entre unidades de negócios e equipes de análise.
- Fórmulas de KPI: fornece fórmulas matemáticas e lógica para indicadores principais de desempenho (KPIs) específicos do domínio.
- Propriedade organizacional: estabelece uma propriedade organizacional clara
por meio de aspectos de governança anexados (
contacts).
Por exemplo, em um conjunto de contexto de e-commerce, uma entrada em concepts_net_items_sold especifica o cálculo exato das unidades líquidas vendidas. Quando
um agente recebe um comando pedindo "itens líquidos vendidos", ele consulta a entrada
do conceito para aplicar o cálculo verificado em vez de inventar uma lógica SQL.
Exemplo de representação de recurso:
name: projects/cymbal-style/locations/us-central1/entryGroups/online-apparel-store/entries/concepts_net_items_sold
entryType: generic
aspects:
  dataplex-types.global.glossary-term-aspect:
    definition: "Calculates the absolute number of items sold minus customer returns in a given time period."
Documentos
Uma entrada de documento (entrada do tipo documento usando a convenção de nomenclatura documents_*)
armazena o contexto narrativo e processual em Markdown estruturado
(Document, overview).
As principais capacidades incluem:
- Procedimentos operacionais padrão (SOPs): captura SOPs, checklists de runbooks e guias de integração diretamente no catálogo.
- Políticas de compliance: documenta as políticas de compliance, as restrições regulatórias (como as regras de tratamento do GDPR ou da HIPAA) e os critérios de exceção.
- Wikis de referência externa: faz referência a wikis externas (como
documentos do Google, Atlassian Confluence, Notion ou GitHub) usando ponteiros de URI de origem (links
overview).
Por exemplo, um conjunto de contexto de vestuário inclui documents_return_policy_rules para
instruir os agentes sobre como excluir vendas finalizadas e itens danificados em trânsito
ao calcular as taxas de devolução padrão.
Exemplo de representação de recurso:
name: projects/cymbal-style/locations/us-central1/entryGroups/online-apparel-store/entries/documents_return_policy_rules
entryType: document
aspects:
  dataplex-types.global.overview:
    content: "## Return Policy Rules\nItems marked FINAL_SALE or DAMAGED_IN_TRANSIT are excluded from return rates..."
Modelos de consulta
Uma entrada de modelo de consulta (entrada do tipo query-template usando a convenção de nomenclatura query-templates_*) contém consultas SQL parametrizadas e verificadas por humanos, mapeadas para intents analíticas comuns de linguagem natural (usando o aspecto query-template).
As principais capacidades incluem:
- Consultas pré-validadas: armazena caminhos de mesclagem, condições de filtro e padrões de agregação pré-validados para perguntas de negócios de alta frequência.
- Parametrização do ambiente de execução: permite a substituição de parâmetros do ambiente de execução (como
@start_date,@regione@limit) para a execução dinâmica do agente. - Prevenção de erros: evita junções de tabelas alucinadas e erros de sintaxe de dialeto SQL.
Por exemplo, quando um agente precisa responder a uma pergunta sobre as contas com melhor desempenho, ele faz a correspondência de query-templates_sales_top_accounts_by_arr e substitui o período solicitado no modelo SQL verificado.
Exemplo de representação de recurso:
name: projects/cymbal-style/locations/us-central1/entryGroups/online-apparel-store/entries/query-templates_top_categories_by_season
entryType: query-template
aspects:
  dataplex-types.global.query-template:
    intent: "Which e-commerce product categories performed best this season?"
    query: "SELECT category, SUM(revenue) FROM sales WHERE season = @season GROUP BY category ORDER BY 2 DESC LIMIT @limit"
    parameters:
      -   name: "season"
        type: "STRING"
      -   name: "limit"
        type: "INTEGER"
Modelos semânticos
As entradas de modelo semântico (usando os tipos de entrada semantic-model, semantic-entity e
semantic-metric com a convenção de nomenclatura semantic-models_*)
formalizam estruturas relacionais, hierarquias dimensionais e medidas de agregação
em tabelas normalizadas.
As principais capacidades incluem:
Definição relacional: define chaves primárias, chaves externas e cardinalidades de mesclagem (como relações de um para muitos ou de muitos para muitos).
Mapeamento de dimensões de negócios: mapeia colunas subjacentes brutas para dimensões de negócios, granularidades de tempo e medidas reutilizáveis.
Orientação do agente: orienta os agentes autônomos na montagem de consultas analíticas complexas de várias tabelas quando não há um modelo de consulta exato.
Abstração da complexidade subjacente: ao contrário dos links de entrada de junção de esquema brutos, que apenas documentam conexões de tabela mecânicas no conjunto de dados de origem, os modelos semânticos operam na camada lógica de negócios para evitar que o agente de IA alucine travessias incorretas de diagramas de ER.
Por exemplo, um conjunto de contexto de vestuário usa semantic-models_apparel_sales_model
para definir como warehouses, shipments e line_items se unem em
tabelas de fatos e dimensões de esquema em estrela.
Exemplo de representação de recurso:
name: projects/cymbal-style/locations/us-central1/entryGroups/online-apparel-store/entries/semantic-models_apparel_sales_model
entryType: semantic-model
aspects:
  dataplex-types.global.semantic-model:
    entities:
      -   name: "products"
      -   name: "orders"
    relationships:
      -   sourceEntity: "orders"
        foreignKey: "product_id"
        targetEntity: "products"
        primaryKey: "id"
        type: "MANY_TO_ONE"
Exemplo: conjunto de contexto de uma loja de roupas on-line
Para mostrar como as quatro convenções de nomenclatura funcionam juntas, considere uma loja de roupas on-line que implanta um assistente de IA para os comerciantes da loja. Sem um contexto limitado, o agente pode consultar tabelas de preparo brutas ou contar incorretamente itens populares por não subtrair as devoluções dos clientes.
Para embasar o agente, um gestor de dados cria um conjunto de contexto chamado
online-apparel-store:
EntryGroup: projects/cymbal-style/locations/us-central1/entryGroups/online-apparel-store
(EntryGroup.type = "context-set")
│
├── concepts_* (Business concepts)
│   ├── concepts_net_items_sold
│   │     Formula: SUM(orders.quantity) - SUM(returns.quantity)
│   └── concepts_bestseller
│         Definition: Any clothing item with >= 500 net units sold within a 30-day window
│
├── documents_* (Documents and SOPs)
│   ├── documents_return_policy_rules
│   │     Markdown SOP: Exclude items marked 'FINAL_SALE' or 'DAMAGED_IN_TRANSIT' from standard return rates
│   └── documents_size_chart_guide
│         Markdown guide: Sizing conversions across US, UK, and EU clothing labels
│
├── query-templates_* (Golden SQL queries)
│   └── query-templates_top_categories_by_season
│         Verified SQL template with parameters: @season, @limit
│
└── semantic-models_* (Semantic models)
    └── semantic-models_apparel_sales_model
          Join keys: orders.product_id = products.product_id (many-to-one)
                     orders.order_id = returns.order_id (one-to-many)
Como um agente resolve um comando
Quando um comerciante pergunta ao agente: "Quais foram os cinco estilos de jaqueta de inverno mais vendidos, excluindo devoluções de itens danificados?", o agente resolve o comando pelo conjunto de contexto:
Pesquisa de modelo de consulta: o agente verifica
query-templates_*e faz a correspondência comquery-templates_top_categories_by_season, substituindo@season = 'Winter'e@limit = 5.Verificação de conceito: o agente inspeciona
concepts_net_items_soldeconcepts_bestsellerpara confirmar que os itens devolvidos precisam ser subtraídos das quantidades totais do pedido.Aplicação da regra SOP: o agente lê
documents_return_policy_rulese adiciona a condição de filtroWHERE return_reason != 'DAMAGED_IN_TRANSIT'.Validação de esquema e mesclagem: usando
semantic-models_apparel_sales_modele as tabelas@bigqueryvinculadas, o agente mesclastore.orders,store.productsestore.returnsusando chaves externas verificadas e executa a consulta SQL.
Capacidades de arquitetura
Os conjuntos de contexto oferecem vários recursos essenciais para ambientes de dados corporativos:
Limites de execução herméticos: ao limitar o contexto a um conjunto selecionado de recursos e entradas semânticas, os agentes operam em um sandbox hermético. Isso elimina o ruído de catálogo estranho, ajuda a garantir avaliações determinísticas e minimiza o uso de tokens.
Upload rápido e indexação em massa: as equipes podem fazer upload e indexar conjuntos de conceitos, consultas e documentos como uma única operação atômica, o que permite a integração com pipelines de integração e implantação contínuas (CI/CD).
Empacotamento sem cópia: o contexto define metadados e relacionamentos de pacotes sem copiar ou mover o repositório de dados subjacente, evitando custos de armazenamento redundantes e atrasos na sincronização de dados.
Padrões de consulta de agentes
Os agentes downstream consomem conjuntos de contexto pelo Protocolo de Contexto de Modelo (MCP) ou pelas APIs diretas do Knowledge Catalog. Para mais informações, consulte Recuperar contexto de dados com as APIs Catalog. Para otimizar a latência de resposta e minimizar o consumo de tokens, os agentes seguem uma hierarquia de consulta de três níveis:
Correspondência de modelo de consulta: o agente pesquisa
query-templates_*. Se um modelo verificado corresponder à intent do usuário, o agente vai parametrizar a consulta e executá-la diretamente. Isso fornece a resposta mais rápida com risco quase zero de erro de consulta.Montagem do modelo semântico: se nenhum modelo de consulta corresponder, o agente vai avaliar
semantic-models_*para entender as relações de entidade e criar uma instrução SQL de várias tabelas.Consulta de documentos e conceitos: para casos extremos ambíguos (como limites de calendário fiscal ou exclusões de disputas), o agente lê
concepts_*edocuments_*para aplicar regras de negócios.
Como consumir contexto em aplicativos de IA generativa
Os aplicativos de IA generativa usam conjuntos de contexto selecionados para entender a semântica do domínio empresarial, navegar por esquemas complexos e gerar SQL confiável sem alucinações. Os aplicativos normalmente consomem esses conjuntos de contexto por meio de dois padrões principais:
Descoberta de contexto dinâmico: em ambientes de análise de conversação ou de autoatendimento, os usuários fazem perguntas ad hoc em linguagem natural. O aplicativo avalia dinamicamente a intenção do usuário para identificar e recuperar o conjunto de contexto mais relevante do Knowledge Catalog, inserindo o conhecimento de domínio recuperado no comando ativo.
Conjuntos de contexto pré-configurados: para aplicativos de agente dedicados, é possível pré-configurar o agente com uma referência explícita de conjunto de contexto fornecendo o URI do recurso. A vinculação de um conjunto de contexto dedicado fornece embasamento determinístico, garantindo que todas as interações usem definições de negócios certificadas sem sobrecarga de pesquisa em tempo de execução. O agente herda automaticamente as melhorias de qualidade à medida que os fluxos de trabalho de enriquecimento recorrentes refinam o conjunto de contexto ao longo do tempo.
Para otimizar esses recursos de enriquecimento e autoaprendizado, recomendamos especificar um modelo Gemini 3.8 Flash ou posterior no aplicativo Gemini Enterprise. Para mais informações sobre as etapas de seleção de modelos, consulte a seção "Criar um agente usando o criador de fluxos" em Criar agentes no Agent Studio.
Como os conjuntos de contexto se comparam a construções relacionadas
Para escolher a construção de metadados certa para sua arquitetura, leia como os conjuntos de contexto do Knowledge Catalog se comparam aos recursos relacionados da plataforma.
Conjuntos de contexto em comparação com gráficos de contexto
O gráfico e os conjuntos de contexto são duas construções separadas com papéis distintos na arquitetura do Knowledge Studio:
Gráfico de contexto: a topologia semântica abrangente e em tempo real da sua organização. Ele vincula recursos de dados subjacentes, termos do glossário empresarial e traces de interação. Você explora e atravessa esse gráfico aberto de forma interativa na interface Explorar.
Conjunto de contexto: uma unidade de empacotamento limitada, regional e selecionada. Ele extrai e empacota de forma hermética um subconjunto específico de conhecimento de domínio em um grupo de entrada (
type="context-set") para que os agentes de IA downstream façam consultas pelo Protocolo de Contexto de Modelo (MCP). Um conjunto de contexto atua como um subgráfico coeso e de alta densidade dentro do gráfico de contexto mais amplo.
Conjuntos de contexto do Knowledge Catalog em comparação com conjuntos de contexto de banco de dados
Tanto o Knowledge Catalog quanto os bancos de dados operacionais do Google Cloud usam o termo conjunto de contexto para se referir a informações selecionadas que embasam modelos de IA generativa.
Embora as duas variações compartilhem a mesma arquitetura, elas são armazenadas
nativamente como conjuntos de contexto do Knowledge Catalog (grupos de entrada
extensíveis com type="context-set") e usam APIs padrão
do Knowledge Catalog, elas visam camadas diferentes da
pilha de dados corporativos:
- Conjuntos de contexto de banco de dados (QueryData): criados para atender a bancos de dados operacionais e transacionais (como AlloyDB para PostgreSQL, Cloud SQL e Spanner). Esses conjuntos de contexto são altamente otimizados para configurações do SQL. Eles agrupam modelos de consulta de ouro, metadados de esquema e facetas de filtragem que um agente de engenharia de contexto dedicado avalia para melhorar a tradução de linguagem natural para SQL (NL2SQL) em ambientes de execução operacionais.
- Conjuntos de contexto do Knowledge Catalog (Knowledge Studio): criados para atender a propriedades de dados analíticos (como BigQuery, data lake houses e produtos de dados do Knowledge Catalog). Esses conjuntos de contexto reúnem conhecimento mais amplo e multimodal em várias convenções de nomenclatura, incluindo conceitos de negócios, wikis de documentação do Markdown e modelos semânticos. Eles são selecionados usando fluxos de trabalho de enriquecimento do Knowledge Studio e disponibilizados para agentes analíticos downstream pelo Protocolo de Contexto de Modelo (MCP).
Conjuntos de contexto em comparação com produtos de dados
Entender como os conjuntos de contexto interagem com os produtos de dados do Knowledge Catalog ajuda a estabelecer limites claros de governança de dados e IA:
Os produtos de dados gerenciam os recursos subjacentes:eles agrupam com segurança recursos concretos, como tabelas, buckets e streams do BigQuery, estabelecendo uma unidade principal para compartilhamento de dados, contratos de dados e controle de acesso ao plano de dados.
Os conjuntos de contexto agrupam a semântica de conversação:eles não concedem acesso aos dados. Em vez disso, agrupam o conhecimento do domínio, como conceitos, modelos de consulta e documentos necessários para que os agentes de IA e os humanos entendam os dados. Os gestores de dados podem vincular um conjunto de contexto a um produto de dados declarando-o nas referências
additional_contextdo produto.
Segurança e governança corporativas
Os conjuntos de contexto se integram aos Google Cloud controles de segurança e governança para ajudar a proteger metadados empresariais sensíveis:
Papéis do IAM de conjuntos de contexto: como os conjuntos de contexto geralmente contêm informações semânticas sensíveis, o acesso é regido por papéis do IAM aplicados diretamente ao grupo de entrada
context-set. Isso permite organizar o conhecimento selecionado por região geográfica e propriedade de domínio, concedendo permissões de modificação aos administradores de domínio e permissões de leitura aos agentes de IA consumidores. Para criar um conjunto de contexto, é preciso ter a permissãodataplex.entryGroups.setIamPolicydo IAM. Essa permissão é necessária para conceder automaticamente permissões de proprietário durante a criação do conjunto de contexto. É possível receber essa permissão por papéis predefinidos, como Administrador do Dataplex Catalog (roles/dataplex.catalogAdmin) ou Proprietário de grupos de entradas do Dataplex (roles/dataplex.entryGroupOwner).Segurança de dados subjacente sem cópia: conceder a um agente acesso a um conjunto de contexto permite que ele leia metadados semânticos e modelos de consulta, mas não ignora os controles de acesso nas tabelas subjacentes. Para executar uma consulta SQL no BigQuery ou ler arquivos no Cloud Storage, a identidade que executa a consulta precisa ter as permissões de IAM do plano de dados necessárias nesses recursos.
Governança human-in-the-loop: quando as tarefas autônomas de enriquecimento do Knowledge Studio extraem novos conceitos, SOPs ou modelos de consulta de registros operacionais, as propostas são preparadas como solicitações de mudança que podem ser revisadas. Os administradores de dados inspecionam as comparações de diferenças e as pontuações de avaliação antes de aprovar mudanças em um conjunto de contexto de produção. Para mais informações sobre a revisão de propostas, consulte Gerenciar solicitações.
Identidade de execução gerenciada pelo usuário: as tarefas de enriquecimento automatizadas que preenchem conjuntos de contexto são executadas em uma conta de serviço gerenciada pelo usuário representada pelo agente de serviço do Dataplex por meio do papel de Criador de token da conta de serviço (
roles/iam.serviceAccountTokenCreator).
Escopo e limites da prévia
Durante o pré-lançamento, os conjuntos de contexto operam dentro dos seguintes limites:
Escopo regional: conjuntos de contexto global vinculados a recursos de dados regionais não são aceitos. Um conjunto de contexto precisa estar alinhado com os limites regionais dos recursos que ele empacota.
Interfaces de criação e consumo: é possível criar conjuntos de contexto pelo contêiner do Knowledge Studio no console do Google Cloud , mantendo-os logicamente distintos dos grupos de entrada administrativos padrão do Knowledge Catalog. É possível preencher conjuntos de contexto automaticamente com fluxos de trabalho de enriquecimento do Knowledge Studio. Os agentes de IA downstream podem descobrir e consultar conjuntos de contexto de forma programática usando as APIs do Knowledge Catalog (
ListEntrieseLookupEntry) e o Protocolo de Contexto de Modelo (MCP). Para mais informações, consulte Sobre os servidores MCP.Faturamento: o Knowledge Catalog não cobra uma SKU independente separada para criar grupos de entrada de conjunto de contexto.
Cotas compartilhadas: como os conjuntos de contexto são, fundamentalmente, grupos de entradas especializados (
type="context-set"), eles consomem e compartilham as mesmas cotas de recursos que os grupos de entradas padrão do Knowledge Catalog.
A seguir
Visão geral do Knowledge Studio
Saiba como organizar contextos de dados avançados, criar conjuntos de contexto e embasar agentes de IA usando as interfaces do Knowledge Studio.
Analisar recursos de dados e o gráfico de contexto
Use a tela visual no Knowledge Studio para conversar com seus dados e rastrear relações semânticas.
Sobre o gerenciamento de metadados
Entender como entradas, grupos de entradas e aspectos formam a base estrutural dos conjuntos de contexto.
Sobre os servidores MCP
Expor conjuntos de contexto e metadados avançados para agentes de IA generativa downstream usando o MCP.
Recuperar o contexto de dados com as APIs Catalog
Descubra e recupere de forma programática conjuntos de contexto para raciocínio de IA generativa usando as APIs "ListEntries" e "LookupEntry".
Gerenciar conjuntos de contexto
Saiba como criar, visualizar, editar e excluir conjuntos de contexto no para organizar o conhecimento do domínio.