


Document AI te permite entrenar versiones nuevas del procesador con tus propios datos de entrenamiento y evaluar la calidad de la versión del procesador con tus propios datos de prueba.
Esto es útil cuando deseas usar un procesador personalizado. Existe un procesador de Document AI para tu tipo de documento, pero puedes entrenar una versión personalizada para satisfacer tus necesidades.
Por lo general, el entrenamiento y la evaluación se realizan en conjunto para iterar hacia una versión del procesador utilizable y de alta calidad.
Document AI
Document AI te permite crear tu propio extractor personalizado, que extrae entidades de documentos de un tipo particular, por ejemplo, los elementos de un menú o el nombre y la información de contacto de un currículum.
A diferencia de otros procesadores, los procesadores personalizados no incluyen versiones de procesador preentrenadas y, por lo tanto, no pueden procesar ningún documento hasta que entrenes una versión desde cero.
Para comenzar a usar Document AI, consulta Crea tu propio procesador personalizado.
Cómo enriquecer un procesador
Puedes entrenar versiones nuevas del procesador para mejorar la precisión en tus datos, extraer campos personalizados adicionales de tus documentos y agregar compatibilidad con idiomas nuevos.
El entrenamiento ascendente funciona aplicando el aprendizaje por transferencia en las versiones de procesadores previamente entrenados de Google y, por lo general, requiere menos datos que el entrenamiento desde cero.
Para comenzar, consulta Enriquece un procesador previamente entrenado.
Procesadores compatibles
No todos los procesadores especializados admiten el entrenamiento de actualización. Estos son los procesadores que admiten la actualización.
Consideraciones y recomendaciones sobre los datos
La calidad y la cantidad de tus datos determinan la calidad del entrenamiento, el reentrenamiento y la evaluación.
Obtener un conjunto de documentos representativos del mundo real y proporcionar suficientes etiquetas de alta calidad suele ser la parte del proceso que requiere más tiempo y recursos.
Cantidad de documentos
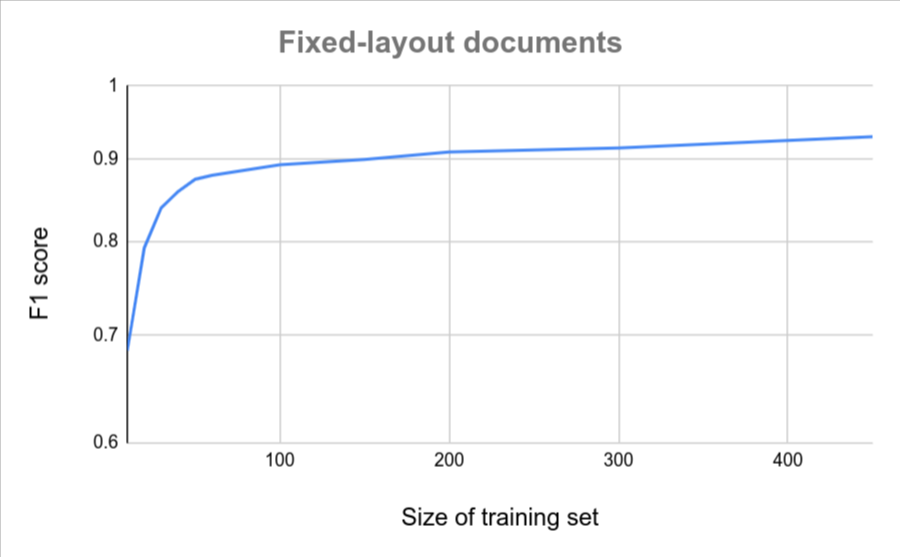
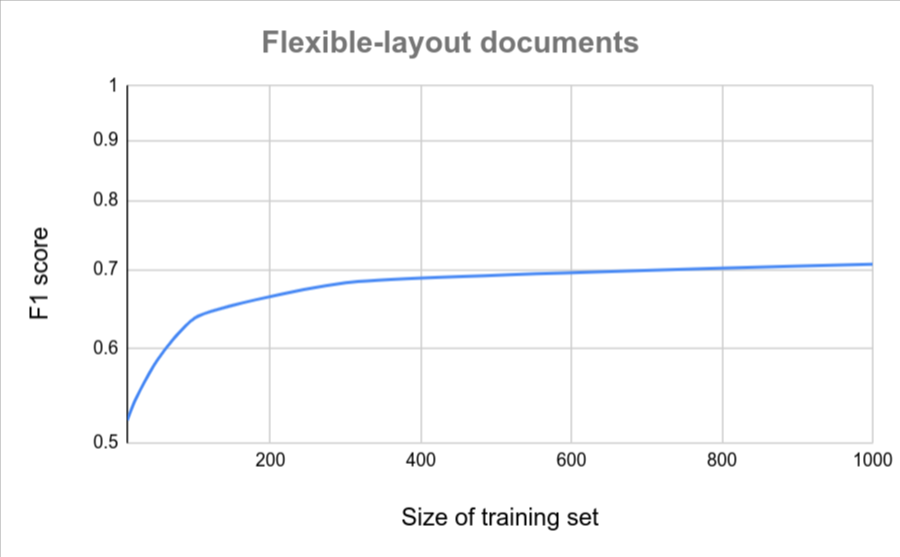
Si todos tus documentos tienen un formato similar (por ejemplo, un formulario fijo con muy poca variación), se requieren menos documentos para lograr la precisión. Cuanto mayor sea la variación, más documentos se requerirán.
Los siguientes gráficos proporcionan una estimación aproximada de la cantidad de documentos que se requieren para que un extractor de documentos personalizado alcance una puntuación de calidad determinada.
| Poca variación | Variación alta |
|---|---|
 |
 |
Etiquetado de datos
Considera tus opciones para etiquetar documentos y asegúrate de tener suficientes recursos para anotar los documentos de tu conjunto de datos.
Entrena modelos
Los procesadores de extractores personalizados pueden usar diferentes tipos de modelos según el caso de uso específico y los datos de entrenamiento disponibles.
- Modelo personalizado: Es un modelo que usa datos de entrenamiento etiquetados.
- Basados en plantillas: Documentos con un diseño fijo
- Basado en modelos: documentos con cierta variación de diseño
- Modelo de IA generativa: Se basa en modelos de base previamente entrenados que requieren un entrenamiento adicional mínimo.
En la siguiente tabla, se ilustran los casos de uso que corresponden a cada tipo de modelo.
| Modelo personalizado | IA generativa | ||
|---|---|---|---|
| Basado en plantillas | Basado en modelos | ||
| Variación del diseño | Ninguno | De baja a media | Alta |
| Cantidad de texto de formato libre (por ejemplo, párrafos en un contrato) | Baja | Baja | Alta |
| Cantidad de datos de entrenamiento necesarios | Baja | Alta | Baja |
| Precisión con datos de entrenamiento limitados | Mayor | Inferior | Mayor |
Aprende a ajustar un procesador con descripciones de propiedades.
Cuándo usar otro procesador
A continuación, se incluyen algunos casos en los que tal vez quieras considerar opciones además de Document AI Workbench o adaptar tu flujo de trabajo.
- Document AI Workbench no admite ciertos formatos de entrada basados en texto (.txt, .html, .docx, .md, etcétera). Considera otras ofertas de procesamiento de lenguaje prediseñadas o personalizadas en Google Cloud, como la API de Cloud Natural Language.
- El esquema del extractor de documentos personalizado admite hasta 150 etiquetas de entidades. Si tu lógica empresarial requiere más de 150 entidades en la definición del esquema, considera entrenar varios procesadores, cada uno orientado a un subconjunto de entidades.
Cómo entrenar un procesador
Si suponemos que ya creaste un procesador que admite el entrenamiento o el enriquecimiento y etiquetaste tu conjunto de datos, puedes entrenar una nueva versión del procesador desde cero. También puedes enriquecer una versión nueva del procesador con una versión existente.
Entrena la versión del procesador
IU web
En la consola de Google Cloud , ve a la pestaña Entrenar del procesador.
Haz clic en Editar esquema para abrir la página Administrar etiquetas. Verifica las etiquetas del procesador.
Las etiquetas que están habilitadas en el momento del entrenamiento determinan las entidades que extrae la nueva versión del procesador. Si una etiqueta está inactiva en el esquema, la versión del procesador no la extraerá, incluso si los documentos están etiquetados.
En la pestaña Train, haz clic en View Label Stats y verifica tu conjunto de prueba y conjunto de entrenamiento. Los documentos etiquetados automáticamente, sin etiquetar o sin asignar se excluyen del entrenamiento y la evaluación.
Haz clic en Entrenar una versión nueva.
El Nombre de la versión define el campo
namedeprocessorVersion.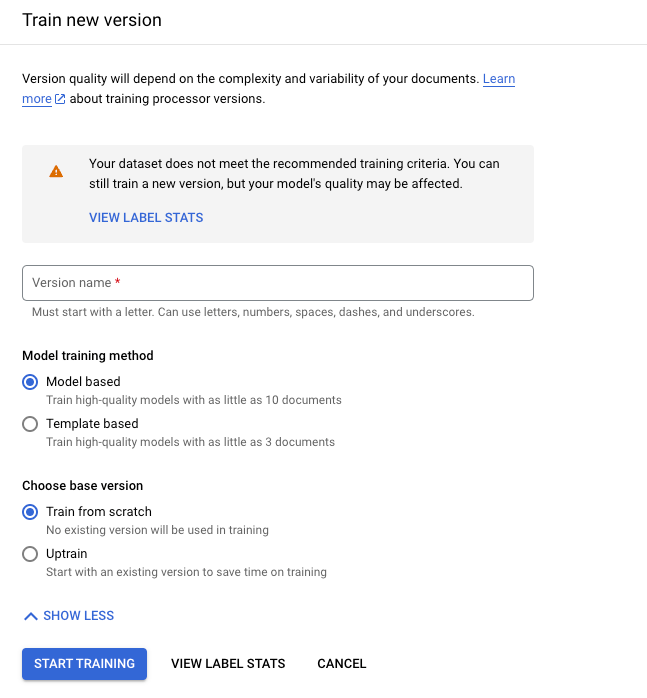
Haz clic en Comenzar entrenamiento y espera a que se entrene y evalúe tu nueva versión del procesador.
Puedes supervisar el progreso del entrenamiento en la pestaña Administrar versiones:
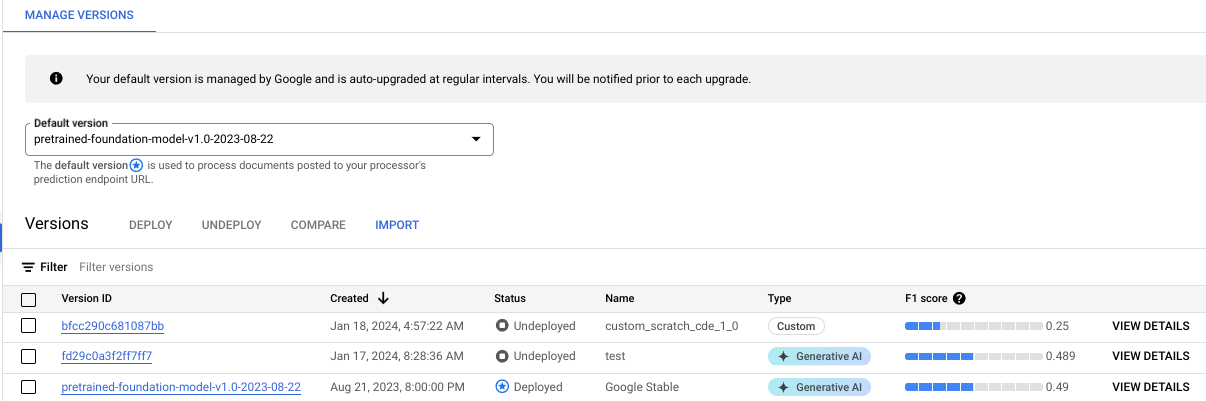
Haz clic en la pestaña Evalúa y prueba para ver el rendimiento de la nueva versión del procesador en el conjunto de prueba. Para obtener más información, consulta Evalúa la versión del procesador.
Python
Para obtener más información, consulta la documentación de referencia de la API de Document AI Python.
Para autenticarte en Document AI, configura las credenciales predeterminadas de la aplicación. Para obtener más información, consulta Configura la autenticación para un entorno de desarrollo local.
Implementa y usa la versión del procesador
Puedes implementar y administrar tus versiones de procesador como cualquier otra versión de procesador. Para obtener más información, consulta Administra versiones de procesadores.
Una vez implementado, puedes enviar una solicitud de procesamiento a tu procesador personalizado.
Inhabilita o borra un procesador
Si ya no quieres usar un procesador, puedes inhabilitarlo o borrarlo. Si inhabilitas un procesador, puedes volver a habilitarlo. Si borras un procesador, no podrás recuperarlo.
En el panel Document AI de la izquierda, haz clic en Mis procesadores.
Haz clic en los puntos verticales a la derecha del nombre del procesador. Haz clic en Inhabilitar procesador o Borrar procesador.
Para obtener más información, consulta Administra versiones de procesadores.
Procesadores con puntuaciones de ajuste y confianza
En las siguientes tablas, puedes revisar los diferentes tipos de procesadores y qué versiones admiten el ajuste y las puntuaciones de confianza.
Para obtener más información sobre las puntuaciones de confianza, consulta umbrales de confianza.
| Extractor personalizado | Canal de versiones | Ajuste | Puntuación de confianza |
|---|---|---|---|
pretrained-foundation-model-v1.5-2025-05-05 |
Estable | Estados Unidos y la UE | Sí |
pretrained-foundation-model-v1.5-pro-2025-06-20 |
Estable | No | Sí |
| Clasificador personalizado | Canal de versiones | Ajuste | Puntuación de confianza |
|---|---|---|---|
pretrained-classifier-v1.5-2025-08-05 |
Estable | EE.UU., UE (vista previa) | Sí |
| Divisor personalizado | Canal de versiones | Ajuste | Puntuación de confianza |
|---|---|---|---|
pretrained-splitter-v1.5-2025-07-14 |
Estable | No | Sí |
Actualiza una versión del procesador ajustado
Puedes actualizar las versiones de procesador de extractores personalizados ajustados a una versión base más reciente. Las configuraciones de la versión base más reciente se basarán en la anterior. Usará los datos de entrenamiento del procesador que se encuentran en las versiones originales.
En la consola de Google Google Cloud , ve a la pestaña Implementar y usar de tu procesador y selecciona una casilla de verificación para una versión compatible del procesador que se actualizará. Esta será la base de la configuración de la nueva versión del procesador.
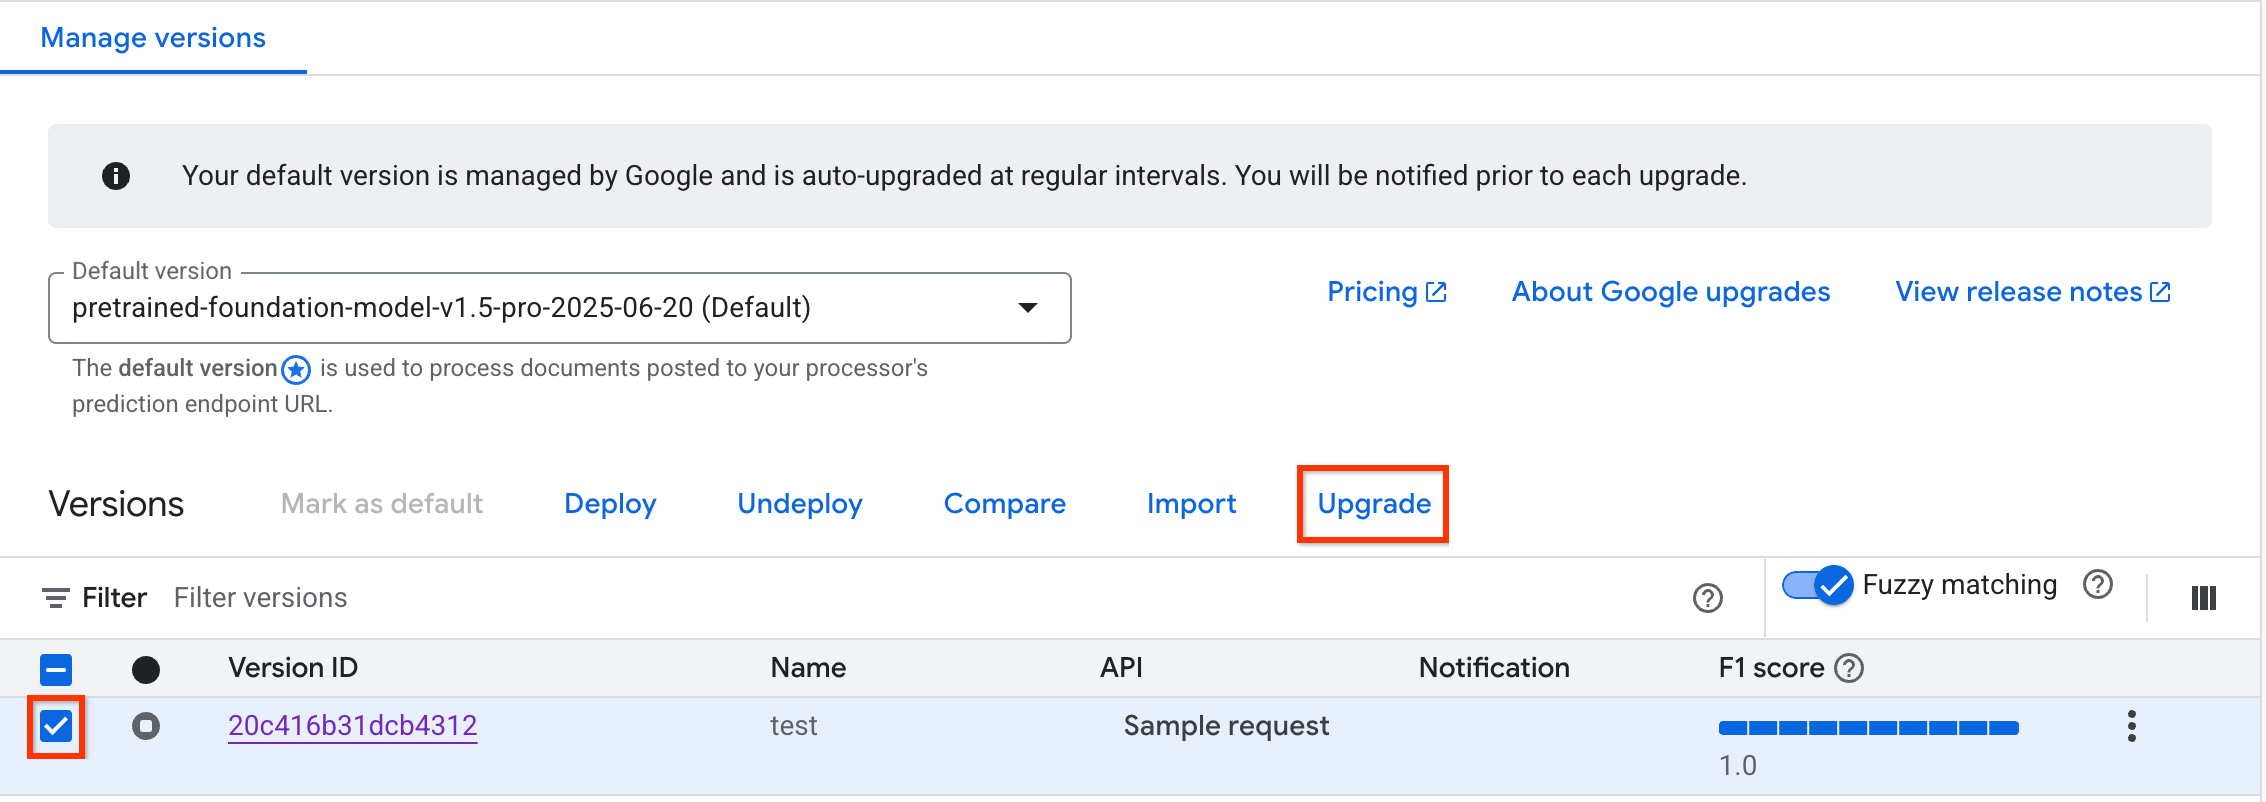
Selecciona la actualización habilitada. Ingresa el nombre y la versión base de la nueva versión del procesador.
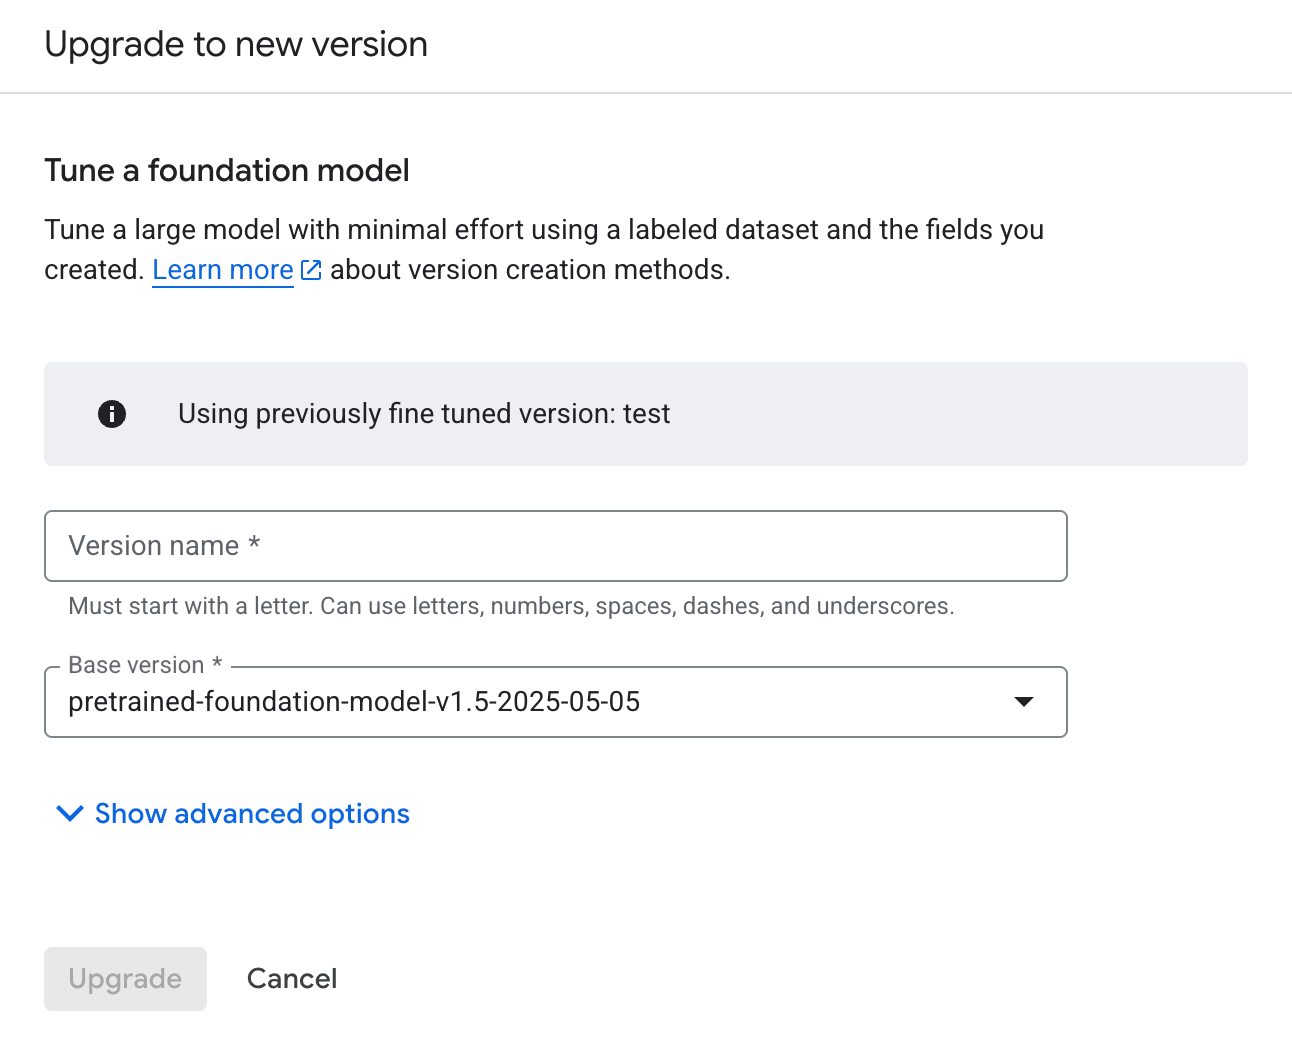
Haz clic en Actualizar y espera a que se entrene la nueva versión del procesador.
Usa la API para actualizar
También puedes usar llamadas a la API para actualizar las versiones del procesador del extractor personalizado ajustado a una versión base más reciente.
curl
En este ejemplo, se muestra cómo migrar un processor existente ajustado con el campo FoundationModelTuningOptions en TrainingMethod.
Antes de usar cualquiera de los datos de solicitud, realiza los siguientes reemplazos con la información de la pestaña Descripción general de la Google Cloud consola de Document AI para tu procesador.
- LOCATION: La ubicación de tu procesador
- PROJECT_ID: ID del proyecto
- PROCESSOR_ID: Es el ID del procesador.
- DISPLAY_NAME: Es el nuevo nombre visible del procesador.
- BASE_PROCESSOR_VERSION: El nombre de la versión actual del procesador del modelo
PROCESSOR_VERSION: ID del procesador actual que se actualizará
curl -X POST -v -H "Authorization: Bearer $(gcloud auth print-access-token)" \
  -H "Content-Type: application/json" \
  "https://LOCATION-documentai.googleapis.com/PROJECT_ID/locations/LOCATION/processors/PROCESSOR_ID/processorVersions:train" \
  -d '{
  "processor_version": {
    "display_name": "DISPLAY_NAME"
  },
  "base_processor_version": "projects/PROJECT_ID/locations/LOCATION/processors/PROCESSOR_ID/processorVersions/BASE_PROCESSOR_VERSION",
  "foundation_model_tuning_options": {
  "train_steps": 10,
  "learning_rate_multiplier": 1,
  "previous_fine_tuned_processor_version_name": "projects/PROJECT_ID/locations/LOCATION/processors/PROCESSOR_ID/processorVersions/PROCESSOR_VERSION",
  }
}'
Encriptación de los datos de entrenamiento
Los datos de entrenamiento de Document AI se guardan en Cloud Storage y se pueden encriptar con claves de encriptación administradas por el cliente si es necesario.
Eliminación de datos de entrenamiento
Una vez que se completa un trabajo de entrenamiento de Document AI, todos los datos de entrenamiento guardados en Cloud Storage vencen después de un período de retención de dos días. Las actividades posteriores de eliminación de datos respetan el proceso descrito en Eliminación de datos en Google Cloud.
Precios
No hay costos de capacitación ni de actualización de la capacitación. Pagas por el hosting y la predicción. Para obtener más información, consulta Precios de Document AI.