


Com a Document AI, é possível treinar novas versões de processadores usando seus próprios dados de treinamento e avaliar a qualidade da versão do processador em relação aos dados de teste.
Isso é útil quando você quer usar um processador personalizado. Há um processador da Document AI para seu tipo de documento, mas é possível treinar uma versão personalizada dele para atender às suas necessidades.
O treinamento e a avaliação geralmente são realizados em conjunto para iterar em direção a uma versão de processador utilizável e de alta qualidade.
Document AI
Com a Document AI, você pode criar seu próprio extrator personalizado, que extrai entidades de documentos de um tipo específico, por exemplo, os itens de um menu ou o nome e dados de contato de um currículo.
Ao contrário de outros processadores, os personalizados não vêm com versões pré-treinadas e, portanto, não podem processar documentos até que você treine uma versão do zero.
Para começar a usar a Document AI, consulte Crie seu próprio processador personalizado.
Aprimorar o treinamento de um processador
É possível aprimorar o treinamento de novas versões de processadores para melhorar a acurácia dos seus dados, extrair mais campos personalizados dos documentos e adicionar suporte a novos idiomas.
O up training funciona aplicando aprendizagem por transferência em versões pré-treinadas do processador do Google e geralmente exige menos dados do que o treinamento do zero.
Para começar, consulte Aprimorar o treinamento de um processador pré-treinado.
Processadores compatíveis
Nem todos os processadores especializados são compatíveis com o treinamento de atualização. Estes são os processadores que oferecem suporte ao treinamento.
Considerações e recomendações de dados
A qualidade e a quantidade dos seus dados determinam a qualidade do treinamento, do uptraining e da avaliação.
Obter um conjunto de documentos representativos do mundo real e fornecer rótulos de alta qualidade suficientes costuma ser a parte mais demorada e que exige mais recursos do processo.
Número de documentos
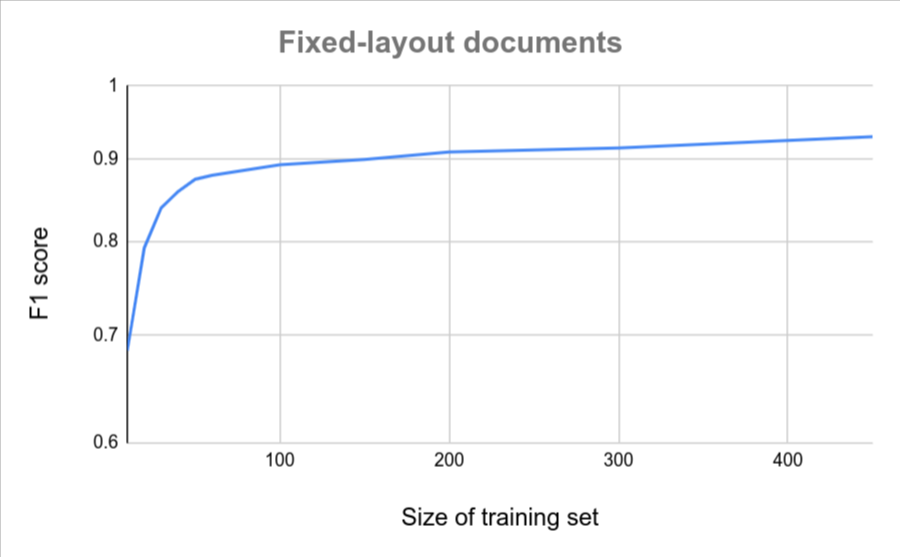
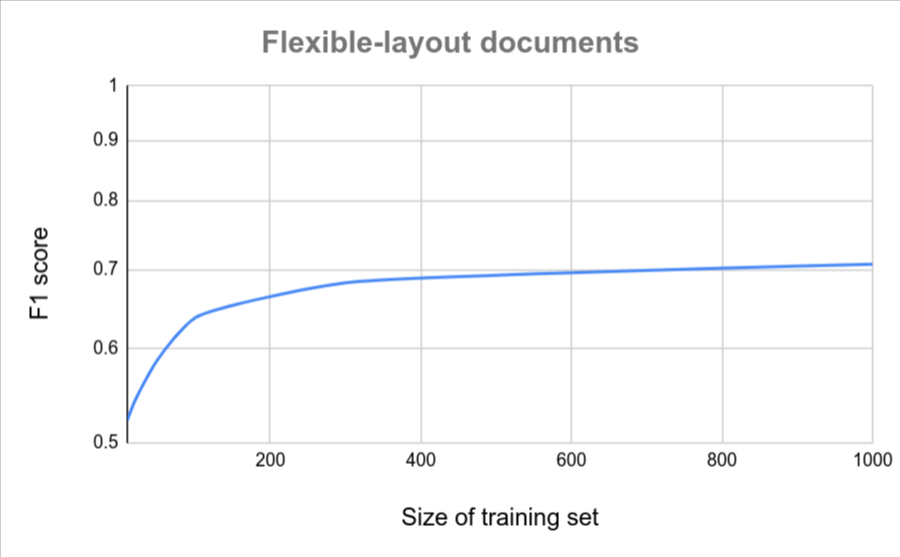
Se todos os documentos tiverem um formato semelhante (por exemplo, um formulário fixo com variação muito baixa), menos documentos serão necessários para alcançar a precisão. Quanto maior a variação, mais documentos são necessários.
Os gráficos a seguir fornecem uma estimativa aproximada do número de documentos necessários para que um extrator de documentos personalizado alcance uma pontuação de qualidade específica.
| Baixa variação | Alta variação |
|---|---|
 |
 |
Rotulagem de dados
Considere suas opções de rotulagem de documentos e verifique se você tem recursos suficientes para anotar os documentos no seu conjunto de dados.
Como treinar modelos
Os processadores de extração personalizados podem usar diferentes tipos de modelos dependendo do caso de uso específico e dos dados de treinamento disponíveis.
- Modelo personalizado: modelo que usa dados de treinamento rotulados.
- Baseado em modelo: documentos com um layout fixo.
- Baseado em modelo: documentos com alguma variação de layout.
- Modelo de IA generativa: baseado em modelos de fundação pré-treinados que exigem treinamento adicional mínimo.
A tabela a seguir ilustra quais casos de uso correspondem a cada tipo de modelo.
| Modelo personalizado | IA generativa | ||
|---|---|---|---|
| Com base em modelos | Com base no modelo | ||
| Variação de layout | Nenhum | Baixa a média | Alta |
| Quantidade de texto livre (por exemplo, parágrafos em um contrato) | Baixo | Baixo | Alta |
| Quantidade de dados de treinamento necessários | Baixo | Alta | Baixo |
| Precisão com dados de treinamento limitados | Maior | Inferior | Maior |
Saiba como ajustar um processador com descrições de propriedades.
Quando usar outro processador
Confira algumas situações em que você pode considerar opções além do Document AI Workbench ou adaptar seu fluxo de trabalho.
- Alguns formatos de entrada baseados em texto (.txt, .html, .docx, .md etc.) não são compatíveis com o Document AI Workbench. Considere outras ofertas de processamento de linguagem pré-criadas ou personalizadas em Google Cloud, como a API Cloud Natural Language.
- O esquema do extrator de documentos personalizado aceita até 150 rótulos de entidade. Se a lógica de negócios exigir mais de 150 entidades na definição do esquema, treine vários processadores, cada um segmentando um subconjunto de entidades.
Como treinar um processador
Supondo que você já tenha criado um processador compatível com treinamento ou aprimoramento e rotulado seu conjunto de dados, é possível treinar uma nova versão do processador do zero. Ou você pode aprimorar o treinamento de uma nova versão do processador com base em uma versão atual.
Treinar versão do processador
IU da Web
No console do Google Cloud , acesse a guia Treinar do processador.
Clique em Editar esquema para abrir a página Gerenciar marcadores. Verifique os rótulos do processador.
Os rótulos ativados no momento do treinamento determinam as entidades que a nova versão do processador extrai. Se um rótulo estiver inativo no esquema, a versão do processador não vai extrair esse rótulo, mesmo que os documentos estejam rotulados.
Na guia Treinar, clique em Ver estatísticas de rótulos e verifique seu conjunto de teste e treinamento. Os documentos rotulados automaticamente, sem rótulo ou não atribuídos são excluídos do treinamento e da avaliação.
Clique em Treinar nova versão.
O Nome da versão define o campo
namedoprocessorVersion.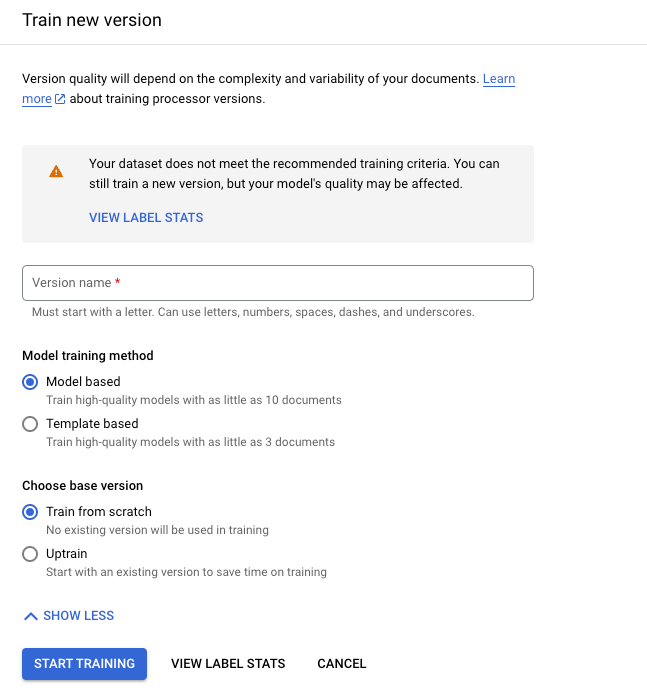
Clique em Iniciar treinamento e aguarde a nova versão do processador ser treinada e avaliada.
É possível monitorar o progresso do treinamento na guia Gerenciar versões:
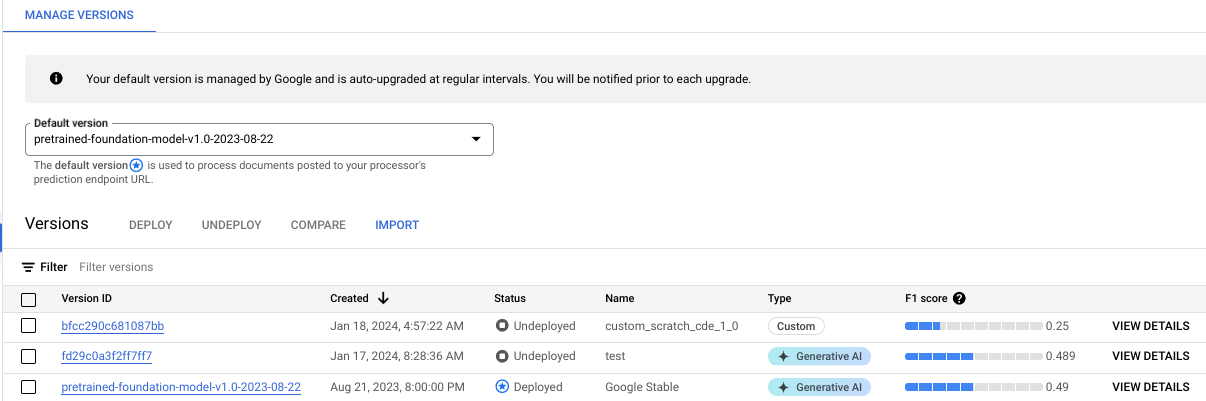
Clique na guia Avaliar e testar para conferir o desempenho da nova versão do processador no conjunto de teste. Para mais informações, consulte Avaliar versão do processador.
Python
Para mais informações, consulte a documentação de referência da API Python da Document AI.
Para autenticar na Document AI, configure o Application Default Credentials. Para mais informações, consulte Configurar a autenticação para um ambiente de desenvolvimento local.
Implantar e usar a versão do processador
É possível implantar e gerenciar suas versões de processador como qualquer outra versão de processador. Para mais informações, consulte Como gerenciar versões de processadores.
Depois de implantado, envie uma solicitação de processamento para o processador personalizado.
Desativar ou excluir um processador
Se você não quiser mais usar um processador, desative ou exclua-o. Se você desativar um processador, poderá reativá-lo. Não é possível recuperar um processador excluído.
No painel Document AI à esquerda, clique em Meus processadores.
Clique nos pontos verticais à direita do nome do processador. Clique em Desativar processador ou Excluir processador.
Para mais informações, consulte Como gerenciar versões de processadores.
Processadores com ajuste fino e pontuações de confiança
Nas tabelas a seguir, você pode conferir os diferentes tipos de processadores e quais versões são compatíveis com ajuste refinado e pontuações de confiança.
Para mais informações sobre pontuações de confiança, consulte limiares de confiança.
| Extrator personalizado | Canal de lançamento | Ajustes detalhados | Pontuação de confiança |
|---|---|---|---|
pretrained-foundation-model-v1.5-2025-05-05 |
Estável | EUA, UE | Sim |
pretrained-foundation-model-v1.5-pro-2025-06-20 |
Estável | Não | Sim |
| Classificador personalizado | Canal de lançamento | Ajustes detalhados | Pontuação de confiança |
|---|---|---|---|
pretrained-classifier-v1.5-2025-08-05 |
Estável | EUA, UE (pré-lançamento) | Sim |
| Divisor personalizado | Canal de lançamento | Ajustes detalhados | Pontuação de confiança |
|---|---|---|---|
pretrained-splitter-v1.5-2025-07-14 |
Estável | Não | Sim |
Fazer upgrade de uma versão de processador ajustada
É possível fazer upgrade das versões refinadas do processador extrator personalizado para uma versão de base mais recente. As configurações da versão de base mais recente serão baseadas na mais antiga. Ele vai usar os dados de treinamento do processador que estão nas versões originais.
No console do Google Google Cloud , acesse a guia Implantar e usar do seu processador e marque uma caixa de seleção para fazer upgrade de uma versão compatível. Essa será a base da configuração da nova versão do processador.
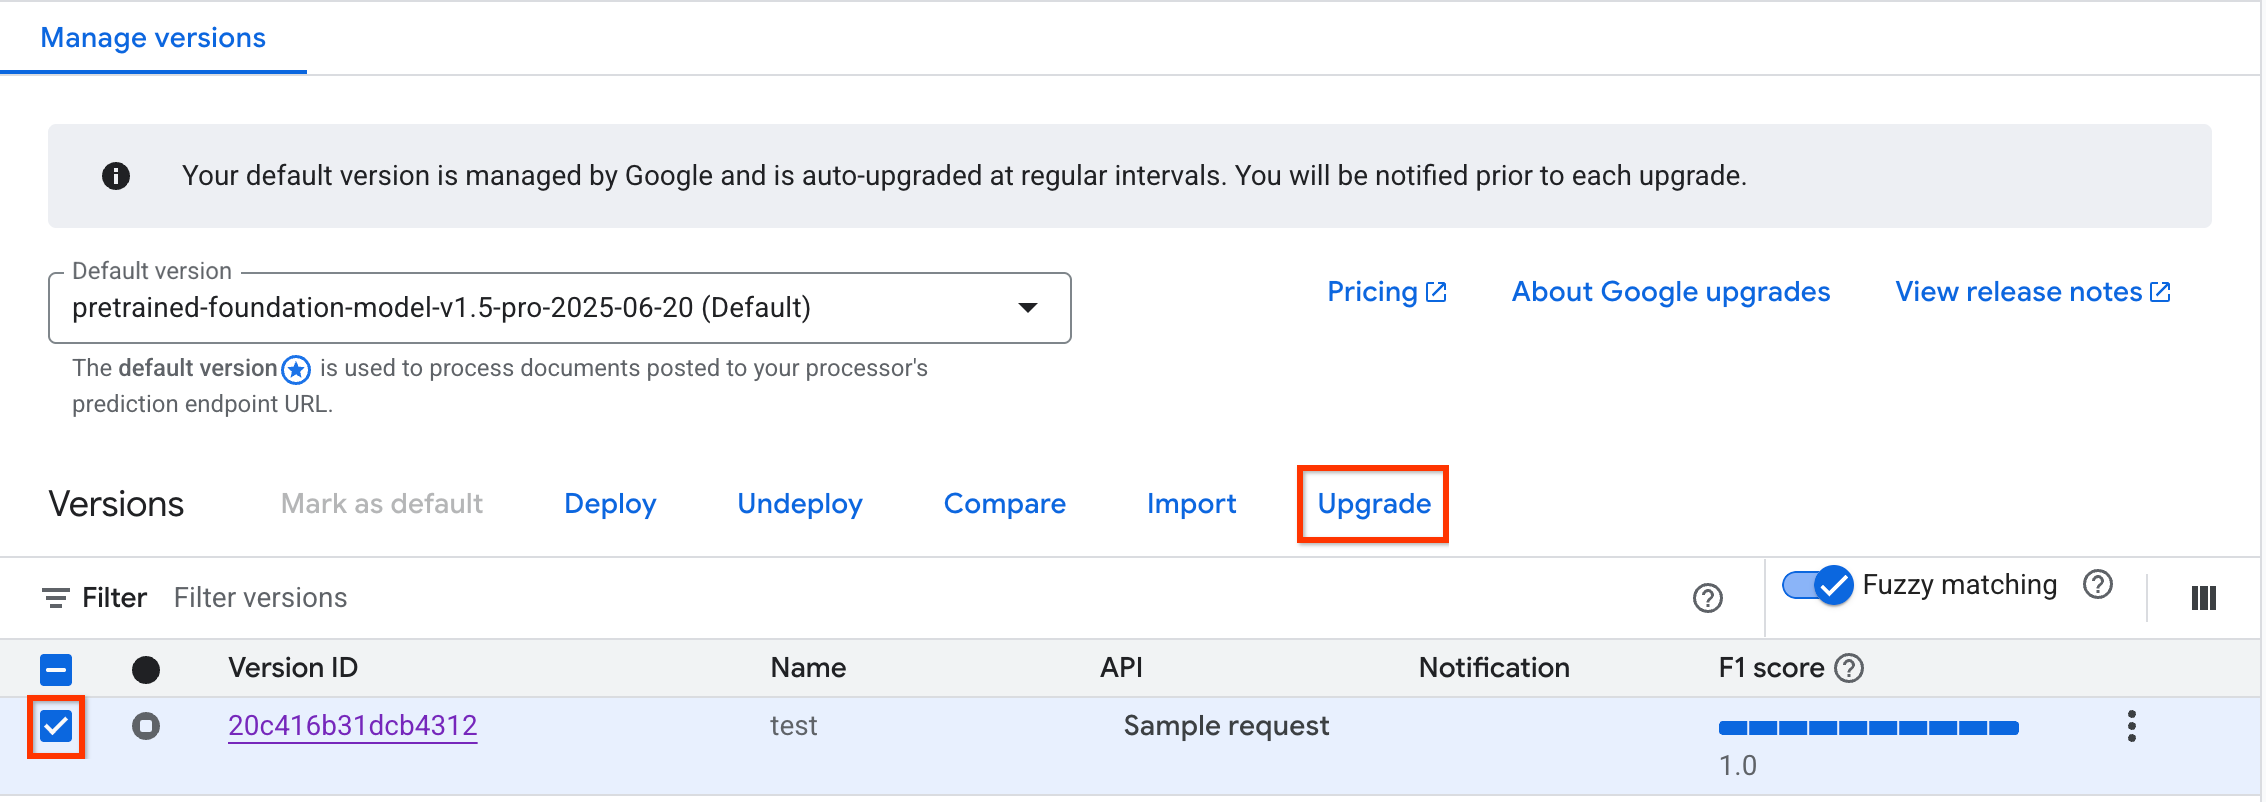
Selecione o Upgrade ativado. Insira o nome e a versão de base da nova versão do processador.
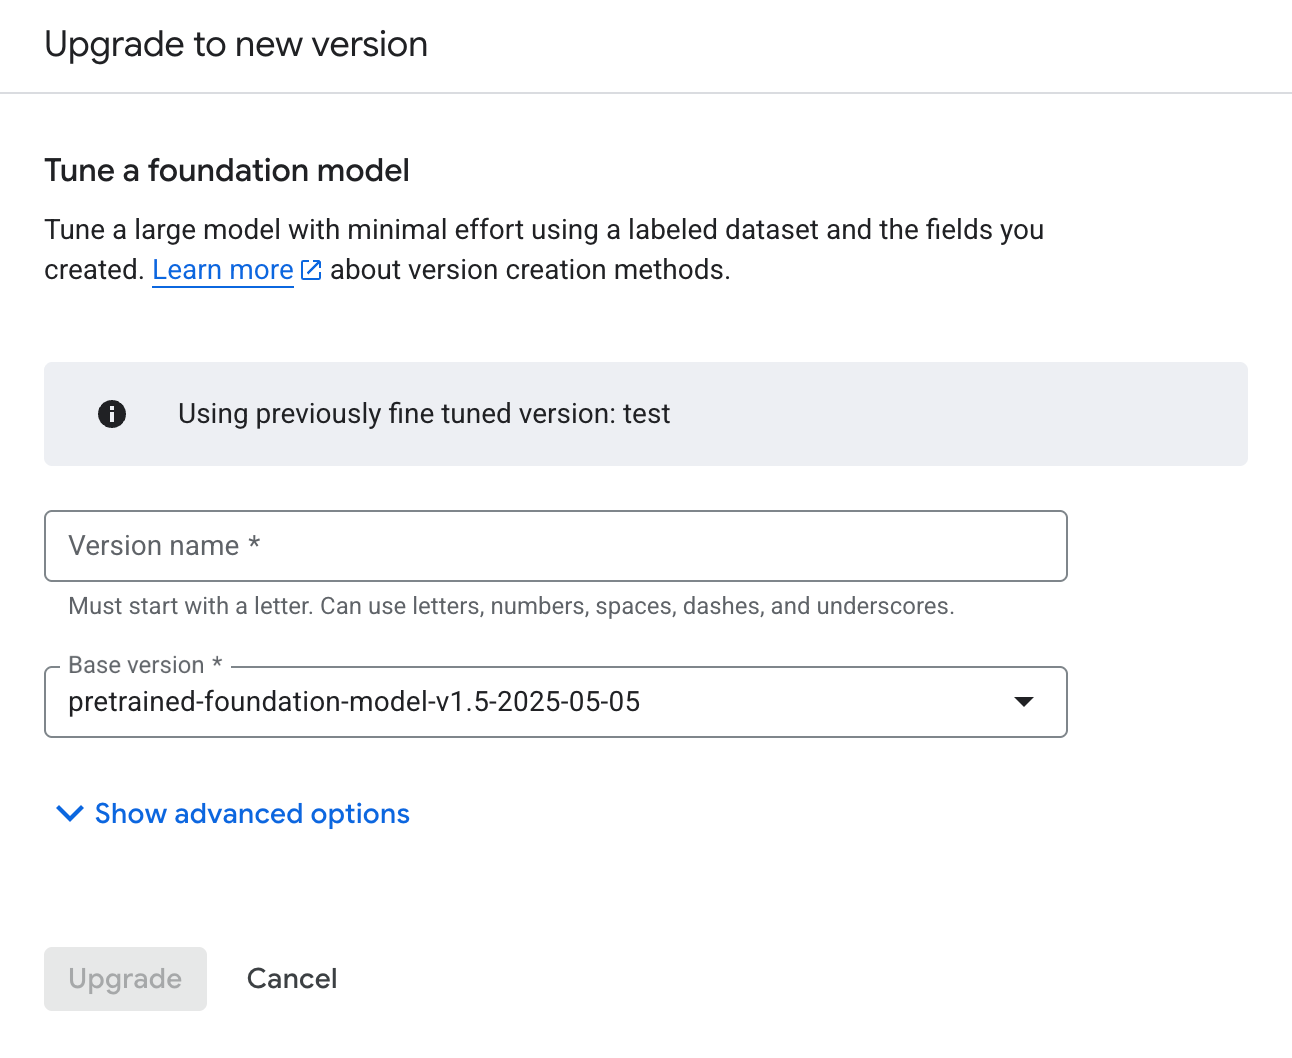
Clique em Fazer upgrade e aguarde o treinamento da nova versão do processador.
Usar a API para fazer upgrade
Também é possível usar chamadas de API para fazer upgrade de versões de processador de extrator personalizado ajustadas para uma versão de base mais recente.
curl
Este exemplo mostra como migrar um processor ajustado usando o campo FoundationModelTuningOptions
no TrainingMethod.
Antes de usar os dados da solicitação, faça as substituições a seguir com as informações na guia Visão geral do consoleGoogle Cloud da Document AI para seu processador.
- LOCATION: o local do processador.
- PROJECT_ID: o ID do projeto.
- PROCESSOR_ID: o ID do seu processador.
- DISPLAY_NAME: o novo nome de exibição do seu processador.
- BASE_PROCESSOR_VERSION: O nome da versão do processador do modelo atual
PROCESSOR_VERSION: o ID do processador atual que será atualizado
curl -X POST -v -H "Authorization: Bearer $(gcloud auth print-access-token)" \
  -H "Content-Type: application/json" \
  "https://LOCATION-documentai.googleapis.com/PROJECT_ID/locations/LOCATION/processors/PROCESSOR_ID/processorVersions:train" \
  -d '{
  "processor_version": {
    "display_name": "DISPLAY_NAME"
  },
  "base_processor_version": "projects/PROJECT_ID/locations/LOCATION/processors/PROCESSOR_ID/processorVersions/BASE_PROCESSOR_VERSION",
  "foundation_model_tuning_options": {
  "train_steps": 10,
  "learning_rate_multiplier": 1,
  "previous_fine_tuned_processor_version_name": "projects/PROJECT_ID/locations/LOCATION/processors/PROCESSOR_ID/processorVersions/PROCESSOR_VERSION",
  }
}'
Criptografia de dados de treinamento
Os dados de treinamento da Document AI são salvos no Cloud Storage e podem ser criptografados com chaves de criptografia gerenciadas pelo cliente, se necessário.
Exclusão de dados de treinamento
Depois que um job de treinamento do Document AI é concluído, todos os dados de treinamento salvos no Cloud Storage expiram após um período de armazenamento de dois dias. As atividades de exclusão de dados subsequentes respeitam o processo descrito em Exclusão de dados no Google Cloud.
Preços
Não há custo para treinamento ou reciclagem. Você paga pela hospedagem e pela previsão. Para mais informações, consulte Preços da Document AI.