


本參考架構提供概念架構,說明如何在 Google Distributed Cloud (GDC) 實體隔離方案上部署及操作客戶自行管理的 PostgreSQL 資料庫。這項解決方案可讓組織在虛擬機器上部署高可用性 (HA) 多可用區叢集,藉此維護重要的資料庫工作負載。
這個架構著重於彈性的 3 節點設定,即使單一可用區或基礎架構發生故障,也能確保資料庫可用性。涵蓋整個生命週期,從自動佈建和網路,到高可用性、備份、還原和觀測能力等正式環境等級的作業。
特點與功能
這項解決方案提供多個資料庫管理的核心功能元件:
- 自動化高可用性:使用 Patroni 和 etcd 自動選取領導者和容錯移轉,確保資料庫不需手動介入即可持續運作。
- 多可用區韌性:將資料庫節點分散至三個不同的可用區,防範局部硬體或基礎架構中斷。
- 標準化自動化:使用 Autobase 搭配以 Ansible 為基礎的教戰手冊佈建整個堆疊,確保部署作業可重複且一致。
- 連線集區:整合 PgBouncer 服務,可管理大量連線,並穩定資料庫節點的資源消耗量。
- 全域負載平衡:使用平台管理的全域 L4 負載平衡器,提供單一穩定的虛擬 IP (VIP),可跨所有可用區存取。
- 實體隔離準備:專門的工作流程,可封裝所有必要的作業系統依附元件和二進位檔,以便在未連線的環境中部署。
- 資料保護:運用
pg_dump和pg_basebackup等標準工具,以及 GDC 儲存空間快照,維持穩健的備份和復原策略。
架構
這個架構包含三個 VM 環境,分布在三個可用區,執行共置的服務堆疊。
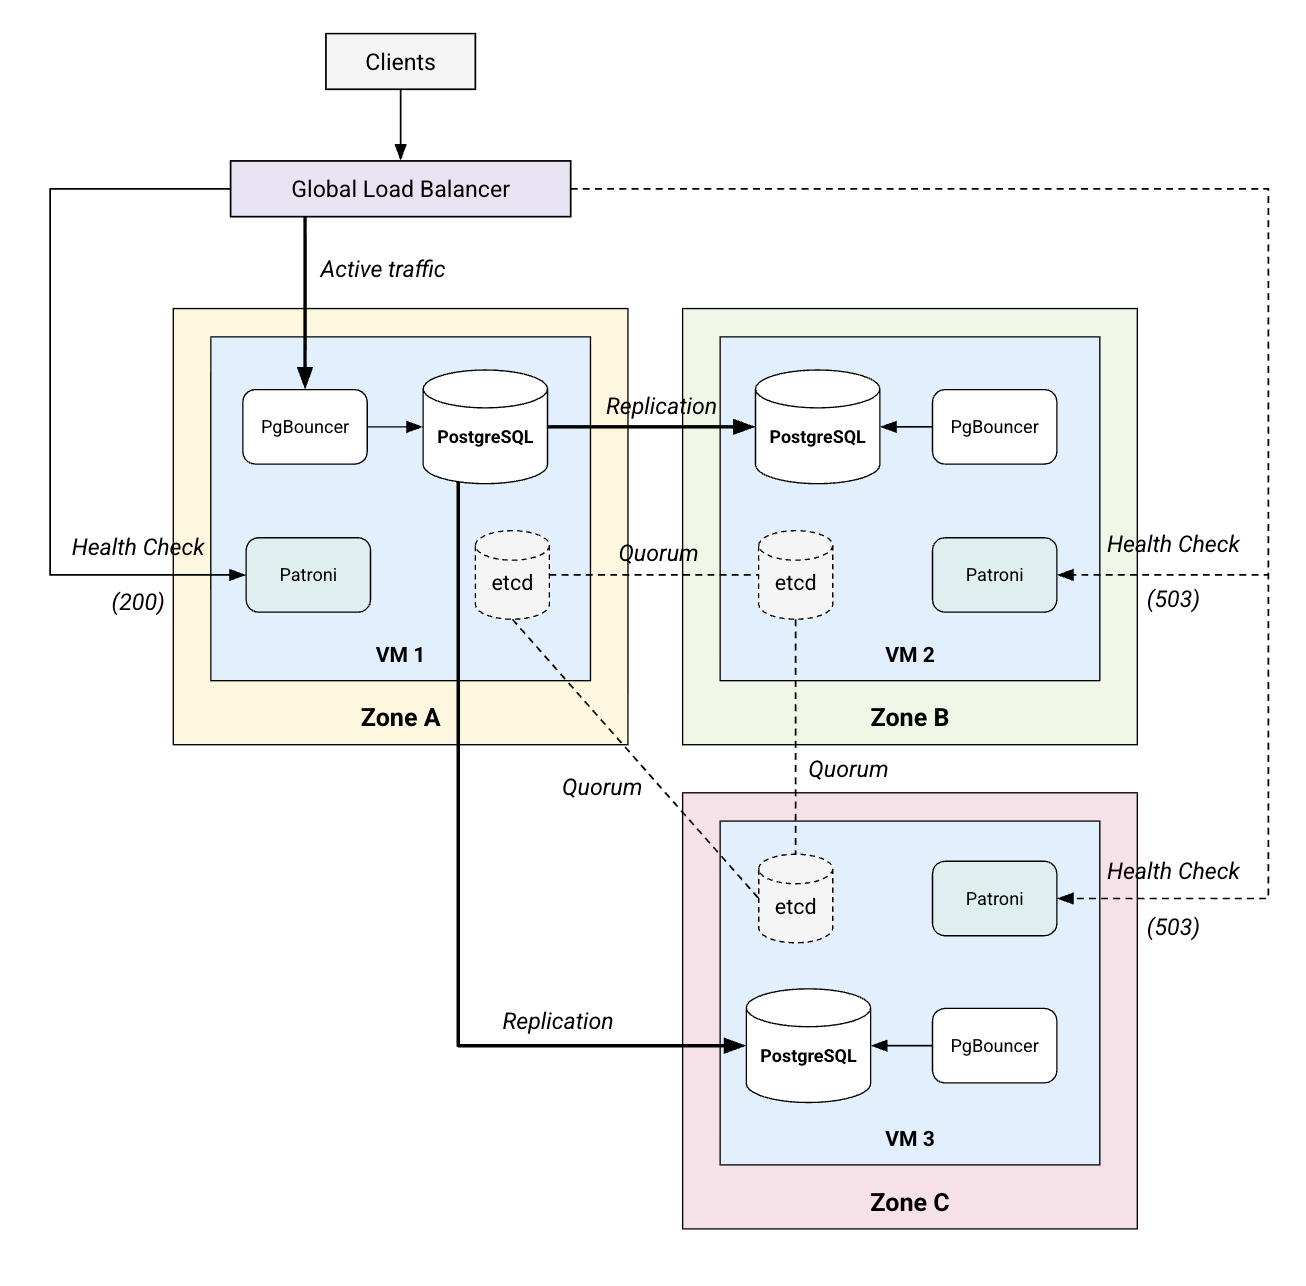
架構原則
- 多數決共識:採用多數決模型,必須有多數節點 (3 個節點中有 2 個) 同意叢集狀態,才能避免「腦裂」情況,並確保資料完整性。
- 關注點分離:每個 VM 都會執行共置但不同的服務堆疊 (資料庫、HA 管理工具、共識和集區),提供獨立且彈性的節點。
- 資料庫感知容錯移轉:優先處理 Patroni REST API 的資料庫健康狀態指標,透過平台負載平衡器協調流量重新導向。
- 基礎架構即程式碼:所有設定工作都仰賴自動化應對手冊,降低部署和擴充時的人為錯誤風險。
概念和技術
本節將詳細說明功能元件、其職責,以及元件在系統中的通訊方式。
基礎架構和平台
- 虛擬機器 (VM):分散在各可用區的專屬運算執行個體,用於託管資料庫堆疊。
- 全域 L4 負載平衡器:由平台代管的服務,提供穩定的虛擬 IP (VIP),可將流量轉送至目前的叢集領導者。
- 永久儲存空間:必須使用高效能 SSD 支援的儲存空間,才能滿足共識層預寫記錄檔的嚴格延遲時間要求。
服務和邏輯
- PostgreSQL 17:核心關聯式資料庫引擎,負責資料持續性和查詢執行。
- Patroni:高可用性管理工具,可監控本機 PostgreSQL 程序,並使用 etcd 協調領導者選舉。
- etcd:分散式設定儲存庫,提供共識層並保留叢集的權威狀態。
- PgBouncer:輕量級連線集區,位於 PostgreSQL 前端,可有效處理傳入的應用程式連線。
資料流程和介面
- PgBouncer (通訊埠 6432):應用程式資料庫流量的主要進入點。
- Patroni API (通訊埠 8008):HTTPS REST 介面,負載平衡器會使用這個介面執行健康狀態檢查,並透過
/primary端點識別目前的領導者。 - etcd (通訊埠 2379):共識叢集的通訊管道,用於維護狀態及執行選舉。
注意事項
- 擴充性和效能:
- 資料庫節點的大小應根據工作負載調整,至少要有 2 個 vCPU 和 8 GiB RAM。正式環境工作負載通常從 8 個 vCPU 和 32 GiB 開始。
- 效能取決於低延遲儲存空間;必須使用 SSD,確保 etcd 可以在 10 毫秒內處理資料同步作業。
- 同步複製:同步複製的負擔直接取決於可用區間網路延遲時間。為確保零資料遺失設定的最佳效能,可用區之間的延遲時間必須較低。
- 資源管理和授權:
- 可用性和穩定性:
- 高可用性是透過 3 節點仲裁機制達成。任何單一節點或可用區故障,都不會中斷服務。
- 叢集穩定性:如要維持可靠的仲裁,節點之間的網路延遲時間必須很短。平均封包往返時間 (RTT) 最好低於 10 毫秒,以免選舉逾時和叢集不穩定。
- 營運管理:
- 子版本修補和主要升級等例行工作,仍由客戶的營運團隊負責。
- VM 的
stdout輸出內容會自動擷取至 Google Distributed Cloud 實體隔離方案監控平台。我們日後會發布指南,說明如何為個別元件整合更詳細的監控功能。 - 請務必使用資料庫原生工具和平台快照,實施完善的備份策略。這些程序的詳細指南會另行發布。
設計決策
這項解決方案的架構選擇為多可用區部署作業提供彈性的路徑。
Kubernetes 上的虛擬機器
我們選擇採用以 VM 為基礎的方法,提供多可用區高可用性。GDC 不支援跨多個實體可用區的 Kubernetes 叢集。因此,您必須將專用 VM 部署至不同的可用區,才能建構穩健的跨可用區架構。即使單一基礎架構可用區完全故障,這項設定仍可正常運作。
平台原生全域負載平衡
這個架構採用 GDC 全域 L4 負載平衡器,而非 VM 上的軟體式 Proxy。這種做法有幾項優點:
- 全球觸及:提供穩定的虛擬 IP,可在所有可用區存取。
- 平台管理:VIP 由平台的控制層獨立管理。
- 簡化容錯移轉:容錯移轉是透過標準健康狀態檢查探測管理,而非複雜的本機軟體設定。
- 高可用性:不需依賴本機 Proxy,確保資料庫流量的進入點保持彈性。
假設和限制
假設
- 環境具有本機登錄檔或機制,可匯入封裝的 OS 依附元件和二進位檔。
- 所有目標 VM 都能透過金鑰型 SSH 存取,以便執行 Ansible 自動化作業。
- 專案有足夠的配額,可佈建多可用區 VM 和負載平衡器。
限制
- 手動維護:作業系統修補和 PostgreSQL 版本升級為手動工作,不會由解決方案自動執行。
- 儲存空間敏感度:共識層 (etcd) 對磁碟延遲非常敏感。如果儲存空間爭用情況持續偏高,可能會影響共識層的穩定性。
- 網路穩定性:高可用性管理工具仰賴可用區之間穩定、低延遲的網路連線。延遲或網路抖動可能會影響叢集協調和角色轉換的時間。
其他資料
- 參考自動化程式碼存放區:GitHub 上的 Autobase 原始碼
- PostgreSQL 資料庫參考實作