


本參考架構提供概念架構,說明如何在 Google Distributed Cloud (GDC) 實體隔離方案,部署及操作高可用性的客戶自行管理 MariaDB 12 資料庫。企業和搶先體驗客戶可透過強大的多可用區虛擬機器 (VM) 設定,可靠地維護重要資料庫工作負載。
由於 GDC 實體隔離方案目前不支援跨可用區 Kubernetes 延伸叢集,因此這個架構嚴格仰賴部署於三個可用性網域的專用 VM,確保營運不中斷,並在整個可用區故障時不會發生資料遺失。
特點與功能
- 多可用區韌性:在三個不同的可用區部署高韌性的 3 節點設定,防範單一基礎架構可用區故障。
- 自動化高可用性和共識:使用 Galera 進行同步多主叢集,提供自動故障偵測、節點共識和全域資料同步,不會發生腦裂情況。
- 智慧型流量轉送:共置的 HAProxy 執行個體會管理連線集區,並嚴格轉送流量,將寫入作業 (例如通訊埠 3306) 導向至運作中的主要節點,並在同步副本之間負載平衡讀取作業 (例如通訊埠 3307)。
- 全域負載平衡:與平台原生的 GDC 全域 L4 負載平衡器整合,為用戶端應用程式提供單一穩定的虛擬 IP (VIP),並抽象化基礎節點拓撲。
- 資料庫感知容錯移轉驗證:使用輕量級自訂 Python 指令碼或 clustercheck 等 OSS 解決方案 (例如在通訊埠 9200 公開),向負載平衡器和 HAProxy 提供健康狀態檢查,確保流量只會轉送至健康狀態良好且完全同步的節點。
架構原則
- 同步多數決共識:優先考量嚴格的資料一致性,而非最終一致性。Galera 採用以仲裁為基礎的模型,需要多數同意,因此可消除網路分區期間資料遺失或腦裂的風險。
- 關注點分離:將資料庫複製層 (Galera) 與連線轉送和容錯移轉偵測層 (HAProxy 和 Python 健康狀態檢查服務) 分離。
- 基礎架構最佳化:專為實體隔離環境設計,利用強大的 VM 繞過目前的 Kubernetes 網路限制。
架構
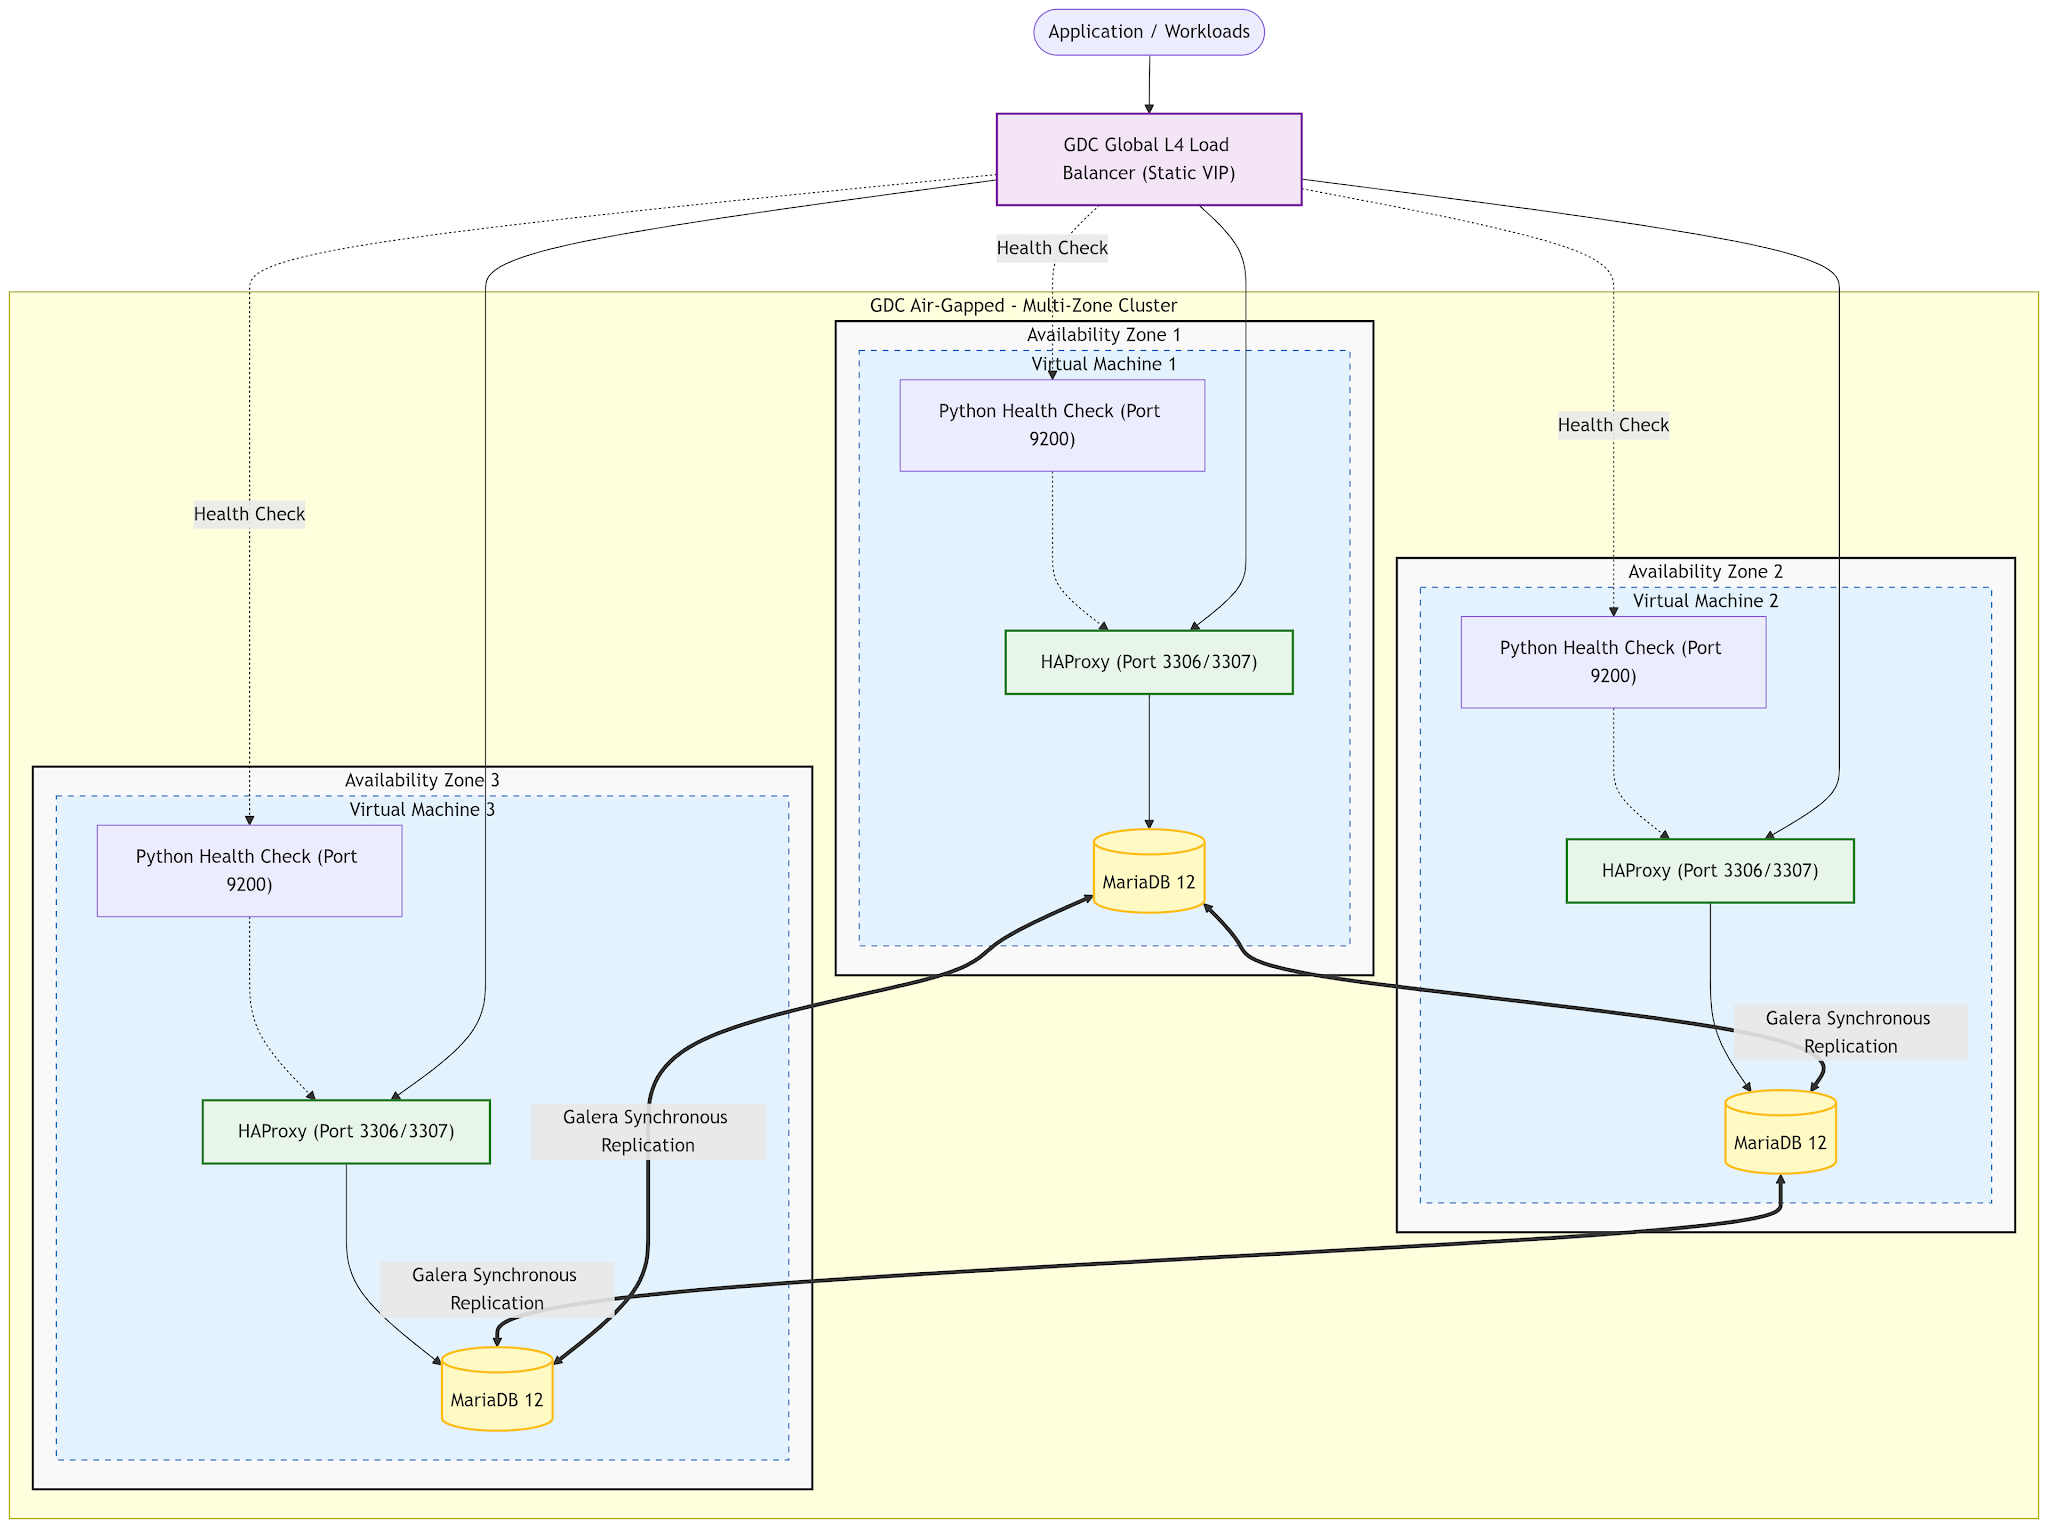
概念和技術
本節將詳細說明多可用區架構中的功能元件及其特定職責。
基礎架構和平台
- 虛擬機器 (VM):三個專屬運算執行個體,分別部署至不同的可用區,形成故障域邊界。
- GDC 全域 L4 負載平衡器:由平台管理的網路建構,可公開穩定的內部 VIP,自動評估 Python 驅動的 HTTP 健康狀態檢查,重新導向傳入流量。
服務和邏輯
- MariaDB 12:核心關聯式資料庫引擎。
- Galera 外掛程式:負責同步多主節點複製和驗證節點仲裁的叢集架構。
- HAProxy:在每個 VM 上做為流量路由器。寫入作業採用主動/備份拓撲,可避免死結;分散式讀取作業則採用循環配置。
- Python 健康狀態檢查服務:輕量級 HTTP 服務 (包裝在 systemd 中),會持續輪詢本機資料庫狀態,並透過通訊埠 9200 將健康狀態回報給 HAProxy 和 L4 負載平衡器。
資料流程和介面
- 應用程式會將資料庫要求傳送至全域 L4 負載平衡器 VIP。
- 負載平衡器會將連線代理至其中一個 VM 上健康狀態良好的 HAProxy 執行個體。
- HAProxy 會根據要求的通訊埠,動態轉送流量:通訊埠 3306 嚴格指定寫入作業的有效節點,而通訊埠 3307 則會在叢集中循環讀取。
設計須知
一般注意事項
- 效能與一致性之間的取捨:Galera 原生同步,因此每筆交易都必須由叢集對等節點確認。效能與 GDC 環境中的可用區間網路延遲時間直接相關。
- 資源管理:直接在資料庫 VM 上部署 HAProxy 可最佳化硬體使用率,但必須仔細調整資源,以免連線集區負擔過重,導致核心 MariaDB 程序資源不足。
健康狀態檢查注意事項
雖然這項解決方案使用自訂 Python 指令碼,因為其簡單且不含外部依附元件,但客戶可以選擇使用 xinetd 和 clustercheck 實作標準 OSS 健康狀態檢查。
- 自訂 Python 指令碼:運用預先安裝的 Python 3 和
http.server模組,適合實體隔離環境,因為不需要額外傳輸套件。不過,客戶必須維護自訂指令碼程式碼。 - OSS 工具 (
xinetd/clustercheck):將維護工作轉移給開放原始碼社群,但在初始實體隔離軟體準備期間,會增加架構複雜度和依附元件管理。
效能注意事項
規劃部署作業時,請考量下列具體因素,盡可能提高效能和可靠性:
- 硬體規模:雖然需求因工作負載而異,但請使用這些標準設定檔做為每個 VM 的起點:
- 開發/概念驗證:2 個 vCPU、8 GB RAM (穩定運作的最低需求)。
- 小型正式環境:4 個 vCPU、16 GB RAM。適合並行程度適中的內部工具。
- 標準正式環境:8 個 vCPU,32 GB RAM。建議用於重要業務應用程式的基準。
- 高處理量:16 個以上 vCPU、64 GB 以上 RAM。如果工作負載的工作集較大,且能透過 InnoDB 緩衝集區中的大量資料快取受益,則必須使用這項功能。
- 儲存空間效能:高效能儲存空間對於資料庫耐用性和叢集穩定性至關重要。強烈建議使用 SSD 磁碟,盡可能縮短同步複製「提交」階段的寫入延遲時間。為達到最佳效能,請將 p99 磁碟寫入延遲時間控制在 10 毫秒內,確保 Galera
gcache或 MySQL 二進位記錄不會成為瓶頸。 - 網路延遲和流量控制:VM 之間的延遲時間會直接影響交易提交速度。
- 同步複製:在 Galera 或群組複製叢集中,每個寫入交易都必須獲得多數節點確認。GDC 實體隔離方案的可用區間延遲時間通常小於 1 毫秒,非常適合將寫入負擔降到最低 (通常為 10% 到 30%)。
- 流量控制:網路抖動過高或單一「慢速」節點可能會觸發 Galera 流量控制,暫停整個叢集的寫入作業,讓落後的節點趕上。
- HAProxy (或 MySQL Router) 的角色:負載平衡器仍不可或缺:
- 流量拆分:HAProxy 會確保寫入流量嚴格導向單一運作中的節點 (通訊埠 3306),防止死結,同時在所有同步副本 (通訊埠 3307) 之間平衡唯讀查詢。
- 連線穩定性:提供抽象層,讓應用程式不必手動處理複雜的容錯移轉邏輯。
- Sidecar 元件:自訂 Python 健康狀態檢查服務和負載平衡器雖然輕量,但至關重要。確保 VM 的 CPU 可用性一致;在高負載情況下,Hypervisor 層級的 CPU「竊取」可能會延遲健康狀態檢查回應,導致全域負載平衡器過早將健康節點從輪替中剔除。
設計決策
這份 SRA 的架構選擇明確解決了 GDC 實體隔離方案的限制,並針對高處理量進行最佳化。
- Kubernetes 上的虛擬機器:GDC 實體隔離方案目前不支援跨多個實體可用區的 Kubernetes 叢集。之所以嚴格選擇以 VM 為基礎的方法,是因為在不同可用區部署專用 VM,是實現真正的多可用區高可用性,並在整個可用區故障時存活的唯一可行方法。
- Galera 與主要/次要手動設定 (搭配 ProxySQL):傳統的主要/次要架構搭配 ProxySQL,經評估後是可行的替代方案。不過,搭配 ProxySQL 處理手動容錯移轉邏輯,需要編寫大量指令碼,且作業相當複雜。Galera 則因其原生同步特性而獲選,可大幅降低容錯移轉的複雜度,並提供更佳的效能。
- 拒絕使用 Orchestrator:Orchestrator 是業界公認的自動容錯移轉拓撲管理工具。不過,經過評估後,我們最終拒絕了這項要求,因為該外掛程式僅支援 MariaDB 10,與 MariaDB 11 以上版本不相容。因此不符合我們對 MariaDB 12 的目標要求。
- 平台原生全域負載平衡:運用原生 GDC 全域 L4 負載平衡器,確保 VIP 由 GDC 控制層控管,保持進入點彈性,並簡化跨可用區流量傳遞。
假設和限制
假設
- 基礎架構可用性:客戶有足夠的專案配額,可佈建大小適當的專用 VM,以及平均分布於 3 個可用區的全域負載平衡器。
- 安全網路:建立金鑰存取權和適當的 ProjectNetworkPolicies (PNP),允許叢集內 Galera 同步和健康狀態檢查輪詢。
限制
- 不支援 Kubernetes:如果客戶只尋求容器化/Kubernetes 解決方案,則必須等到平台完全支援延展叢集,才能實現多可用區高可用性。
- 需要手動升級:與代管服務不同,這項解決方案會將例行 OS 層級修補、資料庫子版本升級和 Galera 版本管理的責任完全交給客戶。
- 網路延遲敏感度:同步複製需要高品質且穩定的網路。實體隔離可用區之間的網路抖動或延遲時間高峰,會按比例延遲 MariaDB 叢集的寫入作業。
其他資料
- 解決方案參考實作 - 在 GDC 實體隔離方案中部署高可用性的多可用區 MariaDB 12 資料庫