


問題描述
在實體隔離環境中執行大型語言模型 (LLM) 的組織,會快速累積模型端點:在 Google Distributed Cloud (GDC) 實體隔離環境中提供的每個開放權重模型 (請參閱 GDC 實體隔離環境中的開放權重模型指南),都會公開自己的 Kubernetes Service、位址、憑證和作業生命週期。應用程式和代理開發人員最終會陷入架構孤島,為每個模型硬式編碼一個端點,並在每次模型疊代時重新編寫整合。這種分散情況會產生技術債,並拖慢重要多步驟代理工作負載的部署速度。
標準網路層也「無法辨識 AI」:傳統負載平衡器會將推論流量視為一般 HTTP,無法讀取要求的 model 欄位、優先處理對延遲敏感的工作負載、以權杖而非要求為考量,或將要求導向已保留相關 KV 快取的模型伺服器副本。在成本高昂的實體隔離 GPU 叢集中,這會導致硬體使用率偏低,投資報酬率不佳。雖然 Gemini on GDC 提供代管的前沿模型,但如果客戶將這些模型與自行託管的開放權重模型結合,就需要一個推論層,在不影響資料主權的情況下,提供類似雲端的靈活性:任何要求、提示或模型權重都不得離開 GDC 邊界。
解決方案提案
本文件概述 GDC 實體隔離方案中,自行管理 AI 閘道的參考架構:這個安全、集中的推論層可為應用程式提供一個與 OpenAI 相容的端點,適用於所有模型,並將每項要求轉送至正確的後端。參考實作是以 Kubernetes Gateway API 為基礎建構:Envoy Gateway 是 Gateway API 實作 (控制層和 Envoy Proxy 資料層),而 Envoy Agent Router (舊稱 Envoy AI Gateway) 則透過 AI 專屬要求處理功能擴充:從要求主體擷取模型、要求和回應翻譯、上游驗證、權杖計費,以及選用的權杖型頻率限制。Gateway API Inference Extension 新增了模型伺服器感知端點選取功能 (InferencePool 和端點挑選器),可有效運用 GPU 運算能力。所有構件都會在 GDC 組織的 Harbor 登錄檔中暫存,且整個堆疊會在標準叢集中執行,不需任何外部連線。
包含內容:這個架構涵蓋在標準叢集中部署 Envoy Gateway 和 Envoy Agent Router、公開統一 OpenAI 相容端點的 Gateway API 資源 (GatewayClass、Gateway) 和 Envoy Agent Router 資源 (AIGatewayRoute、AIServiceBackend、BackendSecurityPolicy、GatewayConfig)、model 欄位中以主體為依據的轉送、用於模型感知負載平衡的 Gateway API Inference Extension (InferencePool、InferenceObjective、端點挑選器)、選用的 Redis 權杖型頻率限制、閘道 TLS 終止、網路政策 (NetworkPolicy/ProjectNetworkPolicy),以及 Harbor 中的實體隔離構件管理。閘道後方的模型提供後端 (Ollama、vLLM) 是透過隨附指南「在 GDC 實體隔離方案中設定開放權重模型」部署。
不包含的項目:這個架構不涵蓋代管 AI 閘道產品、模型本身的部署和調整 (隨附指南組合)、模型微調、非 LLM 生成式 AI 模態、代理到工具流量 (MCPRoute) 或商業支援的閘道發行版本。Gemini on GDC 是代管產品功能,其佈建作業不在範圍內,且這版指南集會使用自行託管的開放權重模型驗證閘道。
目標對象:本文件主要適用於負責在標準叢集中部署及操作閘道的平台管理員,以及在實體隔離環境中設計 AI 平台的技術架構師。使用統一端點的應用程式開發人員是次要目標對象,他們可以瞭解要求的轉送方式,進而受益。
架構
這項解決方案完全在 GDC 實體隔離方案組織的標準叢集中執行。在服務層中,Kubernetes Gateway API 會將設定模型標準化;AI 閘道控制層 (Envoy Gateway 控制器和 Envoy Agent Router 控制器) 會讀取 Gateway API 和 Envoy Agent Router 資源,並設定資料層:Envoy Proxy Deployment 是要求進入點 (透過 LoadBalancer 類型的 Service 公開),而 Envoy Agent Router 外部處理器則在 Proxy Pod 中以 Sidecar 形式執行,並執行 AI 專屬邏輯。在應用程式層中,客戶工作負載 (應用程式和代理) 會將 AI 要求傳送至 Proxy (1),Proxy 會將要求交給外部處理器,後者會擷取模型名稱、翻譯要求並記錄權杖用量 (2),Proxy 會將平衡的流量轉送至所選模型的推論 Pod (3),模型則會在基礎架構層的 GPU 節點上執行 (4)。提供模型後端會附加至閘道,可以是 AIServiceBackend (任何與 OpenAI 相容的 Service),也可以是 InferencePool,其端點挑選器會為每個要求選取最佳副本。容器映像檔和 Helm 圖表是從 Harbor 提取。
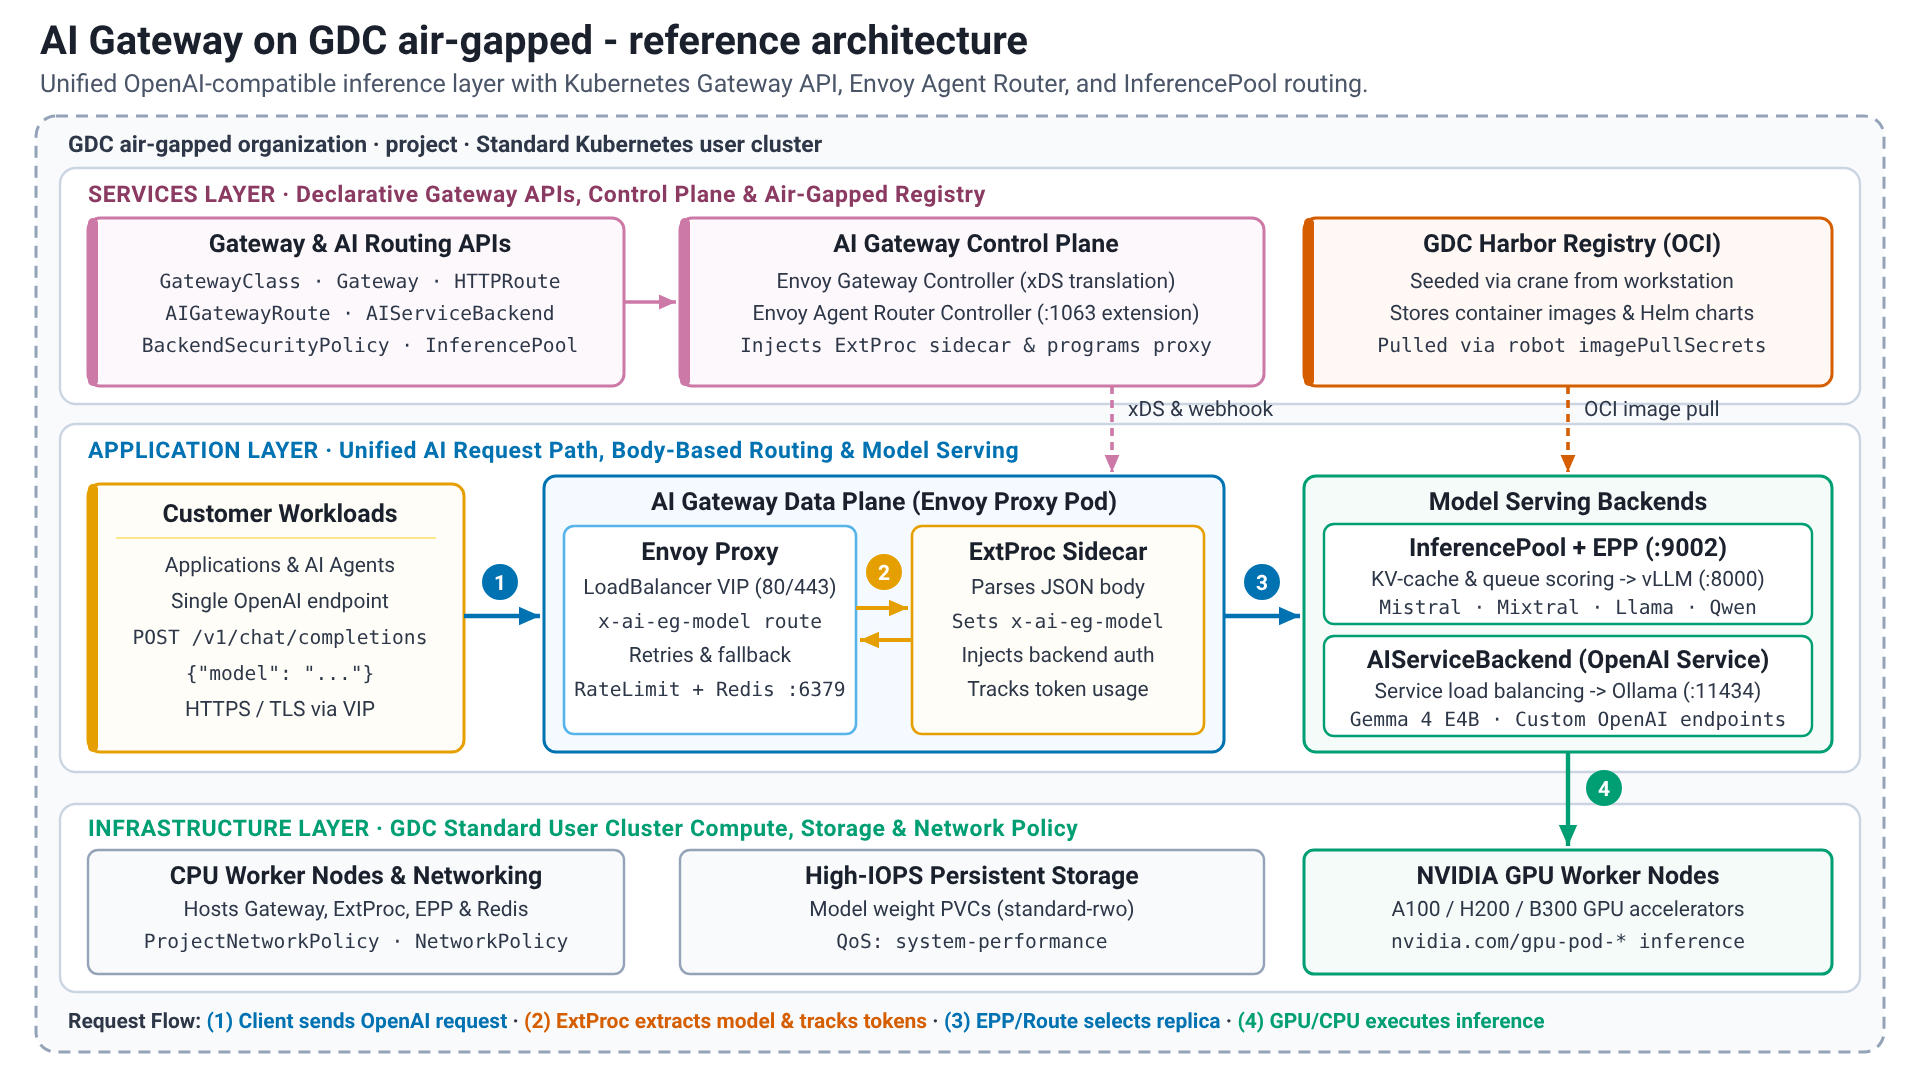
解決方案元件
這項解決方案使用下列元件:
| 解決方案元件 | 責任 | 資料流程 | 介面 |
|---|---|---|---|
| Kubernetes Gateway API | Ingress 和轉送的標準角色導向資源模型:GatewayClass (由平台擁有)、Gateway (監聽器、TLS) 和路由資源 (由應用程式團隊擁有)。Ingress API 的後續版本,不含供應商專屬註解。 |
僅限宣告式設定;資源由控制器監控,不含要求流量。 | Kubernetes API (gateway.networking.k8s.io/v1);CRD 是從 Envoy Gateway CRD 圖表安裝。 |
| Envoy Gateway 控制器 (控制層) | 實作 Gateway API:為每個 Gateway 佈建一個 Envoy Proxy Deployment 和 LoadBalancer Service、將路徑和政策 (BackendTrafficPolicy、SecurityPolicy、EnvoyExtensionPolicy、Backend、EnvoyProxy) 轉譯為 xDS 設定、在設定後執行全域頻率限制服務,以及透過擴充功能管理工具呼叫 Envoy Agent Router 擴充功能伺服器,以便將 InferencePool 後端新增至轉譯。 |
監控 Kubernetes API 並將 xDS 設定推送至 Proxy;無要求流量。 | Kubernetes API (監控)、xDS gRPC (傳送至 Proxy)、gRPC (傳送至擴充功能伺服器,通訊埠 1063)。 |
| Envoy Agent Router 控制器 (控制層) | 將 aigateway.envoyproxy.io/v1beta1 資源、AIGatewayRoute (擷取模型名稱的路由規則)、AIServiceBackend (具有 API 架構的後端)、BackendSecurityPolicy (上游憑證) 和 GatewayConfig (每個 Gateway 的外部處理器設定) 協調為 Envoy Gateway 資源,將外部處理器 sidecar 插入 Envoy Proxy Pod,並提供 Envoy Gateway 使用的擴充功能伺服器。 |
僅限設定。 | Kubernetes API、gRPC 擴充功能伺服器 (通訊埠 1063)、用於加入邊車容器的變更許可 Webhook。 |
| Envoy Proxy (資料層) | 要求進入點:終止 TLS、比對監聽器和路徑、在後端端點之間平衡負載、強制執行頻率限制和逾時、重試並改用替代後端,以及發出存取記錄和指標。 | 在 LoadBalancer VIP (80/443) 接收用戶端要求、針對每項 AI 要求諮詢外部處理器、將要求轉送至所選後端端點 (Service 或端點選擇器選取的 Pod),並將回應串流傳回用戶端。 |
HTTP/HTTPS 傳送至用戶端 (OpenAI 相容 API)、ext_proc gRPC 傳送至 Sidecar 和端點選擇器、HTTP 傳送至後端、gRPC 傳送至頻率限制服務。 |
| Envoy Agent Router 外部處理器 (ExtProc) | 剖析與 OpenAI 相容的要求主體、將 model 欄位擷取至轉送標頭 x-ai-eg-model、套用模型名稱覆寫、在用戶端 API 架構和後端 API 架構之間轉譯要求和回應酬載、插入 BackendSecurityPolicy 定義的上游憑證,以及將回應中的權杖用量 (輸入、輸出、總計) 擷取至動態中繼資料,用於權杖型頻率限制和指標。 |
Envoy Proxy Pod 中的邊車容器;處理要求和回應主體,包括串流回應。 |
Envoy ext_proc gRPC;Prometheus 指標端點。 |
| Gateway API 推論擴充功能 (InferencePool + 端點挑選器) | InferencePool (inference.networking.k8s.io/v1) 會將一個模型伺服器部署作業的 Pod 分組 (標籤選取器、目標通訊埠,例如 8000),並參照其端點挑選器 (EPP)。InferenceObjective (v1alpha2) 會為每個模型或目標指派優先順序。EPP 會擷取模型伺服器指標 (要求佇列深度、KV 快取使用率、載入的 LoRA 轉接器),並為每個要求選取端點。 |
Proxy 會使用要求標頭呼叫 EPP (ext_proc,通訊埠 9002);EPP 會回覆要使用的端點;Proxy 會將要求轉送至該 Pod。 |
Kubernetes API (CRD)、gRPC ext_proc (9002)、模型伺服器的 Prometheus 抓取。 |
| Redis (選用) | Envoy 頻率限制服務的備份儲存庫:所有 Proxy 副本中,以要求和權杖為基礎的限制共用計數器。只有在設定全域頻率限制時才需要。 | 每當有受限要求,頻率限制服務就會讀取並遞增通訊埠 6379 的計數器。 | Redis 通訊協定 (6379)。在叢集或現有 Redis 執行個體中部署 Redis 8.10。 |
| 模型提供後端 (Ollama/vLLM) | 在閘道後方提供開放權重模型,並按照隨附指南「在 GDC 實體隔離方案部署開放權重模型」進行部署。以 AIServiceBackend (任何與 OpenAI 相容的 Service,例如 Ollama) 或 InferencePool (模型伺服器,例如 vLLM,會公開端點挑選器評分的指標) 的形式附加。 |
接收從 Proxy 轉送的要求、在 GPU 節點上執行推論 (或在 CPU 上使用小型模型進行功能評估),並傳回與 OpenAI 相容的回覆。 | OpenAI 相容 REST API:vLLM (通訊埠 8000)、Ollama (通訊埠 11434);Prometheus 指標 (vLLM),用於端點挑選器。 |
| Harbor | 儲存解決方案的容器映像檔 (Envoy Proxy、Envoy Gateway、Envoy Agent Router 控制器和外部處理器、頻率限制服務、Endpoint Picker、Redis) 和 Helm 圖表 (OCI 構件)。 | 構件會從公開註冊資料庫複製到 Harbor,並使用 seed_registry.sh (crane) 從具備網路連線能力的工作站複製;叢集會透過映像檔提取密鑰,使用機器人帳戶提取映像檔,而資訊套件則會從 Harbor 使用 helm template 轉譯。 |
OCI Distribution API;Harbor UI 和機器人帳戶。 |
| Standard 叢集和 GPU 節點 | 託管所有閘道元件 (CPU 節點即足夠) 和推論 Pod (GPU 節點,具有從節點探索到的加速器資源)。提供 LoadBalancer VIP、模型權重的永久儲存空間,以及網路政策強制執行功能。 |
基礎平台;要求會透過 Gateway 的 LoadBalancer VIP 進入,並留在叢集網路內。 |
Kubernetes API、GDC 網路 API (networking.gdc.goog/v1 ProjectNetworkPolicy)、GDC 控制台和 gdcloud (適用於平台管理員)。 |
特點與功能
這項參考架構提供下列核心功能:
- 統一的 OpenAI 相容端點:應用程式會針對閘道後方提供的每個模型呼叫一個位址 (
/v1/chat/completions、/v1/models等)。- 元件:
Gateway、AIGatewayRoute、Envoy Proxy、外部處理器。 - 職責:公開穩定的虛擬 IP、終止 TLS、接受與 OpenAI 相容的要求格式,並在必要時轉譯為後端結構定義。
- 介面:HTTPS REST (JSON,包括用於串流的伺服器傳送事件)。
- 元件:
- 以主體為依據 (模型感知) 的路由:閘道會讀取要求主體的
model欄位,並將要求轉送至相符的後端,不需任何用戶端端點邏輯。- 元件:外部處理器、
AIGatewayRoute規則比對x-ai-eg-model、AIServiceBackend、InferencePool。 - 職責:擷取模型名稱、比對路由規則、重新命名模型 (
modelNameOverride)、依權重分配流量,以及依優先順序改用替代後端。 - 介面:Kubernetes API (
aigateway.envoyproxy.io/v1beta1)。
- 元件:外部處理器、
- 模型伺服器感知負載平衡:傳送至
InferencePool的要求會傳送至佇列最短且 KV 快取最實用的副本,而非輪流傳送。- 元件:Gateway API 推論擴充功能 (
InferencePool、InferenceObjective、端點挑選器)。 - 職責:擷取模型伺服器指標、為端點評分 (佇列深度、KV 快取使用率、前置字元快取相似度、LoRA 轉接器),並在負載下優先處理各項目標。
- 介面:Kubernetes API (
inference.networking.k8s.io/v1、inference.networking.x-k8s.io/v1alpha2)、ext_proc gRPC (9002)。
- 元件:Gateway API 推論擴充功能 (
- 上游驗證和安全性政策:需要憑證的後端會由閘道插入憑證,且絕不會發布至應用程式。
- 元件:
BackendSecurityPolicy、Envoy GatewaySecurityPolicy、TLS 監聽器。 - 職責:將 API 金鑰插入後端、在
Gateway終止用戶端 TLS,以及在必要時強制執行用戶端驗證和授權政策。 - 介面:政策參照的 Kubernetes
Secret。
- 元件:
- 以權杖為基礎的頻率限制 (選用):用量是以權杖為單位,而非僅以要求為單位。
- 元件:外部處理器 (
llmRequestCosts)、Envoy GatewayBackendTrafficPolicy(全域頻率限制)、頻率限制服務、Redis。 - 職責:從每個回覆中擷取輸入、輸出和總詞元,並附加為要求成本,在所有 Proxy 副本中強制執行每位消費者或每個模型的預算。
- 介面:Kubernetes API、Redis (6379)。
- 元件:外部處理器 (
- 流量管理:標準 Gateway API 功能適用於 AI 流量。
- 元件:
Gateway、HTTPRoute、AIGatewayRoute、BackendTrafficPolicy。 - 職責:根據主機、路徑和標頭進行比對、適合長時間生成的逾時設定、重試、加權流量拆分,以及後端之間依優先順序執行的備用機制。
- 介面:Kubernetes API。
- 元件:
- 觀測能力:每個模型都有要求、延遲時間和權杖指標。
- 元件:Envoy Proxy 存取記錄和統計資料、外部處理器指標 (權杖用量、要求時間長度、第一個權杖的時間)、端點挑選器指標。
- 責任:公開 Prometheus 格式的指標和結構化存取記錄,讓 GDC 觀測能力堆疊或客戶管理的 Prometheus 抓取。
- 介面:Prometheus 指標端點、標準輸出內容記錄。
- 實體隔離構件管理:每個映像檔和圖表都會先在 Harbor 中暫存,然後才安裝。
- 元件:Harbor、
seed_registry.sh、機器人帳戶、映像檔提取密鑰、EnvoyProxy資源 (Proxy 映像檔和提取密鑰)。 - 職責:從連線的工作站植入映像檔和 OCI Helm 圖表、固定版本、使用
helm template離線算繪圖表。 - 介面:OCI Distribution API、Kubernetes API。
- 元件:Harbor、
架構原則
- 標準優先:閘道是透過 Kubernetes Gateway API 及其推論擴充功能設定,並向應用程式提供與 OpenAI 相容的 API,因此應用程式、路徑和後端在不同閘道實作之間仍可攜。
- 安全至上:所有元件和資料都位於 GDC 實體隔離方案邊界內。TLS 會在
Gateway終止,後端憑證由閘道插入,網路存取權則受NetworkPolicy和ProjectNetworkPolicy物件限制。 - 資料主權:提示、回覆、模型權重和用量資料絕不會離開客戶的 GDC 組織,且不需外部連線即可運作。
- 關注點分離:角色導向的 Gateway API 可讓平台管理員擁有
GatewayClass、Gateway、TLS 和網路政策,而應用程式團隊則可在自己的命名空間中擁有AIGatewayRoute、AIServiceBackend和InferencePool資源。 - 分離控制和資料層:控制器只會轉譯設定;要求路徑包含 Envoy Proxy、其外部處理器 Sidecar 和端點挑選器,如果控制器重新啟動,這些元件會繼續提供流量。
- 開放且彈性:架構全面採用開放原始碼軟體 (Envoy Gateway、Envoy Agent Router、Gateway API Inference Extension、Ollama、vLLM),且相同的 Gateway API 資源可由替代實作項目提供。
- 擴充性與效能:資料層可透過新增 Proxy 副本水平擴充,並透過調整 CPU 和記憶體垂直擴充;模型伺服器感知負載平衡功能可讓 GPU 保持飽和,不會使個別副本超載。
- 簡化使用者體驗:每個模型都使用單一端點、單一 API 格式和單一憑證,縮短從模型部署到使用的路徑。
- 韌性:Kubernetes 健康狀態檢查和複製、Envoy 重試,以及後端之間依優先順序執行的備用機制,可在個別模型副本失敗時,確保端點可用。
注意事項
- 擴充性和效能:
- 閘道元件是僅限 CPU 的工作負載;
Gateway的 Envoy ProxyDeployment會透過增加副本數量 (EnvoyProxy資源) 進行水平擴充,並透過提高 CPU 和記憶體要求進行垂直擴充。外部處理器檢查主體時,會根據要求和回應的大小,耗用相應的 CPU 資源;串流回應則會逐步處理。 - 模型伺服器感知負載平衡僅適用於附加為
InferencePool的後端;附加為AIServiceBackend的後端則由 Proxy 跨Service的端點進行負載平衡。 - 閘道不會增加 GPU 容量:處理量和延遲時間受限於模型伺服器。使用隨附的指南組合 (vLLM 適用於高處理量,Ollama 適用於易用性和僅限 CPU 的評估),調整模型部署作業的大小。
- 生成內容較長時,要求和閒置逾時時間會比一般 HTTP API 長,請在路徑和政策上設定,而非在用戶端上設定。
- 閘道元件是僅限 CPU 的工作負載;
- 資源管理:
- 所有閘道元件都在 CPU 節點上執行,不需要加速器。下表列出功能性部署作業的建議大小。參考實作會設定確切的要求和限制;實際工作環境值則取決於要求率和酬載大小。
- 下方的通訊埠表格列出網路政策必須允許的所有通訊埠。
- GPU 規劃屬於模型部署作業:加速器資源名稱是從節點中探索,如隨附指南所述。
閘道元件的參考大小 (僅限 CPU)
| 元件 | 備用資源 | CPU (要求) | 記憶體 (要求) | 附註 |
|---|---|---|---|---|
| Envoy Gateway 控制器 | 1 | 1 億至 5 億 | 256Mi–1Gi | 控制層;不在要求路徑中 |
| Envoy 代理路由器控制器 | 1 | 1 億至 5 億 | 256Mi–512Mi | 控制層和擴充功能伺服器 |
Envoy Proxy Pod (Proxy + 外部處理器 sidecar) |
每Gateway 1 到 2 次 |
500m–2 | 512Mi–2Gi | 根據要求比率和酬載大小調度資源 |
| 端點挑選器 | 每InferencePool 1 次 |
1 億至 5 億 | 256Mi–512Mi | 擷取模型伺服器指標 |
| 頻率限制服務 (選用) | 1 | 1 億至 5 億 | 256Mi–512Mi | 僅限全域頻率限制 |
| Redis (選用) | 1 | 1 億至 5 億 | 256Mi–1Gi | 僅限全域頻率限制 |
網路通訊埠
| 通訊埠 | 元件 | 目的 |
|---|---|---|
| 80 / 443 | Envoy Proxy (Gateway 個事件監聽器) |
LoadBalancer VIP 上的 HTTP/HTTPS 進入點 |
| 1063 | Envoy 代理路由器控制器 (擴充功能伺服器) | Envoy Gateway 擴充功能管理工具的 gRPC 呼叫 |
| 9002 | 端點挑選器 | 從 Envoy Proxy 發出的 ext_proc gRPC 呼叫 |
| 6379 | Redis | 頻率限制計數器 |
| 8000 | vLLM | 模型伺服器的 OpenAI 相容 API 和指標 |
| 11434 | Ollama | 模型伺服器的 Ollama 和 OpenAI 相容 API |
- 可用性和穩定性:
- Proxy 和外部處理器會在同一個
Pod中執行;LoadBalancerService後方的多個副本會遮蓋個別Pod故障,控制器則可在不中斷流量的情況下重新啟動。 AIGatewayRoute規則可列出多個後端並設定優先順序,這樣一來,當後端健康狀態不佳時,閘道就會改用其他副本集或模型伺服器。- 端點挑選器是每個集區的
Deployment;如果無法使用,對該InferencePool的要求會失敗,直到恢復為止。執行時,請使用資源要求和就緒探測,並像監控資料層元件一樣監控。 - Redis 僅保留頻率限制計數器;Redis 中斷會影響頻率限制,而非轉送。
- Proxy 和外部處理器會在同一個
- 作業複雜度:
- Envoy Gateway、Envoy Agent Router 和 Gateway API Inference Extension 的版本一致性:請一併升級這三項,並使用經過測試的組合 (Envoy Gateway 1.8.4、Envoy Agent Router 1.1.0、Gateway API Inference Extension 1.5.0)。
- 實體隔離生命週期:每次升級時,每個映像檔和圖表都會重新植入 Harbor;
EnvoyProxy資源和圖表值會固定登錄檔和提取密鑰。 - 兩個設定層:平台擁有的
GatewayClass/Gateway/EnvoyProxy,以及團隊擁有的AIGatewayRoute/AIServiceBackend/InferencePool。如要啟用新模型,只要新增路由規則和後端,不必新增閘道。 - 監控:要求比率、延遲時間 (包括第一個權杖的時間)、每個模型和消費者的權杖用量、端點挑選器評分,以及模型伺服器的 GPU 使用率。
InferenceObjective仍是 Alpha 版 API (v1alpha2);Inference Extension 的版本之間可能會有結構定義變更。
- 安全性與法規遵循:
- 整個解決方案都在 GDC 實體隔離安全範圍內運作。
- 網路政策為必要:命名空間
NetworkPolicy允許從 Proxy 傳送至模型伺服器通訊埠 (8000、11434) 和端點挑選器 (9002) 的流量,而ProjectNetworkPolicy則允許用戶端流量傳送至LoadBalancerVIP (當消費者位於專案外部時)。 - TLS 會在
Gateway終止,憑證則儲存在 KubernetesSecret中;用戶端只會看到閘道端點。 - 上游憑證 (例如模型伺服器所需的 API 金鑰) 會儲存在
BackendSecurityPolicy參照的Secret中,並由閘道插入,因此應用程式不會保留後端憑證。 - 以權杖為基礎的頻率限制,可限制每位消費者或每個模型耗用的昂貴 GPU 容量。
- Harbor 機器人帳戶和 Kubernetes 映像檔提取密鑰可確保安全存取容器映像檔;角色導向的 Gateway API RBAC 則可區分平台和應用程式的責任。
設計決策
這項參考架構已做出下列重要設計決策:
決策 1:AI 閘道實作:Envoy Gateway 上的開放原始碼 Envoy Agent Router 與替代發行版本
| 背景資訊 | 重要決策 | 理由 |
|---|---|---|
| AI 閘道是主要的架構選擇,並提供可行的替代方案,從自行管理的開放原始碼選項到商業支援的產品:(a) Envoy Gateway 上的 Envoy Agent Router (開放原始碼);(b) kgateway 和 agentgateway (開放原始碼 Gateway API 實作,也可在單一資料層中處理 LLM 供應商流量、MCP 工具和代理對代理通訊,並可選擇由 solo.io 提供供應商支援);(c) Solo Enterprise for agentgateway,這是商業支援的進階選項。 | 參考實作會在 Envoy Gateway 上使用開放原始碼 Envoy 代理路由。替代方案仍是相同 Gateway API 資源背後的有效選擇;如果正式環境需要專屬供應商支援,建議使用商業支援的發行版本。 | 開放原始碼優勢:輕量且符合標準、高效能 L7 轉送、無授權費,適合在採用付費方案前評估解決方案;Envoy Agent Router 是本指南系列中驗證過的選項。開放原始碼缺點:解決方案團隊和社群會盡力提供支援,但可能無法滿足核心正式環境的需求。進階版優勢:提供閘道生命週期企業支援協議,通常也具備進階代理能力。付費版缺點:需要付費授權或支援協議,以及額外的供應商關係。 |
決策 2:Kubernetes Gateway API 搭配 Inference Extension,還是 Ingress 或專屬閘道 API
| 背景資訊 | 重要決策 | 理由 |
|---|---|---|
| 推論端點可透過舊版 Ingress API、閘道專屬設定格式或 Kubernetes Gateway API 公開。模型感知負載平衡還需要一種方式,來描述模型伺服器集區及其優先順序。 | 這項解決方案採用 Kubernetes Gateway API (GatewayClass、Gateway、路徑) 標準,由 Envoy Gateway 實作,並採用 Gateway API Inference Extension (InferencePool、InferenceObjective、端點挑選器) 進行模型感知轉送。 |
Gateway API 是 Kubernetes 標準,可取代 Ingress,以角色為導向 (平台與應用程式團隊),且可跨實作移植。Inference Extension 是模型伺服器感知轉送 (佇列深度、KV 快取、優先順序) 的社群標準,Envoy Agent Router 預設支援這項功能。其他閘道發行版本也實作相同的 API,因此決策 1 仍可撤銷。 |
決策 3:在 OpenAI 相容要求的 model 欄位上,以主體為依據轉送至統合端點
| 背景資訊 | 重要決策 | 理由 |
|---|---|---|
應用程式可透過多種方式指定模型,包括每個模型一個端點 (依主機或路徑)、用戶端設定的自訂標頭,或每個 OpenAI 相容要求已包含的 model 欄位。 |
閘道會公開一個與 OpenAI 相容的端點,並根據 model 欄位轉送:外部處理器會將該欄位擷取至 x-ai-eg-model 標頭,而 AIGatewayRoute 規則會比對該標頭。 |
現有的 OpenAI 相容用戶端和 SDK 可照常運作,只要變更一個字串即可切換模型;端點、憑證和模型位置可變更,不影響應用程式;相同規則可將模型名稱對應至多個後端,用於流量拆分、備用或覆寫模型名稱。 |
決策 4:將實體隔離構件植入 Harbor,還是隨選提取
| 背景資訊 | 重要決策 | 理由 |
|---|---|---|
| 上游安裝作業會視需要從公開登錄檔和 Helm 圖表提取容器映像檔,做為 OCI 構件,這在實體隔離環境中是不可能的。 | 所有容器映像檔 (Envoy Proxy、Envoy Gateway、Envoy Agent Router 控制器和外部處理器、頻率限制服務、Endpoint Picker、Redis) 和 Envoy Gateway 與 Envoy Agent Router Helm 圖表,都會透過 seed_registry.sh (crane) 植入 Harbor 專案,圖表會透過 Harbor 的 helm template 離線算繪,EnvoyProxy 資源和圖表值則會固定 Harbor 登錄檔和提取密鑰。 |
每個版本都有一個可重複、可稽核的播種步驟;叢集不需要外部連線;版本固定功能可讓升級作業明確且可逆。 |
決策 5:選用 Redis 權杖式頻率限制,或僅採用要求式限制
| 背景資訊 | 重要決策 | 理由 |
|---|---|---|
| GPU 運算能力是以權杖為單位消耗,而非要求。因此,要求數量限制無法保護共用模型,避免少數大型提示或冗長生成內容造成影響。Envoy Gateway 的全域頻率限制需要共用計數器儲存庫。 | 以詞元為基礎的頻率限制是架構的選用功能:外部處理器會記錄每個要求的輸入、輸出和總詞元數 (llmRequestCosts),BackendTrafficPolicy 會強制執行預算,而 Redis 執行個體 (Redis 8.10,部署在叢集或現有執行個體中) 則會儲存計數器。如果部署作業沒有頻率限制,就不需要 Redis。 |
用量是以反映費用的單位計算,預算會一致套用至所有 Proxy 副本,且只有需要配額的客戶才須支付依附元件費用。 |
決策 6:拓撲:閘道控制和資料層位於標準叢集的專屬命名空間,模型位於應用程式命名空間
| 背景資訊 | 重要決策 | 理由 |
|---|---|---|
| 閘道可以在專屬叢集、每個應用程式命名空間,或每個標準叢集執行一次,並位於其前端的模型旁邊。GDC 實體隔離方案的開放權重模型會部署在標準叢集 (隨附指南組合)。 | Envoy Gateway 和 Envoy Agent Router 控制層,以及 Envoy Proxy 資料層,會在託管模型的標準叢集專屬命名空間中執行;AIGatewayRoute、AIServiceBackend、InferencePool 和模型部署作業則位於應用程式命名空間,並跨命名空間參照。 |
要求會保留在 Proxy 和模型 Pod 之間的叢集網路內 (延遲時間最低,不需額外的負載平衡器),平台管理員擁有閘道命名空間,應用程式團隊則擁有其路徑和模型,且端點挑選器可以直接抓取模型伺服器。每個專案的用戶端閘道會轉送至中央伺服器閘道,仍是這個拓撲的延伸,可供多個專案使用。 |
假設和限制
- GDC 實體隔離方案 1.16.2-hf1 以上版本環境,可與執行 Kubernetes v1.32.13-gke.400 以上版本的標準叢集搭配使用。
- 模型提供後端有足夠的硬體資源 (尤其是 GPU);閘道元件本身則在 CPU 節點上執行。實際模型需要 GPU;Ollama 上的小型模型可在 CPU 上執行,但僅限功能評估。
- Harbor 執行個體已設定完成且可存取,並有可連上網際網路和 GDC 環境 (Harbor 和 Kubernetes API) 的工作站,可用於植入映像檔和圖表。
- 使用者具備必要權限:專案角色 Harbor 執行個體檢視者和標準叢集管理員,以及標準叢集上
cluster-admin角色的StandardClusterRoleBinding,用於叢集範圍安裝 (CRD、GatewayClass、命名空間),請參閱參考實作。 - 模型提供後端會公開與 OpenAI 相容的 API;附加為
InferencePool的後端也會公開端點挑選器依賴的 vLLM 相容指標。 - 限制:解決方案團隊會盡力支援開放原始碼元件 (Envoy Gateway、Envoy Agent Router、Gateway API Inference Extension);如需專屬供應商支援,則需使用商業支援的發行版本 (決策 1)。
- 限制:
InferenceObjective是 Alpha 版 API (inference.networking.x-k8s.io/v1alpha2),可能會在推論擴充功能版本之間變更。 - 限制:專案外部的消費者需要
Gateway的LoadBalancerVIP 和ProjectNetworkPolicy;在專案內部,叢集內用戶端或kubectl port-forward可以直接連線至閘道Service。 - 限制:本解決方案版本不支援 GDC 上的 Gemini、模型微調、非 LLM 生成式 AI 模型,以及多節點模型提供。
使用者流程
以下是 GDC 實體隔離方案中 AI 閘道的完整使用者流程:首先是應用程式開發人員依賴的要求路徑,接著是平台管理員遵循的設定路徑。
1. 開發人員要求路徑
應用程式或代理只需要閘道端點、用戶端憑證 (如果閘道強制執行),以及模型名稱。
- 傳送要求:應用程式在閘道端點上呼叫
POST /v1/chat/completions,並使用與 OpenAI 相容的 JSON 主體命名模型 (例如"model": "gemma"),就像呼叫任何與 OpenAI 相容的服務一樣。 - 進入閘道:要求到達
Gateway的LoadBalancerVIP;Envoy Proxy 終止 TLS 並比對監聽器和路徑。 - 處理主體:Proxy 會將要求傳送至 Envoy Agent Router 外部處理器,由其剖析主體、將模型名稱擷取至
x-ai-eg-model標頭,並在酬載與後端結構定義不同時,將酬載轉譯為後端結構定義。 - 選取後端:與模型名稱相符的
AIGatewayRoute規則會選取AIServiceBackend(例如 OllamaService) 或InferencePool(例如 vLLM 副本集);如果是InferencePool,端點挑選器會選擇佇列最短且 KV 快取比對結果最佳的副本。 - 轉送及回應:當
BackendSecurityPolicy適用時,Proxy 會插入上游憑證、將要求轉送至所選Pod、串流傳輸回應,並讓外部處理器記錄權杖用量,進而提供指標,以及權杖型頻率限制 (如有設定)。 - 切換模型:如要使用其他模型,開發人員只需變更
model字串,不需建立新的端點、憑證或用戶端程式庫。
2. 平台管理員設定路徑
- 將構件植入 Harbor:建立 Harbor 機器人帳戶,然後從可連上網際網路的工作站,使用
seed_registry.sh將容器映像檔、Envoy Gateway 和 Envoy Agent Router Helm 圖表複製到 Harbor。 - 安裝 Envoy Gateway:使用
helm template從 Harbor 轉譯 CRD 和控制器圖表,並套用至閘道命名空間;建立EnvoyProxy資源,固定 Proxy 映像檔和提取密鑰,並使用基本的GatewayClass、Gateway和HTTPRoute驗證控制器。 - 安裝 Envoy Agent Router:安裝 Envoy Agent Router CRD 和 Gateway API Inference Extension CRD、部署 Envoy Agent Router 控制器,並重新設定 Envoy Gateway,以便呼叫其擴充功能伺服器 (通訊埠 1063) 並接受
InferencePool後端;視需要部署 Redis 並啟用全域頻率限制服務。 - 公開閘道:使用 HTTP 和 HTTPS 監聽器 (TLS 憑證
Secret) 建立GatewayClass和Gateway,等待LoadBalancerVIP,然後為專案外部的使用者套用ProjectNetworkPolicy。 - 附加模型:使用隨附的指南集部署提供模型後端,然後為與 OpenAI 相容的
Service和InferencePool建立AIServiceBackend資源,以及為與 vLLM 相容的副本集建立 Endpoint Picker 資源,並建立命名空間NetworkPolicy物件。 - 發布路徑:建立
AIGatewayRoute,每個模型名稱設定一項規則 (依據主體轉送),並視需要建立BackendSecurityPolicy和BackendTrafficPolicy物件,用於上游憑證和權杖預算。 - 驗證及操作:透過 VIP (或
kubectl port-forward備用) 呼叫/v1/models和/v1/chat/completions,檢查 Proxy、外部處理器和端點挑選器指標,並將端點和模型名稱提供給應用程式團隊。獨立擴充 Proxy 副本和模型部署作業;一併升級 Envoy Gateway、Envoy Agent Router 和 Inference Extension。
如需詳細步驟,請參閱「Envoy Agent Router 參考實作」和「使用 Envoy Agent Router 進行以主體為依據的路由使用手冊」。
其他資料
- Envoy Agent Router 參考實作
- 使用 Envoy Agent Router 進行以主體為依據的路由作業使用手冊
- 開放權重 LLM 參考架構
- Envoy Agent Router 說明文件
- Envoy Gateway
- Kubernetes Gateway API
- Gateway API Inference Extension
- Google Distributed Cloud 實體隔離方案說明文件