


Cette architecture de référence fournit un framework conceptuel pour déployer et exploiter des bases de données Oracle autogérées sur Google Distributed Cloud (GDC) air-gapped. Cette solution vous permet de gérer les charges de travail de base de données critiques à l'aide de l'opérateur de base de données Oracle officiel pour Kubernetes sur des clusters standards.
L'architecture se concentre sur l'activation d'un modèle BYOL (Bring Your Own License), qui vous permet de déployer des bases de données standardisées, sécurisées et disponibilité élevée dans des environnements isolés. Il couvre l'intégralité du cycle de vie, du provisionnement et de la mise en réseau aux opérations de niveau production telles que la haute disponibilité, la sauvegarde, la restauration et l'observabilité.
Fonctionnalités et capacités
La solution fournit plusieurs composants fonctionnels de base pour la gestion des bases de données :
- Gestion automatisée du cycle de vie : utilisez l'opérateur de base de données Oracle pour automatiser le provisionnement, le clonage, l'application de correctifs et la configuration des bases de données à instance unique (SIDB).
- Haute disponibilité : compatibilité intégrée avec Oracle Data Guard pour fournir des fonctionnalités de réplication synchrone ou asynchrone et de basculement automatisé. La haute disponibilité est assurée dans une seule zone.
- Intégration du stockage persistant : utilisez de manière fluide les classes de stockage standard-rwo existantes de GDC pour les fichiers de base de données afin d'assurer la durabilité des données.
- Gestion sécurisée des images : compatibilité avec la mise en miroir des images de conteneurs Oracle depuis Oracle Container Registry vers les registres Harbor locaux, y compris l'analyse des failles intégrée.
- Observabilité unifiée : mécanismes intégrés pour exporter les métriques de base de données vers Prometheus et transférer les journaux d'alerte à l'aide de modèles side-car.
- Mise en réseau flexible : compatibilité avec les équilibreurs de charge L4 internes et externes pour exposer les points de terminaison de base de données de manière sécurisée.
Principes architecturaux
- Approche autogérée : fournit le framework architectural pour déployer et gérer les charges de travail Oracle.
- Opérations cloud natives : utilise le modèle d'opérateur pour gérer les charges de travail avec état, garantissant ainsi la cohérence entre différents environnements.
- Résilience adaptée aux bases de données : donne la priorité à la réplication au niveau de la base de données (Data Guard) par rapport à la réplication au niveau de l'infrastructure pour assurer la cohérence logique et une récupération plus rapide.
- Conception axée sur la sécurité : respecte les exigences de l'air gap en utilisant des registres locaux, l'analyse obligatoire des images et des règles de réseau explicites pour tout le trafic de la base de données.
Architecture
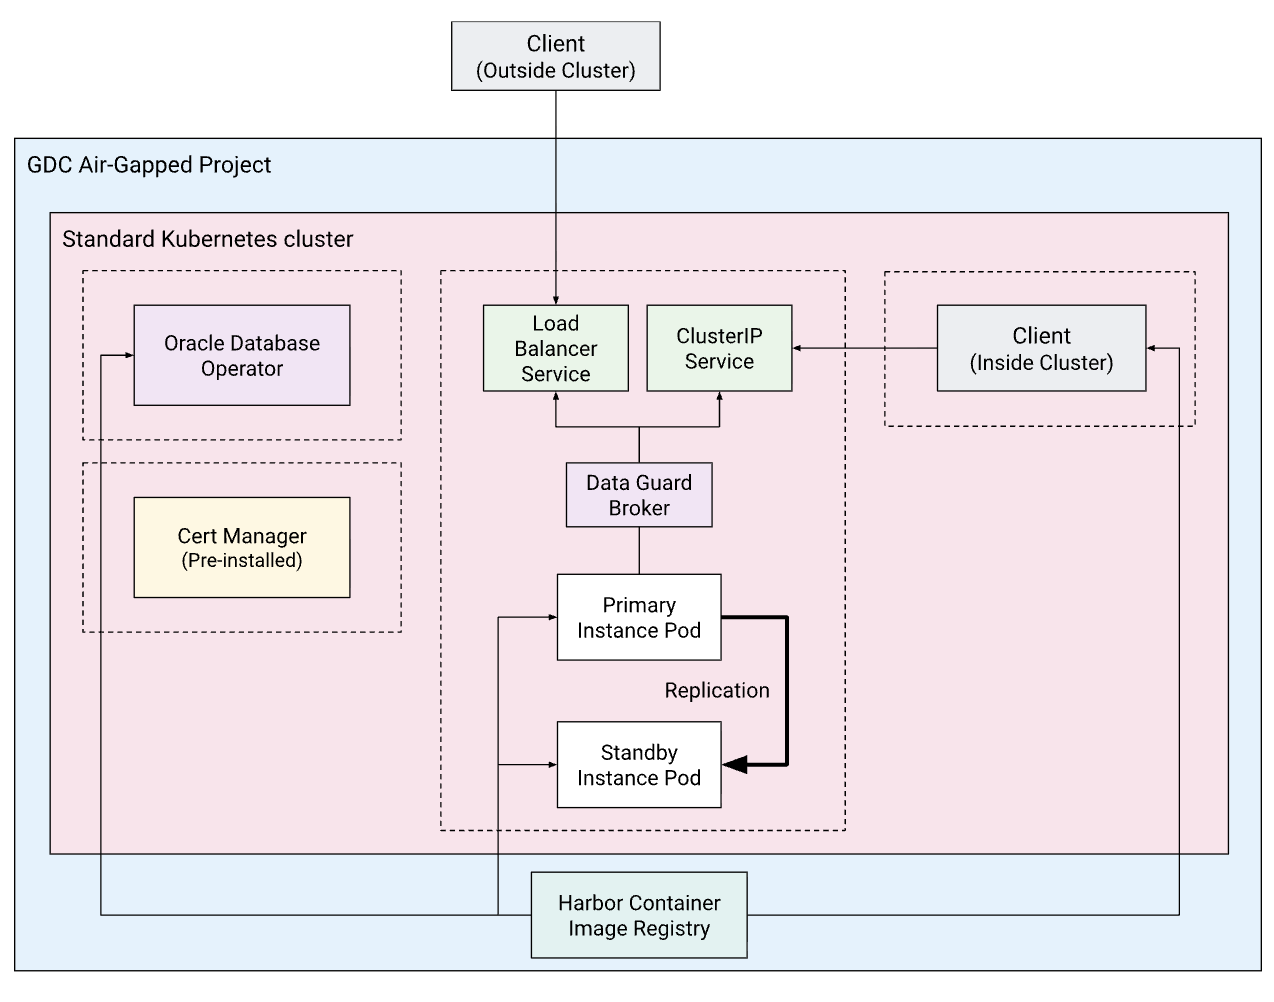
L'architecture illustre la relation entre le cluster GDC standard, Oracle Database Operator, les ressources SIDB et l'infrastructure compatible telle que Harbor.
Concepts et technologies
Cette section décrit les composants fonctionnels, leurs responsabilités et la manière dont ils communiquent au sein du système.
Infrastructure et plate-forme
- Cluster GDC standard : environnement de calcul principal où résident l'opérateur Oracle et les pods de base de données.
- Registre Harbor : source de vérité locale et sécurisée pour toutes les images de conteneurs. Il fournit une analyse automatisée pour s'assurer que les images ne contiennent pas de failles connues.
- Stockage persistant : les classes de stockage standard-rwo de GDC fournissent le stockage de blocs sous-jacent requis pour les fichiers de données, les journaux de rétablissement et les fichiers de contrôle Oracle à l'aide d'un PersistentVolumeClaim.
Services et logique
- Oracle Database Operator : contrôleur chargé de surveiller les ressources personnalisées telles que
SingleInstanceDatabaseetDataguardBroker. Il les rapproche dans des objets Kubernetes standards, y compris des StatefulSets pour les pods de base de données et des services pour la mise en réseau. - Base de données à instance unique (SIDB) : déploiement conteneurisé utilisant l'architecture mutualisée Oracle (CDB/PDB). Vous pouvez déployer plusieurs instances SIDB distinctes ou consolider les charges de travail en créant plusieurs bases de données enfichables (PDB) dans une seule SIDB.
- Data Guard Broker : orchestre les transitions de rôle entre les instances principales et de secours. Il gère les libellés de rôle de base de données, par exemple
database.oracle.com/role: primary, utilisés par les services Kubernetes pour acheminer correctement le trafic après un basculement. - Équilibreur de charge L4 : fournit des adresses IP stables pour la connectivité de la base de données.
Flux de données et interfaces
- SQL*Net (port 1521) : protocole principal pour la connectivité des applications.
- Exportateur d'observabilité : expose un point de terminaison
/metricspour Prometheus. - Journaux d'alertes : les journaux d'alertes de base de données standards sont envoyés à
stdoutpour être collectés par l'agent Logging GDC. - Canaux RMAN : utilisés par les ressources
CronJobpour diffuser des sauvegardes vers un stockage d'objets compatible avec S3.
Remarques
- Évolutivité et performances :
- Les nœuds de calcul doivent être dimensionnés avec au moins 8 vCPU et 32 Gio de RAM pour les charges de travail de production.
- L'utilisation de
nodeSelectorou de rejets et tolérances est une bonne pratique pour dédier des nœuds spécifiques aux charges de travail de base de données. - Les performances dépendent fortement du stockage sous-jacent. Il est recommandé d'utiliser
standard-rwoavec des IOPS élevées.
- Gestion des ressources et licences :
- Cette solution suit un modèle BYOL (Bring Your Own License).
- Les fonctionnalités avancées telles que le chiffrement transparent des données (TDE), la compression avancée et Active Data Guard (veille en lecture seule) nécessitent des licences Enterprise Edition spécifiques.
- L'édition Oracle Database Free peut être utilisée pour le développement et les tests.
- Disponibilité et fiabilité :
- La haute disponibilité est obtenue grâce à des configurations Data Guard monozones dans lesquelles les instances principale et de secours résident dans le même espace de noms.
- L'utilisation d'un service avec un sélecteur pour l'étiquette de rôle
primarygarantit une redirection transparente du client lors du basculement, sans modification côté client. - Pour la protection des données, la solution utilise RMAN pour les sauvegardes dans un bucket compatible S3.
- Gestion opérationnelle :
- Bien que l'opérateur simplifie le déploiement, les opérations quotidiennes telles que le réglage et les restaurations complexes bénéficient toujours de l'expertise en administration de bases de données.
- L'utilisation d'un conteneur side-car est recommandée pour transférer les journaux de trace et d'audit détaillés qui ne sont pas envoyés à
stdout.
Décision de conception
Les principaux choix architecturaux de cette solution visent à trouver un équilibre entre l'automatisation et les contraintes d'un environnement isolé.
Comparaison entre Data Guard et la réplication au niveau du stockage
Data Guard est le mécanisme de haute disponibilité, car il est compatible avec les bases de données. Cette approche protège contre la corruption logique et garantit l'absence de perte de données en mode de disponibilité maximale en validant les blocs avant qu'ils ne soient écrits sur le serveur de secours. Bien que cela nécessite des licences supplémentaires pour Enterprise Edition et une surcharge de configuration plus importante que les instantanés de volume, cela fournit la cohérence requise pour les charges de travail d'affinage.
Gestion des services pour les équilibreurs de charge
Par défaut, la définition du paramètre loadBalancer: true dans la spécification SingleInstanceDatabase crée automatiquement un service d'équilibreur de charge externe. Pour un équilibreur de charge interne, une ressource de service distincte doit être créée manuellement pour inclure l'annotation networking.gke.io/load-balancer-type: "internal" nécessaire. Cette approche manuelle permet de contrôler de manière déclarative les annotations et les étiquettes que le service géré par l'opérateur par défaut n'expose pas.
Stratégie d'observabilité des side-cars pour les journaux
La solution recommande d'utiliser des conteneurs side-car pour le transfert des journaux. Cela dissocie la collecte des journaux du processus de base de données principal, ce qui garantit qu'un volume de journalisation important n'affecte pas les performances de la base de données. Bien que cela augmente l'empreinte des ressources par pod de base de données, cela garantit une collecte fiable des données de télémétrie sans affecter la stabilité de la base de données.
Hypothèses et limites
Hypothèses
- L'environnement dispose d'une instance Harbor préconfigurée et accessible pour l'hébergement d'images.
- Cert-manager est préinstallé sur le cluster standard pour gérer les certificats de webhook de l'opérateur.
- Un store d'objets compatible S3 est disponible pour les cibles de sauvegarde RMAN.
Limites
- HA monozone : les configurations à haute disponibilité sont compatibles avec une seule zone.
- Pas d'Oracle RAC : la compatibilité avec Real Application Clusters (RAC) n'est pas incluse. La solution se concentre sur Single Instance et Data Guard.
- Clusters standards uniquement : la solution est validée pour les clusters GDC standards et n'est pas compatible avec les clusters d'utilisateur partagés.
Étapes suivantes
- Déployer des bases de données Oracle autogérées
- Déployer des bases de données Oracle autogérées à haute disponibilité