


Ce guide décrit le déploiement d'une configuration Oracle Data Guard à haute disponibilité sur un cluster standard Google Distributed Cloud (GDC) air gap. Cette configuration utilise Oracle Database Enterprise Edition et exploite les fonctionnalités existantes de GDC pour le stockage et la mise en réseau.
Ce déploiement utilise l'opérateur de base de données Oracle officiel pour Kubernetes, qui automatise la gestion du cycle de vie de la base de données.
Architecture
L'architecture décrit un déploiement Oracle Database à haute disponibilité géré par Oracle Database Operator dans un cluster GDC standard. Un déploiement à haute disponibilité se compose d'une base de données principale et d'une base de données de secours configurées avec Data Guard pour la réplication et le basculement.
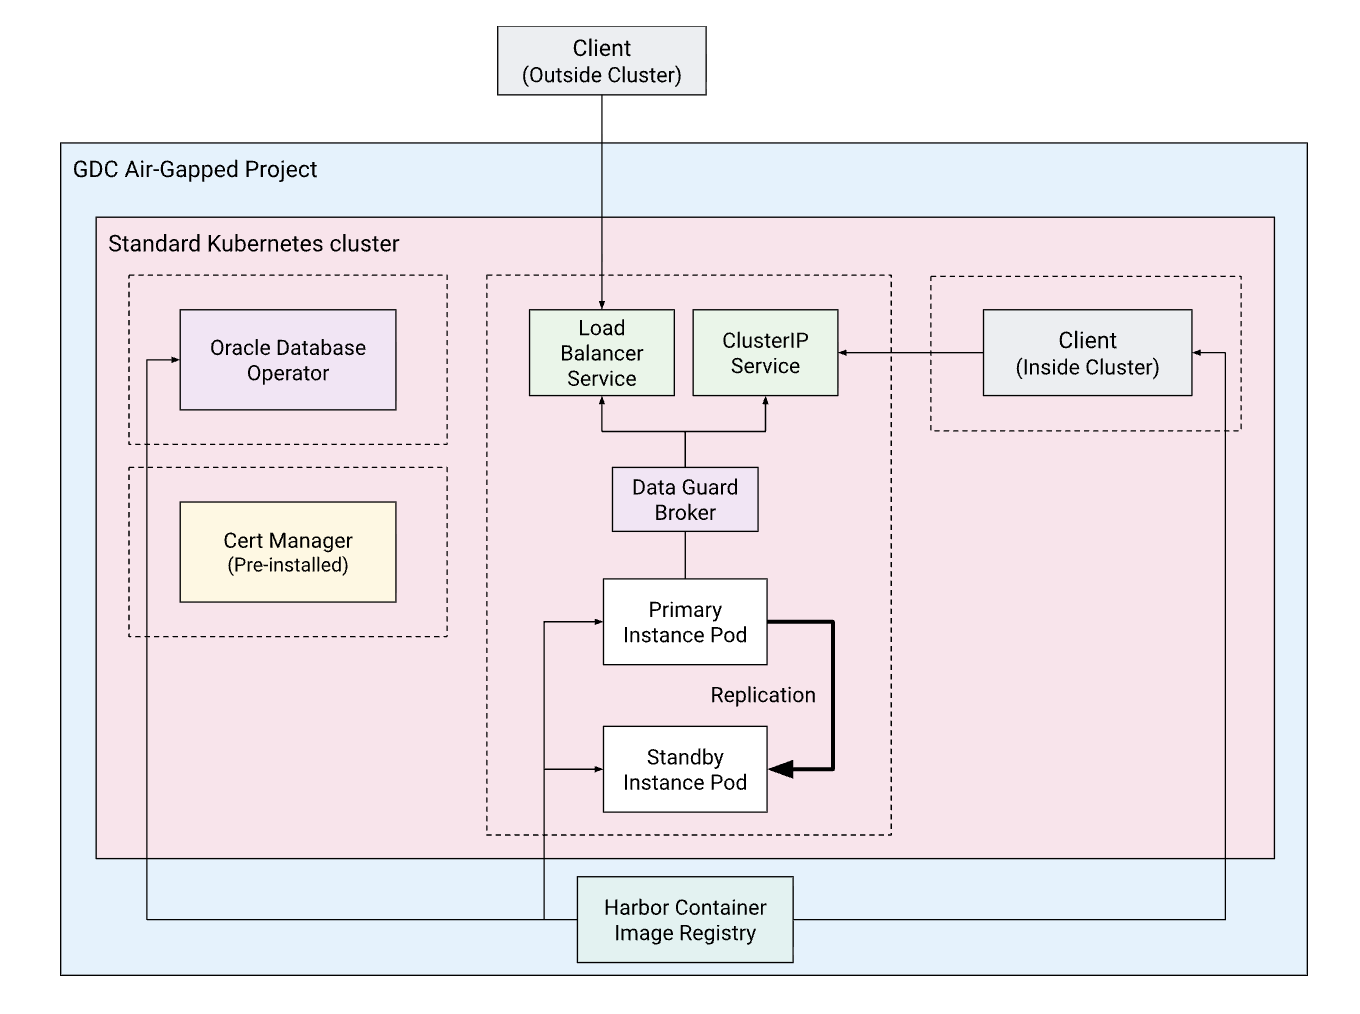
Voici les principaux composants :
- Projet GDC : conteneur de projet pour vos ressources.
- Cluster Kubernetes standard : cluster standard fournissant les ressources de calcul.
- Oracle Database Operator : opérateur Kubernetes qui automatise le provisionnement, la gestion du cycle de vie et l'observabilité des bases de données Oracle. Il simplifie les tâches complexes telles que l'application de correctifs, la sauvegarde et la récupération, ce qui facilite l'exécution des charges de travail Oracle avec état dans un environnement conteneurisé.
- Base de données principale : instance de base de données conteneurisée active en lecture/écriture.
- Base de données de secours : instance de base de données répliquée en lecture seule (ou en lecture/écriture lors du basculement).
- Data Guard Broker : orchestre la configuration et les transitions de rôle (basculement/failover) entre les bases de données.
- Harbor : registre de conteneurs privé utilisé pour héberger les images de base de données, d'opérateur et de client dans l'environnement isolé.
- Cert-manager : l'opérateur s'appuie sur
cert-managerpour gérer les certificats de webhooks.cert-managerest préinstallé sur les clusters GDC standards.
Dans ce guide, vous allez déployer l'opérateur dans son propre espace de noms (oracle-database-operator-system) et l'instance de base de données dans un espace de noms distinct (oracle-dbs). Ces espaces de noms sont représentés par des cadres en pointillés dans le diagramme de l'architecture.
Cette séparation est recommandée pour plus de clarté et de facilité de gestion. Toutefois, c'est à vous de décider comment organiser vos bases de données. Par exemple, vous pouvez regrouper certaines bases de données dans différents espaces de noms pour gérer le contrôle des accès de manière précise (RBAC) en fonction des besoins de la charge de travail, de l'équipe propriétaire ou des spécifications de sécurité.
Avant de commencer
Avant de commencer le déploiement, vous devez vous assurer que votre environnement répond aux exigences suivantes :
- Créez un projet qui servira de conteneur pour toutes les ressources générées tout au long de ce guide.
Attribuez à votre utilisateur les rôles d'administrateur de cluster et d'administrateur de cluster standard pour votre projet. Cela vous permet de créer un cluster Kubernetes standard et de gérer ses ressources :
export PROJECT_ID=PROJECT_ID
export USER_NAME=USER_NAME

gdcloud projects add-iam-policy-binding ${PROJECT_ID} \
  --member="user:${USER_NAME}" \
  --role=cluster-admin

gdcloud projects add-iam-policy-binding ${PROJECT_ID} \
  --member="user:${USER_NAME}" \
  --role=standard-cluster-admin
Créez une instance Harbor et un projet Harbor pour héberger les images de conteneurs nécessaires à ce guide.
Attribuez à votre utilisateur le rôle d'administrateur d'instance Harbor afin de pouvoir importer des images dans votre instance Harbor :
gdcloud projects add-iam-policy-binding ${PROJECT_ID} \
  --member="user:${USER_NAME}" \
  --role=harbor-instance-admin
Créez un compte de robot Harbor dans votre projet Harbor. Plus loin dans ce guide, les identifiants du compte robot seront stockés dans des secrets Kubernetes, ce qui permettra au cluster d'extraire des images de Harbor lors de l'instanciation des conteneurs.
Créez un cluster Kubernetes standard avec au moins deux nœuds de calcul, chacun disposant d'au moins 16 Go de mémoire. Exemple :
kubectl --kubeconfig MGMT_API_KUBECONFIG create -f - <<EOF
apiVersion: cluster.gdc.goog/v1
kind: Cluster
metadata:
  name: ${CLUSTER_NAME}
  namespace: ${PROJECT_ID}
spec:
  nodePools:
  - machineTypeName: n3-standard-8-gdc
    nodeCount: 2
    name: ${CLUSTER_NAME}-node-pool
EOF
Configurez vos variables d'environnement. Elles seront utilisées tout au long du guide pour créer et référencer des ressources :
Remarques :
- Les deux instances de base de données sont nommées arbitrairement
blueetgreendans ce guide. Initialement, l'instanceblueest l'instance principale etgreenest l'instance de secours.
# General info export PROJECT_ID="PROJECT_ID" export ZONE="ZONE" export ORG_NAME="ORG_NAME" export CLUSTER_NAME="CLUSTER_NAME" # Software versions export ORACLE_OPERATOR_VERSION="2.1.0" export ORACLE_DB_VERSION="21.3.0.0" # Namespaces export ORACLE_OPERATOR_NAMESPACE="ORACLE_OPERATOR_NAMESPACE" export DB_NAMESPACE="DATABASE_NAMESPACE" # Harbor config export HARBOR_INSTANCE_PROJECT_ID="HARBOR_PROJECT_ID" export HARBOR_INSTANCE_NAME="HARBOR_INSTANCE_NAME" export HARBOR_INSTANCE_URL="HARBOR_INSTANCE_URL" export HARBOR_PROJECT="HARBOR_PROJECT" export HARBOR_PULL_SECRET_NAME="HARBOR_PULL_SECRET_NAME" export HARBOR_ROBOT_ACCOUNT="robot\$HARBOR_PROJECT+ROBOT_NAME" export HARBOR_ROBOT_SECRET="HARBOR_ROBOT_SECRET" # Oracle database config export ADMIN_PASSWORD="ADMIN_PASSWORD" export ADMIN_PASSWORD_SECRET_NAME="ADMIN_PASSWORD_SECRET_NAME" # Database names export DB_NAME_BLUE="database-blue" export DB_NAME_GREEN="database-green"- Les deux instances de base de données sont nommées arbitrairement
Remarque concernant le réseau : Ce guide suppose qu'il est exécuté à partir d'un nœud bastion ayant accès aux API GDC et à Internet pour télécharger les fichiers manifestes et les images de conteneur de l'opérateur Oracle. Si vous exécutez cette opération à partir d'une machine sans accès à Internet, vous devez obtenir ces éléments séparément (par exemple, en utilisant
docker savepour exporter des images à partir d'une machine connectée etdocker loadpour les importer) et les importer de manière sécurisée dans votre environnement avant de continuer.Avant de continuer, vous devez créer un compte et obtenir un jeton d'API sur container-registry.oracle.com, puis accepter le contrat de licence pour les images Oracle Database Enterprise Edition et Oracle Instant Client.
Charger des images dans Harbor
Étant donné que les clusters de Google Distributed Cloud sous air gap ne peuvent pas accéder aux registres externes, vous devez dupliquer les images requises dans votre instance Harbor privée.
Se connecter à Oracle Container Registry
Vous devez d'abord vous authentifier auprès du registre Oracle officiel pour extraire les images de base :
docker --config=./docker-oracle login container-registry.oracle.com
Une fois la connexion établie, les identifiants sont enregistrés dans ./docker-oracle/config.json.
Se connecter à Harbor
Authentifiez-vous auprès de votre instance Harbor privée :
docker --config=./docker-harbor login ${HARBOR_INSTANCE_URL} \
  -u ${HARBOR_ROBOT_ACCOUNT} \
  -p ${HARBOR_ROBOT_SECRET}
Une fois la connexion établie, les identifiants du compte robot sont enregistrés dans ./docker-harbor/config.json.
Extraire, taguer et transférer des images
Téléchargez les images à partir du registre de conteneurs Oracle officiel et transférez-les vers votre projet Harbor interne. Vous allez mettre en miroir l'opérateur, la base de données d'entreprise et le client instantané pour les tests.
Mettez en miroir l'image de l'opérateur de base de données Oracle :
docker --config=./docker-oracle pull \
  container-registry.oracle.com/database/operator:${ORACLE_OPERATOR_VERSION} \
  --platform linux/amd64

docker tag container-registry.oracle.com/database/operator:${ORACLE_OPERATOR_VERSION} \
  ${HARBOR_INSTANCE_URL}/${HARBOR_PROJECT}/oracle-operator:${ORACLE_OPERATOR_VERSION}

docker --config=./docker-harbor push \
  ${HARBOR_INSTANCE_URL}/${HARBOR_PROJECT}/oracle-operator:${ORACLE_OPERATOR_VERSION}
Mettez en miroir l'image Oracle Database Enterprise :
docker --config=./docker-oracle pull \
  container-registry.oracle.com/database/enterprise:${ORACLE_DB_VERSION} \
  --platform linux/amd64

docker tag container-registry.oracle.com/database/enterprise:${ORACLE_DB_VERSION} \
  ${HARBOR_INSTANCE_URL}/${HARBOR_PROJECT}/oracle-enterprise:${ORACLE_DB_VERSION}

docker --config=./docker-harbor push \
  ${HARBOR_INSTANCE_URL}/${HARBOR_PROJECT}/oracle-enterprise:${ORACLE_DB_VERSION}
Mettez en miroir l'image Oracle Instant Client :
docker --config=./docker-oracle pull \
  container-registry.oracle.com/database/instantclient:latest \
  --platform linux/amd64

docker tag container-registry.oracle.com/database/instantclient:latest \
  ${HARBOR_INSTANCE_URL}/${HARBOR_PROJECT}/oracle-instantclient:latest

docker --config=./docker-harbor push \
  ${HARBOR_INSTANCE_URL}/${HARBOR_PROJECT}/oracle-instantclient:latest
Configurer l'accès au cluster
Avant de déployer des ressources, récupérez les identifiants de votre cluster standard et créez un alias pratique :
Récupérez le fichier kubeconfig de votre cluster standard :
KUBECONFIG=kubeconfig-${CLUSTER_NAME}.yaml gdcloud clusters \
  get-credentials ${CLUSTER_NAME} \
  --standard \
  --project ${PROJECT_ID} \
  --zone ${ZONE}
Créez l'alias
kkpour simplifier les commandes suivantes :alias kk="kubectl --kubeconfig kubeconfig-${CLUSTER_NAME}.yaml"
Créer des secrets
Créez un secret Kubernetes pour permettre au cluster d'extraire des images de Harbor à l'aide des identifiants enregistrés dans votre fichier ./docker-harbor/config.json local. Vous avez besoin de ce secret à la fois dans l'espace de noms de l'opérateur (pour extraire l'image de l'opérateur) et dans l'espace de noms de la base de données (pour extraire l'image de la base de données).
Créez l'espace de noms pour l'opérateur :
kk create ns ${ORACLE_OPERATOR_NAMESPACE}Créez le secret d'extraction pour l'opérateur :
kk create secret docker-registry ${HARBOR_PULL_SECRET_NAME} \
  --from-file=.dockerconfigjson=./docker-harbor/config.json \
  -n ${ORACLE_OPERATOR_NAMESPACE}
Créez l'espace de noms pour les bases de données :
kk create ns ${DB_NAMESPACE}Créez le secret d'extraction d'image pour les conteneurs de base de données :
kk create secret docker-registry ${HARBOR_PULL_SECRET_NAME} \
  --from-file=.dockerconfigjson=./docker-harbor/config.json \
  -n ${DB_NAMESPACE}
Créez le secret pour le mot de passe d'administration des bases de données :
kk create secret generic ${ADMIN_PASSWORD_SECRET_NAME} \
  --from-literal=password=${ADMIN_PASSWORD} \
  -n ${DB_NAMESPACE}
Installer l'opérateur de base de données Oracle
Installez maintenant l'opérateur de base de données Oracle dans votre cluster en appliquant trois fichiers manifestes :
Liaison de rôle de cluster : configure les autorisations nécessaires pour que l'opérateur fonctionne à l'échelle du cluster.
kk apply -f https://raw.githubusercontent.com/oracle/oracle-database-operator/refs/tags/v${ORACLE_OPERATOR_VERSION}/rbac/cluster-role-binding.yamlRBAC de nœud : accorde des autorisations de lecture de la topologie des nœuds, ce qui est essentiel pour une planification correcte des pods.
kk apply -f https://raw.githubusercontent.com/oracle/oracle-database-operator/refs/tags/v${ORACLE_OPERATOR_VERSION}/rbac/node-rbac.yamlDéploiement de l'opérateur : déploie les pods de l'opérateur et les définitions de ressources personnalisées. Cette commande télécharge le fichier manifeste officiel, remplace le chemin d'accès de l'image par votre URL Harbor, injecte la configuration
imagePullSecretspour que Kubernetes puisse s'authentifier auprès de Harbor, puis applique le résultat :curl -L https://raw.githubusercontent.com/oracle/oracle-database-operator/refs/tags/v${ORACLE_OPERATOR_VERSION}/oracle-database-operator.yaml \ | sed "s|container-registry.oracle.com/database/operator:latest|${HARBOR_INSTANCE_URL}/${HARBOR_PROJECT}/oracle-operator:${ORACLE_OPERATOR_VERSION}|g" \ | awk "/terminationGracePeriodSeconds: 10/{print; print \" imagePullSecrets:\n - name: ${HARBOR_PULL_SECRET_NAME}\"; next}1" \ | kk apply -f -Attendez que les pods de l'opérateur soient en cours d'exécution :
kk get pods -n ${ORACLE_OPERATOR_NAMESPACE} --watchLe résultat doit se présenter sous la forme suivante :
NAME                                                           READY   STATUS    RESTARTS   AGE
oracle-database-operator-controller-manager-5f7b56874d-k9v4z   1/1     Running   0          45s
oracle-database-operator-controller-manager-5f7b56874d-n2x8m   1/1     Running   0          45s
oracle-database-operator-controller-manager-5f7b56874d-r6z7q   1/1     Running   0          45s
Déployer des bases de données principale et de secours
Vous allez maintenant déployer deux instances de base de données dans le même espace de noms de manière séquentielle.
Déployer l'instance principale
Exécutez la commande suivante pour créer l'instance de base de données principale :
apiVersion: database.oracle.com/v4
kind: SingleInstanceDatabase
metadata:
  name: ${DB_NAME_BLUE}
  namespace: ${DB_NAMESPACE}
spec:
  replicas: 1
  edition: enterprise
  image:
    pullFrom: "${HARBOR_INSTANCE_URL}/${HARBOR_PROJECT}/oracle-enterprise:${ORACLE_DB_VERSION}"
    pullSecrets: ${HARBOR_PULL_SECRET_NAME}
    prebuiltDB: true
  sid: ORCLBLUE
  pdbName: ORCLPDB1
  archiveLog: true
  flashBack: true
  forceLog: true
  adminPassword:
    secretName: "${ADMIN_PASSWORD_SECRET_NAME}"
    secretKey: "password"
  persistence:
    size: "50Gi"
    storageClass: "standard-rwo"
    accessMode: "ReadWriteOnce"
  resources:
    requests:
      memory: "4Gi"
Paramètres de configuration clés :
sid/pdbName: définit l'identifiant système (SID) et le nom de la base de données enfichable (PDB).edition: spécifie l'édition de la base de données (enterprisedans ce cas).image: pointe vers l'image de votre registre Harbor privé.persistence: demande un volume persistant de 50 Gio à l'aide de la classe de stockagestandard-rwo, qui crée un disque persistant zonal dans GDC.replicas: définit le nombre de pods sur 1 pour l'instance.archiveLog: active le mode Archive Log, qui est requis pour Data Guard.flashBack: active la base de données Flashback, ce qui vous permet de revenir à un état antérieur de la base de données.forceLog: active la journalisation forcée, ce qui garantit que toutes les modifications sont journalisées, même pour les opérations qui contournent normalement la journalisation.
Pour obtenir la liste complète des options de configuration, y compris les paramètres d'initialisation personnalisés et les limites de ressources, consultez la documentation officielle.
La création de la base de données nécessite beaucoup de ressources et peut prendre de 10 à 20 minutes.
Attendez que la base de données soit entièrement prête avant de continuer. Cette étape est essentielle, car la base de données de secours nécessite que la base de données principale soit accessible pour établir la réplication.
Attendez que le pod de base de données soit
Running:kk get po -n ${DB_NAMESPACE} -l app=${DB_NAME_BLUE} -wLe résultat doit se présenter sous la forme suivante :
NAME                   READY   STATUS    RESTARTS   AGE
database-blue-i5xdj   0/1     Pending   0          0s
database-blue-i5xdj   0/1     Pending   0          0s
database-blue-i5xdj   0/1     Pending   0          1s
database-blue-i5xdj   0/1     Init:0/1   0          1s
database-blue-i5xdj   0/1     PodInitializing   0          98s
database-blue-i5xdj   0/1     Running           0          99s
database-blue-i5xdj   1/1     Running           0          99s
Ensuite, surveillez les journaux et attendez le message
DATABASE IS READY TO USE!:kk logs -n ${DB_NAMESPACE} -l app=${DB_NAME_BLUE} -fLe résultat doit contenir les éléments suivants :
#########################
DATABASE IS READY TO USE!
#########################
Vérifiez que l'état est
Healthyet que le rôle estPRIMARY:kk get sidb -n ${DB_NAMESPACE} ${DB_NAME_BLUE}Le résultat doit se présenter sous la forme suivante :
NAME            EDITION      STATUS    ROLE
database-blue   Enterprise   Healthy   PRIMARY
Déployer l'instance de secours
Une fois l'instance principale opérationnelle, déployez l'instance de secours. Notez que les paramètres Data Guard (archiveLog, flashBack, forceLog) sont hérités de la base de données principale et ne doivent pas être spécifiés dans le fichier manifeste de la base de données de secours :
Déployez l'instance de secours :
apiVersion: database.oracle.com/v4
kind: SingleInstanceDatabase
metadata:
  name: ${DB_NAME_GREEN}
  namespace: ${DB_NAMESPACE}
spec:
  replicas: 1
  edition: enterprise
  image:
    pullFrom: "${HARBOR_INSTANCE_URL}/${HARBOR_PROJECT}/oracle-enterprise:${ORACLE_DB_VERSION}"
    pullSecrets: ${HARBOR_PULL_SECRET_NAME}
    prebuiltDB: true
  sid: ORCLGREEN
  pdbName: ORCLPDB1
  adminPassword:
    secretName: "${ADMIN_PASSWORD_SECRET_NAME}"
    secretKey: "password"
  createAs: standby
  primaryDatabaseRef: ${DB_NAME_BLUE}
  persistence:
    size: "50Gi"
    storageClass: "standard-rwo"
    accessMode: "ReadWriteOnce"
  resources:
    requests:
      memory: "4Gi"
Attendez que le pod de base de données soit
Running:kk get po -n ${DB_NAMESPACE} -l app=${DB_NAME_GREEN} -wLe résultat doit se présenter sous la forme suivante :
NAME                   READY   STATUS    RESTARTS   AGE
database-green-q1gur   0/1     Pending   0          0s
database-green-q1gur   0/1     Pending   0          0s
database-green-q1gur   0/1     Pending   0          1s
database-green-q1gur   0/1     Init:0/1   0          1s
database-green-q1gur   0/1     PodInitializing   0          98s
database-green-q1gur   0/1     Running           0          99s
database-green-q1gur   1/1     Running           0          99s
Ensuite, surveillez les journaux et attendez le message
DATABASE IS READY TO USE!:kk logs -n ${DB_NAMESPACE} -l app=${DB_NAME_GREEN} -fLe résultat doit contenir les éléments suivants :
#########################
DATABASE IS READY TO USE!
#########################
Vérifiez que l'état est
Healthyet que le rôle estPHYSICAL_STANDBY:kk get sidb -n ${DB_NAMESPACE}Le résultat doit se présenter sous la forme suivante :
NAME             EDITION      STATUS    ROLE
database-blue    Enterprise   Healthy   PRIMARY
database-green                Healthy   PHYSICAL_STANDBY
Configurer l'agent Data Guard
Déployez
DataguardBrokerpour gérer la configuration Data Guard :apiVersion: database.oracle.com/v4 kind: DataguardBroker metadata: name: broker-blue-green namespace: ${DB_NAMESPACE} spec: primaryDatabaseRef: ${DB_NAME_BLUE} standbyDatabaseRefs: - ${DB_NAME_GREEN} protectionMode: MaxAvailability fastStartFailover: false loadBalancer: trueParamètres de configuration clés :
protectionMode: défini surMaxAvailabilitypour éviter toute perte de données si au moins une instance de secours est disponible, en passant en mode asynchrone si au moins une instance de secours est accessible.fastStartFailover: défini surfalsepour désactiver le basculement automatique. Lorsqu'il est activé, un processus d'observateur peut déclencher automatiquement un basculement si la base de données principale devient indisponible.loadBalancer: définissez cette option surtruepour créer un service KubernetesLoadBalancerpour l'agent, en fournissant une adresse IP externe stable qui est toujours acheminée vers la base de données principale actuelle.
Surveillez l'état de l'agent jusqu'à ce qu'il indique
Healthy:kk get dataguardbroker -n ${DB_NAMESPACE} -wLe résultat doit se présenter sous la forme suivante :
NAME PRIMARY STANDBYS PROTECTION MODE CONNECT STR STATUS FSFO broker-blue-green MaxAvailability Creating broker-blue-green MaxAvailability Creating broker-blue-green ORCLBLUE ORCLGREEN MaxAvailability 10.0.0.25:32345/DATAGUARD Creating false broker-blue-green ORCLBLUE ORCLGREEN MaxAvailability 10.0.0.25:32345/DATAGUARD Healthy falseDataguardBrokercrée un service Kubernetes (broker-blue-green) qui achemine automatiquement le trafic vers la base de données principale actuelle. Cela fournit un point de connexion stable pour les applications. Obtenez ce service :kk get svc -n ${DB_NAMESPACE} broker-blue-greenLe résultat doit se présenter sous la forme suivante. Notez le provisionnement d'un
CLUSTER-IPpour les clients du cluster et d'unEXTERNAL-IPpour les clients externes à l'aide d'un équilibreur de charge :NAME TYPE CLUSTER-IP EXTERNAL-IP PORT(S) AGE broker-blue-green LoadBalancer 10.0.19.198 100.66.38.138 1521:31116/TCP,5500:31842/TCP 8mVérifiez les points de terminaison du service de l'agent. Il doit initialement pointer vers l'adresse IP du pod bleu :
kk get endpoints -n ${DB_NAMESPACE} broker-blue-greenLe résultat doit se présenter sous la forme suivante, où l'adresse IP du pod bleu doit apparaître à la place de
BLUE_POD_IP:NAME ENDPOINTS broker-blue-green [BLUE_POD_IP]:5500,[BLUE_POD_IP]:1521Vérifiez les pods de base de données pour mettre en corrélation l'adresse IP :
kk get pod -n ${DB_NAMESPACE} -o wide
Tester la synchronisation des données et les rôles
Vous allez maintenant vérifier la réplication en écrivant des données dans l'instance principale et en les lisant à partir de l'instance de secours à l'aide d'un pod client dans le cluster.
Écrire dans la base de données principale avec le service de l'agent
Déployez un pod temporaire pour vous connecter à la base de données principale à l'aide du service d'agent stable :
kk run sqlplus -n ${DB_NAMESPACE} --rm -it --restart=Never \
  --image=${HARBOR_INSTANCE_URL}/${HARBOR_PROJECT}/oracle-instantclient:latest \
  --image-pull-policy=Always \
  --overrides='{"spec": {"imagePullSecrets": [{"name": "'${HARBOR_PULL_SECRET_NAME}'"}]}}' \
  -- sqlplus sys/${ADMIN_PASSWORD}@broker-blue-green:1521/ORCLPDB1 as sysdba
Créez une table de test :
CREATE TABLE employees (id NUMBER, name VARCHAR2(50));
INSERT INTO employees VALUES (1, 'John Doe');
COMMIT;
SELECT * FROM employees;
exit;
Le résultat doit se présenter sous la forme suivante :
        ID NAME
---------- --------------------------------------------------
        1 John Doe
Lecture à partir de l'instance de secours (accès direct)
Déployez un pod temporaire pour vous connecter directement au service de secours :
kk run sqlplus -n ${DB_NAMESPACE} --rm -it --restart=Never \
  --image=${HARBOR_INSTANCE_URL}/${HARBOR_PROJECT}/oracle-instantclient:latest \
  --image-pull-policy=Always \
  --overrides='{"spec": {"imagePullSecrets": [{"name": "'${HARBOR_PULL_SECRET_NAME}'"}]}}' \
  -- sqlplus sys/${ADMIN_PASSWORD}@${DB_NAME_GREEN}:1521/ORCLPDB1 as sysdba
Vérifiez la réplication des données :
SELECT * FROM employees;
exit;
Le résultat doit se présenter sous la forme suivante :
        ID NAME
---------- --------------------------------------------------
        1 John Doe
Effectuer une commutation manuelle
Déclenchez une commutation manuelle pour inverser les rôles, en faisant de la base de données verte la nouvelle base de données principale. L'opérateur nécessite le SID (par exemple, ORCLGREEN) de la cible de basculement.
Exécutez la commande suivante :
kk patch dataguardbroker broker-blue-green -n ${DB_NAMESPACE} --type='merge' \
  -p "{\"spec\":{\"setAsPrimaryDatabase\":\"ORCLGREEN\"}}"
Surveillez la progression de la commutation :
kk get sidb -n ${DB_NAMESPACE} -wUne fois le basculement terminé, le résultat doit se présenter comme suit :
NAME             EDITION      STATUS    ROLE
database-blue    Enterprise   Healthy   PHYSICAL_STANDBY
database-green                Healthy   PRIMARY
Vérifiez que les instances de base de données ont changé de rôle et que la base de données verte est désormais l'instance principale :
kk get dataguardbroker -n ${DB_NAMESPACE}Le résultat doit se présenter sous la forme suivante :
NAME                PRIMARY     STANDBYS   PROTECTION MODE
broker-blue-green   ORCLGREEN   ORCLBLUE   MaxAvailability
Vérifiez que les points de terminaison du service
broker-blue-greenont été mis à jour pour pointer vers l'adresse IP du pod vert :kk get endpoints -n ${DB_NAMESPACE} broker-blue-greenLe résultat doit se présenter sous la forme suivante, où l'adresse IP du pod vert doit apparaître à la place de
GREEN_POD_IP:NAME ENDPOINTS broker-blue-green [GREEN_POD_IP]:5500,[GREEN_POD_IP]:1521
Étapes suivantes
- Architecture de référence de base de données Oracle autogérée
- Déployer des bases de données Oracle autogérées