


בעזרת מילונים ב-Vertex AI Translation ב-Google Distributed Cloud (GDC) עם air gap, אתם יכולים להגדיר מונחים ספציפיים לתחום כדי לקבל תרגום עקבי בין צמדי שפות. הגדרת צמדים של מונחי מקור ויעד מאפשרת לכם לקבוע איך השירות יתרגם אוצר מילים מיוחד, כמו שמות של מוצרים, מילים דו-משמעיות ומונחים שאולים.
רשומות במילון המונחים יכולות להיות מילים בודדות (שנקראות גם אסימונים) או ביטויים קצרים, בדרך כלל קצרים מחמש מילים. ב-Vertex AI Translation, רשומות תואמות מוחלות במהלך התרגום, אבל המערכת מתעלמת מרשומות שתואמות למילות עצירה.
שיטות של מילון המונחים
ב-Vertex AI Translation יש את השיטות הבאות לעבודה עם מילוני מונחים ב-GDC:
| Method | תיאור |
|---|---|
CreateGlossary |
יוצרים מילון מונחים. |
GetGlossary |
החזרת מילון מונחים שמור. |
ListGlossaries |
החזרת רשימה של מילוני מונחים בפרויקט. |
DeleteGlossary |
למחוק מילון מונחים שכבר לא צריך. |
לפני שמתחילים
לפני שיוצרים מילון מונחים לתרגום, צריך שיהיה פרויקט בשם translation-glossary-project. המשאב בהתאמה אישית של הפרויקט צריך להיראות כמו בדוגמה הבאה:
  apiVersion: resourcemanager.gdc.goog/v1
  kind: Project
  metadata:
    labels:
      atat.config.google.com/clin-number: CLIN_NUMBER
      atat.config.google.com/task-order-number: TASK_ORDER_NUMBER
    name: translation-glossary-project
    namespace: platform
כדי לקבל את ההרשאות שדרושות לשימוש במילון מונחים, צריך לבקש מהאדמין של הפרויקט ב-IAM להקצות לכם את התפקידים הבאים במרחב השמות של הפרויקט:
- AI Translation Developer: התפקיד
ai-translation-developerמאפשר גישה לשירות Vertex AI Translation. - אדמין של קטגוריות בפרויקט: התפקיד "אדמין של קטגוריות בפרויקט" (
project-bucket-admin) מאפשר לנהל קטגוריות של אחסון ואובייקטים בתוך קטגוריות, וכך ליצור ולהעלות קבצים.
למידע נוסף על דרישות מוקדמות, ראו הגדרת פרויקט תרגום.
יצירת קובץ מילון מונחים
צריך ליצור קובץ מילון מונחים כדי לאחסן את המונחים בשפת המקור ובשפת היעד. בקטע הזה יש שתי פריסות שונות של מילון מונחים שבהן אתם יכולים להשתמש כדי להגדיר את המונחים שלכם.
בטבלה הבאה מפורטות המגבלות של קובצי מילון המונחים שנתמכים ב-Distributed Cloud:
| תיאור | הגבלה |
|---|---|
| גודל קובץ מקסימלי | 10.4 מיליון (10,485,760) בייטים בקידוד UTF-8 |
| האורך המקסימלי של מונח במילון | 1,024 בייטים בקידוד UTF-8 |
| המספר המקסימלי של משאבי מילון מונחים לפרויקט | 10,000 |
בוחרים אחת מהפריסות הבאות לקובץ של מילון המונחים:
- מילון מונחים חד-כיווני: מציינים את התרגום הצפוי של צמד מונחים בשפת המקור ובשפת היעד בשפה ספציפית. מילוני מונחים חד-כיווניים תומכים בפורמטים של קובצי TSV, CSV ו-TMX.
- מילון מונחים עם קבוצת מונחים מקבילים: מציינים את התרגום הצפוי בכמה שפות בכל שורה. מילוני מונחים מקבילים תומכים בפורמטים של קובצי CSV.
מילון מונחים חד-כיווני
Vertex AI Translation API מקבל ערכים מופרדים בטאבים (TSV) וערכים מופרדים בפסיקים (CSV). בפורמטים האלה, כל שורה מכילה צמד מונחים שמופרדים באמצעות טאב (\t) או פסיק (,).
Vertex AI Translation API מקבל גם את הפורמט Translation Memory eXchange (TMX), פורמט XML סטנדרטי שמאפשר לספק את צמדי המונחים של המקור והיעד של התרגום. קובצי הקלט הנתמכים הם בפורמט שמבוסס על TMX גרסה 1.4.
הדוגמאות הבאות מציגות את המבנה הנדרש לקובצי TSV, CSV ו-TMX של מילוני מונחים חד-כיווניים:
TSV ו-CSV
בתמונה הבאה מוצגות שתי עמודות בקובץ TSV או CSV. העמודה הראשונה מכילה את המונח בשפת המקור, והעמודה השנייה מכילה את המונח בשפת היעד.
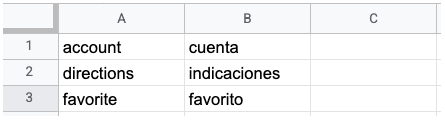
אל תכללו שורת כותרת בקובץ TSV או CSV חד-כיווני. השורה הראשונה צריכה להכיל נתוני מונחים. הבקשה למילוי מונחים הופכת את הקובץ לזמין ל-Vertex AI Translation API.
TMX
הדוגמה הבאה ממחישה את המבנה הנדרש בקובץ TMX:
<?xml version='1.0' encoding='utf-8'?>
<!DOCTYPE tmx SYSTEM "tmx14.dtd">
<tmx version="1.4">
  <header segtype="sentence" o-tmf="UTF-8" adminlang="en" srclang="en" datatype="PlainText"/>
  <body>
    <tu>
      <tuv xml:lang="en">
        <seg>account</seg>
      </tuv>
      <tuv xml:lang="es">
        <seg>cuenta</seg>
      </tuv>
    </tu>
    <tu>
      <tuv xml:lang="en">
        <seg>directions</seg>
      </tuv>
      <tuv xml:lang="es">
        <seg>indicaciones</seg>
      </tuv>
    </tu>
  </body>
</tmx>
אם הקובץ מכיל תגי XML שלא מוצגים בדוגמה הזו, Vertex AI Translation API מתעלם מהתגים האלה.
כדי ש-Vertex AI Translation API יעבד את קובץ ה-TMX, צריך לכלול בו את הרכיבים הבאים:
-
<header>: מזהים את שפת המקור באמצעות המאפייןsrclang.
<tu>: כוללים זוג רכיבי<tuv>עם אותן שפות מקור ויעד.<tuv>הרכיבים האלה עומדים בדרישות הבאות:- כל רכיב
<tuv>מזהה את שפת הטקסט שהוא מכיל באמצעות המאפייןxml:lang. צריך להשתמש בקודים של ISO-639-1 כדי לזהות את שפת המקור ושפת היעד. כאן אפשר לעיין ברשימת השפות הנתמכות וקודי השפה שלהן. - אם רכיב
<tu>מכיל יותר משני רכיבי<tuv>, Vertex AI Translation API מעבד רק את רכיב<tuv>הראשון שתואם לשפת המקור ואת רכיב<tuv>הראשון שתואם לשפת היעד. השירות מתעלם משאר הרכיבים של<tuv>. - אם לאלמנט
<tu>אין זוג תואם של אלמנטים מסוג<tuv>, ה-Vertex AI Translation API מתעלם מהאלמנט הלא תקין<tu>.
- כל רכיב
<seg>: מייצג מחרוזות כלליות של טקסט. Vertex AI Translation API לא כולל את תגי העיצוב מרכיב<seg>לפני עיבוד הקובץ. אם רכיב<tuv>מכיל יותר מרכיב<seg>אחד, Vertex AI Translation API משרשר את הטקסט לרכיב אחד עם רווח בין מחרוזות הטקסט.
אחרי שזיהיתם את המונחים במילון החד-כיווני, העלו את הקובץ לקטגוריית אחסון והפכו אותו לזמין ל-Vertex AI Translation API על ידי יצירה וייבוא של מילון מונחים.
מילון מונחים מקבילים
Vertex AI Translation API מקבל קובצי מילון מונחים לקבוצות של מונחים מקבילים בפורמט CSV. כדי להגדיר קבוצות של מונחים מקבילים, יוצרים קובץ CSV עם כמה עמודות, שבו כל שורה כוללת מונח אחד ממילון המונחים בכמה שפות. כאן אפשר לעיין ברשימת השפות הנתמכות וקודי השפה שלהן.
בתמונה הבאה מוצגת דוגמה לקובץ CSV עם כמה עמודות. כל שורה מייצגת מונח במילון המונחים, וכל עמודה מייצגת תרגום של המונח לשפות שונות.
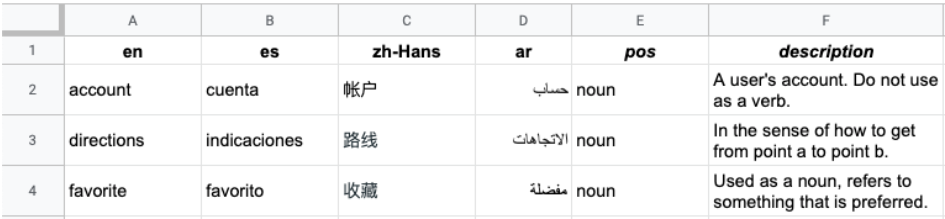
הכותרת היא השורה הראשונה בקובץ, והיא מציינת את השפה של כל עמודה. שורת הכותרת משתמשת בקודי השפה הסטנדרטיים ISO-639-1 או BCP-47. Vertex AI Translation API לא משתמש במידע על חלקי דיבר (pos), וערכי מיקום ספציפיים לא מאומתים.
כל שורה נוספת מכילה מונחים מקבילים במילון המונחים בשפות שצוינו בכותרת. אפשר להשאיר עמודות ריקות אם המונח לא זמין בכל השפות.
אחרי שמזהים את המונחים במילון המונחים בקבוצת המונחים המקבילים, מעלים את הקובץ לקטגוריית אחסון והופכים אותו לזמין ל-Vertex AI Translation API על ידי יצירה וייבוא של מילון מונחים.
העלאת קובץ מילון המונחים לקטגוריית אחסון
כדי להעלות את קובץ מילון המונחים לקטגוריית אחסון:
- הגדרת ה-gdcloud CLI למאגר אובייקטים.
יוצרים קטגוריית אחסון במרחב השמות של הפרויקט. משתמשים בסוג האחסון (storage class)
Standard.כדי ליצור את קטגוריית האחסון, פורסים משאב
Bucketבמרחב השמות של הפרויקט:apiVersion: object.gdc.goog/v1 kind: Bucket metadata: name: glossary-bucket namespace: translation-glossary-project spec: description: bucket for translation glossary storageClass: Standard bucketPolicy: lockingPolicy: defaultObjectRetentionDays: 90נותנים הרשאות
readבקטגוריה והרשאותget,listו-watchב-secretsבמרחב השמות של הפרויקט לחשבונות השירות (ai-translation-system-saו-g-vai-translation-sie-sa) שמשמשים את שירות Vertex AI Translation.כדי ליצור את התפקיד ואת הקישור לתפקיד באמצעות משאבים בהתאמה אישית בשרת ה-API לניהול, צריך לבצע את השלבים הבאים. משתמש שכבר יש לו את ההרשאות של
secretsצריך להחיל את המשאבים האלה, אחרת הבקשה תיכשל עם השגיאהattempting to grant RBAC permissions not currently held:יוצרים את התפקיד על ידי פריסת משאב
Roleבמרחב השמות של הפרויקט:apiVersion: rbac.authorization.k8s.io/v1 kind: Role metadata: name: ai-translation-glossary-reader namespace: translation-glossary-project rules: - apiGroups: - object.gdc.goog resources: - buckets verbs: - read-object - apiGroups: - "" resources: - secrets verbs: - get - list - watchיוצרים את קישור התפקיד על ידי פריסת משאב
RoleBindingבמרחב השמות של הפרויקט:apiVersion: rbac.authorization.k8s.io/v1 kind: RoleBinding metadata: name: ai-translation-glossary-reader-rolebinding namespace: translation-glossary-project roleRef: apiGroup: rbac.authorization.k8s.io kind: Role name: ai-translation-glossary-reader subjects: - kind: ServiceAccount name: ai-translation-system-sa namespace: g-vai-translation-sie - kind: ServiceAccount name: g-vai-translation-sie-sa namespace: g-vai-translation-sie
מעלים את קובץ מילון המונחים לקטגוריית האחסון שיצרתם. מידע נוסף זמין במאמר העלאה והורדה של אובייקטים באחסון בפרויקטים.
יצירת מילון מונחים
השיטה CreateGlossary יוצרת מילון מונחים ומחזירה את המזהה של הפעולה הממושכת שיוצרת את מילון המונחים.
כדי ליצור מילון מונחים, מחליפים את הערכים הבאים לפני שמשתמשים בנתוני הבקשה:
ENDPOINT: נקודת הקצה של Vertex AI Translation שמשמשת את הארגון. למידע נוסף על סטטוס השירות ונקודות הקצהPROJECT_ID: מזהה הפרויקט.-
BUCKET_NAME: השם של קטגוריית האחסון שבה נמצא קובץ מילון המונחים. -
GLOSSARY_FILENAME: השם של קובץ מילון המונחים בקטגוריית האחסון.
זה התחביר של בקשת HTTP ליצירת מילון מונחים:
POST https://ENDPOINT/v3/projects/PROJECT_ID/glossaries
בוחרים באחת מהאפשרויות הבאות כדי ליצור מילון מונחים, בהתאם לקובץ מילון המונחים שיצרתם:
חד-כיווני
כדי ליצור מילון מונחים חד-כיווני, מציינים צמד שפות (language_pair) עם שפת מקור (source_language_code) ושפת יעד (target_language_code).
כדי ליצור מילון חד-כיווני:
שומרים את גוף הבקשה הבא בקובץ JSON בשם
request.json:{ "language_pair": { "source_language_code": "SOURCE_LANGUAGE", "target_language_code": "TARGET_LANGUAGE" }, "input_config": { "s3_source": { "input_uri": "s3://BUCKET_NAME/GLOSSARY_FILENAME" } } }מחליפים את מה שכתוב בשדות הבאים:
שולחים את הבקשה. בדוגמאות הבאות נעשה שימוש ב-method של API בארכיטקטורת REST ובשורת הפקודה, אבל אפשר גם להשתמש בספריות לקוח כדי ליצור מילון מונחים חד-כיווני.
curl
curl -X POST \
-H "Authorization: Bearer TOKEN" \
-H "Content-Type: application/json; charset=utf-8" \
-d @request.json \
"https://ENDPOINT/v3/projects/PROJECT_ID/glossaries"
מחליפים את TOKEN באסימון האימות שקיבלתם.
PowerShell
$cred = TOKEN
$headers = @{ "Authorization" = "Bearer $cred" }
Invoke-WebRequest
  -Method POST
  -Headers $headers
  -ContentType: "application/json; charset=utf-8"
  -InFile request.json
  -Uri "https://ENDPOINT/v3/projects/PROJECT_ID/glossaries"
  | Select-Object -Expand Content
מחליפים את TOKEN באסימון האימות שקיבלתם.
Python
מתקינים את הגרסה העדכנית של ספריית הלקוח של Vertex AI Translation.
מוסיפים את הקוד הבא לסקריפט Python שיצרתם:
import time
import google.auth
import google.auth.transport.requests
import requests

def create_glossary(project_id="PROJECT_ID", input_uri="s3://BUCKET_NAME/GLOSSARY_FILENAME",
                    source_lang_code="SOURCE_LANGUAGE", target_lang_code="TARGET_LANGUAGE"):
    # Client 3.8.0 has no s3_source field, so call REST (token audience without :443).
    creds, _ = google.auth.default()
    creds = creds.with_gdch_audience("https://ENDPOINT")
    creds.refresh(google.auth.transport.requests.Request())
    session = requests.Session()
    session.verify = "CERT_NAME"
    session.headers["Authorization"] = f"Bearer {creds.token}"
    body = {"language_pair": {"source_language_code": source_lang_code,
                              "target_language_code": target_lang_code},
            "input_config": {"s3_source": {"input_uri": input_uri}}}
    r = session.post(f"https://ENDPOINT/v3/projects/{project_id}/glossaries", json=body)
    r.raise_for_status()
    op = r.json()
    while not op.get("done"):
        time.sleep(2)
        op = session.get(f"https://ENDPOINT/v3/{op['name']}").json()
    return op  # The service assigns the glossary ID: op["metadata"]["name"]
מחליפים את מה שכתוב בשדות הבאים:
-
SOURCE_LANGUAGE: קוד השפה של שפת המקור של מילון המונחים. כאן אפשר לעיין ברשימת השפות הנתמכות וקודי השפה שלהן. -
TARGET_LANGUAGE: קוד השפה של שפת היעד של מילון המונחים. כאן אפשר לעיין ברשימת השפות הנתמכות וקודי השפה שלהן. -
CERT_NAME: השם של קובץ האישור של רשות האישורים (CA), למשלorg-1-trust-bundle-ca.cert. מידע נוסף זמין במאמר יצירת קובץ אישור CA של חבילת האמון בסביבת פיתוח.
-
שומרים את הסקריפט של Python.
מריצים את הסקריפט של Python:
python SCRIPT_NAMEמחליפים את
SCRIPT_NAMEבשם שנתתם לסקריפט Python, למשלglossary.py.
מידע נוסף על השיטה projects.glossaries.create זמין במאמרי העזרה של Vertex AI Translation API בארכיטקטורת REST.
אתם אמורים לקבל תגובת JSON שדומה לזו:
{
"name": "projects/PROJECT_ID/operations/OPERATION_ID",
"metadata": {
    "@type": "type.googleapis.com/google.cloud.translation.v3.CreateGlossaryMetadata",
    "name": "projects/PROJECT_ID/glossaries/GLOSSARY_ID",
    "state": "RUNNING",
    "submitTime": "TIME"
  }
}
בתשובה:
-
OPERATION_ID: המזהה שהוקצה על ידי השרת של הפעולה הממושכת שיוצרת את מילון המונחים. השירות מחזיר את המזהה הזה בשדהnameשל התשובה, או שאפשר למצוא אותו על ידי קריאה ל-projects.operations.list. אפשר להעביר את הערך שלprojects/PROJECT_ID/operations/OPERATION_IDאלprojects.operations.getכדי לבדוק את סטטוס הפעולה של יצירת מילון המונחים. -
GLOSSARY_ID: המזהה שהשרת הקצה למילון המונחים (Gואחריו ספרות), שבו משתמשים בבקשות get, translate ו-delete.
קבוצת מונחים שקולים
כדי ליצור מילון מונחים עם קבוצת מונחים מקבילים, מציינים קבוצת שפות (language_codes_set) עם קודי השפה (language_codes) של מילון המונחים.
כדי ליצור מילון מונחים עם קבוצת מונחים מקבילים:
שומרים את גוף הבקשה הבא בקובץ JSON בשם
request.json:{ "language_codes_set": { "language_codes": ["LANGUAGE_CODE_1", "LANGUAGE_CODE_2", "LANGUAGE_CODE_3" ] }, "input_config": { "s3_source": { "input_uri": "s3://BUCKET_NAME/GLOSSARY_FILENAME" } } }מחליפים את
LANGUAGE_CODE_1,LANGUAGE_CODE_2ו-LANGUAGE_CODE_3בקודים של השפות במילון המונחים. כאן אפשר לעיין ברשימת השפות הנתמכות וקודי השפה שלהן.שולחים את הבקשה:
curl
curl -X POST \
    -H "Authorization: Bearer TOKEN" \
    -H "Content-Type: application/json; charset=utf-8" \
    -d @request.json \
    "https://ENDPOINT/v3/projects/PROJECT_ID/glossaries"
מחליפים את TOKEN באסימון האימות שקיבלתם.
אתם אמורים לקבל תגובת JSON שדומה לזו:
{
  "name": "projects/PROJECT_ID/operations/OPERATION_ID",
  "metadata": {
    "@type": "type.googleapis.com/google.cloud.translation.v3.CreateGlossaryMetadata",
    "name": "projects/PROJECT_ID/glossaries/GLOSSARY_ID",
    "state": "RUNNING",
    "submitTime": "TIME"
  }
}
בתשובה:
-
OPERATION_ID: המזהה שהוקצה על ידי השרת של הפעולה הממושכת שיוצרת את מילון המונחים. השירות מחזיר את המזהה הזה בשדהnameשל התשובה, או שאפשר למצוא אותו על ידי קריאה ל-projects.operations.list. אפשר להעביר את הערך שלprojects/PROJECT_ID/operations/OPERATION_IDאלprojects.operations.getכדי לבדוק את סטטוס הפעולה של יצירת מילון המונחים. -
GLOSSARY_ID: המזהה שהשרת הקצה למילון המונחים (Gואחריו ספרות), שבו משתמשים בבקשות get, translate ו-delete.
PowerShell
$cred = TOKEN
$headers = @{ "Authorization" = "Bearer $cred" }

Invoke-WebRequest `
  -Method POST `
  -Headers $headers `
  -ContentType: "application/json; charset=utf-8" `
  -InFile request.json `
  -Uri "https://ENDPOINT/v3/projects/PROJECT_ID/glossaries"
  | Select-Object -Expand Content
מחליפים את TOKEN באסימון האימות שקיבלתם.
אתם אמורים לקבל תגובת JSON שדומה לזו:
{
  "name": "projects/PROJECT_ID/operations/OPERATION_ID",
  "metadata": {
    "@type": "type.googleapis.com/google.cloud.translation.v3.CreateGlossaryMetadata",
    "name": "projects/PROJECT_ID/glossaries/GLOSSARY_ID",
    "state": "RUNNING",
    "submitTime": "TIME"
  }
}
בתשובה:
-
OPERATION_ID: המזהה שהוקצה על ידי השרת של הפעולה הממושכת שיוצרת את מילון המונחים. השירות מחזיר את המזהה הזה בשדהnameשל התשובה, או שאפשר למצוא אותו על ידי קריאה ל-projects.operations.list. אפשר להעביר את הערך שלprojects/PROJECT_ID/operations/OPERATION_IDאלprojects.operations.getכדי לבדוק את סטטוס הפעולה של יצירת מילון המונחים. -
GLOSSARY_ID: המזהה שהשרת הקצה למילון המונחים (Gואחריו ספרות), שבו משתמשים בבקשות get, translate ו-delete.
Python
מתקינים את הגרסה העדכנית של ספריית הלקוח של Vertex AI Translation.
מוסיפים את הקוד הבא לסקריפט Python שיצרתם:
import time
import google.auth
import google.auth.transport.requests
import requests

def create_glossary(project_id="PROJECT_ID", input_uri="s3://BUCKET_NAME/GLOSSARY_FILENAME",
                    lang_1="LANGUAGE_CODE_1", lang_2="LANGUAGE_CODE_2"):
    # Client 3.8.0 has no s3_source field, so call REST (token audience without :443).
    creds, _ = google.auth.default()
    creds = creds.with_gdch_audience("https://ENDPOINT")
    creds.refresh(google.auth.transport.requests.Request())
    session = requests.Session()
    session.verify = "CERT_NAME"
    session.headers["Authorization"] = f"Bearer {creds.token}"
    body = {"language_codes_set": {"language_codes": [lang_1, lang_2]},
            "input_config": {"s3_source": {"input_uri": input_uri}}}
    r = session.post(f"https://ENDPOINT/v3/projects/{project_id}/glossaries", json=body)
    r.raise_for_status()
    op = r.json()
    while not op.get("done"):
        time.sleep(2)
        op = session.get(f"https://ENDPOINT/v3/{op['name']}").json()
    return op  # The service assigns the glossary ID: op["metadata"]["name"]
מחליפים את מה שכתוב בשדות הבאים:
-
LANGUAGE_CODE_1ו-LANGUAGE_CODE_2: קודי השפות של השפות במילון המונחים. כאן אפשר לעיין ברשימת השפות הנתמכות וקודי השפה שלהן. -
CERT_NAME: השם של קובץ האישור של רשות האישורים (CA), למשלorg-1-trust-bundle-ca.cert. מידע נוסף זמין במאמר יצירת קובץ אישור CA של חבילת האמון בסביבת פיתוח.
-
שומרים את הסקריפט של Python.
מריצים את הסקריפט של Python:
python SCRIPT_NAMEמחליפים את
SCRIPT_NAMEבשם שנתתם לסקריפט Python, למשלglossary.py.
מידע נוסף על השיטה projects.glossaries.create זמין במאמרי העזרה של Vertex AI Translation API בארכיטקטורת REST.
בהתאם לגודל של קובץ מילון המונחים, בדרך כלל יצירת מילון מונחים נמשכת פחות מ-10 דקות. כדי לדעת מתי הפעולה הסתיימה, אפשר לאחזר את הסטטוס שלה.
קבלת מילון מונחים
השיטה GetGlossary מחזירה מילון מונחים שמור. אם מילון המונחים לא קיים, הפלט מחזיר את הערך NOT_FOUND. כדי להפעיל את ה-method GetGlossary, צריך לציין את מזהה הפרויקט ואת מזהה מילון המונחים. השיטות CreateGlossary ו-ListGlossaries מחזירות את מזהה מילון המונחים. Vertex AI Translation API מקבל רק בקשות HTTPS.
לדוגמה, הבקשות הבאות מחזירות מידע על מילון מונחים ספציפי בפרויקט:
curl
curl -X GET \
   -H "Authorization: Bearer TOKEN" \
   "https://ENDPOINT/v3/projects/PROJECT_ID/glossaries/GLOSSARY_ID"
מחליפים את TOKEN באסימון האימות שקיבלתם.
Python
from google.cloud import translate_v3 as translate
from google.api_core.client_options import ClientOptions

def get_glossary(creds, name="projects/PROJECT_ID/glossaries/GLOSSARY_ID"):
    """Get a glossary by its full name. The service assigns the glossary ID."""
    client = translate.TranslationServiceClient(
        credentials=creds, client_options=ClientOptions(api_endpoint="ENDPOINT:443"))
    response = client.get_glossary(name=name)
    print(f"Glossary name: {response.name}")
מעבירים את פרטי הכניסה של Distributed Cloud (creds) שהוגדרו עם הקהל https://ENDPOINT:443, כמו שמוסבר במאמר תרגום טקסט.
מידע נוסף על השיטה get_glossary זמין בספריית הלקוח של Python.
הצגת רשימת מילוני המונחים
ה-method ListGlossaries מחזירה רשימה של משאבי Glossary בפרויקט, שכל אחד מהם מכיל את ה-name המלא (projects/PROJECT_ID/glossaries/GLOSSARY_ID). אם אין בפרויקט מילוני מונחים, הפלט שמחזירה ה-method הוא {}. אם הפרויקט לא קיים, הפלט מחזיר את הערך NOT_FOUND. כדי להפעיל את השיטה ListGlossaries, צריך לציין את מזהה הפרויקט ואת נקודת הקצה של Vertex AI Translation.
Vertex AI Translation API מקבל רק בקשות HTTPS.
לדוגמה, הבקשה הבאה מחזירה את מילוני המונחים בפרויקט:
curl -X GET \
    -H "Authorization: Bearer TOKEN" \
    "https://ENDPOINT/v3/projects/PROJECT_ID/glossaries?page_size=10"
מחליפים את TOKEN באסימון האימות שקיבלתם.
מחיקת מילון מונחים
ה-method DeleteGlossary מוחקת מילון מונחים. אם מילון המונחים לא קיים, הפלט מחזיר את הערך NOT_FOUND. כדי להפעיל את השיטה DeleteGlossary, צריך לציין את מזהה הפרויקט, מזהה מילון המונחים ונקודת הקצה של Vertex AI Translation.
השיטות CreateGlossary ו-ListGlossaries מחזירות את מזהה מילון המונחים. Vertex AI Translation API מקבל רק בקשות HTTPS.
לדוגמה, הבקשה הבאה מוחקת מילון מונחים מהפרויקט:
curl -X DELETE \
    -H "Authorization: Bearer TOKEN" \
    "https://ENDPOINT/v3/projects/PROJECT_ID/glossaries/GLOSSARY_ID"
מחליפים את TOKEN באסימון האימות שקיבלתם.