


Knowledge Catalog te permite unificar los metadatos técnicos y la semántica empresarial en datos estructurados y no estructurados con funciones potenciadas por Gemini. Luego, puedes usar el gráfico de contexto resultante para descubrir recursos, verificar la calidad de los datos y fundamentar las aplicaciones de IA generativa para reducir las alucinaciones.
Este documento está dirigido a ingenieros de datos y contexto, científicos de datos, administradores de datos y desarrolladores de IA. Se supone que tienes familiaridad con los sistemas de bases de datos y almacenamiento, como BigQuery o Cloud Storage, y una comprensión básica de los conceptos de IA generativa, como la generación mejorada por recuperación (RAG) o el protocolo de contexto del modelo (MCP).
Para obtener una explicación detallada de Knowledge Catalog, consulta el siguiente video:
Resuelve la complejidad de los datos específicos de la industria
En las empresas modernas, los datos son complejos, están muy distribuidos y existen en formatos estructurados y no estructurados. Las solicitudes empresariales rara vez se asignan a un solo esquema de base de datos o almacén de documentos. Alinear estos silos de forma segura y, al mismo tiempo, proporcionar respuestas inmediatas y confiables a preguntas que abarcan varios dominios es un gran desafío operativo.
Knowledge Catalog actúa como la base semántica que cierra esta brecha, lo que permite que los agentes de IA y las herramientas de análisis recuperen un contexto fundamentado y pertinente.
Roles de usuario clave
Ingenieros de contexto (ingenieros de datos). Automatiza la agregación de metadatos en las bases de datos y Cloud Storage, realiza un seguimiento de las transformaciones con el linaje y crea flujos de trabajo de enriquecimiento y evaluación.
Administradores de datos (equipos de administración). Supervisa la calidad de los metadatos proporcionando revisiones con intervención humana de las descripciones generadas por IA, estandarizando los vocabularios empresariales con glosarios y definiendo aspectos personalizados para adjuntar contexto específico del dominio a las entradas del catálogo.
Desarrolladores de IA. Fundamenta los LLM y las aplicaciones de IA con esquemas de datos empresariales confiables usando servidores de MCP o APIs de recuperación de contexto.
Casos prácticos del sector
En la siguiente tabla, se ilustran las preguntas complejas que surgen en la práctica, cómo cruzan los límites técnicos y cómo Knowledge Catalog ayuda a las organizaciones a abordarlas:
| Sector | Desafíos operativos y de datos | Problema empresarial que se debe resolver | Cómo lo aborda Knowledge Catalog |
|---|---|---|---|
| Comercio electrónico |
|
"Busca productos electrónicos con altas tasas de devolución y fotos de clientes que muestren signos de daños al momento de la entrega". | Fundamentación semántica en todos los formatos de datos: Descubre automáticamente los metadatos de las bases de datos transaccionales y los vincula a imágenes no estructuradas en los buckets de almacenamiento de Cloud Storage, lo que permite que las herramientas de IA resuelvan la consulta en diferentes sistemas de almacenamiento. |
| Manufactura |
|
“Genera resúmenes de todos los informes de inspección relacionados con las máquinas de la región occidental que no pasaron las verificaciones de seguridad el trimestre pasado”. | Rastreo regional y no estructurado: Rastrea y cataloga informes de inspección en PDF no estructurados junto con metadatos de activos, lo que permite que los agentes de IA generativa ubiquen, recopilen y resuman informes por región. |
| Salud |
|
"¿Qué pacientes tienen el mayor riesgo de reingreso en un plazo de 30 días según los signos vitales de laboratorio recientes y la frecuencia de las citas?". | Calidad y linaje de los datos: Calcula la generación de perfiles de calidad de los datos a nivel de línea y los mapas de linaje en los feeds de registros de salud electrónicos, lo que ayuda a garantizar que los modelos predictivos clínicos se basen solo en signos vitales de pacientes verificados y de alta calidad. |
| Servicios financieros |
|
"¿Cuáles de los 10 clientes que generan más ingresos se quejaron de 'problemas de rendimiento' y cómo afecta eso a las proyecciones del tercer trimestre?" | Gráfico de contexto unificado: Unifica los registros de los clientes, los comentarios de asistencia y las tablas financieras, lo que permite que las consultas en lenguaje natural unan las estadísticas de ingresos de los clientes con los archivos de comentarios no estructurados para prever el impacto financiero. |
Para abordar estos desafíos operativos, Knowledge Catalog proporciona funciones clave que ayudan a los ingenieros de datos, los científicos de datos y los desarrolladores de IA a compilar sistemas de datos gobernados:
Fundamenta los agentes de IA con el Protocolo de contexto del modelo (MCP). Expón metadatos, esquemas, linaje y reglas empresariales directamente a los agentes de IA con servidores de MCP locales o remotos. Estos servidores permiten que los modelos verifiquen las expectativas operativas antes de proponer acciones.
Acelera el descubrimiento para la IA y las estadísticas. Encuentra recursos de datos pertinentes con la búsqueda semántica en lenguaje natural. Los resúmenes y las recomendaciones generativos ayudan a los usuarios a encontrar datos sin esperar las revisiones manuales de la documentación.
Administra productos de datos a gran escala. Empaqueta colecciones de recursos con acuerdos de nivel de servicio (ANS), contratos, detalles de propiedad y notas de uso en unidades únicas y administradas para la búsqueda y la suscripción.
Cómo funciona Knowledge Catalog
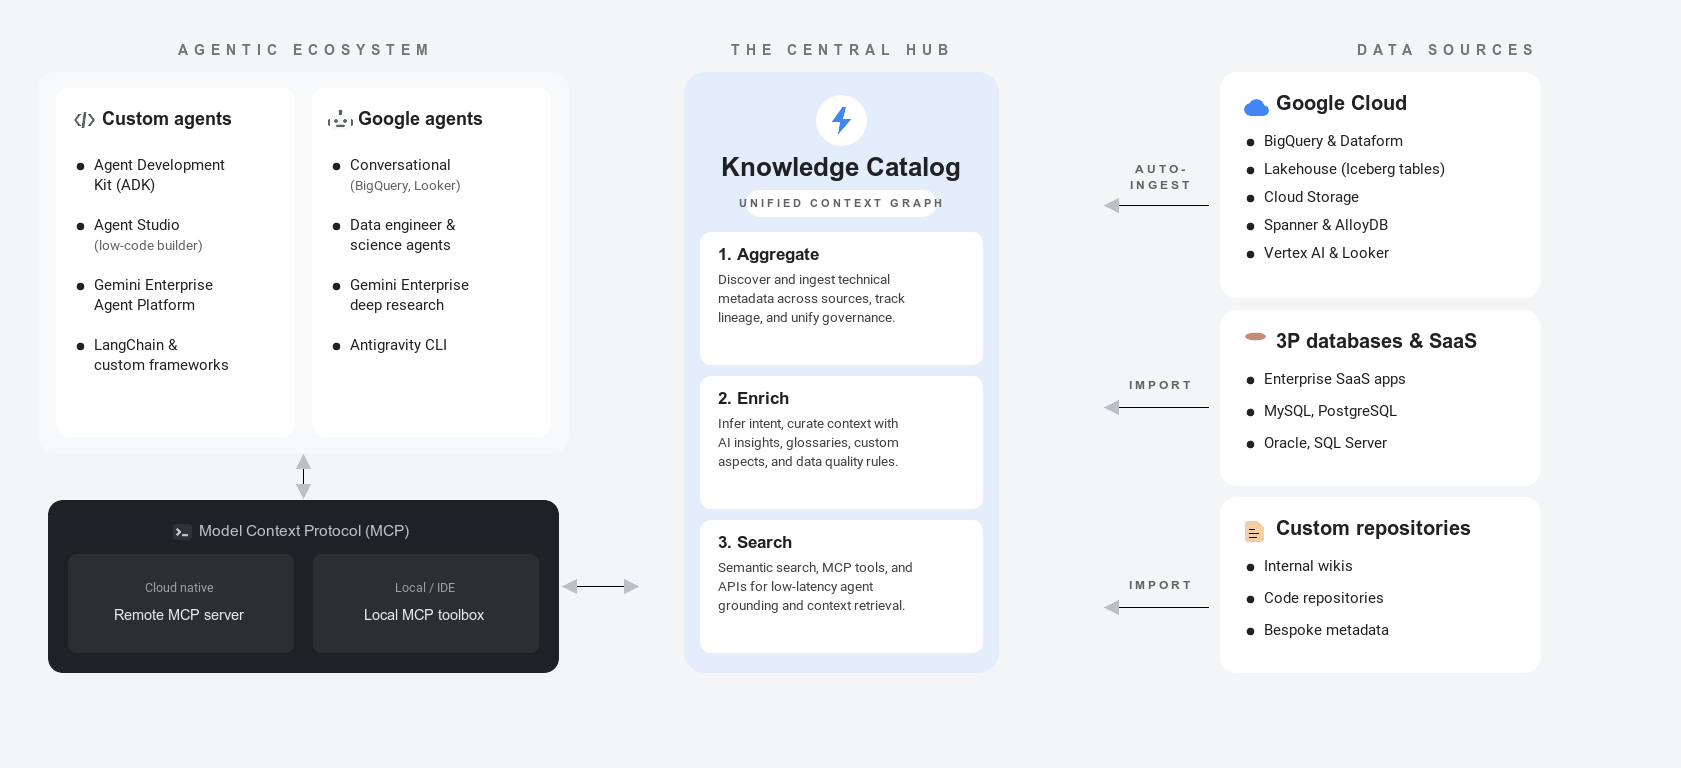
Knowledge Catalog unifica la administración de datos y el contexto a través de un ciclo de vida de tres pilares. En el siguiente diagrama, se ilustra cómo el servicio asigna recursos de datos físicos a la semántica empresarial para fundamentar los agentes de IA:
Para obtener más información sobre estos conceptos de metadatos, consulta Acerca de los metadatos.
En las siguientes secciones, se describen los tres pilares del ciclo de vida de los metadatos y se ilustra cómo una empresa de venta minorista los aplica a las tablas de bases de datos, los archivos y las entradas de catálogo externas:
Agregación (descubrimiento y transferencia). Knowledge Catalog rastrea e indexa automáticamente los metadatos técnicos en todo tu patrimonio de datos sin mover los datos subyacentes:
- Bases de datos integradas. La catalogación automatizada captura esquemas y atributos en plataformas como BigQuery, AlloyDB para PostgreSQL y Spanner.
- Conectividad administrada. Transfiere definiciones de sistemas externos, como Oracle o PostgreSQL, o registros de socios, como Collibra, sin escribir canalizaciones personalizadas.
- Linaje de datos. Realiza un seguimiento de las transformaciones a nivel de columna en las canalizaciones para saber de dónde provienen tus datos y cómo cambiaron.
- Ejemplo: Una empresa de venta minorista transfiere automáticamente los metadatos de la base de datos transaccional, como las tablas
ordersyorder_items, y, además, indexa los archivos de productos no estructurados almacenados en buckets de Cloud Storage. Vinculan bases de datos externas para establecer un índice de metadatos unificado en un directorio detectable.
Para obtener más información sobre la agregación de metadatos y la transferencia de datos (haz clic para expandir)
- Fuentes de datos compatibles: Enumera todas las fuentes externas y de Google Cloud compatibles para la transferencia automatizada.
- Descripción general de la conectividad administrada: Explica cómo transferir esquemas técnicos de sistemas externos.
- Realiza un seguimiento del linaje de datos: Describe cómo visualizar las transformaciones de canalización a nivel de columna y el flujo de datos.
Enriquecimiento (seleccionar el contexto y verificar la confianza). Knowledge Catalog asocia el significado empresarial a las estructuras técnicas y establece indicadores de confianza:
- Estadísticas generadas por IA. Gemini analiza los registros de consultas para generar descripciones de columnas, resúmenes de tablas y uniones recomendadas.
- Glosarios y aspectos. Asigna nombres de métricas internos a un vocabulario compartido con términos empresariales y plantillas lógicas.
- Calidad de los datos y detección de anomalías. Aplica lineamientos de limpieza y ejecuta análisis de aprendizaje automático para detectar valores atípicos estadísticos o problemas de actualidad de los datos, lo que genera indicadores de confianza clave.
- Revisiones de administración. Administra el riesgo con procesos de revisión de flujos de trabajo para verificar las actualizaciones de metadatos antes de la publicación.
- Ejemplo: El equipo de venta minorista enriquece los recursos activando estadísticas de datos para recomendar descripciones de columnas y ejecutar reglas de calidad de los datos. Asignan definiciones empresariales a los pedidos activos creando glosarios y aspectos.
Más información sobre el enriquecimiento de metadatos y la verificación de confianza (haz clic para expandir)
- Configura las estadísticas de datos: Explica cómo generar descripciones y resúmenes automatizados de conjuntos de datos.
- Administra glosarios empresariales: Describe cómo personalizar los términos estándar y los vocabularios empresariales.
- Enriquece los metadatos con aspectos: Muestra cómo adjuntar propiedades de metadatos estructurados a recursos lógicos.
- Reutiliza reglas de calidad de los datos: Muestra cómo establecer y reutilizar reglas de validación de bases de datos.
- Descripción general de la generación de perfiles de datos: Describe cómo configurar análisis para detectar anomalías de esquemas y desvíos estadísticos.
Búsqueda y recuperación (acceso y fundamentación). Las aplicaciones de IA y los usuarios empresariales consultan el gráfico de contexto unificado para acceder a los datos de forma segura:
- Agentes de fundamentación. Conecta tus apps y agentes basados en LLM al catálogo.
- API de Context. Realizar solicitudes de carga útil de fundamentación de baja latencia
- Búsqueda semántica. Encuentra los recursos adecuados con consultas en lenguaje natural.
- Empaquetado de datos. Agrupa colecciones de tablas, detalles de licencias y ANS en paquetes de datos seguros y de autoservicio.
- Ejemplo: Los analistas realizan búsquedas semánticas en lenguaje natural para ubicar recursos. Las aplicaciones de IA consumen este índice de forma segura con servidores de MCP o la API de recuperación de contexto, y los recursos de alta calidad se empaquetan en una vista segura.
Para obtener más información sobre la recuperación de contexto y la fundamentación de agentes (haz clic para expandir)
- Descripción general del Protocolo de contexto del modelo (MCP): Explica cómo conectar los agentes de IA generativa y las capas de aplicación al contexto de Knowledge Catalog.
- Recupera el contexto con LookupContext: Muestra cómo extraer cargas útiles operativas clave para las instrucciones del agente.
- Busca recursos: Describe las capacidades de búsqueda de recursos con la sintaxis de consulta semántica de lenguaje natural.
Knowledge Catalog en Google Cloud y el ecosistema de IA
Comprender cómo se integra Knowledge Catalog con los servicios relacionados es esencial para crear una base de datos.
Google Cloud bases de datos y modelos
- BigQuery. Knowledge Catalog rastrea e indexa automáticamente los conjuntos de datos, las tablas y las vistas de BigQuery. Activa las estadísticas de datos potenciadas por Gemini para analizar los historiales de consultas, publicar descripciones y sugerir consultas de ejemplo verificadas.
- Looker (Google Cloud Core). Knowledge Catalog transfiere paneles de Looker, vistas y estructuras de LookML, como vistas, exploraciones, dimensiones y mediciones. Esta transferencia crea asignaciones de linaje para rastrear cómo los valores operativos se asignan a la semántica empresarial.
- Catálogo de tiempo de ejecución de Lighthouse. Knowledge Catalog se integra en Lighthouse, el metastore de entorno de ejecución para cargas de trabajo de Iceberg de código abierto. Indexa automáticamente los metadatos técnicos sobre las cargas de trabajo de Lighthouse para proporcionar un contexto activo unificado.
Plataformas y asistentes de agentes de IA
- Estadísticas conversacionales. Las interfaces de análisis usan términos del catálogo y herramientas de búsqueda para permitir que los usuarios consulten métricas empresariales en lenguaje natural con fundamentación verificada.
- Gemini para agentes de IA. Los agentes de asistencia de alta precisión usan metadatos del catálogo para ejecutar búsquedas en la base de datos, lo que reduce las alucinaciones.
- Gemini Enterprise Agent Platform. Knowledge Catalog funciona como el estándar central de administración de datos en los entornos de la plataforma de destino. Se vincula de forma cruzada con Gemini Enterprise Agent Platform para proporcionar herramientas y contexto al registro de agentes de la plataforma.
Integración de la base de datos deGoogle Cloud y el servicio de IA
Knowledge Catalog funciona junto con otros productos deGoogle Cloud para formar tu base de datos. En la siguiente tabla, se destaca cómo Knowledge Catalog se integra en los servicios relacionados y los complementa:
| Servicio | Rol principal | Cómo se integra en Knowledge Catalog |
|---|---|---|
| Knowledge Catalog | Administración y contexto de agentes | Sirve como el grafo de contexto semántico unificado, ejecuta análisis de verificación de la calidad de los datos y expone esquemas fundamentados a los modelos y las aplicaciones de IA. |
| BigQuery | Almacenamiento de datos empresariales | Almacena, consulta y procesa conjuntos de datos; rastrea, indexa y enriquece automáticamente estas tablas con aspectos de clasificación empresarial. |
| Agent Platform de Gemini Enterprise | Desarrollo de modelos de IA | Compila, implementa y aloja modelos de base. Los agentes personalizados recuperan el contexto de los metadatos para fundamentar el razonamiento lógico. |
| Cloud Storage | Almacenamiento de archivos no estructurados | Almacena archivos sin procesar y no estructurados; ejecuta automáticamente análisis de descubrimiento no estructurados para analizar archivos PDF e imágenes y crear mapas de relaciones. |
Semántica y formatos de datos
Para instruir y fundamentar los sistemas de agentes de forma eficaz, debes distinguir entre la estructura física de los datos y el significado semántico:
- Semántica. El significado, la intención y las relaciones empresariales asociados
con tus datos. Aunque los esquemas técnicos definen las especificaciones de almacenamiento estructural,
como un tipo de base de datos, una longitud de caracteres o una restricción de números enteros,
la semántica describe lo que realmente representa el conjunto de datos. Por
ejemplo, puedes asignar una columna llamada
txn_qtya la definición empresarial de "cantidad comprada". - Datos estructurados. Información almacenada en esquemas definidos y formatos relacionales. Algunos ejemplos son las tablas de BigQuery, las bases de datos de Spanner y las tablas operativas de Postgres. Knowledge Catalog rastrea automáticamente estos metadatos y registra columnas y restricciones.
Orquestación de contexto de la nube de datos con agentes
En el framework de nube de datos con agentes de Google, Knowledge Catalog funciona como el plano de organización semántica. En lugar de requerir que los desarrolladores codifiquen de forma manual los esquemas y las reglas de la base de datos en las instrucciones, el motor contextual entrega de forma dinámica el contexto semántico preciso que un agente necesita para tomar decisiones inteligentes.
En la siguiente figura, se muestra cómo Knowledge Catalog organiza y entrega el contexto de los datos:
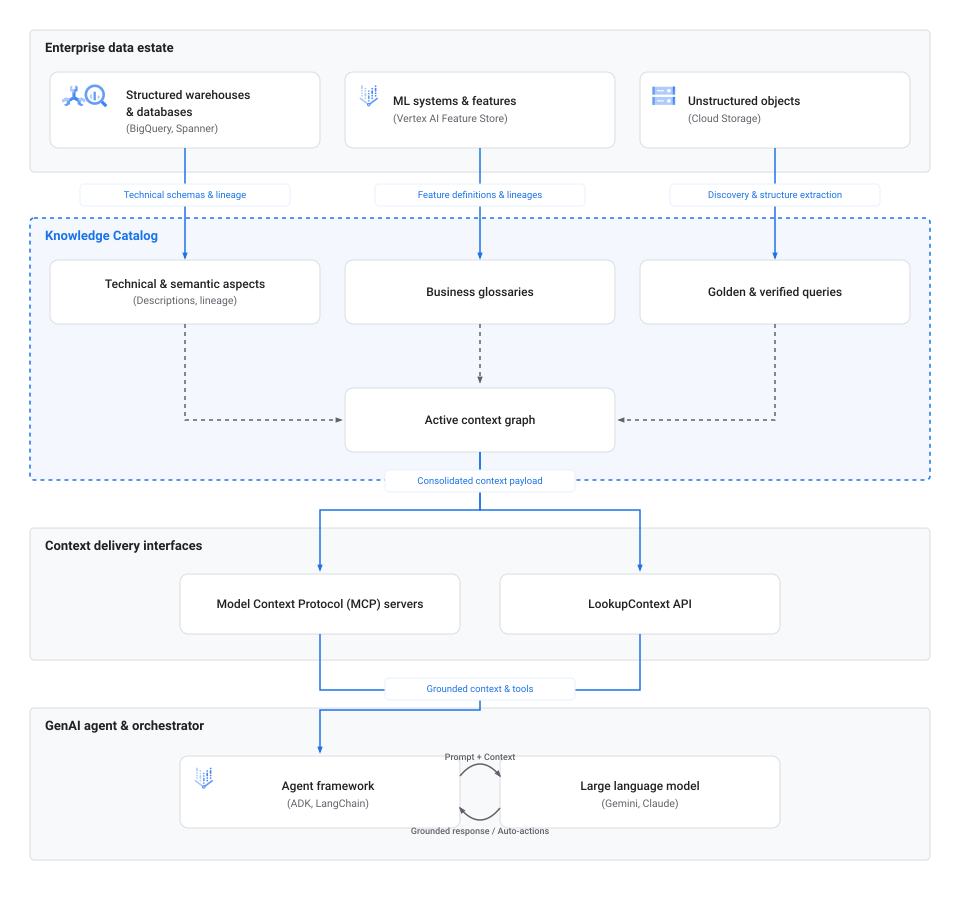
El flujo de trabajo de organización del contexto consta de las siguientes fases:
- Transferencia y descubrimiento. Las bases de datos operativas, los almacenes como Spanner y BigQuery, los almacenes de objetos no estructurados como Cloud Storage y los metastores de entorno de ejecución como Lighthouse alimentan los esquemas técnicos, los mapas de linaje y las definiciones de metadatos directamente en Knowledge Catalog.
- Mapa de contenidos. Dentro de Knowledge Catalog, estas propiedades de metadatos se vinculan a elementos semánticos, incluidos aspectos técnicos, glosarios empresariales y consultas verificadas, para ensamblar el gráfico de contexto activo.
- Interfaces de publicación. Las aplicaciones y los organizadores de IA recuperan este grafo de contexto consolidado de forma programática con conectores estándar, como MCP o endpoints de API de
LookupContextdirectos. - Fundamentación de agentes. Los frameworks de organización, como el Kit de desarrollo de agentes (ADK) o LangChain, insertan este contexto de metadatos directamente en las instrucciones de LLM. Esta inserción fundamenta el razonamiento del agente en reglas organizacionales verificadas, lo que les permite consultar bases de datos o ejecutar acciones automatizadas sin alucinaciones.
Perfiles de agentes de IA
Según los flujos de trabajo que quieras automatizar, puedes crear diferentes clases de agentes potenciados por Knowledge Catalog:
- Agentes de descubrimiento de datos. Estos asistentes ayudan a los usuarios a buscar y navegar por el patrimonio de datos. En lugar de usar la concordancia de palabras clave, analizan la intención y las restricciones de formato largo en lenguaje natural para recuperar los recursos físicos más relevantes.
- Agentes de enriquecimiento de metadatos. Estos agentes en segundo plano transfieren texto no estructurado de wikis, archivos README o registros de chat, analizan el texto en metadatos formales y escriben los metadatos como aspectos en Knowledge Catalog para mantenerlos actualizados.
- Agentes de canalización y calidad de los datos. Estos agentes autónomos evalúan las reglas de calidad, detectan la desviación del esquema y compilan o reparan las canalizaciones de transformación de datos consultando el linaje de los datos y las estadísticas de los perfiles.
Herramientas de organización
Para compilar y, luego, integrar estos agentes, puedes usar las siguientes herramientas:
- Protocolo de contexto del modelo (MCP) Un protocolo abierto y estandarizado para vincular agentes a recursos externos. Puedes configurar los agentes para que se conecten al catálogo con el servidor de MCP remoto o la caja de herramientas de MCP local. Para obtener más información, consulta Acerca del Protocolo de contexto del modelo (MCP) en Knowledge Catalog.
- Kit de desarrollo de agentes (ADK). Es un framework de Google que simplifica la compilación, la ejecución y las pruebas de agentes de IA generativa, y ofrece vinculaciones integradas a la API de Catalog Service. Para obtener más información, consulta la página principal de ADK.
- API de LookupContext. Un extremo de API de REST y gRPC que extrae una carga útil de contexto YAML o JSON unificada para los recursos de datos, lista para insertarse directamente en las instrucciones de LLM. Para obtener más información, consulta Recupera el contexto con la API de LookupContext.
Accede al contexto con MCP
El Protocolo de contexto del modelo (MCP) es un puente estandarizado que permite que los agentes y las herramientas de IA se conecten sin problemas a fuentes de datos como Knowledge Catalog. Usa la siguiente tabla de comparación para determinar la mejor opción para tu integración:
| Implementación | Ideal para | Detalles clave | Extremo o configuración |
|---|---|---|---|
| Servidor de MCP remoto | Implementaciones centradas en la nube, entornos sin servidores como Cloud Run y servicios externos administrados. | Es un extremo alojado en Google que no requiere administración de servidores locales. | Extremo: https://dataplex.googleapis.com/mcpPara configurarlo, consulta Usa un servidor de MCP remoto. |
| Caja de herramientas de MCP local | Desarrollo de agentes locales, creación rápida de prototipos y, además, integraciones de IDE de escritorio, como VS Code o Cursor. | Es una herramienta de línea de comandos que actúa como un proxy local entre tu entorno de Workspace y Knowledge Catalog. | Requiere la instalación de objetos binarios y la configuración de .mcp.json.Para realizar la configuración, consulta Usa un servidor de MCP local. |
Prácticas recomendadas para el contexto de datos de agentes
Para crear experiencias de agentes confiables, ten en cuenta las siguientes prácticas recomendadas cuando organices y consultes metadatos en Knowledge Catalog:
- Agrega aspectos. Los agentes de IA no pueden distinguir entre las tablas de producción oficiales y las simulaciones temporales de zona de pruebas solo por el nombre. Define y aplica un aspecto de indicador de confianza personalizado para certificar productos de datos autorizados, lo que ayuda a garantizar que los agentes prioricen o restrinjan las consultas a estos recursos.
- Optimiza las búsquedas con presupuestos de contexto. Cuando llames a la API de
LookupContext, especifica el parámetrocontext_budget. La API optimiza y ajusta primero los metadatos más importantes, como el linaje y las descripciones principales, dentro de las restricciones de tokens que especificaste. - Proporciona recursos relacionados para exponer rutas de unión. En tus consultas de contexto, enumera hasta 10 tablas o recursos relacionados. Proporcionar un grupo de recursos permite que el motor contextual complete automáticamente las rutas de unión y las relaciones, lo que ayuda al agente a comprender cómo se interconectan las tablas.
- Estructura glosarios semánticos. Estandarizar términos y abreviaturas en glosarios empresariales Esta estandarización ayuda a las herramientas conversacionales a resolver sinónimos y métricas específicos de la empresa con precisión.
- Publica consultas de referencia. Adjunta consultas en lenguaje natural verificadas y sus equivalentes en SQL correctos directamente a las entradas de Knowledge Catalog. Si fundamentas el razonamiento en estas plantillas verificadas, evitas errores de conversión de SQL en los agentes de texto a SQL.
Transición de Dataplex Universal Catalog a Knowledge Catalog
Dataplex Universal Catalog evolucionó a Knowledge Catalog. Para obtener más información sobre esta transición, consulta Transición de Dataplex Universal Catalog a Knowledge Catalog.
Limitaciones
Cuando planifiques tu implementación, ten en cuenta las siguientes limitaciones:
Integraciones admitidas. Si bien Knowledge Catalog admite los principales sistemas de terceros, algunas extracciones semánticas automatizadas podrían limitarse a los servicios integrados de Google Cloud .
Límites de cuota. Se aplican las cuotas de la API de Google Cloud estándar a las operaciones de recuperación de contexto y extracción de metadatos.
¿Qué sigue?
Acerca del contexto de los datos
Comprender cómo el contexto activo transforma los metadatos pasivos para fundamentar a los agentes de IA y evitar las alucinaciones
Establecer un contexto de datos fundamental
Crear un glosario empresarial, definir tipos de aspectos personalizados y enriquecer los recursos en BigQuery
Fundamenta las respuestas de los agentes con el MCP
Conecta agentes de IA y herramientas para desarrolladores a Knowledge Catalog con el Protocolo de contexto del modelo.
Buscar recursos
Busca y explora recursos del catálogo en Google Cloud y sistemas de terceros con lenguaje natural.
Automatiza los análisis de calidad de los datos
Define reglas de validación y supervisa la limpieza de los datos en las tablas con análisis de calidad automatizados.
Explorar casos de uso interactivos
Analiza soluciones del mundo real para el enriquecimiento de contexto, el linaje de datos y los flujos de trabajo de agentes.