


Knowledge Catalog (anteriormente, Dataplex Universal Catalog) facilita la comprensión y el análisis de tus datos, ya que genera perfiles automáticamente de tus tablas de BigQuery, Google Cloud Lakehouse Iceberg REST Catalog, SAP Business Data Cloud (BDC) Delta Lake y Hive.
La generación de perfiles es como obtener un informe de estado detallado de tus datos. Te brinda estadísticas clave, como valores comunes, cómo se distribuyen los datos (distribución) y cuántas entradas faltan (recuentos nulos). Esta información acelera tu análisis.
La generación de perfiles de datos recomienda reglas de verificación de la calidad de los datos para garantizar que tus datos sigan siendo confiables.
Modelo conceptual
Knowledge Catalog te permite comprender mejor el perfil de tus datos creando un análisis de perfil de datos. Un análisis de perfiles de datos es un tipo de análisis de datos de Knowledge Catalog que analiza una tabla de BigQuery, Google Cloud un catálogo de REST de Iceberg de Lakehouse, un Delta Lake de SAP BDC o una tabla de Hive para generar estadísticas.
En el siguiente diagrama, se muestra cómo Knowledge Catalog analiza los datos para informar sobre las características estadísticas.
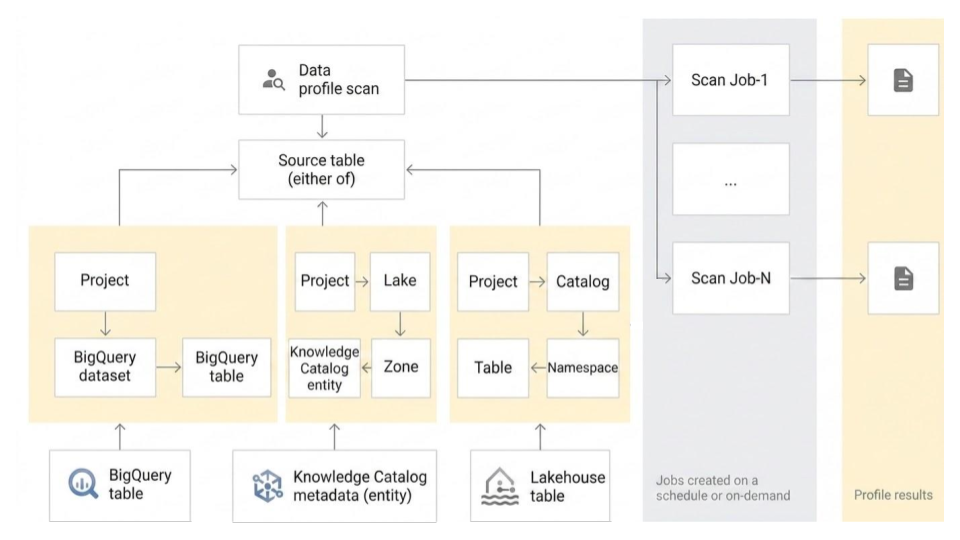
Un análisis de perfil de datos se asocia con una tabla de BigQuery, Google Cloud Lakehouse Iceberg REST Catalog, SAP BDC Delta Lake o Hive, y analiza la tabla para generar los resultados de la generación de perfiles de datos. Un análisis de perfil de datos admite varias opciones de configuración.
Opciones de configuración
En esta sección, se describen las opciones de configuración disponibles para ejecutar análisis de perfiles de datos.
Modos de generación de perfiles
Puedes elegir entre los siguientes modos de generación de perfiles:
Estándar: Este es el modo predeterminado. Proporciona un perfil completo y personalizable, ya que analiza tus datos según el muestreo y los filtros que especifiques. El modo estándar es adecuado para el análisis detallado y la supervisión a largo plazo de las características de los datos.
Ligero (versión preliminar): Este modo proporciona análisis de perfiles de baja latencia que devuelven resultados en segundos. Está optimizado para ofrecer velocidad y rentabilidad, y admitir casos de uso como los siguientes:
- Fundamenta las respuestas de los agentes de IA con características de datos inmediatas
- Genera perfiles de forma previa y rentable a gran escala para el descubrimiento de datos globales
- Proporcionar informes de estado rápidos durante la exploración interactiva de datos
El modo ligero tiene las siguientes limitaciones:
- A diferencia del modo de generación de perfiles estándar, no puedes modificar el alcance, los filtros ni el tamaño de muestreo en las exploraciones ligeras.
- No admite vistas ni tablas externas de BigQuery.
Opciones de programación
Puedes programar un análisis de perfil de datos con una frecuencia definida o ejecutarlo según demanda. Si un trabajo de análisis se ejecuta durante más tiempo del esperado, puedes cancelarlo.
Identidad de ejecución
De forma predeterminada, Knowledge Catalog usa un agente de servicio centralizado (service-PROJECT_NUMBER@gcp-sa-dataplex.iam.gserviceaccount.com) para ejecutar análisis de perfiles de datos.
También puedes anular esta identidad de ejecución predeterminada especificando una cuenta de servicio personalizada o usando tus propias credenciales de usuario final (EUC). Esto ofrece varios beneficios:
- Principio de privilegio mínimo: Otorga solo los permisos exactos de Identity and Access Management (IAM) necesarios para tareas específicas de generación de perfiles de datos a una cuenta de servicio dedicada, lo que minimiza el acceso con aprovisionamiento excesivo.
- Control de acceso detallado: Define el alcance de los permisos para recursos específicos, lo que permite la integración con las políticas de acceso a nivel de fila y de columna en BigQuery.
- Auditoría mejorada: Asigna cuentas de servicio o credenciales de usuario personalizadas a análisis específicos, lo que hace que el seguimiento y el registro de las actividades sean mucho más claros en los registros de auditoría.
- Unificación de la facturación: Cuando usas una identidad de ejecución personalizada, los cargos de procesamiento y almacenamiento se centralizan directamente en BigQuery (omitiendo los SKU de Knowledge Catalog Premium). Esto te permite aprovechar los descuentos empresariales y los compromisos de ranuras de BigQuery.
Para obtener instrucciones sobre cómo configurar una identidad de ejecución personalizada, consulta Configura la identidad de ejecución.
Requisitos de Herramientas de redes
Para ejecutar un análisis, debes habilitar el Acceso privado a Google en la subred de VPC que usas para el análisis. Si no especificas una subred, asegúrate de que la subred predeterminada tenga habilitado el Acceso privado a Google.
Alcance
En el caso de los análisis de creación de perfiles estándar, puedes especificar el alcance de los datos que se analizarán:
Tabla completa: Se analiza toda la tabla en el análisis de perfil de datos. El muestreo, los filtros de fila y los filtros de columna se aplican a toda la tabla antes de calcular las estadísticas de generación de perfiles.
Incremental: Los datos incrementales que especifiques se analizan en el análisis del perfil de datos. Especifica una columna
DateoTimestampen la tabla que se usará como incremento. Por lo general, esta es la columna en la que se particiona la tabla. El muestreo, los filtros de fila y los filtros de columna se aplican a los datos incrementales antes de calcular las estadísticas de generación de perfiles.
Filtra datos
En el caso de los análisis de creación de perfiles estándar, puedes filtrar los datos que se analizarán para la creación de perfiles con filtros de filas y de columnas. El uso de filtros te ayuda a reducir el tiempo de ejecución y el costo, y a excluir los datos sensibles y no necesarios. Los análisis de generación de perfiles ligeros no admiten filtros de columnas ni de filas.
Filtros de filas: Los filtros de filas te permiten enfocarte en los datos de un período específico o de un segmento específico, como la región. Por ejemplo, puedes filtrar los datos con una marca de tiempo anterior a una fecha determinada.
Filtros de columnas: Los filtros de columnas te permiten incluir y excluir columnas específicas de tu tabla para ejecutar el análisis de perfiles de datos.
Datos de muestra
En el caso de los análisis de perfiles estándar, puedes especificar un porcentaje de registros de tus datos para muestrear y ejecutar un análisis de perfiles de datos. Crear análisis de perfiles de datos en una muestra de datos más pequeña puede reducir el tiempo de ejecución y el costo de consultar todo el conjunto de datos.
Varios análisis del perfil de datos
Puedes crear varios análisis de perfiles de datos a la vez con la consola de Google Cloud . Puedes seleccionar hasta 100 tablas de un conjunto de datos y crear un análisis de perfil de datos para cada conjunto de datos. Para obtener más información, consulta Crea varios análisis de perfiles de datos.
Exporta los resultados del análisis a una tabla de BigQuery
Puedes exportar los resultados del análisis de perfiles de datos a una tabla de BigQuery para realizar un análisis más detallado. Para personalizar los informes, puedes conectar los datos de la tabla de BigQuery a un panel de Looker. Puedes crear un informe agregado con la misma tabla de resultados en varios análisis.
Resultados de la creación de perfiles de datos
Los resultados de la generación de perfiles de datos incluyen los siguientes valores:
| Tipo de columna | Resultados de la creación de perfiles de datos |
|---|---|
| Columna numérica |
|
| Columna de cadenas |
|
| Otras columnas no anidadas (fecha, hora, marca de tiempo, binario, etcétera) |
|
| Todas las demás columnas de tipo de datos anidados o complejos (como Record, Array, JSON) o cualquier columna con el modo repeated. |
|
Los resultados incluyen la cantidad de registros analizados en cada trabajo.
Generación de informes y supervisión
Puedes supervisar y analizar los resultados de la generación de perfiles de datos con los siguientes informes y métodos:
Informes publicados con la tabla de origen en las páginas de BigQuery y Knowledge Catalog
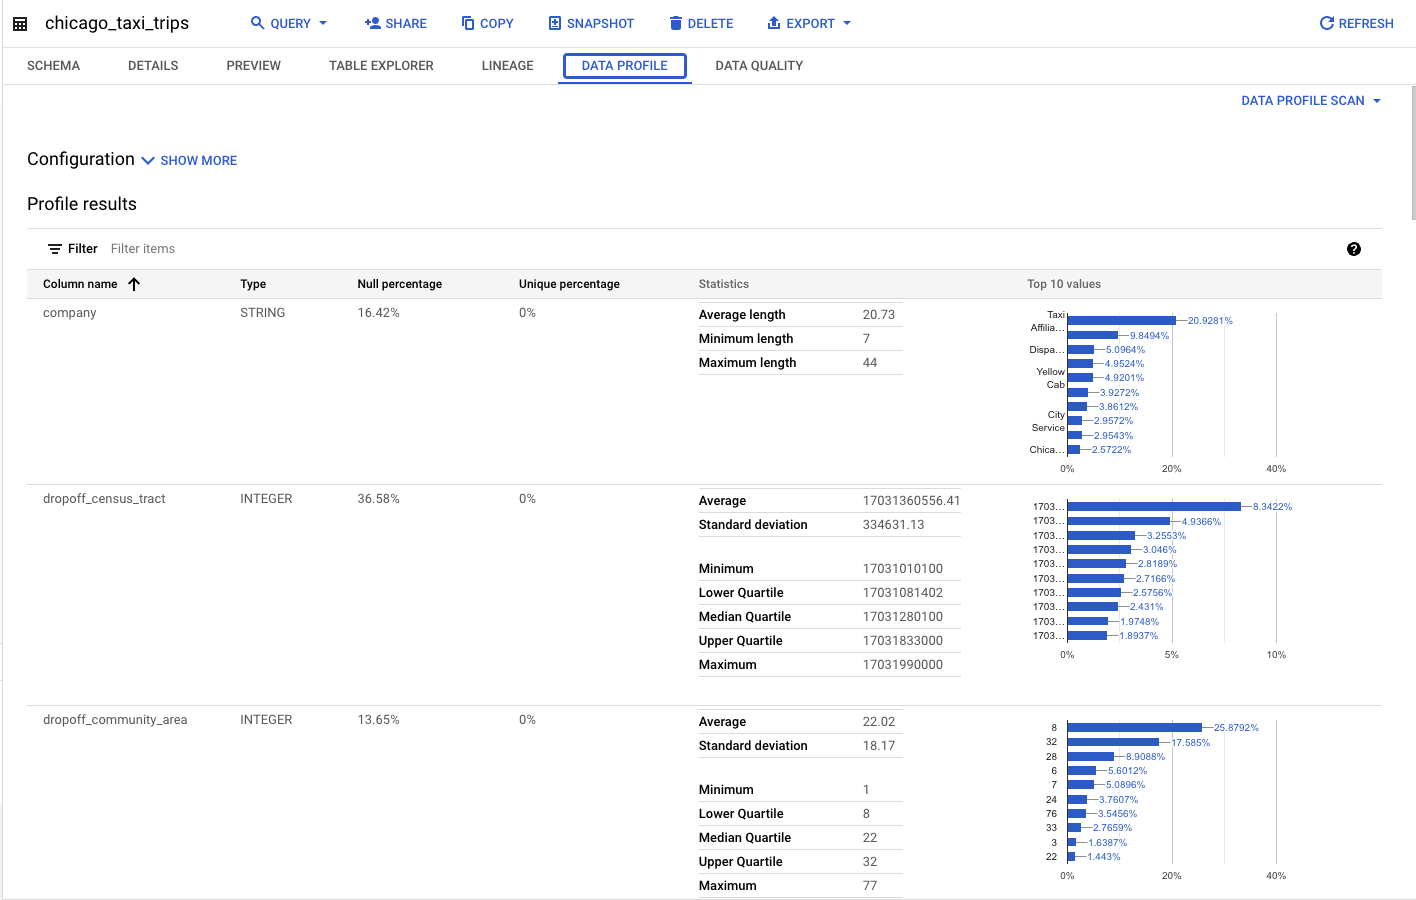
Si configuras un análisis de perfil de datos para publicar los resultados en BigQuery y Knowledge Catalog, puedes ver los resultados más recientes del análisis de perfil de datos en la pestaña Perfil de datos de la tabla de origen en BigQuery y Knowledge Catalog. Se puede acceder a estos resultados desde cualquier proyecto.
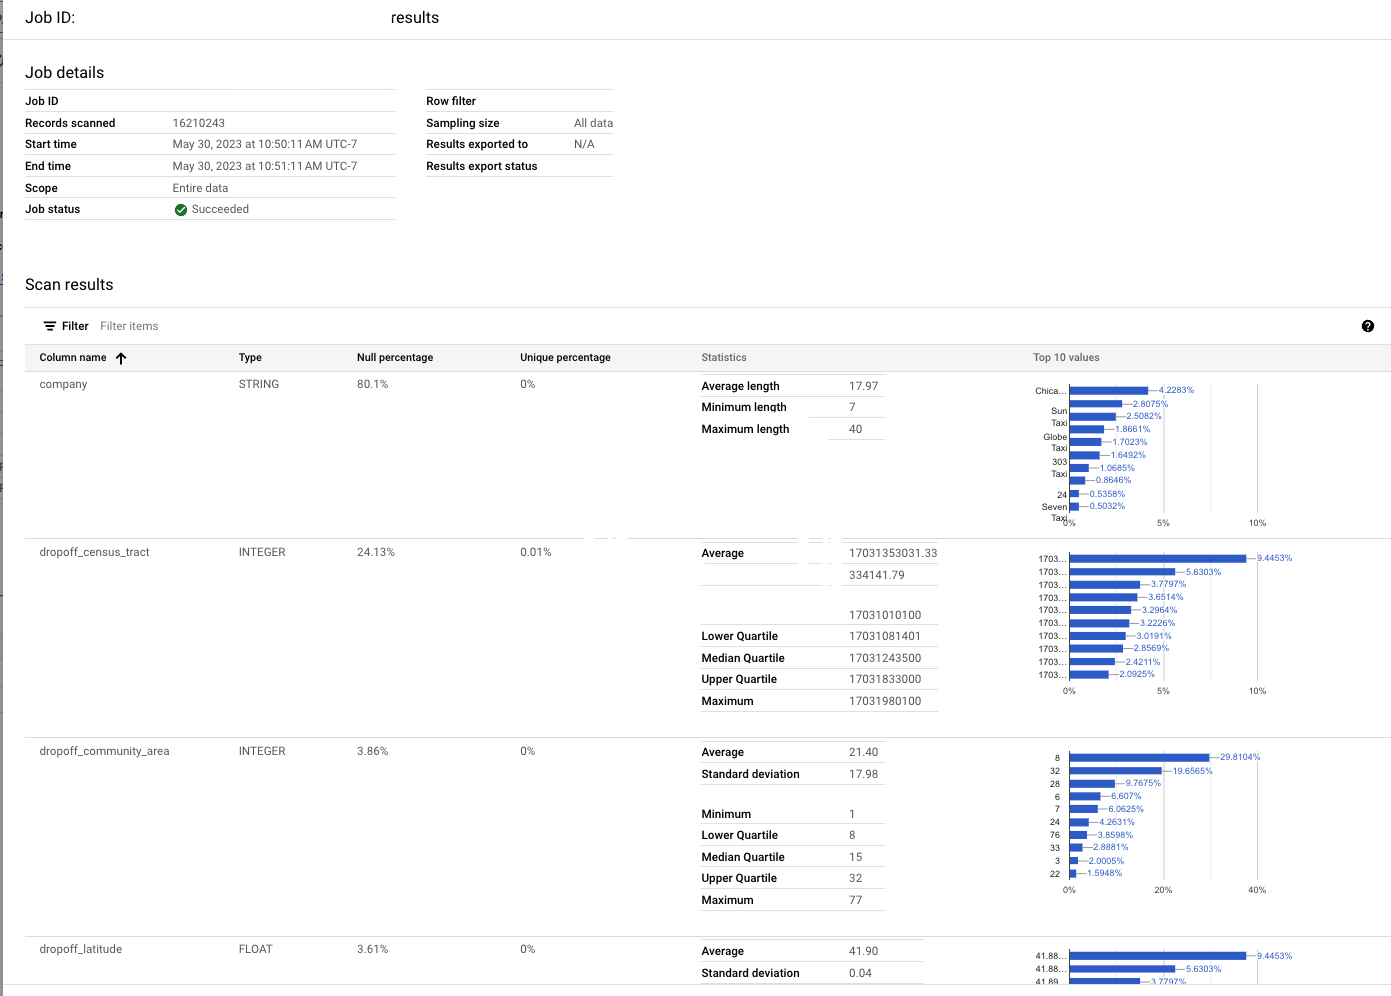
Informe histórico por trabajo
En la página Calidad y creación de perfiles de datos > Análisis del perfil de datos de Knowledge Catalog y BigQuery, puedes ver los informes de detalles de los trabajos más recientes y los históricos. Esto incluye información del perfil a nivel de columna y la configuración que se usó.
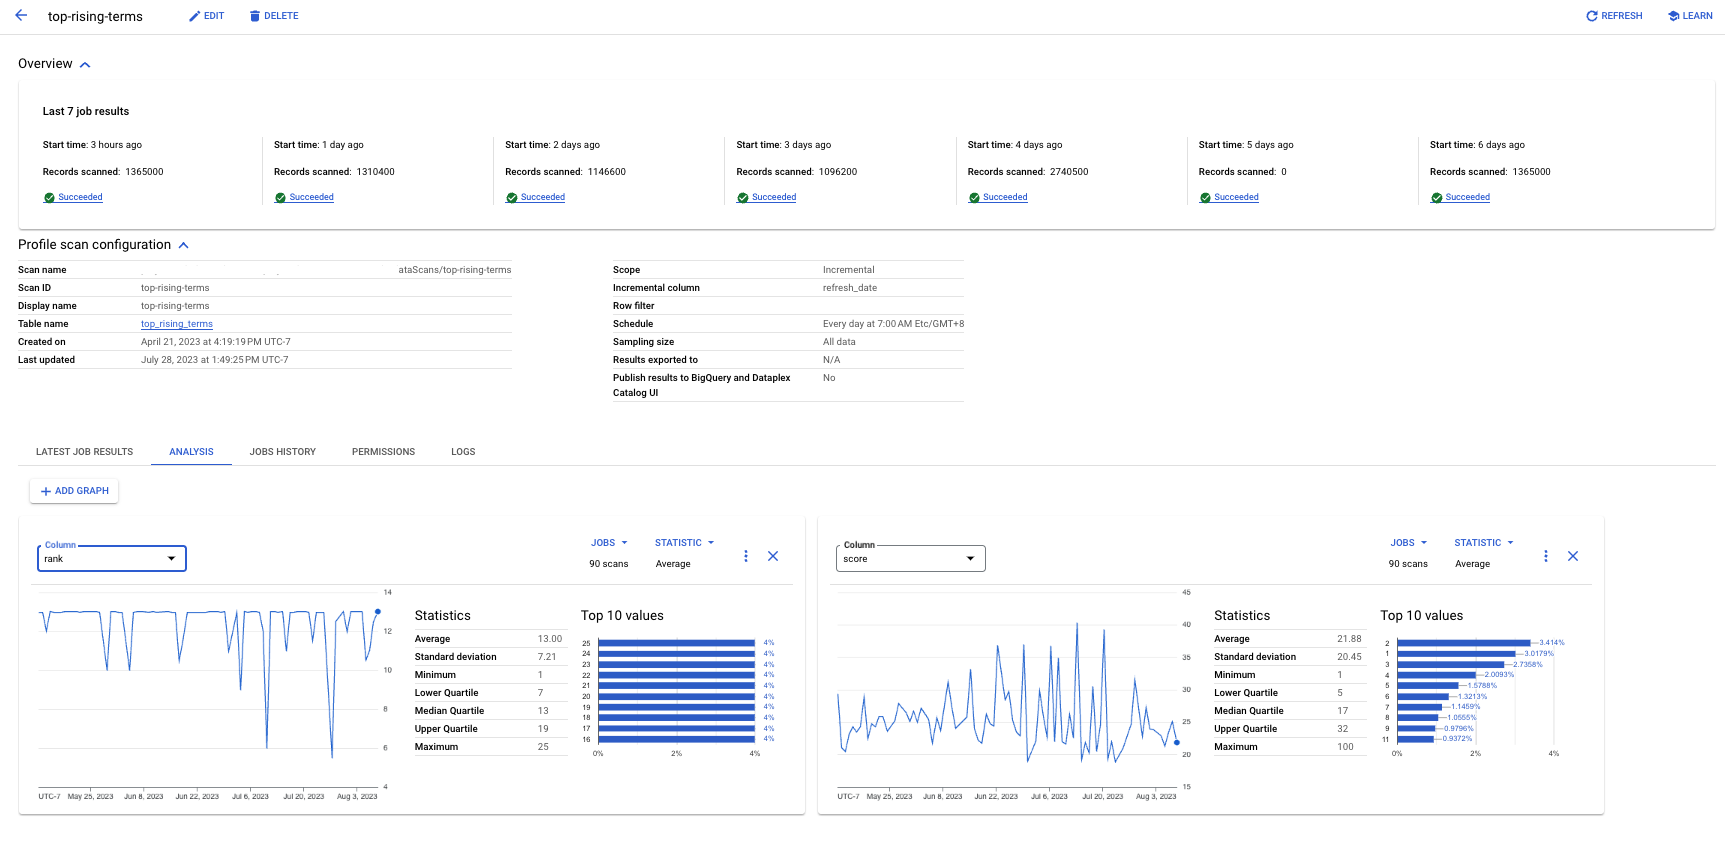
Pestaña Análisis
En la página Generación de perfiles y calidad de los datos > Análisis de perfiles de datos de Knowledge Catalog y BigQuery, puedes usar la pestaña Análisis para ver las tendencias de una estadística determinada de una columna en varios trabajos de perfiles. Por ejemplo, si tienes un análisis incremental, puedes ver cómo ha evolucionado el promedio de un valor con el tiempo.
Crea tu propio panel o estadísticas
Si configuraste un análisis de perfil de datos para exportar resultados a una tabla de BigQuery, puedes crear tus propios paneles con herramientas, como Data Studio.
Supervisa los costos de procesamiento de DCU en la Facturación de Cloud
El procesamiento de análisis del perfil de datos se ejecuta en una infraestructura sin servidores y no emite métricas de series temporales a Cloud Monitoring. Para hacer un seguimiento de los costos de DCU de la creación de perfiles de datos y atribuirlos por proyecto, ID de análisis o tabla, consulta la exportación de la Facturación de Cloud en BigQuery con las etiquetas del sistema
goog-dataplex-datascan-*. Para obtener más información, consulta Supervisa y atribuye los costos de DCU de Dataplex con la exportación de Facturación de Cloud.
Limitaciones
- Solo puedes ejecutar análisis de perfiles de datos en tablas de BigQuery, Google Cloud Lakehouse Iceberg REST Catalog, SAP BDC Delta Lake y Hive.
- La generación de perfiles de datos es compatible con las tablas de BigQuery con todos los tipos de columnas,
excepto
BIGNUMERIC. Un análisis creado para una tabla con una columnaBIGNUMERICgenera un error de validación y no se crea correctamente. - No se admiten varios análisis de perfiles de datos para las tablas de Lakehouse.
Precios
- Para obtener más información sobre los precios, consulta Precios de Knowledge Catalog.
- Para hacer un seguimiento y atribuir el uso y los costos de DCU de análisis del perfil de datos con la exportación de Facturación de Cloud a BigQuery, consulta Supervisa y atribuye los costos de DCU de Dataplex con la exportación de Facturación de Cloud.
¿Qué sigue?
- Obtén más información para usar la generación de perfiles de datos.
- Para obtener más información sobre los recursos de Terraform disponibles para crear análisis de perfiles de datos, consulta lo siguiente:
- Recurso de análisis de datos de Knowledge Catalog en el registro de Terraform.
- La documentación del recurso de análisis de datos de Knowledge Catalog en GitHub, que admite la configuración de reglas basada en YAML.
- Obtén más información sobre la calidad de los datos automática.
- Obtén más información para usar la calidad de los datos automática.
- Aprende a explorar tus datos y generar estadísticas de ellos.