


Le attività di qualità dei dati di Knowledge Catalog ti consentono di definire regole basate su YAML per convalidare le tabelle in BigQuery e Cloud Storage senza gestire l'infrastruttura. Puoi pianificare i controlli per applicare controlli relativi ai dati regolari negli ambienti BigQuery, monitorare i set di dati nelle pipeline di produzione e creare report per i requisiti normativi.
Quando creare attività relative alla qualità dei dati di Knowledge Catalog
Le attività di qualità dei dati di Knowledge Catalog possono aiutarti a:
- Convalidare i dati nell'ambito di una pipeline di produzione dei dati.
- Monitora regolarmente la qualità dei set di dati rispetto alle tue aspettative.
- Crea report sulla qualità dei dati per i requisiti normativi.
Vantaggi
- Specifiche personalizzabili. Puoi utilizzare la sintassi YAML altamente flessibile per dichiarare le regole di qualità dei dati.
- Implementazione serverless. Knowledge Catalog non richiede alcuna configurazione dell'infrastruttura.
- Zero-copy e pushdown automatico. I controlli YAML vengono convertiti in SQL e inviati a BigQuery, senza alcuna copia dei dati.
- Controlli della qualità dei dati pianificabili. Puoi pianificare i controlli di qualità dei dati tramite lo scheduler serverless in Knowledge Catalog o utilizzare l'API Dataplex tramite scheduler esterni come Managed Airflow per l'integrazione della pipeline.
- Esperienza gestita. Knowledge Catalog utilizza un motore di qualità dei dati open source, CloudDQ, per eseguire i controlli della qualità dei dati. Tuttavia, Knowledge Catalog offre un'esperienza gestita senza interruzioni per eseguire i controlli di qualità dei dati.
Come funzionano le attività relative alla qualità dei dati
Il seguente diagramma mostra come funzionano le attività relative alla qualità dei dati di Knowledge Catalog:
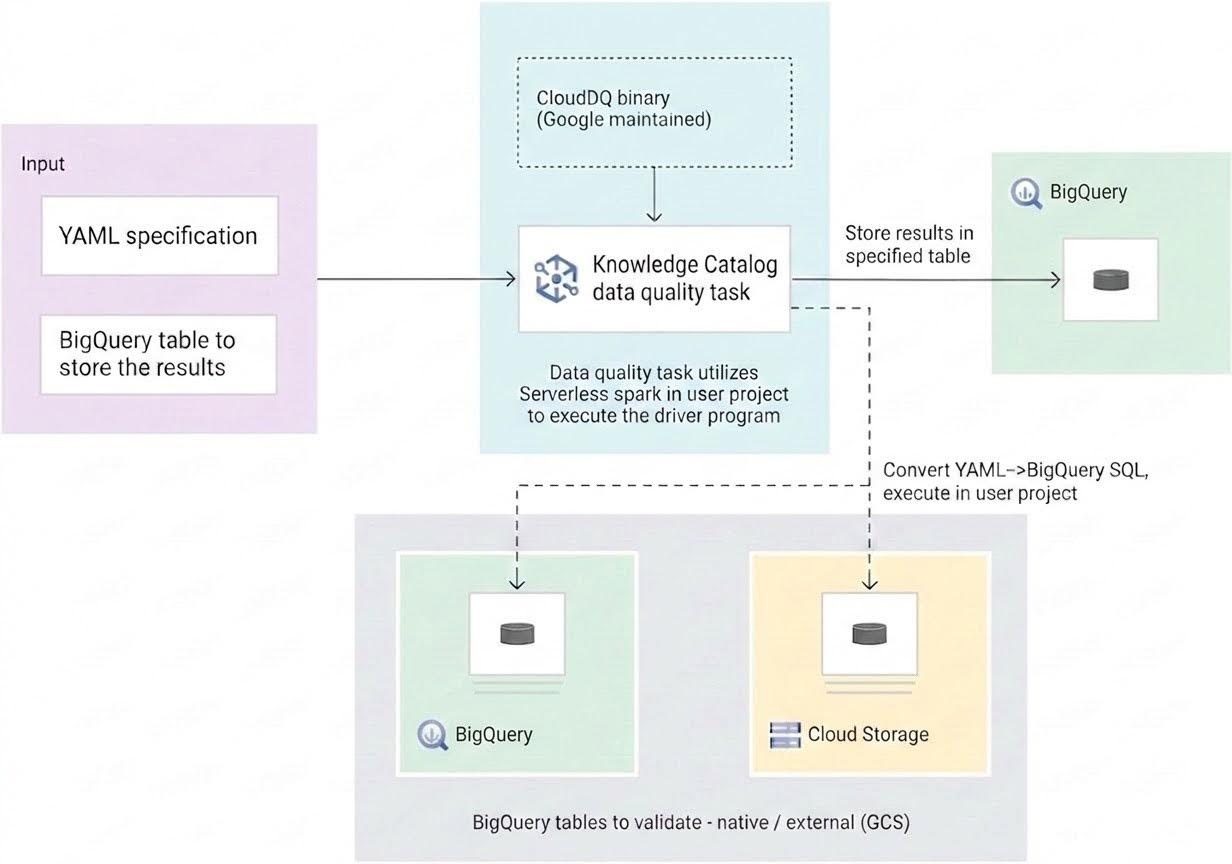
- Input degli utenti
- Specifica YAML: un insieme di uno o più file YAML che definiscono le regole di qualità dei dati in base alla sintassi della specifica. I file YAML vengono archiviati in un bucket Cloud Storage nel tuo progetto. Gli utenti possono eseguire più regole contemporaneamente e queste regole possono essere applicate a diverse tabelle BigQuery, incluse tabelle di set di dati o progetti Google Clouddiversi. La specifica supporta le esecuzioni incrementali solo per la convalida dei nuovi dati. Per creare una specifica YAML, consulta Crea un file di specifica.
- Tabella dei risultati di BigQuery: una tabella specificata dall'utente in cui vengono archiviati i risultati della convalida della qualità dei dati. Il progetto Google Cloud in cui si trova questa tabella può essere diverso da quello in cui viene utilizzata l'attività di qualità dei dati di Knowledge Catalog.
- Tabelle da convalidare
- All'interno della specifica YAML, devi specificare quali tabelle vuoi convalidare per quali regole, operazione nota anche come associazione di regole. Le tabelle possono essere tabelle native di BigQuery o tabelle esterne di BigQuery in Cloud Storage. La specifica YAML consente di specificare le tabelle all'interno o all'esterno di una zona di Knowledge Catalog.
- Le tabelle BigQuery e Cloud Storage convalidate in una singola esecuzione possono appartenere a progetti diversi.
- Attività di qualità dei dati di Knowledge Catalog: un'attività di qualità dei dati di Knowledge Catalog è configurata con un file binario PySpark CloudDQ predefinito e gestito e accetta come input la specifica YAML e la tabella dei risultati di BigQuery. Analogamente ad altre attività di Knowledge Catalog, l'attività di qualità dei dati di Knowledge Catalog viene eseguita in un ambiente Spark serverless, converte la specifica YAML in query BigQuery e poi esegue queste query sulle tabelle definite nel file di specifica.
Prezzi
Quando esegui le attività di qualità dei dati di Knowledge Catalog, ti vengono addebitati i costi di utilizzo di BigQuery e Managed Service for Apache Spark (batch).
L'attività di qualità dei dati di Knowledge Catalog converte il file di specifiche in query BigQuery e le esegue nel progetto utente. Consulta i prezzi di BigQuery.
Knowledge Catalog utilizza Spark per eseguire il programma driver CloudDQ open source predefinito e gestito da Google per convertire la specifica dell'utente in query BigQuery. Consulta i prezzi di Managed Service for Apache Spark.
Non sono previsti addebiti per l'utilizzo di Knowledge Catalog per organizzare i dati o per l'utilizzo dello scheduler serverless in Knowledge Catalog per pianificare i controlli di qualità dei dati. Consulta i prezzi di Knowledge Catalog.