


在分散式串流管道中,單靠匯總指標可能難以找出造成延遲尖峰的特定階段、外部服務呼叫或工作者隨機播放。在 Dataflow 中使用 OpenTelemetry 分散式追蹤功能,即可在單一追蹤 ID 下,跨管道轉換、網路界線和整合式服務,追蹤個別元素端對端的情況。這項資訊可協助您找出效能瓶頸、盡可能提高管道執行成本效益,以及排解複雜的串流工作負載問題。
請使用下列資訊,在 Apache Beam 管道中啟用、設定及使用 OpenTelemetry 分散式追蹤。
用途
Dataflow 中的分散式追蹤功能在下列情境中特別實用:
- 串流工作負載:追蹤每個元素的處理時間,並找出造成延遲或延遲尖峰的階段。
- 使用者程式碼中的外部服務呼叫追蹤:在管道呼叫使用者程式碼 (例如
DoFn內) 中的外部資料庫、微服務或生成式 AI API 時,測量執行時間。舉例來說,您可以測量呼叫外部資料庫 (例如 Spanner 或 Bigtable)、微服務 (使用 HTTP 或 gRPC) 或生成式 AI API (例如 Gemini) 的時間。詳情請參閱「在 DoFn 中編寫自訂追蹤記錄」和「與用戶端程式庫整合」。 - 成本和效能最佳化:在實際負載下,顯示
PTransform執行個體中特定作業的持續時間,找出效率不彰的序列化、緩慢的查詢或背景工作執行緒爭用。 - 複雜的代理和工作流程管道:深入瞭解管道,包括多個分支、疊代代理迴圈和聯結,判斷哪個轉換或分支耗時最長。
限制
Dataflow 中的分散式追蹤功能有下列限制:
- 這項功能僅適用於串流管道,且已通過驗證。
- 如要使用這項功能,必須採用 Beam SDK for Java (2.76.0 以上版本)。
- 跨階段環境傳播需要 Streaming Java Runner (先前稱為 Runner v1)。可攜式 Runner (舊稱「Runner v2」) 會在重組邊界重設追蹤記錄相關資訊。
- Beam I/O 連接器內建的 OpenTelemetry 追蹤功能僅支援下列連接器:Pub/Sub、Apache Kafka 和 Spanner 變更串流。如果是 Apache Kafka,只有直接使用
KafkaIO連接器時,系統才會支援追蹤功能。使用 Kafka 的代管 I/O 時,系統不支援這項功能。其他 I/O 連接器 (例如BigtableIO) 沒有內建的連接器追蹤功能;如要追蹤這些服務的操作,請在使用者程式碼中 (例如在DoFn中) 檢測呼叫。 - 將多個元素合併為一個元素的操作不會傳播單一追蹤記錄相關資訊。包括
GroupByKey、CoGroupByKey和Combine等作業。 - 設定計時器 (
Timer.set()) 和執行@OnTimer回呼方法之間,不會傳播內容。
必要條件
如要在 Dataflow 中使用分散式追蹤,請確保環境符合下列規定:
- 職缺必須符合下列規定:
- 是串流管道
- 使用 Streaming Java Runner (先前稱為 Runner v1)
- 使用 Apache Beam Java SDK 2.76.0 以上版本
如果將追蹤記錄匯出至 Cloud Trace,請在專案中啟用 Telemetry API (
telemetry.googleapis.com)。 Google Cloud啟用 API 時所需的角色
如要啟用 API,您必須具備
serviceusage.services.enable權限。如果您建立了專案,可能已透過「擁有者」角色 (roles/owner) 取得這項權限。否則,您可以透過「服務使用管理員」角色 (roles/serviceusage.serviceUsageAdmin) 取得這項權限。瞭解如何授予角色。工作人員服務帳戶必須具備 Cloud Trace 代理者 (
roles/cloudtrace.agent) 角色,其中包含cloudtrace.traces.patch權限。
核心概念
分散式追蹤功能會用到下列 OpenTelemetry 概念:
- 追蹤記錄
- 代表完整交易或工作流程在分散式系統中的流動情形。追蹤記錄包含一或多個範圍。
- 時距
- 追蹤記錄的基本構成元素,代表單一工作單元。例如轉換執行、方法呼叫或 RPC 要求。
- 背景資訊
- 這個狀態會跨執行緒和 API 邊界傳播。包括追蹤記錄 ID 和時距 ID。
- Propagator
- 用於在網路界線之間注入及擷取脈絡表示法的機制。例如 W3C 追蹤記錄相關資訊。
- 出口商
- 這個元件會將收集到的時距資料傳送至追蹤後端,例如 Cloud Trace 或自行代管的 OpenTelemetry Collector。
- 取樣器
- 這項機制會決定要記錄及匯出哪些追蹤記錄,藉此控管追蹤記錄量。例如 1% 的取樣率。
啟用 OpenTelemetry 追蹤功能
如要使用預設設定啟用 OpenTelemetry 追蹤,請在提交工作時設定必要的管道選項和實驗。預設設定會匯出至 Cloud Trace,並採用 1% 的取樣率。
如要修改預設值,請參閱「設定及修改追蹤屬性」。
執行工作時,請設定管道選項和實驗。
非 Flex 範本工作
提交工作時,請傳遞下列實驗旗標:
--experiments=enable_otel_defaults,element_metadata_supported,disable_portable_worker
Flex 範本工作
在
gcloud指令中,使用--additional-experiments旗標傳遞實驗:gcloud dataflow flex-template run JOB_NAME \ --template-file-gcs-location=gs://BUCKET_NAME/templates/TEMPLATE_NAME.json \ --additional-experiments="enable_otel_defaults,element_metadata_supported,disable_portable_worker" \ --region=REGION更改下列內容:
- JOB_NAME:Dataflow 工作的名稱。
- BUCKET_NAME:包含範本的 Cloud Storage bucket。
- TEMPLATE_NAME:Flex 範本檔案的名稱。
- REGION:要執行工作的 Google Cloud 區域。
這些實驗會設定下列行為:
enable_otel_defaults:設定標準 OpenTelemetry 預設值,包括 Cloud Trace 匯出工具和 1% 的取樣率。element_metadata_supported:啟用中繼資料 (例如追蹤記錄相關資訊) 的序列化和傳播,跨管道階段。disable_portable_worker:強制使用 Dataflow Streaming Java Runner (先前稱為 Runner v1)。
如果您使用 Beam SDK for Java 2.76.0 或 2.77.0 版,請在建構設定中新增必要的 OpenTelemetry 依附元件。
由於 2.76.0 和 2.77.0 版有問題,您必須在
pom.xml檔案中新增下列依附元件,才能匯出追蹤記錄。詳情請參閱「管理管道依附元件」。<dependency> <groupId>io.opentelemetry</groupId> <artifactId>opentelemetry-sdk-extension-autoconfigure</artifactId> <scope>compile</scope> </dependency> <dependency> <groupId>io.opentelemetry</groupId> <artifactId>opentelemetry-exporter-otlp</artifactId> <version>1.62.0</version> <scope>compile</scope> </dependency> <dependency> <groupId>org.apache.beam</groupId> <artifactId>beam-sdks-java-extensions-opentelemetry-gcp-auth-extension</artifactId> <scope>compile</scope> </dependency>在管道程式碼中,針對支援的 I/O 連接器明確啟用 OpenTelemetry 追蹤:
Pub/Sub
如要在從 Pub/Sub 讀取或寫入資料時啟用追蹤功能,請按照下列步驟操作:
// Reading from Pub/Sub
pipeline.apply("ReadFromPubSub",
    PubsubIO.readMessages()
        .withEnableOpenTelemetryTracing()
        .fromSubscription("projects/PROJECT_ID/subscriptions/SUBSCRIPTION_ID"));

// Writing to Pub/Sub
pipeline.apply("WriteToPubSub",
    PubsubIO.writeStrings()
        .withEnableOpenTelemetryTracing()
        .to("projects/PROJECT_ID/topics/TOPIC_ID"));
更改下列內容:
- PROJECT_ID:專案的 ID。 Google Cloud
- SUBSCRIPTION_ID:Pub/Sub 訂閱項目名稱。
- TOPIC_ID:Pub/Sub 主題的名稱。
脈絡傳播詳細資料:
- 上游發布者:從外部應用程式發布訊息時,請將 W3C 追蹤脈絡插入 Pub/Sub 訊息屬性。詳情請參閱「Pub/Sub OpenTelemetry 追蹤」。
- 屬性:Beam 會預期並填入下列屬性:
googclient_traceparent:攜帶 W3Ctraceparent標頭。googclient_tracestate:攜帶 W3Ctracestate標頭。
- 如需標頭格式設定,請參閱 W3C 追蹤內容規格。
Apache Kafka
如要在從 Apache Kafka 讀取或寫入資料時啟用追蹤功能,請按照下列步驟操作:
// Reading from Kafka
pipeline.apply("ReadFromKafka",
    KafkaIO.<String, String>read()
        .withEnableOpenTelemetryTracing()
        // ... additional configuration
        );

// Writing to Kafka
pipeline.apply("WriteToKafka",
    KafkaIO.<String, String>write()
        .withEnableOpenTelemetryTracing()
        // ... additional configuration
        );
脈絡傳播詳細資料:
KafkaIO使用標準 Kafka 記錄標頭傳播內容。- 系統會預期並插入符合 W3C 追蹤內容規格的標頭:
traceparent:識別傳入的追蹤記錄相關資訊。tracestate:提供額外的廠商專屬轉送和篩選中繼資料。
Spanner
如要在從 Spanner 變更串流讀取資料時啟用追蹤功能,請按照下列步驟操作:
pipeline.apply("ReadChangeStream",
    SpannerIO.readChangeStream()
        .withSpannerConfig(spannerConfig)
        .withEnableOpenTelemetryTracing(true)
        .withChangeStreamName("CHANGE_STREAM_NAME"));
更改下列內容:
- CHANGE_STREAM_NAME:Spanner 變更串流的名稱。
建立時距的詳細資料:
- 啟用追蹤功能後,變更資料擷取 (CDC) 讀取器讀取的每筆資料庫變動記錄,都會啟動新的追蹤記錄和範圍。
- 如果 Spanner 讀取器輪詢週期未傳回任何新記錄,也可能會產生追蹤範圍,可在 Cloud Trace 使用者介面中篩除。
設定及修改追蹤屬性
指定 enable_otel_defaults 時,Dataflow 會套用下列預設屬性:
| 屬性 | 預設值 | 說明 |
|---|---|---|
otel.traces.exporter |
otlp |
使用 OpenTelemetry Protocol (OTLP) 匯出追蹤記錄。 |
otel.exporter.otlp.endpoint |
https://telemetry.googleapis.com |
以 Cloud Trace OTLP 接收器為目標。 |
google.cloud.project |
您的專案 ID | 儲存追蹤記錄的 Google Cloud 專案。 |
otel.traces.sampler.arg |
0.01 (1%) |
每 100 個追蹤記錄中,會記錄 1 個。 |
otel.service.name |
options.getAppName() |
與時距相關聯的服務名稱,衍生自管道 appName 選項。 |
如要自訂 OpenTelemetry 設定,請將以半形分號分隔的屬性清單傳遞至 --openTelemetryProperties 管道選項。
以下範例會明確設定所有預設屬性:
--openTelemetryProperties="otel.traces.exporter=otlp;otel.exporter.otlp.endpoint=https://telemetry.googleapis.com;google.cloud.project=PROJECT_ID;otel.traces.sampler.arg=0.01;otel.service.name=CUSTOM_SERVICE_NAME;otel.java.global-autoconfigure.enabled=true"
設定自訂服務名稱
根據預設,追蹤服務名稱衍生自管道 appName 選項 (--appName=YourPipelineName)。您可以設定 otel.service.name 屬性來覆寫這個值:
--openTelemetryProperties="otel.service.name=CUSTOM_SERVICE_NAME"
變更取樣率和屬性
設定較高的取樣率可取得更完善的追蹤資訊。不過,高取樣率 (例如 1.0 或 always_on) 會大幅增加傳送至 Cloud Trace 的追蹤資料量,進而提高 Google Cloud 費用。僅在短期偵錯時使用高取樣率,並降低正式環境工作負載的取樣率。
以下範例會明確設定取樣率。在這種情況下,您必須提供完整的引數清單:
--openTelemetryProperties="otel.traces.exporter=otlp;otel.exporter.otlp.endpoint=https://telemetry.googleapis.com;google.cloud.project=PROJECT_ID;otel.traces.sampler.arg=0.02;otel.service.name=CUSTOM_SERVICE_NAME;otel.java.global-autoconfigure.enabled=true"
匯出至第三方後端
如要將追蹤記錄傳送至外部代管追蹤記錄後端或自行代管的 OpenTelemetry Collector,而非 Cloud Trace,請按照下列步驟操作:
- 省略下列實驗:
--experiments=enable_otel_defaults。 使用
--openTelemetryProperties手動設定匯出工具屬性:--openTelemetryProperties="otel.traces.exporter=otlp;otel.exporter.otlp.endpoint=http://COLLECTOR_HOST:4317;otel.traces.sampler=parentbased_always_on"
Google Cloud 驗證擴充功能
Beam 執行階段包含 Google Cloud 驗證擴充功能,可自動驗證傳送至 Google API (例如 telemetry.googleapis.com) 的 OpenTelemetry Protocol (OTLP) 要求。
- 使用預設值時:系統會自動啟用驗證功能。 Google Cloud
- 匯出至非 Google 端點時:如果省略
enable_otel_defaults,Beam 會設定系統屬性google.otel.auth.target.signals=none,停用 Google Cloud 驗證擴充功能。 - 手動設定:您可以將
google.otel.auth.target.signals系統屬性設為none(停用) 或trace(僅針對追蹤啟用)。
在 DoFn 中撰寫自訂追蹤記錄
您可以在使用者程式碼 (例如 DoFn 內) 建立自訂範圍,藉此評估特定作業。包括呼叫外部 API 或耗用大量運算資源的邏輯。
DoFn 實作範例
import io.opentelemetry.api.trace.Span;
import io.opentelemetry.api.trace.StatusCode;
import io.opentelemetry.api.trace.Tracer;
import io.opentelemetry.context.Scope;
import org.apache.beam.sdk.options.PipelineOptions;
import org.apache.beam.sdk.options.SdkHarnessOptions;
import org.apache.beam.sdk.transforms.DoFn;

public class InvestigateTransactionDoFn extends DoFn<Transaction, RiskAssessment> {
  private transient Tracer tracer;

  @Setup
  public void setup(PipelineOptions options) {
    // Obtain the Tracer instance from SdkHarnessOptions
    this.tracer = options
        .as(SdkHarnessOptions.class)
        .getOpenTelemetry()
        .getTracer("org.apache.beam.examples.adk.aml");
  }

  @ProcessElement
  public void processElement(@Element Transaction tx, OutputReceiver<RiskAssessment> out) {
    // Create and start a custom span as a child of the active context
    Span span = tracer.spanBuilder("InvestigateTransactionDoFn:Analyze")
        .setAttribute("transaction.id", tx.getId())
        .setAttribute("transaction.amount", tx.getAmount())
        .startSpan();

    // Make the span current in the execution thread
    try (Scope scope = span.makeCurrent()) {
      // Perform your logic (such as calling an external service)
      RiskAssessment assessment = analyzeTransactionWithLLM(tx);
      out.output(assessment);
    } catch (Exception e) {
      // Record exception details and set error status on the span
      span.recordException(e);
      span.setStatus(StatusCode.ERROR, e.getMessage());
      throw e;
    } finally {
      // Always end the span
      span.end();
    }
  }

  private RiskAssessment analyzeTransactionWithLLM(Transaction tx) {
    // Application analysis logic
    return new RiskAssessment();
  }
}
整合用戶端程式庫
如果 DoFn 叫用也支援 OpenTelemetry 的外部程式庫 (例如 Google Cloud 用戶端程式庫),請設定用戶端使用管道的 OpenTelemetry 執行個體,以便子項範圍直接連結至管道追蹤記錄。
Spanner Java 用戶端範例
如要在 DoFn 中執行手動 Spanner 查詢,並將這些範圍連結至有效的管道追蹤記錄,請使用管道的 OpenTelemetry 例項初始化 SpannerOptions:
import com.google.cloud.spanner.DatabaseClient;
import com.google.cloud.spanner.DatabaseId;
import com.google.cloud.spanner.ResultSet;
import com.google.cloud.spanner.Spanner;
import com.google.cloud.spanner.SpannerOptions;
import com.google.cloud.spanner.Statement;
import org.apache.beam.sdk.options.PipelineOptions;
import org.apache.beam.sdk.options.SdkHarnessOptions;
import org.apache.beam.sdk.transforms.DoFn;

public class SpannerEnrichmentDoFn extends DoFn<String, String> {
  private transient Spanner spanner;
  private transient DatabaseClient dbClient;
  private final String instanceId;
  private final String databaseId;

  public SpannerEnrichmentDoFn(String instanceId, String databaseId) {
    this.instanceId = instanceId;
    this.databaseId = databaseId;
  }

  @Setup
  public void setup(PipelineOptions pipelineOptions) {
    // Build SpannerOptions leveraging the pipeline's active OpenTelemetry instance
    SpannerOptions options =
        SpannerOptions.newBuilder()
            .setOpenTelemetry(pipelineOptions
                .as(SdkHarnessOptions.class)
                .getOpenTelemetry())
            .setEnableEndToEndTracing(true)
            .setEnableExtendedTracing(true)
            .build();

    this.spanner = options.getService();
    DatabaseId db = DatabaseId.of(options.getProjectId(), instanceId, databaseId);
    this.dbClient = spanner.getDatabaseClient(db);
  }

  @ProcessElement
  public void processElement(@Element String inputId, OutputReceiver<String> out) {
    Statement statement = Statement.newBuilder(
        "SELECT Details FROM AccountTable WHERE AccountId = @id")
        .bind("id").to(inputId)
        .build();

    // Spanner queries automatically generate child spans linked to the active trace
    try (ResultSet rs = dbClient.singleUse().executeQuery(statement)) {
      while (rs.next()) {
        out.output(rs.getString("Details"));
      }
    }
  }

  @Teardown
  public void tearDown() {
    if (spanner != null) {
      spanner.close();
    }
  }
}
跨階段的情境傳播
在分散式資料管道中,跨工作站界線和重組作業傳輸追蹤內容,對於端對端可視性至關重要。
將 Redistribute.arbitrarily() 插入管道後,系統會將有效追蹤內容序列化為元素中繼資料,透過網路傳輸,並在接收端 worker VM 上還原序列化。確保追蹤作業在各階段都能持續進行。
以下範例說明追蹤記錄相關資訊如何在管道階段之間傳播:
- 擷取脈絡:
KafkaIO.read()會讀取傳入的記錄,並從訊息標頭擷取追蹤記錄相關資訊。 - 處理及建立範圍:
DoFn A會處理有效追蹤範圍內的元素。 - 在 worker 之間傳播:
Redistribute.arbitrarily()將有效追蹤記錄相關資訊序列化至元素中繼資料,並在網路中重組元素。 - 繼續追蹤記錄:
DoFn B會在 worker VM 上接收元素、還原序列化追蹤記錄相關資訊,並在相同追蹤記錄 ID 下繼續處理。
在 Cloud Trace 中查看追蹤記錄
啟用追蹤功能後,請在 Google Cloud 控制台中查看管道追蹤記錄:
前往 Google Cloud 控制台的「Trace Explorer」頁面。
在篩選方塊中,依
Service: SERVICE_NAME篩選。 這個 SERVICE_NAME 與管道appName或已設定的otel.service.name相符。你也可以搜尋特定追蹤記錄 ID。
從結果清單中選取追蹤記錄,即可查看詳細時間軸。
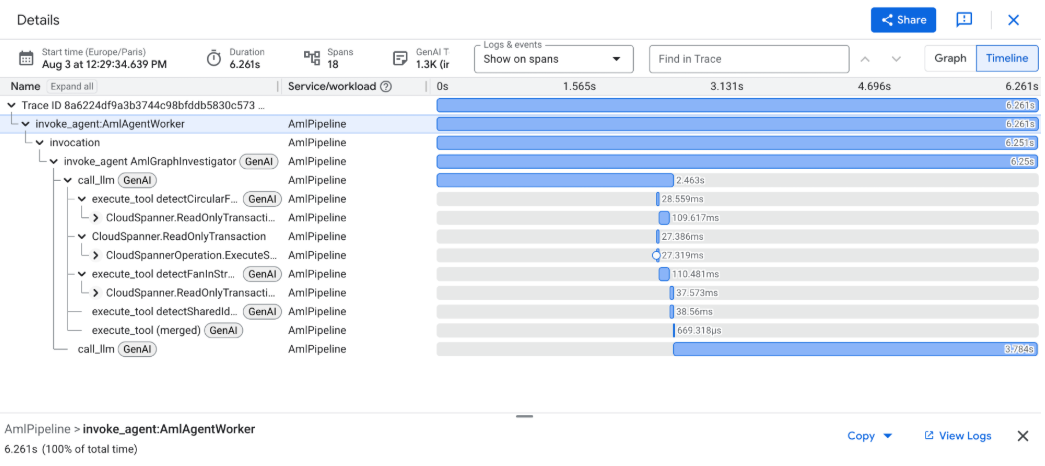
時間軸圖表會顯示:
- 執行器範圍:由 Beam 執行階段產生的範圍。
例如
PubSubIO.Read和ProcessElement。 - 自訂 Span:在
DoFn實作中建立的 Span。例如:InvestigateTransactionDoFn:Analyze。 用戶端程式庫範圍:整合式用戶端程式庫產生的子範圍。例如 Spanner RPC 查詢。
- 執行器範圍:由 Beam 執行階段產生的範圍。
例如
後續步驟
- 如要進一步瞭解如何探索及分析分散式追蹤記錄,請參閱 Cloud Trace 說明文件。
- 使用 Pub/Sub OpenTelemetry 追蹤功能,追蹤從擷取到處理的訊息。
- 使用 Dataflow 監控介面監控管道處理量、CPU 使用率和執行詳細資料。
- 使用 Dataflow 管道記錄查看作業記錄並診斷錯誤。
- 請參閱「疑難排解緩慢或停滯的工作」和「偵測及解決管道瓶頸」,調查並解決效能問題。