


Visualizza la derivazione dei dati per comprendere le relazioni tra le risorse del tuo progetto e i processi che le hanno create. Queste relazioni mostrano come gli asset di dati, come tabelle e set di dati, vengono trasformati da processi come query e pipeline. Questa guida descrive come visualizzare i dettagli della derivazione dei dati nella console Google Cloud o recuperarli utilizzando l'API Data Lineage.
Ruoli e autorizzazioni
La derivazione dei dati monitora automaticamente le informazioni sulla derivazione quando abiliti l'API Data Lineage. Non hai bisogno di ruoli di amministratore o editor per acquisire la derivazione degli asset di dati.
Per visualizzare la derivazione dei dati, devi disporre di autorizzazioni Identity and Access Management (IAM) specifiche. Le informazioni sulla derivazione vengono acquisite in più progetti, pertanto hai bisogno delle autorizzazioni in più progetti.
Quando visualizzi la derivazione in Knowledge Catalog, BigQuery o Vertex AI: devi disporre delle autorizzazioni per visualizzare le informazioni sulla derivazione nel progetto in cui le visualizzi.
Quando visualizzi la derivazione registrata in altri progetti, devi disporre delle autorizzazioni per visualizzare le informazioni sulla derivazione nei progetti in cui è stata registrata.
Per ottenere le autorizzazioni necessarie per visualizzare la derivazione dei dati, chiedi all'amministratore di concederti i seguenti ruoli IAM:
- Visualizzatore Data Lineage (
roles/datalineage.viewer) sul progetto in cui viene registrata la derivazione e sul progetto in cui viene visualizzata la derivazione -
Visualizza i dettagli della tabella BigQuery:
Visualizzatore dati BigQuery (
roles/bigquery.dataViewer) nel progetto di archiviazione della tabella -
Visualizza i dettagli del job BigQuery:
Visualizzatore risorse BigQuery (
roles/bigquery.resourceViewer) nel progetto di computing del job -
Visualizza i dettagli di altri asset catalogati:
Dataplex Catalog Viewer (
roles/dataplex.catalogViewer) nel progetto in cui sono archiviate le voci del catalogo
Per saperne di più sulla concessione dei ruoli, consulta Gestisci l'accesso a progetti, cartelle e organizzazioni.
Questi ruoli predefiniti contengono le autorizzazioni necessarie per visualizzare la derivazione dei dati. Per vedere quali sono esattamente le autorizzazioni richieste, espandi la sezione Autorizzazioni obbligatorie:
Autorizzazioni obbligatorie
Per visualizzare la derivazione dei dati sono necessarie le seguenti autorizzazioni:
-
Visualizza i dettagli della tabella BigQuery:
bigquery.tables.get- il progetto di archiviazione della tabella -
Visualizza i dettagli del job BigQuery:
bigquery.jobs.get- il progetto di computing del job
Potresti anche ottenere queste autorizzazioni con ruoli personalizzati o altri ruoli predefiniti.
Tipi di visualizzazioni della derivazione dei dati
Puoi visualizzare le informazioni sulla derivazione come grafico interattivo o elenco strutturato nella console Google Cloud .
Per una descrizione dettagliata degli elementi del grafico (come nodi, archi, icone di processo ed etichette) e delle colonne disponibili nelle visualizzazioni elenco, consulta Informazioni sulla visualizzazione della tracciabilità dei dati in Knowledge Catalog.
Abilita la derivazione dei dati
Abilita la derivazione dei dati per iniziare a monitorare automaticamente le informazioni sulla derivazione per i sistemi supportati. Per impostazione predefinita, l'abilitazione dell'API attiva il monitoraggio della derivazione per la maggior parte dei servizi supportati. Per controllare l'importazione della derivazione di Managed Service for Apache Spark, consulta Controllare l'importazione della derivazione per un servizio.
L'API Data Lineage viene fatturata in base allo SKU di elaborazione premium di Knowledge Catalog. Per saperne di più, consulta la pagina Prezzi di Knowledge Catalog.
Devi abilitare l'API Data Lineage sia nel progetto in cui visualizzi la derivazione sia nei progetti in cui viene registrata. Per saperne di più, consulta la sezione Tipi di progetto.
- Per acquisire le informazioni sulla derivazione, completa i seguenti passaggi:
-
Nella console Google Cloud , nella pagina Selettore progetto, seleziona il progetto in cui vuoi registrare la derivazione.
Abilita l'API Data Lineage.
- Ripeti i passaggi precedenti per ogni progetto in cui vuoi registrare la derivazione.
-
Nel progetto in cui visualizzi la derivazione, abilita l'API Data Lineage e l'API Dataplex.
Controllare l'importazione della derivazione per un servizio
Puoi attivare o disattivare selettivamente il monitoraggio automatico della derivazione per servizi specifici a livello di progetto, cartella o organizzazione.
Per informazioni dettagliate su come queste configurazioni vengono applicate gerarchicamente tramite l'albero delle risorse, consulta Controllare l'importazione della derivazione.
Visualizza derivazione
Per monitorare il modo in cui i dati vengono trasformati e spostati tra i sistemi, puoi visualizzare la derivazione dei dati utilizzando la console Google Cloud o l'API.
Console
Puoi accedere alle informazioni sulla derivazione dei dati nella console Google Cloud da vari punti di partenza:
- Knowledge Catalog:vai alla pagina Ricerca di Knowledge Catalog, seleziona Knowledge Catalog come modalità di ricerca, cerca la voce che vuoi visualizzare e poi fai clic. Per saperne di più, consulta Cercare risorse in Knowledge Catalog.
- BigQuery:vai alla pagina BigQuery e apri la tabella per cui vuoi visualizzare la derivazione dei dati.
- Vertex AI: vai alla pagina Set di dati o Model Registry e fai clic sul set di dati o sul modello per cui vuoi visualizzare la derivazione dei dati.
Per visualizzare il grafico della derivazione:
Fai clic sulla scheda Lineage.
Si apre la visualizzazione predefinita Grafico, che mostra la derivazione a livello di tabella in tutti i sistemi e le regioni. Per ulteriori informazioni, vedi Visualizzazione del grafico della derivazione.
Per esplorare manualmente il grafico di derivazione, fai clic su Espandi accanto a un nodo per caricare altri cinque nodi alla volta.
Per saperne di più, consulta Esplora manualmente il grafico di derivazione.
Fai clic su un nodo nella visualizzazione Grafico.
Si apre il riquadro Dettagli con informazioni sull'asset, ad esempio nome e tipo completi. Per ulteriori informazioni, consulta Dettagli dei nodi.
Fai clic su un bordo con un'icona di processo nella visualizzazione Grafico.
Viene visualizzato il riquadro Query. Per saperne di più, consulta Ispeziona la logica di trasformazione e Controlla e cronologia delle esecuzioni.
- Per esaminare la logica di trasformazione, fai clic sulla scheda Dettagli.
- Per visualizzare il controllo e la cronologia delle esecuzioni, fai clic sulla scheda Esecuzioni.
Nel riquadro Esplora lignaggio, seleziona i criteri di filtro, ad esempio Direzione, Tipo di dipendenza o Intervallo di tempo, quindi fai clic su Applica.
Si apre una visualizzazione mirata all'interno di una regione specifica (anteprima). Questa visualizzazione espande automaticamente il grafico fino a tre livelli di nodi. Per saperne di più, consulta Applica i filtri per una visualizzazione della derivazione mirata.
Nella visualizzazione Grafico attiva, seleziona un nodo, quindi nel riquadro dei dettagli del nodo fai clic su Visualizza percorso per visualizzare il percorso di derivazione dal nodo selezionato alla voce principale (solo nella visualizzazione attiva).
Per saperne di più, consulta Visualizzazione del percorso di derivazione.
Per visualizzare la derivazione a livello di colonna (solo per i job BigQuery e Managed Service for Apache Spark), esegui una delle seguenti operazioni:
- In una visualizzazione Grafico attiva, fai clic sull'icona della colonna in una tabella.
Icona colonna - Nel riquadro Esplora derivazioni, filtra per nome della colonna e fai clic su Applica.
Per saperne di più, consulta Derivazione a livello di colonna.
- In una visualizzazione Grafico attiva, fai clic sull'icona della colonna in una tabella.
Fai clic su Reimposta.
Questa azione rimuove tutti i filtri applicati e ti porta all'inizio della visualizzazione del grafico.
Fai clic su Elenco per passare alla visualizzazione elenco.
La visualizzazione Elenco offre rappresentazioni tabulari semplificate e dettagliate della derivazione sia a livello di tabella che di colonna, sincronizzate con la visualizzazione Grafico. Per impostazione predefinita, viene visualizzata la visualizzazione elenco semplificata e puoi passare alla visualizzazione elenco dettagliata per analizzare le singole relazioni origine-destinazione. Puoi configurare le colonne visualizzate ed esportare i dati di derivazione. Per saperne di più, consulta Visualizzazione elenco della derivazione.
Java
import com.google.api.gax.rpc.ApiException;
import com.google.cloud.datacatalog.lineage.v1.BatchSearchLinkProcessesRequest;
import com.google.cloud.datacatalog.lineage.v1.EntityReference;
import com.google.cloud.datacatalog.lineage.v1.EventLink;
import com.google.cloud.datacatalog.lineage.v1.LineageClient;
import com.google.cloud.datacatalog.lineage.v1.LineageEvent;
import com.google.cloud.datacatalog.lineage.v1.Link;
import com.google.cloud.datacatalog.lineage.v1.ListLineageEventsRequest;
import com.google.cloud.datacatalog.lineage.v1.ListRunsRequest;
import com.google.cloud.datacatalog.lineage.v1.LocationName;
import com.google.cloud.datacatalog.lineage.v1.ProcessLinks;
import com.google.cloud.datacatalog.lineage.v1.Run;
import com.google.cloud.datacatalog.lineage.v1.SearchLinksRequest;
import java.io.IOException;
import java.util.ArrayList;
import java.util.HashSet;
import java.util.LinkedList;
import java.util.List;
import java.util.Queue;
import java.util.Set;

public class ViewLineageExample {

  public static void main(String[] args) throws IOException {
    // TODO(developer): Replace these variables before running the sample.
    String projectId = "my-project-id";
    String location = "us";
    String targetFullyQualifiedName = "bigquery:my-project-id.my_dataset.my_table";
    int maxDepth = 3;

    viewLineage(projectId, location, targetFullyQualifiedName, maxDepth);
  }

  static class Node {
    String fqn;
    int depth;
    Node(String fqn, int depth) {
      this.fqn = fqn;
      this.depth = depth;
    }
  }

  public static void viewLineage(
      String projectId, String location, String targetFullyQualifiedName, int maxDepth)
      throws IOException {
    // Initialize client that will be used to send requests. This client only needs
    // to be created once, and can be reused for multiple requests.
    try (LineageClient client = LineageClient.create()) {
      String parent = LocationName.of(projectId, location).toString();

      Set<String> visitedNodes = new HashSet<>();
      Queue<Node> queue = new LinkedList<>();

      visitedNodes.add(targetFullyQualifiedName);
      queue.offer(new Node(targetFullyQualifiedName, 0));

      while (!queue.isEmpty()) {
        Node current = queue.poll();
        System.out.printf("\nExploring node (Depth %d): %s\n", current.depth, current.fqn);

        if (current.depth >= maxDepth) {
          continue;
        }

        EntityReference targetEntity =
            EntityReference.newBuilder().setFullyQualifiedName(current.fqn).build();
        SearchLinksRequest searchLinksRequest =
            SearchLinksRequest.newBuilder().setParent(parent).setTarget(targetEntity).build();

        List<String> linkNames = new ArrayList<>();
        try {
          // 1. Search for links related to the target entity
          for (Link link : client.searchLinks(searchLinksRequest).iterateAll()) {
            linkNames.add(link.getName());
          }
        } catch (ApiException e) {
          System.out.printf("  Failed to retrieve links for %s: %s\n", current.fqn, e.getMessage());
          continue;
        }

        if (linkNames.isEmpty()) {
          continue;
        }

        // 2. Batch search for processes in chunks of 100
        for (int i = 0; i < linkNames.size(); i += 100) {
          List<String> batch = linkNames.subList(i, Math.min(linkNames.size(), i + 100));
          BatchSearchLinkProcessesRequest batchSearchRequest =
              BatchSearchLinkProcessesRequest.newBuilder()
                  .setParent(parent)
                  .addAllLinks(batch)
                  .build();

          try {
            for (ProcessLinks processLinks :
                client.batchSearchLinkProcesses(batchSearchRequest).iterateAll()) {
              String processName = processLinks.getProcess();
              System.out.printf("  Process: %s\n", processName);

              // 3. List runs for the process
              ListRunsRequest runsRequest =
                  ListRunsRequest.newBuilder().setParent(processName).build();
              for (Run run : client.listRuns(runsRequest).iterateAll()) {
                System.out.printf("    Run: %s\n", run.getName());

                // 4. List events for the run
                ListLineageEventsRequest eventsRequest =
                    ListLineageEventsRequest.newBuilder().setParent(run.getName()).build();
                for (LineageEvent event : client.listLineageEvents(eventsRequest).iterateAll()) {
                  for (EventLink eventLink : event.getLinksList()) {
                    String sourceFqn = eventLink.getSource().getFullyQualifiedName();
                    // If exploring upstream, queue the source
                    if (!sourceFqn.isEmpty() && !visitedNodes.contains(sourceFqn)) {
                      visitedNodes.add(sourceFqn);
                      queue.offer(new Node(sourceFqn, current.depth + 1));
                    }
                  }
                }
              }
            }
          } catch (ApiException e) {
            System.out.printf("  Failed to retrieve processes/runs: %s\n", e.getMessage());
          }
        }
      }
    }
  }
}
Python
from google.cloud import datacatalog_lineage_v1
from google.api_core.exceptions import GoogleAPICallError

def view_lineage(project_id: str, location: str, target_fully_qualified_name: str, max_depth: int = 3):
    """Retrieves lineage for a given entity using a depth-limited search."""
    client = datacatalog_lineage_v1.LineageClient()
    parent = f"projects/{project_id}/locations/{location}"

    # Store visited nodes to avoid infinite loops in cyclic graphs
    visited_nodes = set([target_fully_qualified_name])
    queue = [(target_fully_qualified_name, 0)]

    while queue:
        current_node, current_depth = queue.pop(0)
        print(f"\nExploring node (Depth {current_depth}): {current_node}")

        if current_depth >= max_depth:
            continue

        target_entity = datacatalog_lineage_v1.EntityReference(
            fully_qualified_name=current_node
        )
        search_links_request = datacatalog_lineage_v1.SearchLinksRequest(
            parent=parent,
            target=target_entity,
        )

        try:
            links = list(client.search_links(request=search_links_request))
        except GoogleAPICallError as e:
            print(f"  Failed to retrieve links for {current_node}: {e.message}")
            continue

        if not links:
            continue

        # Extract link names to query processes in batches
        link_names = [link.name for link in links]

        # Batch max size is 100
        for i in range(0, len(link_names), 100):
            batch = link_names[i:i + 100]
            batch_request = datacatalog_lineage_v1.BatchSearchLinkProcessesRequest(
                parent=parent,
                links=batch
            )

            try:
                for process_links in client.batch_search_link_processes(request=batch_request):
                    process_name = process_links.process
                    print(f"  Process: {process_name}")

                    runs_request = datacatalog_lineage_v1.ListRunsRequest(parent=process_name)
                    for run in client.list_runs(request=runs_request):
                        print(f"    Run: {run.name}")

                        events_request = datacatalog_lineage_v1.ListLineageEventsRequest(parent=run.name)
                        for event in client.list_lineage_events(request=events_request):
                            for event_link in event.links:
                                source_fqn = event_link.source.fully_qualified_name

                                # If exploring upstream, queue the source
                                if source_fqn and source_fqn not in visited_nodes:
                                    visited_nodes.add(source_fqn)
                                    queue.append((source_fqn, current_depth + 1))

            except GoogleAPICallError as e:
                 print(f"  Failed to retrieve processes/runs: {e.message}")
Perfeziona la visualizzazione della derivazione
Per perfezionare la visualizzazione della derivazione, puoi utilizzare le opzioni di evidenziazione e filtro in Esplora derivazioni:
Per cercare progetti, set di dati o nomi di entità specifici, utilizza il riquadro Filtri.
Dopo aver applicato i filtri, i nodi di derivazione che corrispondono ai criteri di filtro sono considerati nodi corrispondenti. Puoi perfezionare la modalità di visualizzazione dei nodi corrispondenti e non corrispondenti.
Nel grafico di derivazione, fai clic sull'icona Altre azioni accanto al pulsante Cancella filtri per visualizzare le opzioni di visualizzazione.
Seleziona una o entrambe le seguenti opzioni:
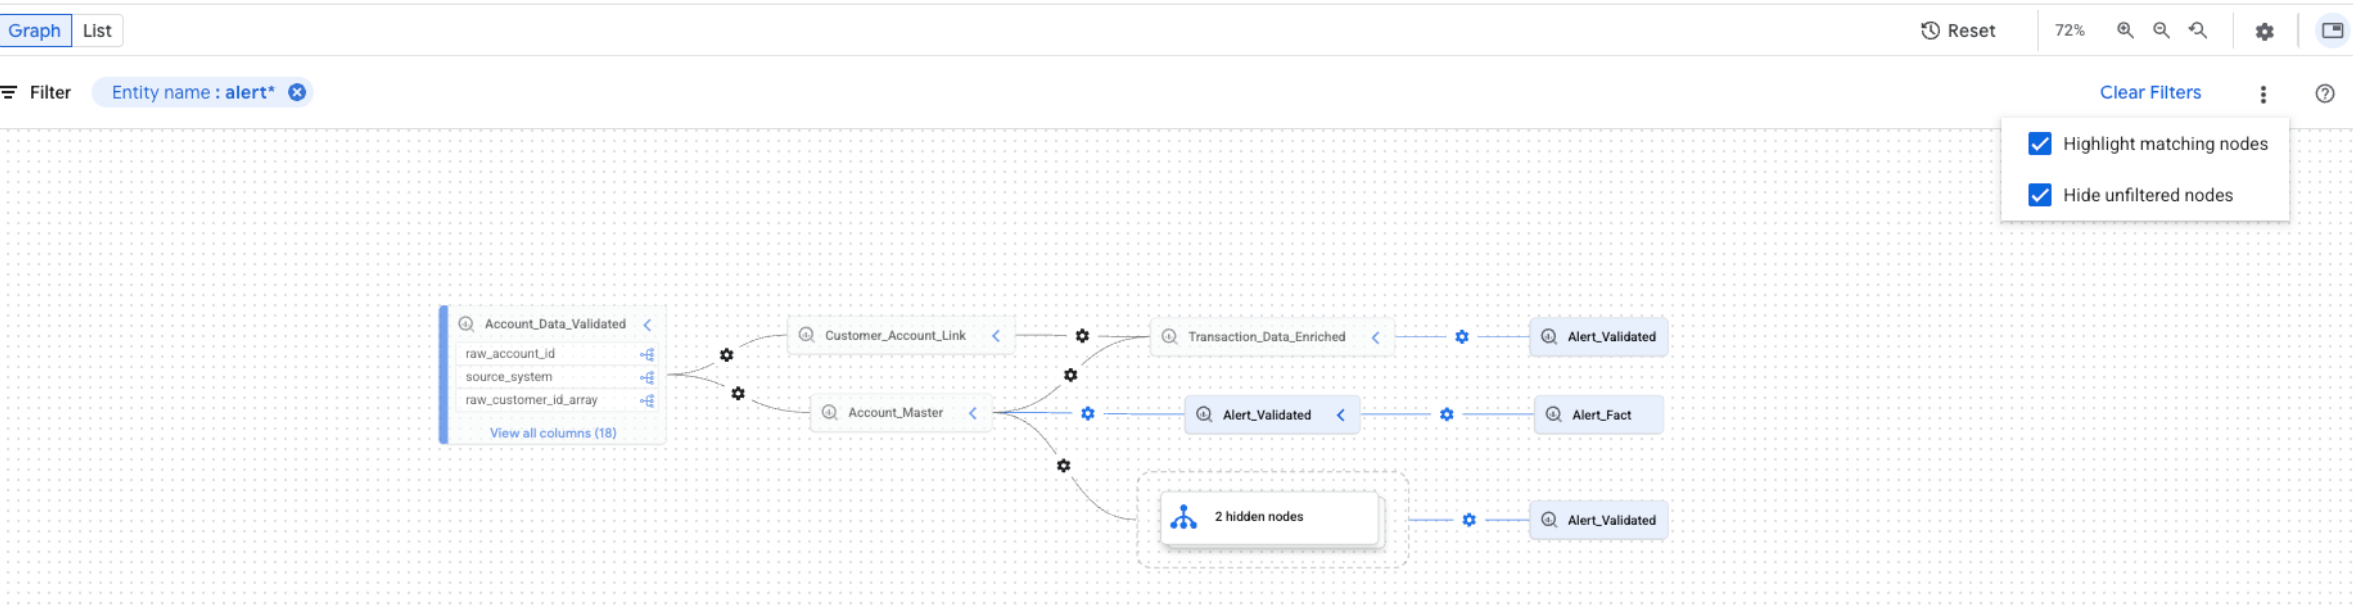
Puoi selezionare entrambe le opzioni contemporaneamente. Se entrambe le opzioni sono selezionate, i nodi non filtrati vengono nascosti e i nodi corrispondenti vengono evidenziati nella visualizzazione del grafico filtrato.
Disattivare la derivazione dei dati
Per interrompere il monitoraggio della derivazione ed evitare addebiti per la derivazione dei dati, disabilita l'API Data Lineage (datalineage.googleapis.com) in ogni progetto in cui è abilitata.
La disattivazione dell'API Dataplex non disattiva la derivazione dei dati né interrompe i relativi addebiti. Devi disabilitare l'API Data Lineage.
Per disattivare la derivazione dei dati, seleziona una delle seguenti schede e completa i passaggi per ogni progetto in cui è stato attivato il monitoraggio della derivazione:
Console
Nella console Google Cloud , vai alla pagina API e servizi abilitati.
Nell'elenco delle API, fai clic su API Data Lineage.
Fai clic su Disabilita API.
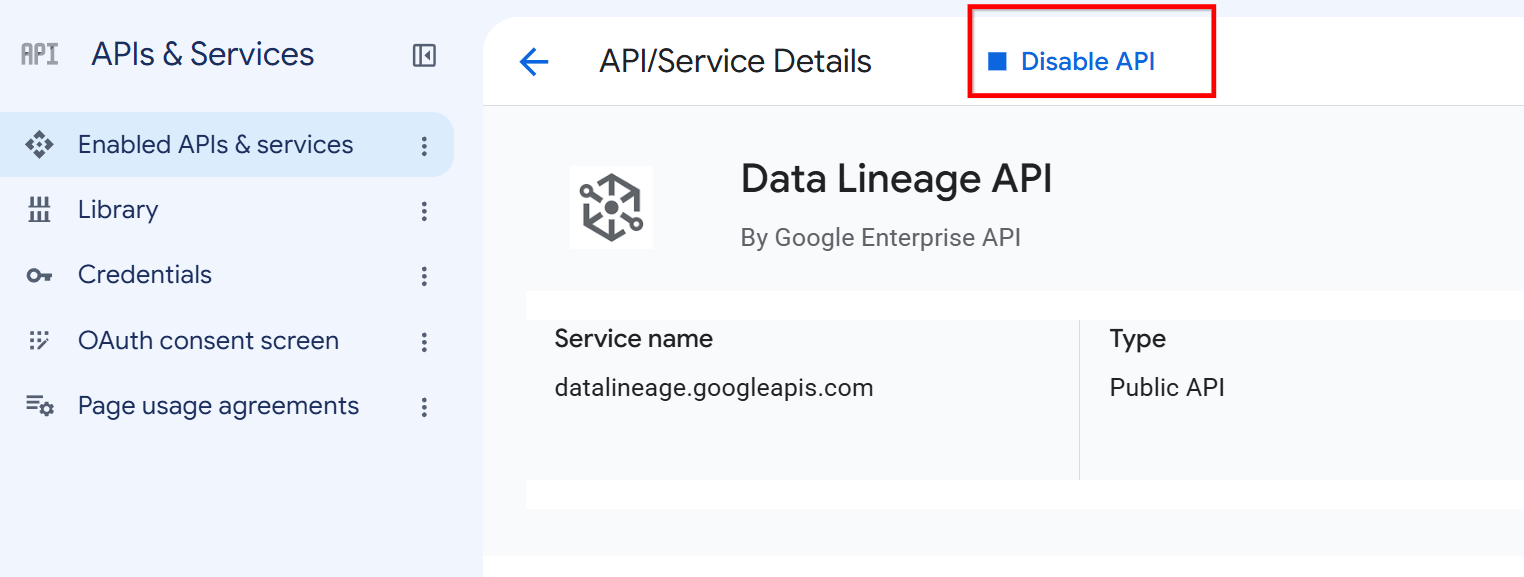
Disattiva il pulsante API nella pagina dei dettagli dell'API Data Lineage. Quando richiesto, fai clic su Disattiva.
gcloud
Per disattivare l'API Data Lineage, utilizza il comando
gcloud services disable:
gcloud services disable datalineage.googleapis.com --project=PROJECT_ID
Sostituisci quanto segue:
PROJECT_ID: l'ID del tuo Google Cloud progetto
Se vuoi interrompere il monitoraggio della derivazione per servizi specifici senza disattivare completamente l'API, consulta Controllare l'importazione della derivazione per un servizio.
Passaggi successivi
- Monitorare la derivazione dei dati per i job di copia e query di una tabella BigQuery.
- Scopri di più sul modello di informazioni sulla derivazione dei dati.
- Scopri di più su considerazioni e limitazioni relative alla derivazione dei dati.
- Scopri di più sui log di controllo della derivazione dei dati.
- Scopri come risolvere i problemi relativi alla derivazione dei dati.
- Scopri come eseguire l'integrazione con OpenLineage.
- Scopri come utilizzare la derivazione dei dati con Managed Service for Apache Spark.