


Com a Computação Confidencial, é possível colaborar com dados sensíveis, treinar modelos de IA e executar cargas de trabalho de aprendizado federado, mantendo os dados criptografados na memória. Neste documento, descrevemos casos de uso do setor e arquiteturas de referência para análise confidencial, IA e aprendizado federado no Google Cloud.
Casos de uso
As seções a seguir mostram exemplos de casos de uso da Computação Confidencial para vários setores.
Saúde e ciências biológicas
A computação confidencial permite o compartilhamento e a análise de dados pessoais de forma segura entre organizações, além de ajudar a preservar a privacidade do paciente. A Computação confidencial permite que as organizações de saúde participem de pesquisas colaborativas, modelagem de doenças, descoberta de medicamentos e planos de tratamento personalizados.
A tabela a seguir descreve alguns exemplos de uso da Computação Confidencial na saúde.
| Caso de uso | Descrição |
|---|---|
| Previsão e detecção precoce de doenças | Os hospitais treinam um modelo de aprendizado federado para detectar lesões cancerígenas em dados de imagens médicas (por exemplo, exames de ressonância magnética ou tomografia computadorizada em vários hospitais ou regiões hospitalares), mantendo a confidencialidade do paciente. |
| Monitoramento de pacientes em tempo real | Os profissionais de saúde analisam dados de dispositivos de saúde vestíveis e apps de saúde móveis para monitoramento e alertas em tempo real. Por exemplo, dispositivos wearable coletam dados sobre níveis de glicose, atividade física e hábitos alimentares para fornecer recomendações personalizadas e avisos antecipados sobre flutuações de açúcar no sangue. |
| Descoberta de medicamentos e ensaios clínicos colaborativos | Empresas farmacêuticas e hospitais de pesquisa reúnem dados de ensaios clínicos, sequências genômicas e estruturas moleculares para descobrir terapias e modelar interações medicamentosas. |
| Documentação clínica e transcrição médica autônomas | Os assistentes de IA capturam conversas entre médicos e pacientes para elaborar resumos clínicos, atualizar históricos eletrônicos de saúde (EHRs, na sigla em inglês) e sugerir códigos de faturamento. |
| Avaliação e comparação de IA médica multi-institucional | Instituições de saúde e consórcios de pesquisa validam modelos de diagnóstico próprios em diversas populações globais de pacientes, sem mover ou expor dados clínicos brutos. |
Serviços financeiros
A Computação Confidencial permite que as instituições financeiras criem um sistema financeiro mais seguro e resiliente.
A tabela a seguir descreve alguns exemplos de uso da Computação Confidencial em serviços financeiros.
| Caso de uso | Descrição |
|---|---|
| Detecção de fraudes e antilavagem de dinheiro (AML, na sigla em inglês) | Várias instituições financeiras compartilham fluxos de transações sensíveis e indicadores de fraude para treinar modelos de machine learning ou implantar agentes analíticos. Ao usar esses dados coletados, as instituições podem detectar sindicatos de lavagem de dinheiro transfronteiriços e fraudes de pagamento sem revelar números de contas de clientes ou registros de transações proprietários aos concorrentes. |
| Avaliação de risco de crédito e subscrição | Os credores avaliam as solicitações de crédito comercial ou de varejo analisando dados financeiros confidenciais e não tradicionais (como pagamentos de serviços públicos em tempo real) sem expor esses dados a terceiros. A execução de agentes de subscrição automatizados em um ambiente de execução confiável (TEE) ajuda a isolar os registros financeiros de um solicitante e os algoritmos de pontuação de riscos proprietários do banco durante a avaliação. |
| Análise financeira automatizada e relatórios regulamentares | Agentes de IA autônomos pesquisam livros corporativos internos, portfólios de investimento e informações não públicas relevantes (MNPI, na sigla em inglês) para preparar memorandos de auditoria, relatórios de auditoria e registros regulatórios. |
Setor público
A computação confidencial permite que os governos criem serviços mais transparentes, eficientes e eficazes, mantendo o controle e a soberania dos dados.
A tabela a seguir descreve alguns exemplos de uso da Computação Confidencial no setor público.
| Caso de uso | Descrição |
|---|---|
| Análise confidencial de várias agências | A Computação confidencial permite a análise de dados de várias partes em vários órgãos governamentais (por exemplo, saúde, tributos e educação) ou em vários governos em diferentes regiões ou países. A Computação Confidencial ajuda a garantir que os limites de confiança e a privacidade de dados sejam protegidos, além de permitir a análise de dados (usando a prevenção contra perda de dados (DLP), análises em grande escala e Policy Engines) e o treinamento e a disponibilização de IA. |
| Análise investigativa entre agências e compartilhamento de inteligência | Órgãos governamentais separados (como agências fiscais, de aplicação da lei e alfandegárias) usam o Confidential Space para realizar análises de dados conjuntas. As agências podem comparar declarações fiscais, manifestos de viagem e registros financeiros para identificar fraudes ou ameaças à segurança nacional sem compartilhar bancos de dados brutos e confidenciais entre jurisdições. |
| Identidade digital e verificação de credenciais de cidadãos | Agências públicas e Identity Platforms verificam passaportes biométricos oficiais e documentos de identidade nacionais sem armazenar ou expor dados pessoais dos cidadãos. Os cidadãos podem comprovar criptograficamente atributos específicos (como nacionalidade, residência ou idade), enquanto os dados brutos do passaporte e as assinaturas biométricas permanecem criptografados na memória e são excluídos após a geração da prova. |
Cadeia de suprimentos
A Computação Confidencial permite que as organizações que gerenciam cadeias de suprimentos e programas de sustentabilidade colaborem e compartilhem insights, ajudando a manter a privacidade dos dados.
A tabela a seguir descreve alguns exemplos de uso da Computação Confidencial em cadeias de suprimentos.
| Caso de uso | Descrição |
|---|---|
| Logística autônoma de várias partes e orquestração de frete | As organizações implantam agentes de IA autônomos para negociar taxas de frete, coordenar transferências de contêineres e traçar novos trajetos de carga com transportadoras externas durante interrupções no trânsito. A execução desses agentes de logística em uma instância de VM confidencial ajuda a proteger manifestos de envio ativos, contratos de preços de transportadoras e credenciais de API de transportadoras contra exposição na memória para outros locatários da nuvem. |
| Detecção de anomalias na cadeia de suprimentos e otimização de rotas em tempo real | Os agentes de IA processam telemetria em tempo real (como registros de trânsito de GPS, sensores de portões de armazéns e alertas meteorológicos) para otimizar as rotas de envio. O processamento dessa telemetria operacional sensível dentro do Confidential Space permite que fabricantes e distribuidores executem algoritmos automatizados de traçado de novo trajeto sem expor capacidades de fábrica reservadas ou vulnerabilidades de gargalo a terceiros. |
| Conformidade alfandegária e documentação comercial automatizadas | Os agentes de IA processam faturas comerciais, conhecimentos de embarque e declarações alfandegárias de alto valor para automatizar a conformidade de fronteira. Isolar esses agentes de análise de documentos em um TEE ajuda a proteger segredos comerciais sensíveis enquanto eles são extraídos e verificados em bancos de dados alfandegários. |
Publicidade digital
Em vez de usar cookies de terceiros, a publicidade digital está usando cada vez mais alternativas com privacidade aprimorada que usam TEEs para ajudar as empresas de publicidade a processar os dados em um ambiente seguro. Por exemplo, o Google Ads usa a Computação confidencial para proteger dados próprios ao veicular campanhas.
É possível usar TEEs nos seguintes casos de uso de publicidade digital:
- Algoritmos de correspondência: encontrar correspondências ou relações em conjuntos de dados.
- Atribuição: vincular efeitos ou eventos às causas prováveis.
- Agregação: calcular resumos ou estatísticas com base nos dados brutos.
Arquiteturas de referência
É possível implementar a Computação Confidencial no Google Cloud para abordar os seguintes casos de uso:
- Análise confidencial
- IA confidencial
- Aprendizado federado confidencial
As seções a seguir fornecem mais informações sobre a arquitetura para esses casos de uso, incluindo exemplos para empresas financeiras e de saúde.
Arquitetura de análise confidencial para instituições de saúde
A arquitetura de análise confidencial demonstra como várias instituições de saúde (como provedores de saúde, empresas biofarmacêuticas e instituições de pesquisa) podem trabalhar juntas para acelerar a pesquisa de medicamentos. Essa arquitetura usa técnicas de computação confidencial para criar um data clean room digital para executar análises colaborativas confidenciais.
Essa arquitetura tem os seguintes benefícios:
- Insights aprimorados: com a análise colaborativa, as organizações de saúde podem ter insights mais amplos e diminuir o tempo de lançamento no mercado para melhorar a descoberta de medicamentos.
- Privacidade de dados: os dados sensíveis de pacientes e ensaios clínicos permanecem criptografados em trânsito, em repouso e na memória, e não são expostos em texto simples para outros participantes ou para o provedor de nuvem.
- Conformidade regulatória: a arquitetura ajuda as instituições de saúde a obedecer às regulamentações de proteção de dados, mantendo um controle rigoroso sobre os dados.
- Confiança e colaboração: a arquitetura permite a colaboração segura entre instituições concorrentes, promovendo um esforço coletivo para descobrir medicamentos.
O diagrama a seguir mostra essa arquitetura.
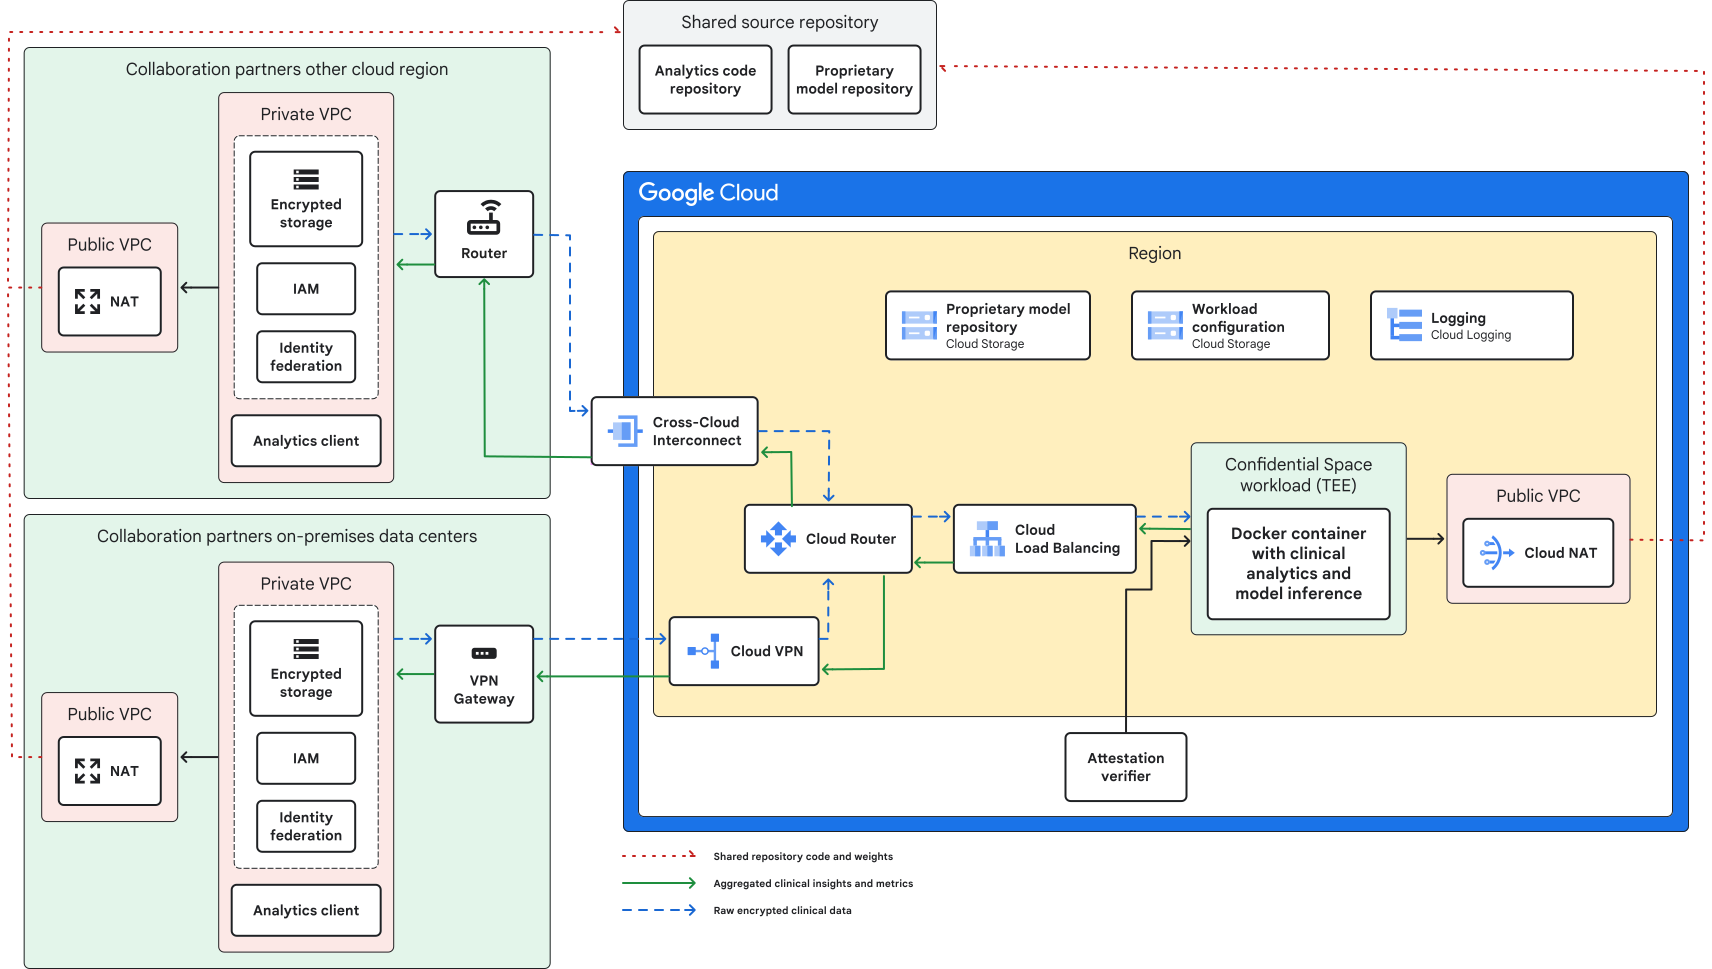
Os principais componentes dessa arquitetura incluem:
- Carga de trabalho do Confidential Space (TEE): um ambiente seguro e isolado em que os dados e o código no TEE são protegidos contra acesso não autorizado, mesmo do sistema operacional ou do provedor de nuvem.
- Parceiros de colaboração: cada instituição de saúde participante tem um ambiente local que atua como intermediário entre os dados particulares da instituição e o TEE.
- Dados criptografados específicos do provedor: cada instituição de saúde armazena os próprios dados privados e criptografados dos pacientes, incluindo históricos de saúde eletrônicos. Cada provedor libera os dados (e o acesso às chaves de descriptografia) para o TEE somente após validar as declarações de atestado da carga de trabalho do TEE. Os dados são descriptografados apenas dentro do TEE atestado durante o processamento e permanecem criptografados na memória.
- Cliente do Analytics: as instituições de saúde participantes podem executar consultas confidenciais nos dados para gerar insights.
Arquitetura de IA confidencial para instituições financeiras
Este padrão de arquitetura demonstra como as instituições financeiras podem treinar de forma colaborativa um modelo de detecção de fraudes usando rótulos de fraude para preservar a confidencialidade dos dados de transações sensíveis. A arquitetura usa técnicas de computação confidencial para permitir o machine learning seguro e de várias partes.
Essa arquitetura tem os seguintes benefícios:
- Detecção de fraudes aprimorada: o treinamento colaborativo usa um conjunto de dados maior e mais diversificado, o que resulta em um modelo de detecção de fraudes mais preciso e eficaz.
- Privacidade de dados: os dados de transações sensíveis permanecem criptografados em trânsito, em repouso e na memória, e não são expostos em texto simples para outros participantes ou para o provedor de nuvem.
- Conformidade regulatória: a arquitetura ajuda as instituições financeiras a obedecer às regulamentações de proteção de dados, mantendo um controle rigoroso sobre os dados.
- Confiança e colaboração: essa arquitetura permite a colaboração segura entre instituições concorrentes, promovendo um esforço coletivo para combater fraudes financeiras.
O diagrama a seguir mostra essa arquitetura.
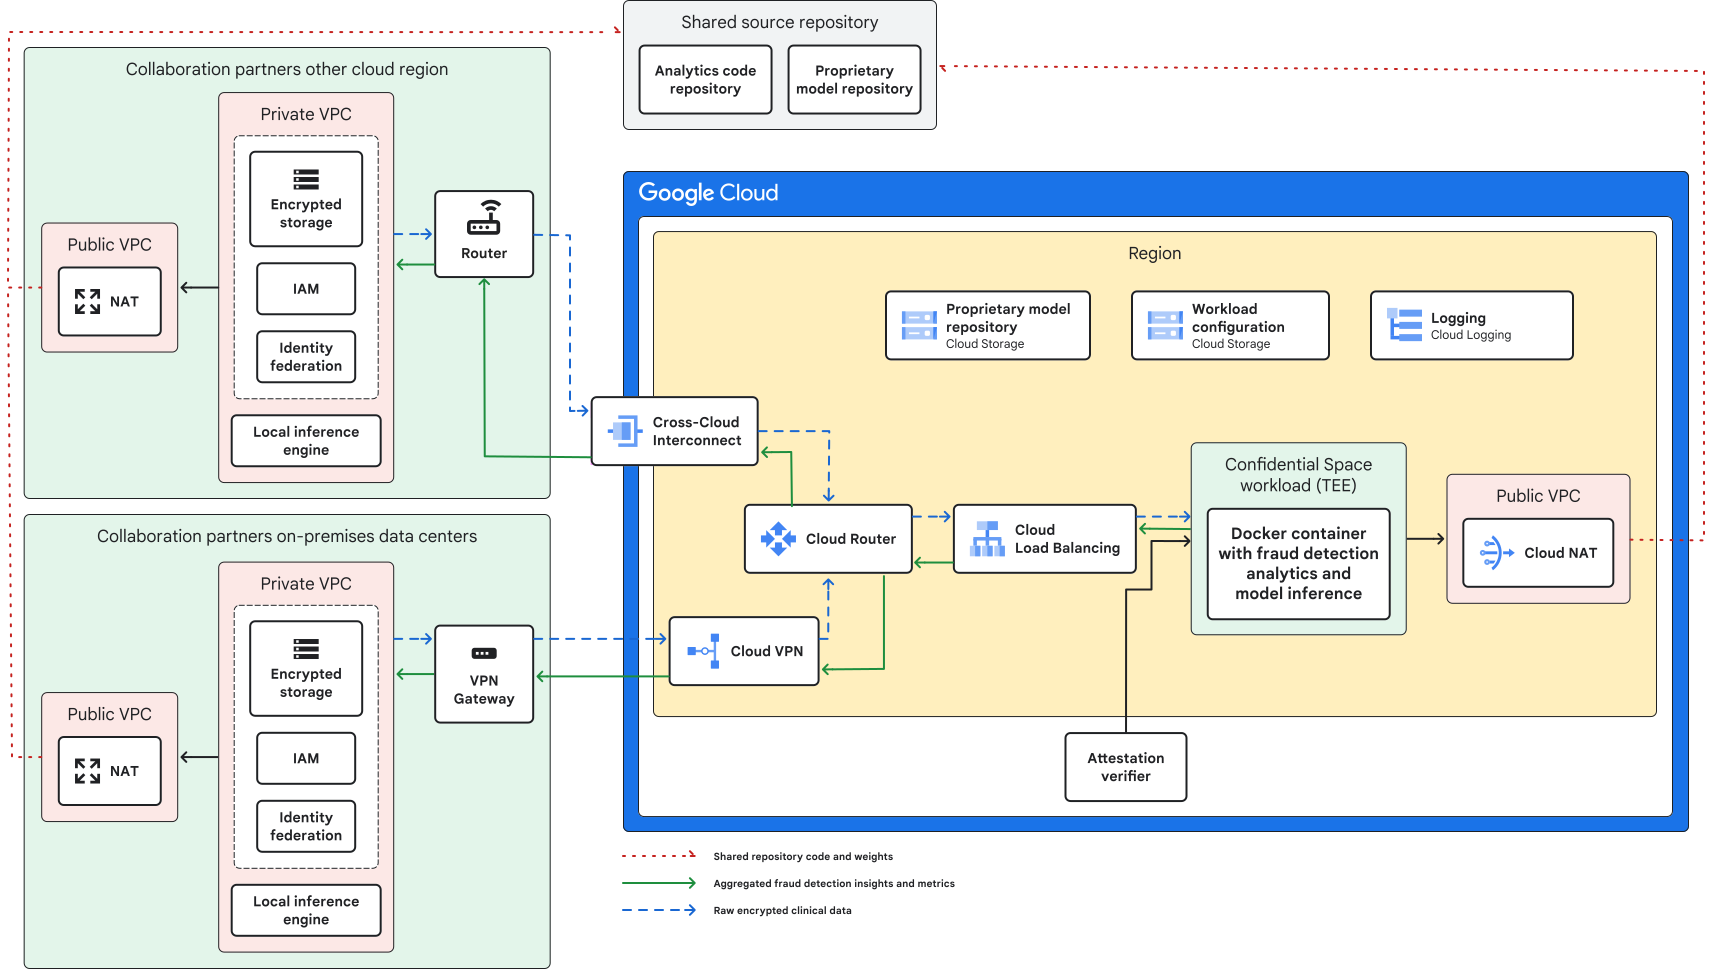
Os principais componentes dessa arquitetura incluem:
- Carga de trabalho do Confidential Space (TEE): um ambiente seguro e isolado em que os dados e o código no TEE são protegidos contra acesso não autorizado, mesmo do sistema operacional ou do provedor de nuvem.
- Parceiros de colaboração: cada instituição financeira participante tem um ambiente local que atua como intermediário entre os dados privados da instituição e o TEE.
- Dados criptografados específicos do banco: cada banco tem os próprios dados de transação privados e criptografados, que incluem rótulos de fraude. Cada banco libera os dados (e o acesso às chaves de descriptografia) para o TEE somente após validar as declarações de atestado da carga de trabalho do TEE. Os dados são descriptografados apenas dentro do TEE atestado durante o processamento e permanecem criptografados na memória.
- Repositório de modelos reservado: um modelo pré-treinado de detecção de fraudes que serve como ponto de partida para o treinamento colaborativo.
- Modelo e pesos globais treinados para fraude (mostrados pelas setas verdes de saída do TEE para cada banco): o modelo de detecção de fraudes aprimorado, junto com os pesos aprendidos, é trocado de forma segura com os bancos participantes. Em seguida, eles podem implantar esse modelo aprimorado localmente para detectar fraudes nas próprias transações.
Arquitetura de aprendizado federado confidencial para instituições financeiras
O aprendizado federado oferece uma solução avançada para clientes que valorizam a privacidade de dados e a soberania de dados rigorosas. A arquitetura de aprendizado federado confidencial oferece uma maneira segura, escalonável e eficiente de usar dados para aplicativos de IA. Essa arquitetura leva os modelos para o local em que os dados estão armazenados, em vez de centralizar os dados em um único local, reduzindo os riscos associados ao vazamento de dados.
Esse padrão de arquitetura demonstra como várias instituições financeiras podem treinar de forma colaborativa um modelo de detecção de fraudes, preservando a confidencialidade dos dados de transações sensíveis com rótulos de fraude. Ele usa o aprendizado federado com técnicas de Computação Confidencial para permitir o machine learning seguro entre várias partes sem movimentação de dados de treinamento.
Essa arquitetura tem os seguintes benefícios:
- Maior privacidade e segurança de dados: o aprendizado federado permite a privacidade e a localidade de dados ao manter os dados sensíveis em cada site. Além disso, as instituições financeiras podem usar técnicas que preservam a privacidade, como criptografia homomórfica e filtros de privacidade diferencial, para proteger ainda mais os dados transferidos (como os pesos do modelo).
- Melhoria na precisão e na diversidade: ao treinar com uma variedade de fontes de dados em diferentes clientes, as instituições financeiras podem desenvolver um modelo global robusto e generalizável para representar melhor conjuntos de dados heterogêneos.
- Escalonabilidade e eficiência de rede: com a capacidade de realizar o treinamento na borda, as instituições podem escalonar o aprendizado federado globalmente. Além disso, as instituições precisam transferir apenas os pesos do modelo, em vez de conjuntos de dados inteiros, o que permite o uso eficiente dos recursos de rede.
O diagrama a seguir mostra essa arquitetura.
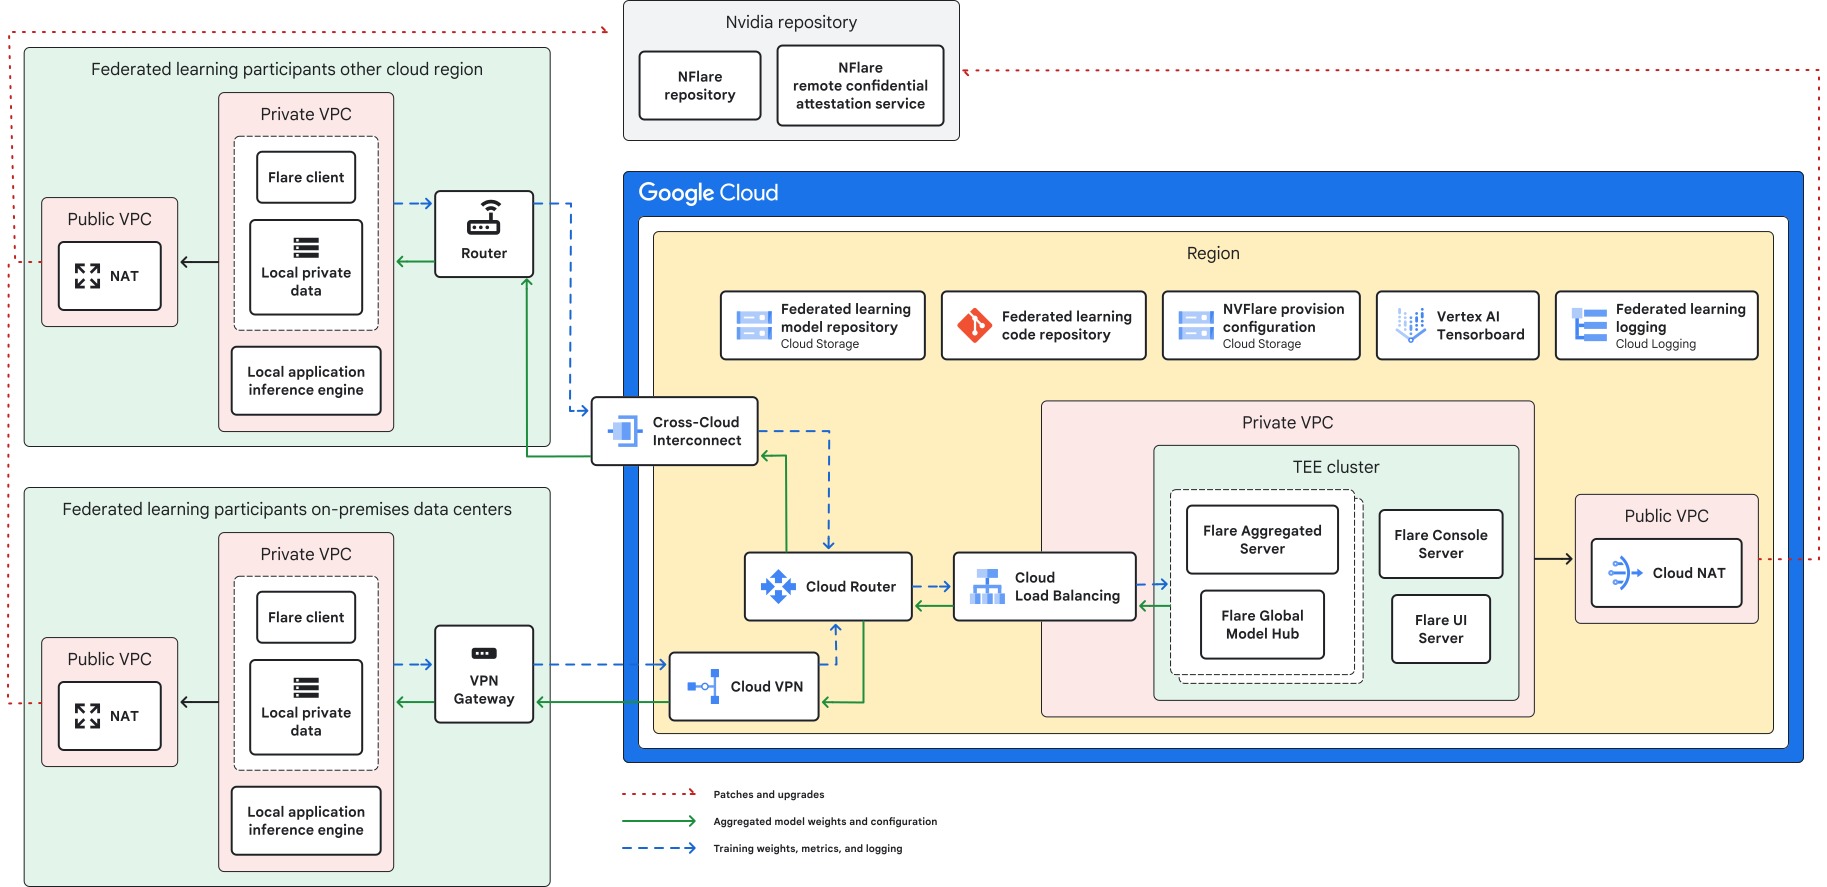
Os principais componentes dessa arquitetura incluem:
- Servidor federado no cluster do TEE: um ambiente seguro e isolado em que o servidor de aprendizado federado organiza a colaboração de vários clientes enviando primeiro um modelo inicial para os clientes de aprendizado federado. Os clientes realizam o treinamento nos conjuntos de dados locais e enviam as atualizações do modelo de volta ao servidor de aprendizado federado para agregação e formação de um modelo global.
- Repositório de modelos de aprendizado federado: um modelo pré-treinado de detecção de fraudes que serve como ponto de partida para o aprendizado federado.
- Mecanismo de inferência de aplicativos locais: um aplicativo que executa tarefas, realiza cálculos e aprendizados locais com conjuntos de dados locais e envia os resultados de volta ao servidor de aprendizado federado para agregação segura.
- Dados privados locais: cada banco tem os próprios dados de transações privados e criptografados, que incluem rótulos de fraude. Esses dados brutos nunca saem do ambiente local do banco, o que ajuda a proteger a privacidade dos dados.
- Protocolo de agregação segura (mostrado pelas setas azuis pontilhadas de entrada de cada banco para o cluster do TEE): o servidor de aprendizado federado não precisa acessar a atualização de nenhum banco individual para treinar o modelo. O servidor requer apenas as médias ponderadas por elemento dos vetores de atualização, extraídas de um subconjunto aleatório de bancos ou sites. Ao usar um protocolo de agregação segura para calcular essas médias ponderadas, o servidor aprende apenas as atualizações de modelo agregadas do subconjunto selecionado, em vez de qual banco específico contribuiu com uma determinada atualização. Essa abordagem ajuda a preservar a privacidade de cada participante no processo de aprendizado federado.
- Modelo global treinado para fraudes e pesos agregados (mostrados pelas setas verdes de saída do cluster do TEE para cada banco): o modelo de detecção de fraudes aprimorado, junto com os pesos aprendidos, é enviado de volta com segurança aos bancos participantes. Os bancos podem implantar esse modelo aprimorado localmente para detecção de fraudes nas próprias transações.
A seguir
- Implemente a computação confidencial e o Confidential Space no seu ambiente.
- Saiba mais sobre os fundamentos da Computação confidencial no Google Cloud.
- Saiba como proteger um modelo de ML no Confidential Space.
- Leia sobre IA médica com foco em privacidade com o MedPerf e o Google Cloud.
- Leia sobre como impulsionar a próxima era da IA confidencial.