


Managed Airflow (Gen 3) | Managed Airflow (Gen 2) | Managed Airflow (Legacy Gen 1)
Questo tutorial mostra come utilizzare Managed Service per Apache Airflow per creare un DAG (grafo diretto aciclico) di Apache Airflow che esegue un job di conteggio parole di Apache Hadoop su un cluster Managed Service for Apache Spark.
Obiettivi
- Accedi all'ambiente Managed Airflow e utilizza la UI di Airflow.
- Crea e visualizza le variabili di ambiente di Airflow.
- Crea ed esegui un DAG che includa le seguenti attività:
- Crea un cluster Managed Service for Apache Spark.
- Esegue un job di conteggio parole di Apache Hadoop sul cluster.
- Genera l'output dei risultati del conteggio parole in un Cloud Storage bucket.
- Elimina il cluster.
Costi
In questo documento vengono utilizzati i seguenti componenti fatturabili di Google Cloud:
- Managed Airflow
- Managed Service for Apache Spark
- Cloud Storage
Per generare una stima dei costi in base all'utilizzo previsto,
utilizza il calcolatore prezzi.
Prima di iniziare
Assicurati che le seguenti API siano abilitate nel tuo progetto:
Console
Abilita le API Managed Service for Apache Spark e Cloud Storage.
Ruoli richiesti per abilitare le API
Per abilitare le API, devi disporre dell'autorizzazione
serviceusage.services.enable. Se hai creato il progetto, probabilmente hai già questa autorizzazione tramite il ruolo Proprietario (roles/owner). In caso contrario, puoi ottenere questa autorizzazione tramite il ruolo Amministratore utilizzo servizi (roles/serviceusage.serviceUsageAdmin). Scopri come concedere i ruoli.gcloud
Abilita le API Managed Service for Apache Spark e Cloud Storage:
Ruoli richiesti per abilitare le API
Per abilitare le API, devi disporre dell'autorizzazione
serviceusage.services.enable. Se hai creato il progetto, probabilmente hai già questa autorizzazione tramite il ruolo Proprietario (roles/owner). In caso contrario, puoi ottenere questa autorizzazione tramite il ruolo Amministratore Service Usage (roles/serviceusage.serviceUsageAdmin). Scopri come concedere i ruoli.gcloud services enable dataproc.googleapis.com
storage-component.googleapis.com Nel tuo progetto, crea un bucket Cloud Storage di qualsiasi classe di archiviazione e regione per archiviare i risultati del job di conteggio parole di Hadoop.
Prendi nota del percorso del bucket che hai creato, ad esempio
gs://example-bucket. Definirai una variabile Airflow per questo percorso e la utilizzerai nel DAG di esempio più avanti in questo tutorial.Crea un ambiente Managed Airflow con i parametri predefiniti. Attendi il completamento della creazione dell'ambiente. Al termine, viene visualizzato il segno di spunta verde a sinistra del nome dell'ambiente.
Prendi nota della regione in cui hai creato l'ambiente, ad esempio
us-central. Definirai una variabile Airflow per questa regione e la utilizzerai nel DAG di esempio per eseguire un cluster Managed Service for Apache Spark nella stessa regione.
Imposta le variabili Airflow
Imposta le variabili Airflow da utilizzare in un secondo momento nel DAG di esempio. Ad esempio, puoi impostare le variabili Airflow nella UI di Airflow.
| Variabile Airflow | Valore |
|---|---|
gcp_project
|
L'ID progetto del progetto
che stai utilizzando per questo tutorial, ad esempio example-project. |
gcs_bucket
|
L'URI del bucket Cloud Storage che hai creato per questo tutorial,
ad esempio gs://example-bucket |
gce_region
|
La regione in cui hai creato l'ambiente, ad esempio us-central1.
Questa è la regione in cui verrà creato il cluster Managed Service for Apache Spark. |
Visualizza il workflow di esempio
Un DAG di Airflow è una raccolta di attività organizzate che vuoi pianificare ed eseguire. I DAG sono definiti in file Python standard. Il codice mostrato in hadoop_tutorial.py è il codice del workflow.
Operatori
Per orchestrare le tre attività nel workflow di esempio, il DAG importa i seguenti tre operatori Airflow:
DataprocClusterCreateOperator: crea un cluster Managed Service for Apache Spark.DataProcHadoopOperator: invia un job di conteggio parole di Hadoop e scrive i risultati in un bucket Cloud Storage.DataprocClusterDeleteOperator: elimina il cluster per evitare addebiti continui per Compute Engine.
Dipendenze
Organizza le attività che vuoi eseguire in modo da riflettere le rispettive relazioni e dipendenze. Le attività in questo DAG vengono eseguite in sequenza.
Programmazione
Il nome del DAG è composer_hadoop_tutorial e il DAG viene eseguito una volta al giorno. Poiché la start_date specificata da default_dag_args è impostata su yesterday, Managed Airflow pianifica il workflow in modo da eseguirlo subito dopo il caricamento del DAG nel bucket dell'ambiente.
Carica il DAG nel bucket dell'ambiente
Managed Airflow archivia i DAG nella cartella /dags del bucket dell'ambiente.
Per caricare il DAG:
Salva
hadoop_tutorial.pysulla tua macchina locale.Nella Google Cloud console, vai alla pagina Ambienti.
Nell'elenco degli ambienti, nella colonna Cartella DAG per il tuo ambiente, fai clic sul link DAG.
Fai clic su Carica file.
Seleziona
hadoop_tutorial.pysulla tua macchina locale e fai clic su Apri.
Managed Airflow aggiunge il DAG ad Airflow e lo pianifica automaticamente. Le modifiche ai DAG vengono applicate entro 3-5 minuti.
Esplora le esecuzioni del DAG
Visualizza lo stato dell'attività
Quando carichi il file DAG nella cartella dags/ di Cloud Storage, Managed Airflow analizza il file. Al termine, il nome del workflow viene visualizzato nell'elenco di DAG e il workflow viene messo in coda per essere eseguito immediatamente.
Per visualizzare lo stato dell'attività, vai all'interfaccia web di Airflow e fai clic su DAG nella barra degli strumenti.
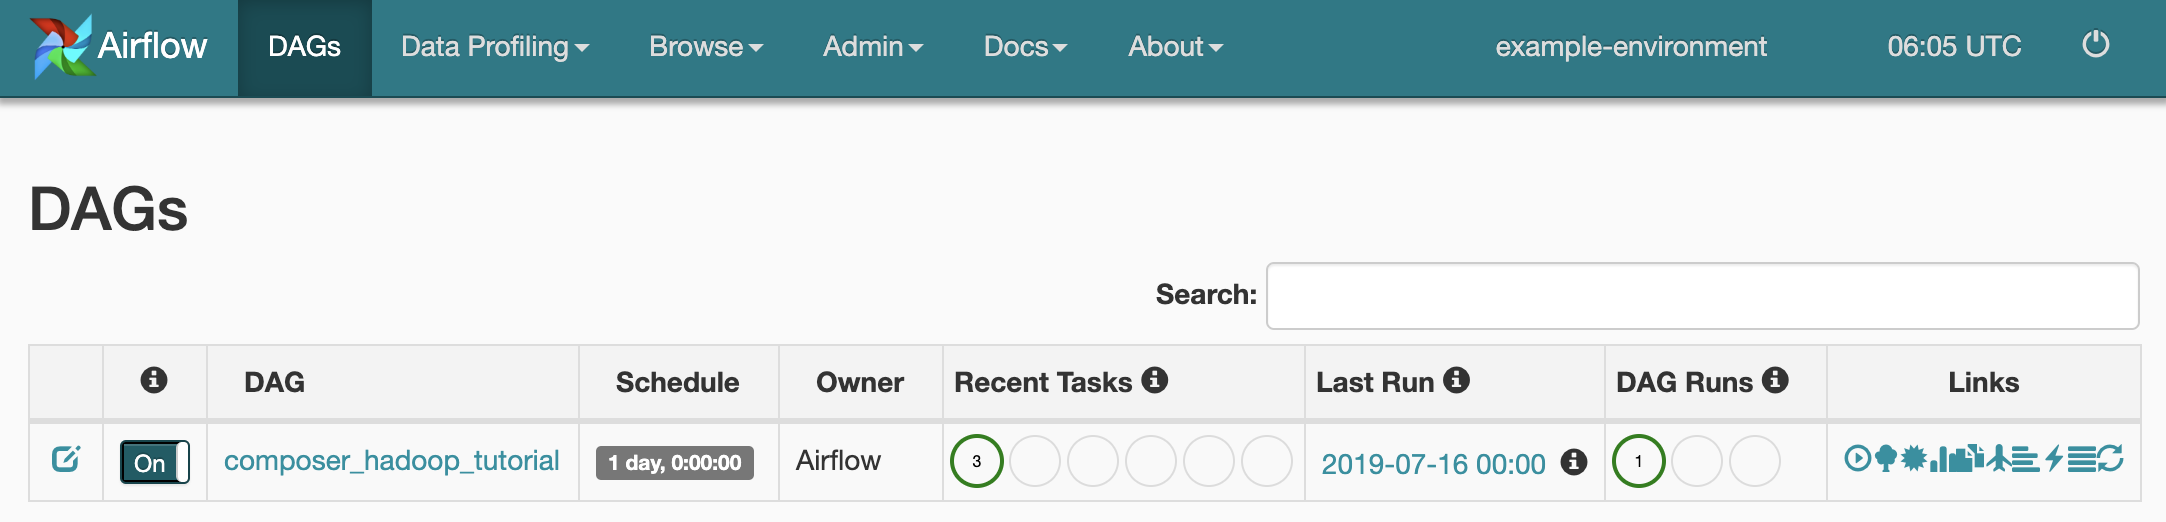
Per aprire la pagina dei dettagli del DAG, fai clic su
composer_hadoop_tutorial. Questa pagina include una rappresentazione grafica delle attività e delle dipendenze del workflow.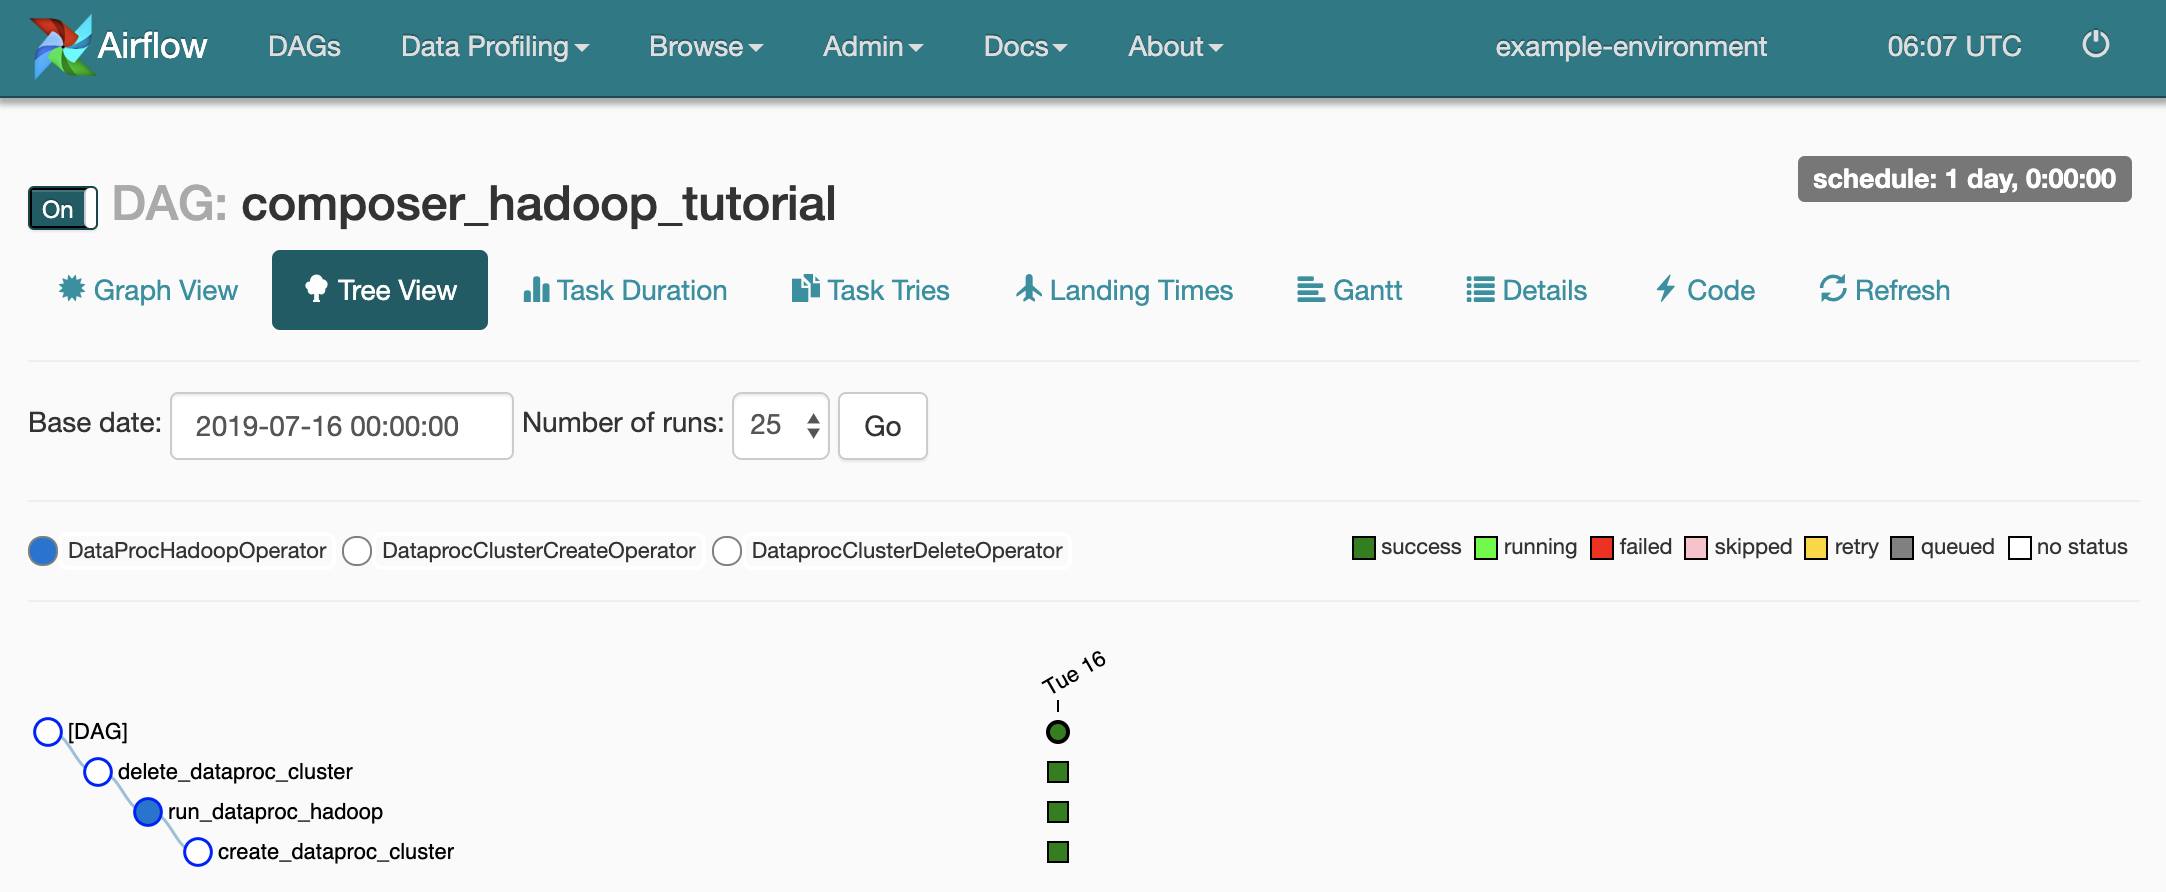
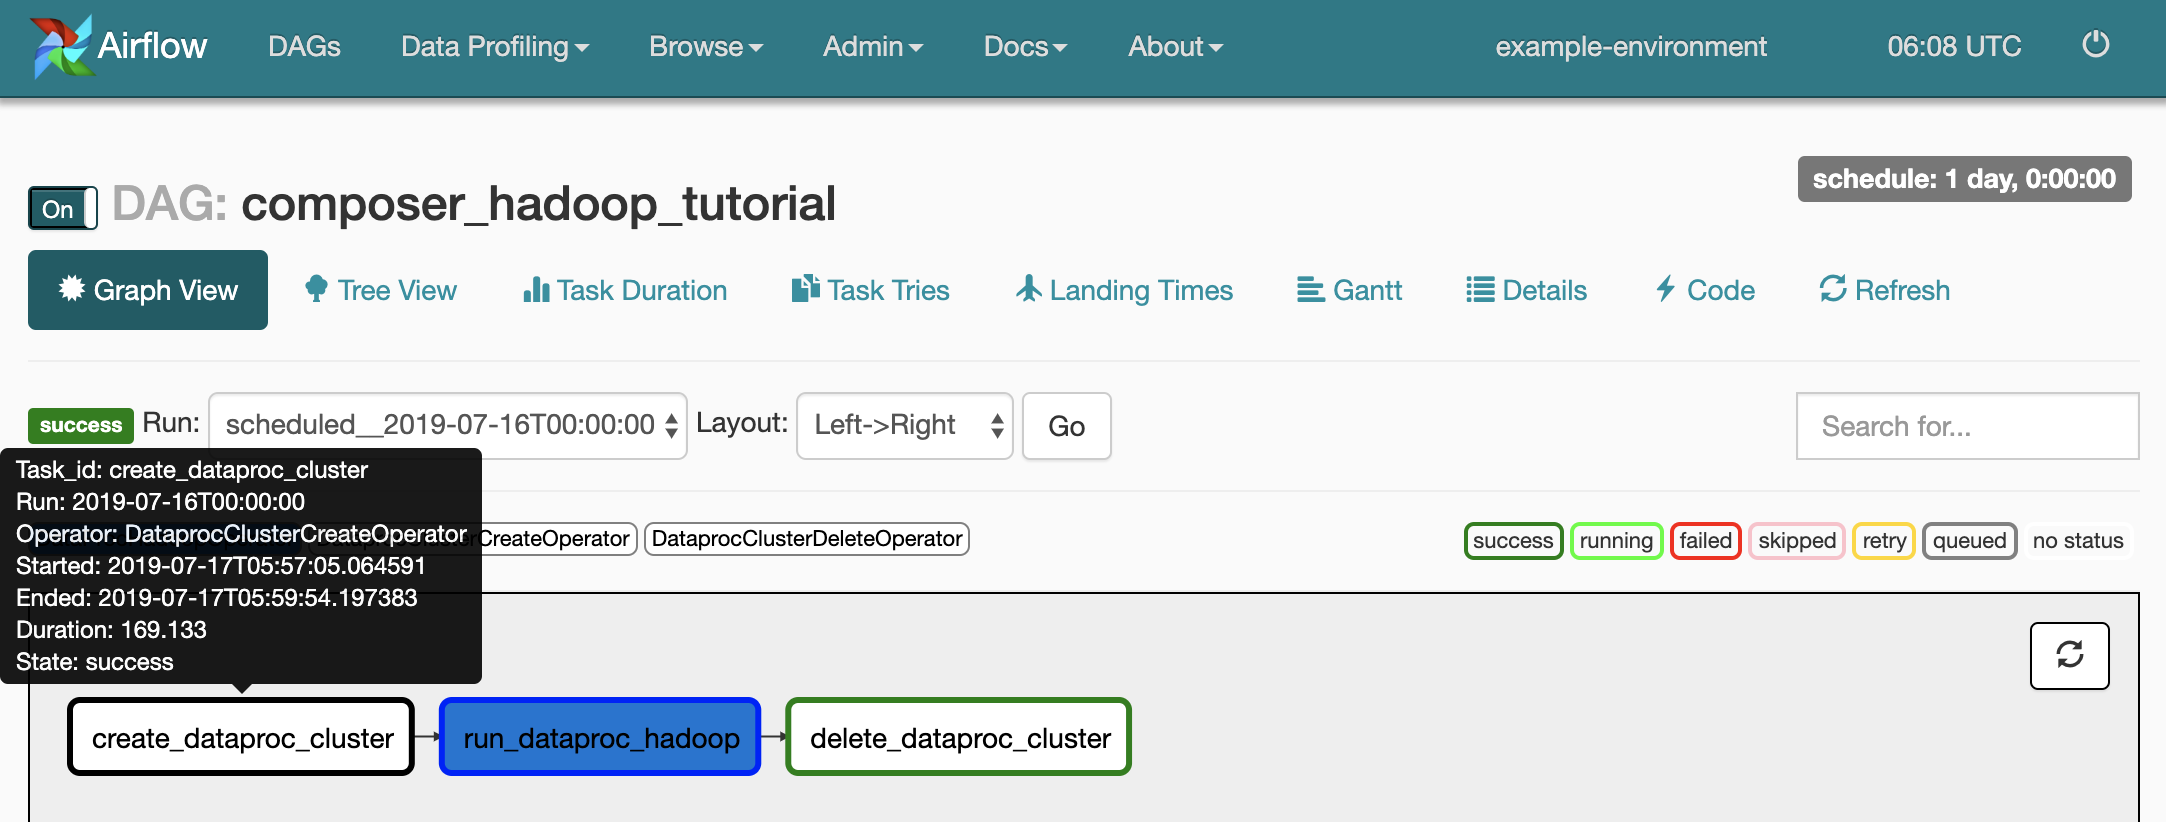
Per visualizzare lo stato di ogni attività, fai clic su Visualizzazione grafo e poi passa il mouse sopra il grafico di ogni attività.
Metti di nuovo in coda il workflow
Per eseguire di nuovo il workflow dalla visualizzazione grafo:
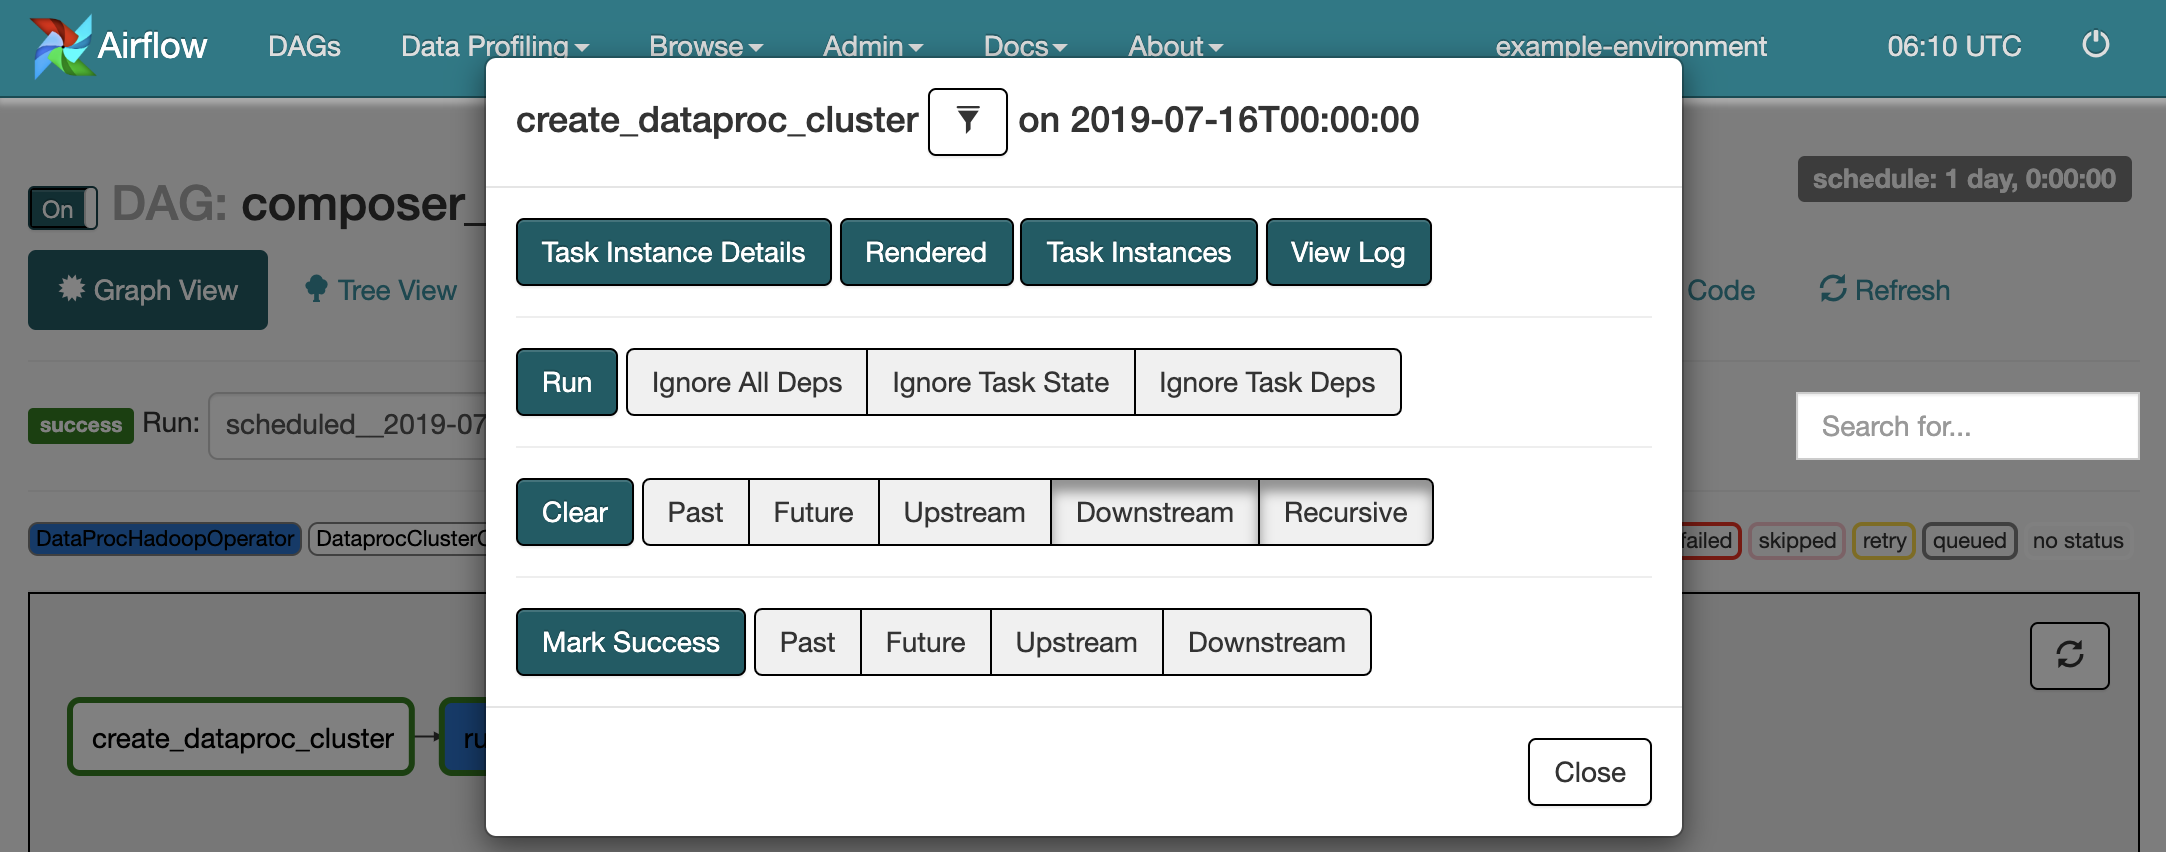
- Nella visualizzazione grafo della UI di Airflow, fai clic sul grafico
create_dataproc_cluster. - Per reimpostare le tre attività, fai clic su Cancella e poi su OK per confermare.
- Fai di nuovo clic su
create_dataproc_clusternella visualizzazione grafo. - Per mettere di nuovo in coda il workflow, fai clic su Esegui.
Visualizza i risultati dell'attività
Puoi anche controllare lo stato e i risultati del composer_hadoop_tutorial
workflow andando alle seguenti Google Cloud pagine della console:
Cluster Managed Service for Apache Spark: per monitorare la creazione e l'eliminazione dei cluster. Tieni presente che il cluster creato dal workflow è temporaneo. Esiste solo per la durata del workflow e viene eliminato dall'ultima attività del workflow.
Job Managed Service for Apache Spark: per visualizzare o monitorare il job di conteggio parole di Apache Hadoop. Fai clic sull'ID job per visualizzarne l'output del log.
Browser Cloud Storage: per visualizzare i risultati del conteggio parole in
wordcountcartella del bucket Cloud Storage che hai creato per questo tutorial.
Esegui la pulizia
Elimina le risorse utilizzate in questo tutorial:
Elimina l'ambiente Managed Airflow, incluso l'eliminazione manuale del bucket dell'ambiente.
Elimina il bucket Cloud Storage che archivia i risultati del job di conteggio parole di Hadoop.