


Le catalogue d'environnements d'exécution Lakehouse vous permet de centraliser les métadonnées des tables dans un metastore sans serveur entièrement géré, qui sert de source unique de vérité pour vos données dans Lakehouse sans frontières. Grâce aux métadonnées centralisées, les moteurs de traitement (y compris Apache Spark, Apache Flink, Apache Hive et BigQuery) peuvent partager des tables directement sans dupliquer les fichiers.
Lorsque vous configurez un point de terminaison client tel que le catalogue Apache Iceberg REST, il sert d'interface de gestion qui connecte les moteurs de requête au catalogue d'environnements d'exécution Lakehouse. Le point de terminaison gère les métadonnées des tables, et Cloud Storage stocke les fichiers de données et de métadonnées sous-jacents.
En tant que composant essentiel de Lakehouse, le catalogue d'environnements d'exécution Lakehouse offre une interopérabilité d'API ouverte et prend en charge les charges de travail d'analyse, de streaming et d'IA lorsqu'il est associé à BigQuery. Pour en savoir plus sur ces avantages architecturaux, consultez Qu'est-ce qu'un lakehouse sans frontières ?
Intégration de Lakehouse à Google Cloud
Pour comprendre comment Lakehouse gère vos données, découvrez comment l'architecture Lakehouse s'intègre aux services Google Cloud . Apache Iceberg ne stocke pas les données dans des tables monolithiques. Au lieu de cela, il utilise une architecture en couches de fichiers de métadonnées pour organiser les fichiers de données dans une structure de table cohérente avec la prise en charge des transactions ACID.
Le diagramme suivant illustre la façon dont les moteurs de calcul tels que Managed Service pour Apache Spark utilisent le catalogue d'environnements d'exécution Lakehouse pour gérer les métadonnées des tables afin de lire et d'écrire directement les fichiers de données Parquet sous-jacents dans Cloud Storage.
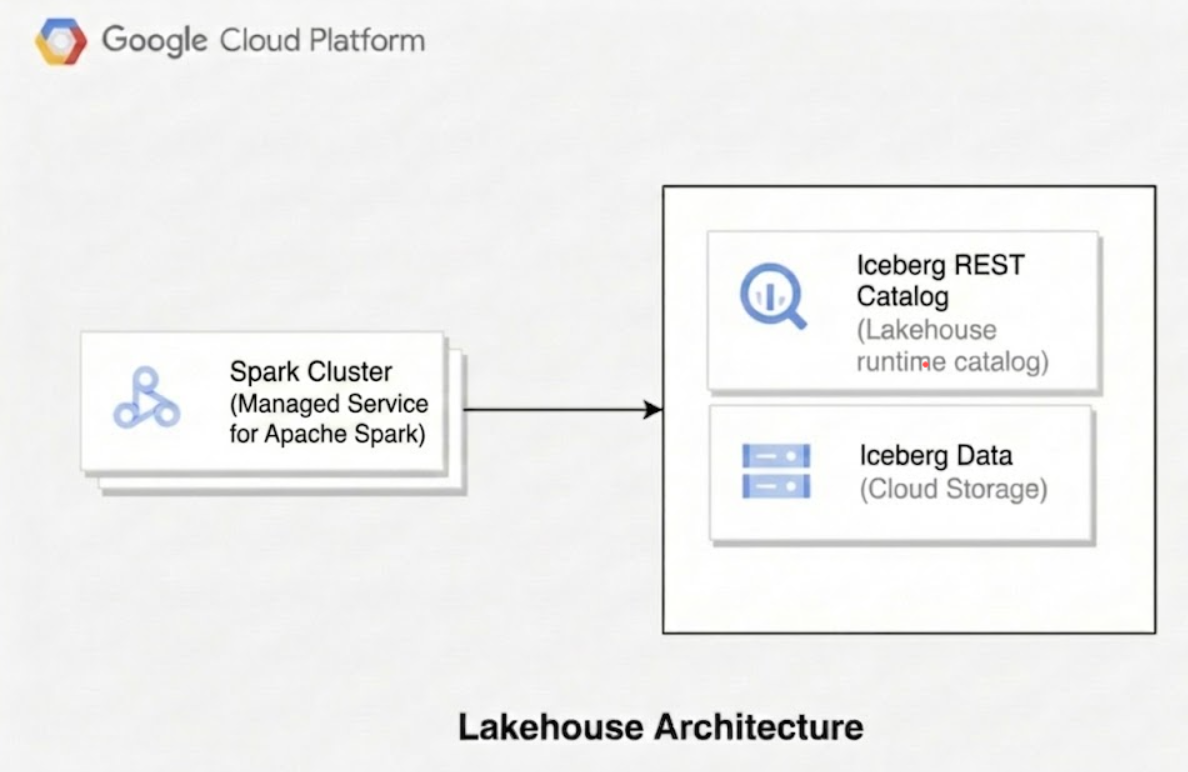
Lorsque vous utilisez Lakehouse, l'architecture technique se compose de trois couches distinctes :
Calque de catalogue :
- Concept de base d'Iceberg : le catalogue stocke l'état actuel de la table en conservant un pointeur vers le dernier fichier de métadonnées. Cette couche facilite la conformité ACID et l'isolation des transactions pour s'assurer que les écritures simultanées n'interfèrent pas les unes avec les autres.
- Implémentation Lakehouse : le catalogue d'environnements d'exécution Lakehouse sert de service de métastore régional de premier niveau. Dans ce service, vous créez des catalogues individuels pour gérer votre hiérarchie de données. Les moteurs de requête client se connectent à ces catalogues à l'aide de types de catalogues de points de terminaison spécifiques, tels que le point de terminaison Apache Iceberg REST Catalog. Le metastore gère les commits de transaction, la distribution d'identifiants pour la délégation d'accès au stockage et la gestion des pointeurs dans vos catalogues.
Couche de métadonnées :
- Concept Iceberg de base : cette couche suit la structure de la table, les instantanés et les emplacements des fichiers à l'aide d'une hiérarchie de trois types de fichiers :
- Fichiers de métadonnées : stockent le schéma de la table, les spécifications de partitionnement et un journal des pointeurs d'instantanés.
- Listes de fichiers manifestes : elles représentent un instantané unique de la table en regroupant une collection de fichiers manifestes.
- Fichiers manifestes : ils permettent de suivre les données au niveau des fichiers individuels, en stockant les chemins d'accès aux fichiers, les informations de partition et les statistiques au niveau des colonnes (par exemple, le nombre de lignes et les valeurs minimales et maximales), qui sont utilisées pour l'optimisation des requêtes et l'élimination des partitions.
- Implémentation Lakehouse : dans un conteneur de catalogue, vous organisez vos données en espaces de noms logiques (semblables aux ensembles de données) et en tables. Pour chaque table, le catalogue du Lakehouse Runtime génère et gère la hiérarchie de métadonnées Iceberg sous-jacente, en commençant par un fichier
metadata.jsonracine qui pointe vers les listes de fichiers manifestes et les fichiers manifestes. Le catalogue d'environnements d'exécution Lakehouse conserve ces fichiers directement dans l'emplacement de stockage de l'entrepôt désigné.
- Concept Iceberg de base : cette couche suit la structure de la table, les instantanés et les emplacements des fichiers à l'aide d'une hiérarchie de trois types de fichiers :
Couche de données :
- Concept Iceberg de base : ce composant est le stockage sous-jacent où résident les enregistrements de données brutes, généralement dans des formats de fichiers ouverts en colonnes ou basés sur des lignes optimisés, tels que Parquet, ORC ou Avro.
- Implémentation Lakehouse : lorsque vous configurez des emplacements d'entrepôt Cloud Storage (
gs://), les fichiers de données physiques référencés par vos tables sont stockés de manière sécurisée dans vos buckets. Le catalogue d'environnements d'exécution Lakehouse gère l'accès via la délégation d'accès au stockage (distribution d'identifiants), en distribuant des jetons d'accès de courte durée directement aux moteurs clients. Les moteurs peuvent ainsi lire et écrire des fichiers de données de manière sécurisée sans avoir besoin d'autorisations IAM étendues et directes sur les buckets sous-jacents.
Comment Lakehouse implémente l'API du catalogue REST Apache Iceberg
Le catalogue d'environnements d'exécution Lakehouse implémente l'API de catalogue REST Apache Iceberg Open Source pour gérer les espaces de noms et les tables. Il fournit également une API d'extensions spécifiquement pour la gestion des catalogues.
Les moteurs de requête client interagissent avec le metastore à l'aide de ces API de catalogue REST standards. Pour en savoir plus sur les ressources et les points de terminaison Google Cloud, consultez la documentation de référence de l'API REST Lakehouse.
Vous pouvez créer, configurer et gérer ces ressources à l'aide de la consoleGoogle Cloud , de gcloud CLI, de l'API REST ou de Terraform. Pour en savoir plus, consultez les pages suivantes :
- Gérer les ressources du catalogue REST Iceberg
- Gérer les tables Apache Iceberg
- Utiliser Terraform avec Lakehouse
- Utiliser des points de terminaison régionaux avec le catalogue d'environnements d'exécution Lakehouse
Compatibilité et configuration du moteur de requêtes
Pour analyser et gérer les données dans le catalogue d'environnements d'exécution Lakehouse, vous pouvez connecter différents moteurs de requête Open Source et d'entreprise. En fonction de votre architecture existante et des exigences de votre charge de travail, vous pouvez choisir parmi plusieurs moteurs compatibles et configurer le point de terminaison de catalogue approprié.
Moteurs compatibles
Le catalogue d'environnements d'exécution Lakehouse est compatible avec plusieurs moteurs de requête, y compris (mais sans s'y limiter) Apache Spark, Apache Flink, Apache Hive et Trino. Le tableau suivant fournit des liens vers la documentation de chaque moteur :
| Moteur | Documentation |
|---|---|
| Apache Spark | Utiliser avec Apache Spark |
| Apache Hive | Utiliser avec Spark et le catalogue Hive |
| Apache Flink | Utiliser avec Apache Flink |
| Trino | Utiliser avec Trino |
Types de catalogues et configuration des points de terminaison
Lorsque vous configurez des moteurs clients pour qu'ils se connectent au metastore du catalogue d'environnements d'exécution Lakehouse, vous sélectionnez un point de terminaison de catalogue spécifique, tel que le point de terminaison du catalogue REST Apache Iceberg ou le point de terminaison Apache Hive. La meilleure option dépend de votre cas d'utilisation, comme indiqué dans le tableau suivant :
| Cas d'utilisation | Recommandation |
|---|---|
| Nouveaux utilisateurs du catalogue d'exécution Lakehouse qui souhaitent que leur moteur Open Source accède aux données dans Cloud Storage et qui ont besoin d'une interopérabilité avec d'autres moteurs, y compris BigQuery et AlloyDB pour PostgreSQL. | Utilisez le point de terminaison du catalogue REST Apache Iceberg. |
| Les utilisateurs qui exécutent des charges de travail Apache Hive ou Spark dépendant de l'interface Hive Metastore et qui souhaitent bénéficier d'un service de metastore entièrement géré. | Utilisez le point de terminaison du catalogue Apache Hive. |
| Utilisateurs existants du catalogue d'exécution Lakehouse qui ont des tables actuelles créées avec le catalogue Apache Iceberg personnalisé pour le point de terminaison BigQuery. | Continuez à utiliser le catalogue Apache Iceberg personnalisé pour le point de terminaison BigQuery, mais utilisez le catalogue REST Apache Iceberg pour les nouveaux workflows. |
Limites du catalogue d'environnements d'exécution Lakehouse
Les limites générales suivantes s'appliquent aux tables du catalogue du runtime Lakehouse lorsque vous les interrogez via BigQuery. Les points de terminaison de catalogue individuels (tels qu'Apache Iceberg REST ou Apache Hive) peuvent présenter des limites supplémentaires spécifiques aux points de terminaison.
Gestion des tableaux
- Les tables Apache Iceberg V2 (disponibilité générale) et V3 (preview) sont prises en charge. Les tables Iceberg V1 ne sont pas acceptées. Avant d'utiliser des tables V1 existantes avec le catalogue d'environnements d'exécution Lakehouse, vous devez les mettre à niveau vers une version compatible. Pour en savoir plus, consultez Mettre à niveau les tables Iceberg V1 vers V2.
- Les tables du catalogue du runtime Lakehouse ne sont pas compatibles avec les opérations de renommage ni avec l'instruction SparkSQL
ALTER TABLE ... RENAME TO. - Les tables du catalogue d'environnements d'exécution Lakehouse ne sont pas compatibles avec le clustering.
- Les tables du catalogue d'environnements d'exécution Lakehouse ne sont pas compatibles avec les noms de colonnes flexibles.
Le catalogue d'environnements d'exécution Lakehouse n'est pas compatible avec les vues de base de données ni de metastore.
Le catalogue d'environnements d'exécution Lakehouse n'est pas compatible avec les vues Apache Iceberg.
Requête
- Les performances des requêtes portant sur des tables du catalogue d'exécution Lakehouse à partir du moteur BigQuery peuvent être ralenties par rapport aux requêtes sur des données dans des tables BigQuery standards. En général, la vitesse des requêtes doit être équivalente à celle de la lecture des données depuis Cloud Storage.
- Une simulation BigQuery d'une requête qui utilise une table dans le catalogue du runtime Lakehouse peut indiquer une limite inférieure de 0 octet de données, même si des lignes sont renvoyées. Ce résultat se produit, car il est impossible de déterminer la quantité de données traitées à partir de la table tant que la requête complète n'est pas exécutée. L'exécution de la requête entraîne des frais pour le traitement de ces données.
- Vous ne pouvez pas référencer une table du catalogue d'environnements d'exécution Lakehouse dans une requête de table générique.
API et métadonnées
- Vous ne pouvez pas utiliser la méthode
tabledata.listpour récupérer des données à partir de tables du catalogue d'environnements d'exécution Lakehouse. Vous pouvez enregistrer les résultats de la requête dans une table BigQuery, puis utiliser la méthodetabledata.listsur cette table. - L'affichage des statistiques de stockage de tables pour les tables du catalogue du runtime Lakehouse n'est pas pris en charge.
Quotas et limites
- Les tables du catalogue d'exécution Lakehouse dans BigQuery sont soumises aux mêmes quotas et limites que les tables standards.
Différences avec BigLake Metastore (version classique)
Voici les principales différences entre le catalogue du runtime Lakehouse et le metastore BigLake (classique) :
- Le catalogue d'environnements d'exécution Lakehouse est compatible avec une intégration directe aux moteurs Open Source tels que Spark, ce qui permet de réduire la redondance lorsque vous stockez des métadonnées et exécutez des jobs. Les tables du catalogue d'environnements d'exécution Lakehouse sont directement accessibles à partir de plusieurs moteurs Open Source et de BigQuery.
- Le catalogue d'environnements d'exécution Lakehouse est compatible avec le point de terminaison du catalogue REST Apache Iceberg, contrairement au métastore BigLake (classique).
Étapes suivantes
- Comprendre le point de terminaison du catalogue REST Apache Iceberg.
- Configurez des points de terminaison régionaux.