


Lakehouse ランタイム カタログを使用すると、フルマネージドのサーバーレス metastore にテーブル メタデータを一元化できます。この metastore は、ボーダーレスな Lakehouse のデータの信頼できる唯一の情報源となります。メタデータを一元化することで、Apache Spark、Apache Flink、Apache Hive、BigQuery などの処理エンジンは、ファイルを複製することなくテーブルを直接共有できます。
Apache Iceberg REST カタログ エンドポイントなどのクライアント エンドポイントを構成すると、クエリエンジンを Lakehouse ランタイム カタログに接続する管理インターフェースとして機能します。エンドポイントはテーブル メタデータを処理し、Cloud Storage は基盤となるメタデータとデータファイルを保存します。
レイクハウス ランタイム カタログは、レイクハウスの中核コンポーネントとして、オープン API の相互運用性を提供し、BigQuery と組み合わせることで、分析、ストリーミング、AI ワークロードをサポートします。これらのアーキテクチャ上のメリットの詳細については、ボーダーレスな Lakehouse とはをご覧ください。
レイクハウスと Google Cloudの統合
Lakehouse がデータを管理する方法については、Lakehouse アーキテクチャと Google Cloud サービスの統合方法をご覧ください。Apache Iceberg は、モノリシック テーブルにデータを保存しません。代わりに、メタデータ ファイルの階層型アーキテクチャを使用して、ACID トランザクションをサポートする一貫したテーブル構造にデータファイルを整理します。
次の図は、Managed Service for Apache Spark などのコンピューティング エンジンが Lakehouse ランタイム カタログを使用してテーブル メタデータを管理し、Cloud Storage で基盤となる Parquet データファイルを直接読み書きする方法を示しています。
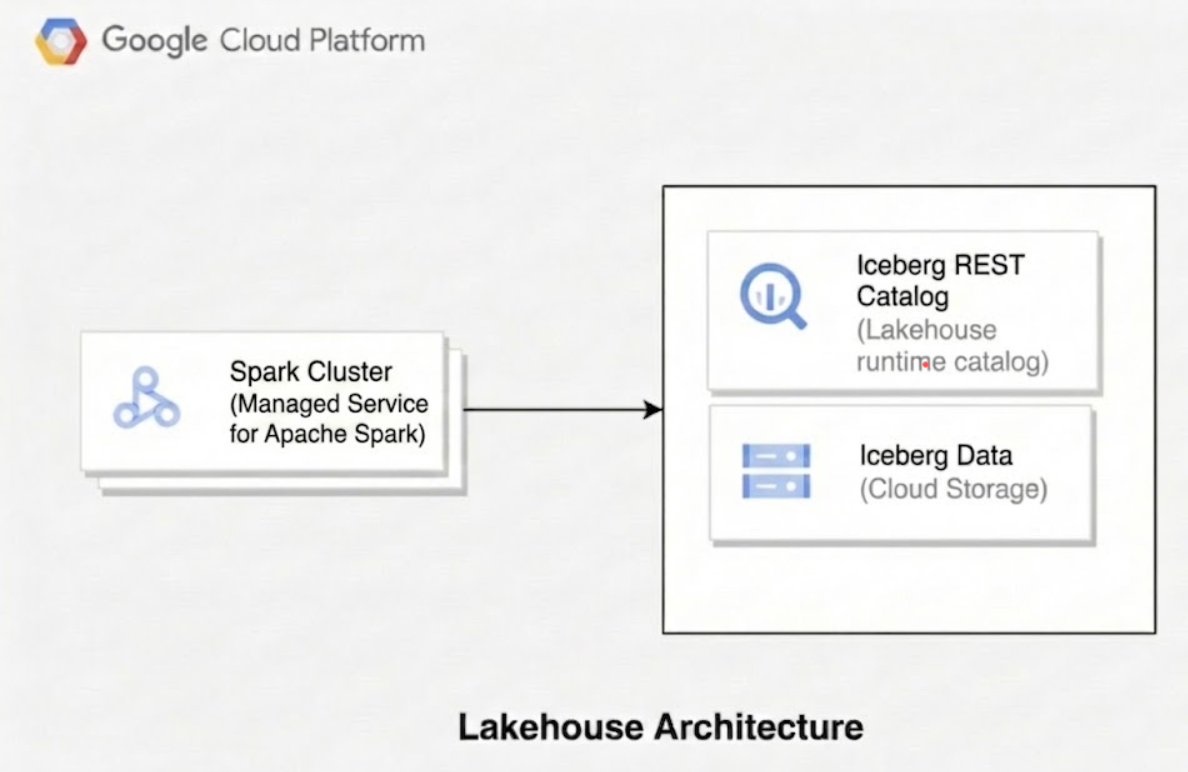
レイクハウスを使用する場合、技術アーキテクチャは次の 3 つのレイヤで構成されます。
カタログレイヤ:
- Iceberg のコアコンセプト: カタログは、最新のメタデータ ファイルへのポインタを維持することで、テーブルの現在の状態を保存します。このレイヤは、ACID コンプライアンスとトランザクション分離を容易にし、同時書き込みが互いに干渉しないようにします。
- Lakehouse の実装: Lakehouse ランタイム カタログは、最上位のリージョン metastore サービスとして機能します。このサービス内で、個々のカタログを作成してデータ階層を管理します。クライアント クエリエンジンは、Apache Iceberg REST カタログ エンドポイントなどの特定のエンドポイント カタログ タイプを使用して、これらのカタログに接続します。メタストアは、トランザクションの commit、ストレージ アクセスの委任のための認証情報の提供、カタログ全体のポインタ管理を管理します。
メタデータ レイヤ:
- Iceberg のコアコンセプト: このレイヤは、3 つのファイル形式の階層を使用して、テーブル構造、スナップショット、ファイルの場所を追跡します。
- メタデータ ファイル: テーブルのスキーマ、パーティション仕様、スナップショット ポインタのログを保存します。
- マニフェスト リスト: マニフェスト ファイルのコレクションをグループ化して、テーブルの単一のスナップショットを表します。
- マニフェスト ファイル: 個々のファイルレベルでデータを追跡し、ファイルパス、パーティション情報、列レベルの統計情報(行数、最小値、最大値など)を保存します。これらは、クエリの最適化とパーティション プルーニングに使用されます。
- レイクハウスの実装: カタログ コンテナ内で、データを論理的な名前空間(データセットと同様)とテーブルに整理します。各テーブルについて、Lakehouse ランタイム カタログは、マニフェスト リストとマニフェスト ファイルを指すルート
metadata.jsonファイルから始まる、基盤となる Iceberg メタデータ階層を生成して管理します。Lakehouse ランタイム カタログは、これらのファイルを指定されたウェアハウス ストレージの場所に直接永続化します。
- Iceberg のコアコンセプト: このレイヤは、3 つのファイル形式の階層を使用して、テーブル構造、スナップショット、ファイルの場所を追跡します。
データレイヤ:
- Iceberg のコアコンセプト: このコンポーネントは、実際の元データレコードが存在する基盤となるストレージです。通常は、Parquet、ORC、Avro などの最適化された列指向または行ベースのオープン ファイル形式で保存されます。
- レイクハウスの実装: Cloud Storage ウェアハウスのロケーション(
gs://)を構成すると、テーブルによって参照される物理データファイルがバケット内に安全に保存されます。Lakehouse ランタイム カタログは、ストレージ アクセスの委任(認証情報の払い出し)を介してアクセスを管理し、有効期間の短いアクセス トークンをクライアント エンジンに直接払い出します。これにより、エンジンは、基盤となるバケットに対する広範な直接 IAM 権限を必要とせずに、データファイルを安全に読み書きできます。
Lakehouse が Apache Iceberg REST Catalog API を実装する方法
Lakehouse ランタイム カタログは、オープンソースの Apache Iceberg REST Catalog API を実装して、名前空間とテーブルを管理します。また、カタログ管理専用の Extensions API も提供しています。
クライアント クエリエンジンは、これらの標準 REST カタログ API を使用して metastore とやり取りします。Google Cloud のリソースとエンドポイントの詳細については、Lakehouse REST API リファレンスをご覧ください。
これらのリソースは、Google Cloud コンソール、gcloud CLI、REST API、または Terraform を使用して作成、構成、管理できます。詳しくは次のページをご覧ください。
- Iceberg REST カタログ リソースを管理する
- Apache Iceberg テーブルを管理する
- Lakehouse で Terraform を使用する
- Lakehouse ランタイム カタログでリージョン エンドポイントを使用する
クエリエンジンの互換性と構成
Lakehouse ランタイム カタログのデータを分析して管理するには、さまざまなオープンソース クエリエンジンとエンタープライズ クエリエンジンを接続します。既存のアーキテクチャとワークロードの要件に応じて、サポートされている複数のエンジンから選択し、適切なカタログ エンドポイントを構成できます。
サポートされているエンジン
Lakehouse ランタイム カタログは、Apache Spark、Apache Flink、Apache Hive、Trino などの複数のクエリエンジンと互換性があります。次の表に、各エンジンのドキュメントへのリンクを示します。
| エンジン | ドキュメント |
|---|---|
| Apache Spark | Apache Spark で使用する |
| Apache Hive | Spark と Hive カタログで使用する |
| Apache Flink | Apache Flink で使用する |
| Trino | Trino で使用する |
カタログの種類とエンドポイントの構成
Lakehouse ランタイム カタログの metastore に接続するようにクライアント エンジンを構成する場合は、Apache Iceberg REST カタログ エンドポイントや Apache Hive エンドポイントなど、特定のカタログ エンドポイントを選択します。次の表に示すように、最適なオプションはユースケースによって異なります。
| ユースケース | 推奨事項 |
|---|---|
| オープンソース エンジンが Cloud Storage のデータにアクセスできるようにし、BigQuery や AlloyDB for PostgreSQL などの他のエンジンとの相互運用性を必要とする、新しい Lakehouse ランタイム カタログ ユーザー。 | Apache Iceberg REST カタログ エンドポイントを使用します。 |
| Hive Metastore インターフェースに依存する Apache Hive または Spark ワークロードを実行し、フルマネージドのメタストア サービスを必要とするユーザー。 | Apache Hive カタログ エンドポイントを使用します。 |
| BigQuery エンドポイントのカスタム Apache Iceberg カタログで作成された現在のテーブルを使用している既存の Lakehouse ランタイム カタログ ユーザー。 | BigQuery エンドポイント用のカスタム Apache Iceberg カタログを引き続き使用しますが、新しいワークフローには Apache Iceberg REST カタログを使用します。 |
Lakehouse ランタイム カタログの制限事項
BigQuery を介してクエリを実行する場合、Lakehouse ランタイム カタログのテーブルには次の一般的な制限が適用されます。個々のカタログ エンドポイント(Apache Iceberg REST や Apache Hive など)には、エンドポイント固有の追加の制限がある場合があります。
テーブル管理
- Apache Iceberg V2 テーブル(一般提供)と V3 テーブル(プレビュー)がサポートされています。Iceberg V1 テーブルはサポートされていません。Lakehouse ランタイム カタログで既存の V1 テーブルを使用する前に、サポートされているバージョンにアップグレードする必要があります。詳細については、Iceberg V1 テーブルを V2 にアップグレードするをご覧ください。
- Lakehouse ランタイム カタログのテーブルは、名前変更オペレーションや
ALTER TABLE ... RENAME TOSpark SQL ステートメントをサポートしていません。 - Lakehouse ランタイム カタログのテーブルはクラスタリングをサポートしていません。
- Lakehouse ランタイム カタログのテーブルは、抽出ジョブをサポートしていません。この制限は、
EXPORT DATAステートメントとbq extractCLI コマンドの両方に適用されます。 - Lakehouse ランタイム カタログは、データベース ビューまたは metastore ビューをサポートしていません。
- Lakehouse ランタイム カタログは、Apache Iceberg ビューをサポートしていません。
クエリ
- BigQuery エンジンから Lakehouse ランタイム カタログのテーブルに対するクエリのパフォーマンスは、標準の BigQuery テーブルのデータに対するクエリよりも低速になる可能性があります。一般的に、クエリ速度は Cloud Storage からのデータ読み取りと同等になります。
- Lakehouse ランタイム カタログのテーブルを使用するクエリの BigQuery ドライランで、行が返されても、下限 0 バイトと報告される場合があります。これは、クエリ全体が実行されるまで、テーブルから処理されるデータの量を決定できないためです。連携クエリを実行すると、このデータの処理に費用がかかります。
- ワイルドカード テーブルのクエリで Lakehouse ランタイム カタログのテーブルを参照することはできません。
API とメタデータ
tabledata.listメソッドを使用して、Lakehouse ランタイム カタログのテーブルからデータを取得することはできません。代わりに、クエリ結果を BigQuery テーブルに保存し、そのテーブルでtabledata.listメソッドを使用できます。- Lakehouse ランタイム カタログ内のテーブルのテーブル ストレージ統計情報の表示はサポートされていません。
割り当てと上限
- BigQuery の Lakehouse ランタイム カタログのテーブルには、標準テーブルと同じ割り当てと上限が適用されます。
BigLake metastore(クラシック)との違い
Lakehouse ランタイム カタログと BigLake metastore(クラシック)の主な違いは次のとおりです。
- Lakehouse ランタイム カタログは、Spark などのオープンソース エンジンとの直接統合をサポートしているため、メタデータの保存とジョブの実行時の冗長性を軽減できます。Lakehouse ランタイム カタログのテーブルには、複数のオープンソース エンジンと BigQuery から直接アクセスできます。
- Lakehouse ランタイム カタログは Apache Iceberg REST カタログ エンドポイントをサポートしていますが、BigLake metastore(クラシック)はサポートしていません。
次のステップ
- Apache Iceberg REST カタログ エンドポイントについて理解する。
- リージョン エンドポイントを構成する。