


El catálogo de entornos de ejecución de Lakehouse te permite centralizar los metadatos de las tablas en un metastore sin servidores y completamente administrado que funciona como una fuente única de información para tus datos en Lakehouse sin fronteras. Con los metadatos centralizados, los motores de procesamiento, incluidos Apache Spark, Apache Flink, Apache Hive y BigQuery, pueden compartir tablas directamente sin duplicar archivos.
Cuando configuras un extremo de cliente, como el extremo del catálogo de REST de Apache Iceberg, este actúa como una interfaz de administración que conecta los motores de consulta con el catálogo de tiempo de ejecución de Lakehouse. El extremo controla los metadatos de la tabla, y Cloud Storage almacena los archivos de datos y metadatos subyacentes.
Como componente central de Lakehouse, el catálogo de tiempo de ejecución de Lakehouse proporciona interoperabilidad de API abierta y admite cargas de trabajo de análisis, transmisión y de IA cuando se vincula con BigQuery. Para obtener más información sobre estos beneficios arquitectónicos, consulta ¿Qué es Lakehouse sin fronteras?
Cómo se integra Lakehouse con Google Cloud
Para comprender cómo Lakehouse administra tus datos, consulta cómo se integra la arquitectura de Lakehouse en los servicios de Google Cloud . Apache Iceberg no almacena datos en tablas monolíticas. En su lugar, usa una arquitectura en capas de archivos de metadatos para organizar los archivos de datos en una estructura de tabla coherente con compatibilidad con transacciones ACID.
En el siguiente diagrama, se ilustra cómo los motores de procesamiento, como Managed Service para Apache Spark, usan el catálogo de tiempo de ejecución de Lakehouse para administrar los metadatos de las tablas y leer y escribir archivos de datos de Parquet subyacentes directamente en Cloud Storage.
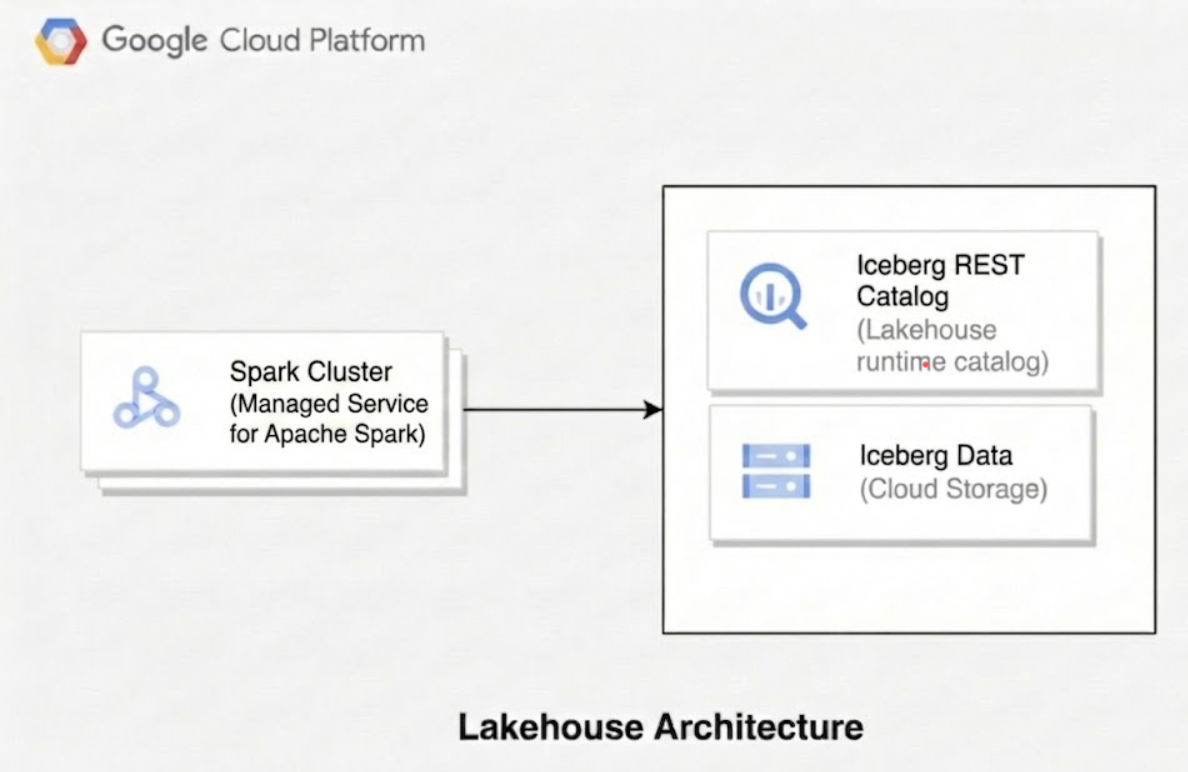
Cuando usas Lakehouse, la arquitectura técnica consta de tres capas distintas:
Capa de catálogo:
- Concepto principal de Iceberg: El catálogo almacena el estado actual de la tabla manteniendo un puntero al archivo de metadatos más reciente. Esta capa facilita el cumplimiento de ACID y el aislamiento de transacciones para garantizar que las escrituras simultáneas no interfieran entre sí.
- Implementación de Lakehouse: El catálogo de tiempo de ejecución de Lakehouse actúa como el servicio de metastore regional de nivel superior. En este servicio, creas catálogos individuales para administrar tu jerarquía de datos. Los motores de consulta de cliente se conectan a estos catálogos con tipos de catálogos de extremos específicos, como el extremo del catálogo de REST de Apache Iceberg. El almacén de metadatos administra las confirmaciones de transacciones, la venta de credenciales para la delegación de acceso al almacenamiento y la administración de punteros en tus catálogos.
Capa de metadatos:
- Concepto central de Iceberg: Esta capa hace un seguimiento de la estructura de la tabla,
las instantáneas y las ubicaciones de los archivos con una jerarquía de tres tipos de archivos:
- Archivos de metadatos: Almacenan el esquema de la tabla, la especificación de la partición y un registro de punteros de instantáneas.
- Listas de manifiestos: Representan una sola instantánea de la tabla agrupando una colección de archivos de manifiesto.
- Archivos de manifiesto: Realizan un seguimiento de los datos a nivel de archivo individual, almacenan rutas de acceso de archivos, información de partición y estadísticas a nivel de columna, por ejemplo, recuentos de filas y valores mínimos y máximos, que se usan para la optimización de consultas y la reducción de particiones.
- Implementación de Lakehouse: Dentro de un contenedor de catálogo,
organizas tus datos en espacios de nombres lógicos (similares a
los conjuntos de datos) y tablas. Para cada tabla, el
catálogo de tiempo de ejecución de Lakehouse genera y administra la
jerarquía de metadatos de Iceberg subyacente, comenzando con un archivo
metadata.jsonraíz que apunta a las listas de manifiestos y a los archivos de manifiesto. El catálogo de tiempo de ejecución de Lakehouse conserva estos archivos directamente en la ubicación de almacenamiento del almacén que designaste.
- Concepto central de Iceberg: Esta capa hace un seguimiento de la estructura de la tabla,
las instantáneas y las ubicaciones de los archivos con una jerarquía de tres tipos de archivos:
Capa de datos:
- Concepto principal de Iceberg: Este componente es el almacenamiento subyacente en el que residen los registros de datos sin procesar, por lo general, en formatos de archivo abiertos optimizados basados en columnas o filas, como Parquet, ORC o Avro.
- Implementación de Lakehouse: Cuando configuras las ubicaciones del almacén de Cloud Storage (
gs://), los archivos de datos físicos a los que hacen referencia tus tablas se almacenan de forma segura en tus buckets. El catálogo de tiempo de ejecución de Lakehouse administra el acceso a través de la delegación de acceso al almacenamiento (venta de credenciales), que vende tokens de acceso de corta duración directamente a los motores de los clientes. Esto permite que los motores lean y escriban archivos de datos de forma segura sin necesidad de tener permisos de IAM amplios y directos en los buckets subyacentes.
Cómo Lakehouse implementa la API de catálogo de REST de Apache Iceberg
El catálogo de tiempo de ejecución de Lakehouse implementa la API de catálogo de REST de Apache Iceberg de código abierto para administrar espacios de nombres y tablas. También proporciona una API de extensiones específicamente para la administración de catálogos.
Los motores de consulta de cliente interactúan con el almacén de metadatos con estas APIs de catálogo de REST estándar. Para obtener detalles sobre los recursos y extremos de Google Cloud, consulta la referencia de la API de REST de Lakehouse.
Puedes crear, configurar y administrar estos recursos con la consola deGoogle Cloud , gcloud CLI, la API de REST o Terraform. Si deseas obtener más información, consulta las siguientes páginas:
- Administra los recursos del catálogo de REST de Iceberg
- Administra tablas de Apache Iceberg
- Usa Terraform con Lakehouse
- Usa extremos regionales con el catálogo de entorno de ejecución de Lakehouse
Compatibilidad y configuración del motor de consultas
Para analizar y administrar datos en el catálogo de entorno de ejecución de Lakehouse, puedes conectar diferentes motores de consulta empresariales y de código abierto. Según tu arquitectura existente y los requisitos de la carga de trabajo, puedes elegir entre varios motores compatibles y configurar el extremo de catálogo adecuado.
Motores compatibles
El catálogo de tiempo de ejecución de Lakehouse es compatible con varios motores de consulta, incluidos Apache Spark, Apache Flink, Apache Hive y Trino, entre otros. En la siguiente tabla, se proporcionan vínculos a la documentación de cada motor:
| Motor | Documentación |
|---|---|
| Apache Spark | Usa con Apache Spark |
| Apache Hive | Usa con Spark y el catálogo de Hive |
| Apache Flink | Usa con Apache Flink |
| Trino | Usa con Trino |
Tipos de catálogos y configuración de extremos
Cuando configuras los motores de cliente para que se conecten al metastore del catálogo de tiempo de ejecución de Lakehouse, seleccionas un extremo de catálogo específico, como el extremo del catálogo de REST de Apache Iceberg o el extremo de Apache Hive. La mejor opción depende de tu caso de uso, como se muestra en la siguiente tabla:
| Caso práctico | Recomendación |
|---|---|
| Usuarios nuevos del catálogo de tiempo de ejecución de Lakehouse que quieren que su motor de código abierto acceda a los datos en Cloud Storage y necesitan interoperabilidad con otros motores, incluidos BigQuery y AlloyDB para PostgreSQL. | Usa el extremo del catálogo de REST de Apache Iceberg. |
| Usuarios que ejecutan cargas de trabajo de Apache Hive o Spark que dependen de la interfaz de Hive Metastore y quieren un servicio de almacén de metadatos completamente administrado. | Usa el extremo del catálogo de Apache Hive. |
| Usuarios existentes del catálogo de entorno de ejecución de Lakehouse que tienen tablas actuales creadas con el catálogo personalizado de Apache Iceberg para el extremo de BigQuery. | Seguir usando el extremo del catálogo personalizado de Apache Iceberg para BigQuery, pero usar el catálogo de REST de Apache Iceberg para los flujos de trabajo nuevos |
Limitaciones del catálogo de tiempo de ejecución de Lakehouse
Las siguientes limitaciones generales se aplican a las tablas del catálogo de tiempo de ejecución de Lakehouse cuando se consultan a través de BigQuery. Los extremos de catálogo individuales (como Apache Iceberg REST o Apache Hive) pueden tener limitaciones adicionales específicas de cada extremo.
Administración de mesas
- Se admiten las tablas de Apache Iceberg V2 (DG) y V3 (versión preliminar). No se admiten las tablas de Iceberg V1. Antes de usar las tablas de V1 existentes con el catálogo de entorno de ejecución de Lakehouse, debes actualizarlas a una versión compatible. Para obtener más información, consulta Actualiza las tablas de Iceberg V1 a V2.
- Las tablas del catálogo de entorno de ejecución de Lakehouse no admiten
operaciones de cambio de nombre ni la
instrucción de SQL de Spark
ALTER TABLE ... RENAME TO. - Las tablas del catálogo de entorno de ejecución de Lakehouse no admiten el agrupamiento en clústeres.
- Las tablas del catálogo de tiempo de ejecución de Lakehouse no admiten
trabajos de extracción. Esta limitación se aplica tanto a las declaraciones
EXPORT DATAcomo al comandobq extractde la CLI. - El catálogo de tiempo de ejecución de Lakehouse no admite vistas de bases de datos ni de metastores.
- El catálogo de tiempo de ejecución de Lakehouse no admite vistas de Apache Iceberg.
Realiza consultas
- El rendimiento de las consultas de las tablas en el catálogo de tiempo de ejecución de Lakehouse desde el motor de BigQuery puede ser lento en comparación con la consulta de datos en tablas estándar de BigQuery. En general, la velocidad de las consultas debe ser equivalente a la lectura de datos de Cloud Storage.
- Una ejecución de prueba de BigQuery de una consulta que usa una tabla en el catálogo de tiempo de ejecución de Lakehouse puede informar un límite inferior de 0 bytes de datos, incluso si se devuelven filas. Este resultado se produce porque la cantidad de datos que se procesan desde la tabla no se puede determinar hasta que se ejecuta la consulta completa. La ejecución de la consulta genera un costo por procesar estos datos.
- No puedes hacer referencia a una tabla en el catálogo de entorno de ejecución de Lakehouse en una consulta de tabla comodín.
API y metadatos
- No puedes usar el método
tabledata.listpara recuperar datos de tablas en el catálogo de entorno de ejecución de Lakehouse. En su lugar, puedes guardar los resultados de la consulta en una tabla de BigQuery y, luego, usar el métodotabledata.listen esa tabla. - No se admite la visualización de estadísticas de almacenamiento para tablas en el catálogo de tiempo de ejecución de Lakehouse.
Cuotas y límites
- Las tablas del catálogo del entorno de ejecución de Lakehouse en BigQuery están sujetas a las mismas cuotas y límites que las tablas estándar.
Diferencias con BigLake Metastore (clásico)
Las diferencias principales entre el catálogo de entorno de ejecución de Lakehouse y el almacén de metadatos de BigLake (clásico) incluyen las siguientes:
- El catálogo de tiempo de ejecución de Lakehouse admite una integración directa con motores de código abierto, como Spark, lo que ayuda a reducir la redundancia cuando almacenas metadatos y ejecutas trabajos. Se puede acceder directamente a las tablas del catálogo de entorno de ejecución de Lakehouse desde varios motores de código abierto y BigQuery.
- El catálogo de entorno de ejecución de Lakehouse admite el extremo del catálogo de REST de Apache Iceberg, mientras que el metastore de BigLake (clásico) no.
¿Qué sigue?
- Comprende el extremo del catálogo de REST de Apache Iceberg.
- Configura extremos regionales.