


このドキュメントでは、断片化されたマルチモーダル データを検索可能なナレッジグラフに統合するマルチエージェント AI システムのハイレベル アーキテクチャについて説明します。このシステムでは、ユーザーがデータをアップロードし、ナレッジグラフを使用して潜在的な問題やシステムリスクを特定できます。このアーキテクチャにより、エージェントは複雑なデータウェブをナビゲートし、長期的なパーソナライズを維持できます。これにより、分散リソースが検索要件に継続的に一致するようになります。
GraphRAG は、検索拡張生成(RAG)に対するグラフベースのアプローチです。RAG は、ベクトル検索を使用して取得したコンテキストに関連するデータでプロンプトを拡張することで、AI 生成のレスポンスをグラウンディングします。GraphRAG は、ベクトル検索とナレッジグラフ クエリを組み合わせて、さまざまなソースからのデータの相互接続性をより適切に反映するコンテキスト データを取得します。GraphRAG を使用して拡張されたプロンプトは、より詳細で関連性の高い AI レスポンスを生成できます。
このドキュメントは、クラウドで AI インフラストラクチャとアプリケーションを構築して管理するアーキテクト、デベロッパー、管理者を対象としています。このドキュメントは、AI エージェントとモデルに関する基本的な知識があることを前提としています。このドキュメントでは、AI エージェントの設計とコーディングに関する具体的なガイダンスは提供していません。
このドキュメントのデプロイセクションでは、Spanner Graph スキーマを定義し、エージェント型検索用にマルチモーダル エンティティをリンクする方法を示すコードサンプルを紹介します。
アーキテクチャ
次の図は、マルチモーダル GraphRAG リソース オーケストレーションを可能にするマルチエージェント AI システムのアーキテクチャの概要を示しています。
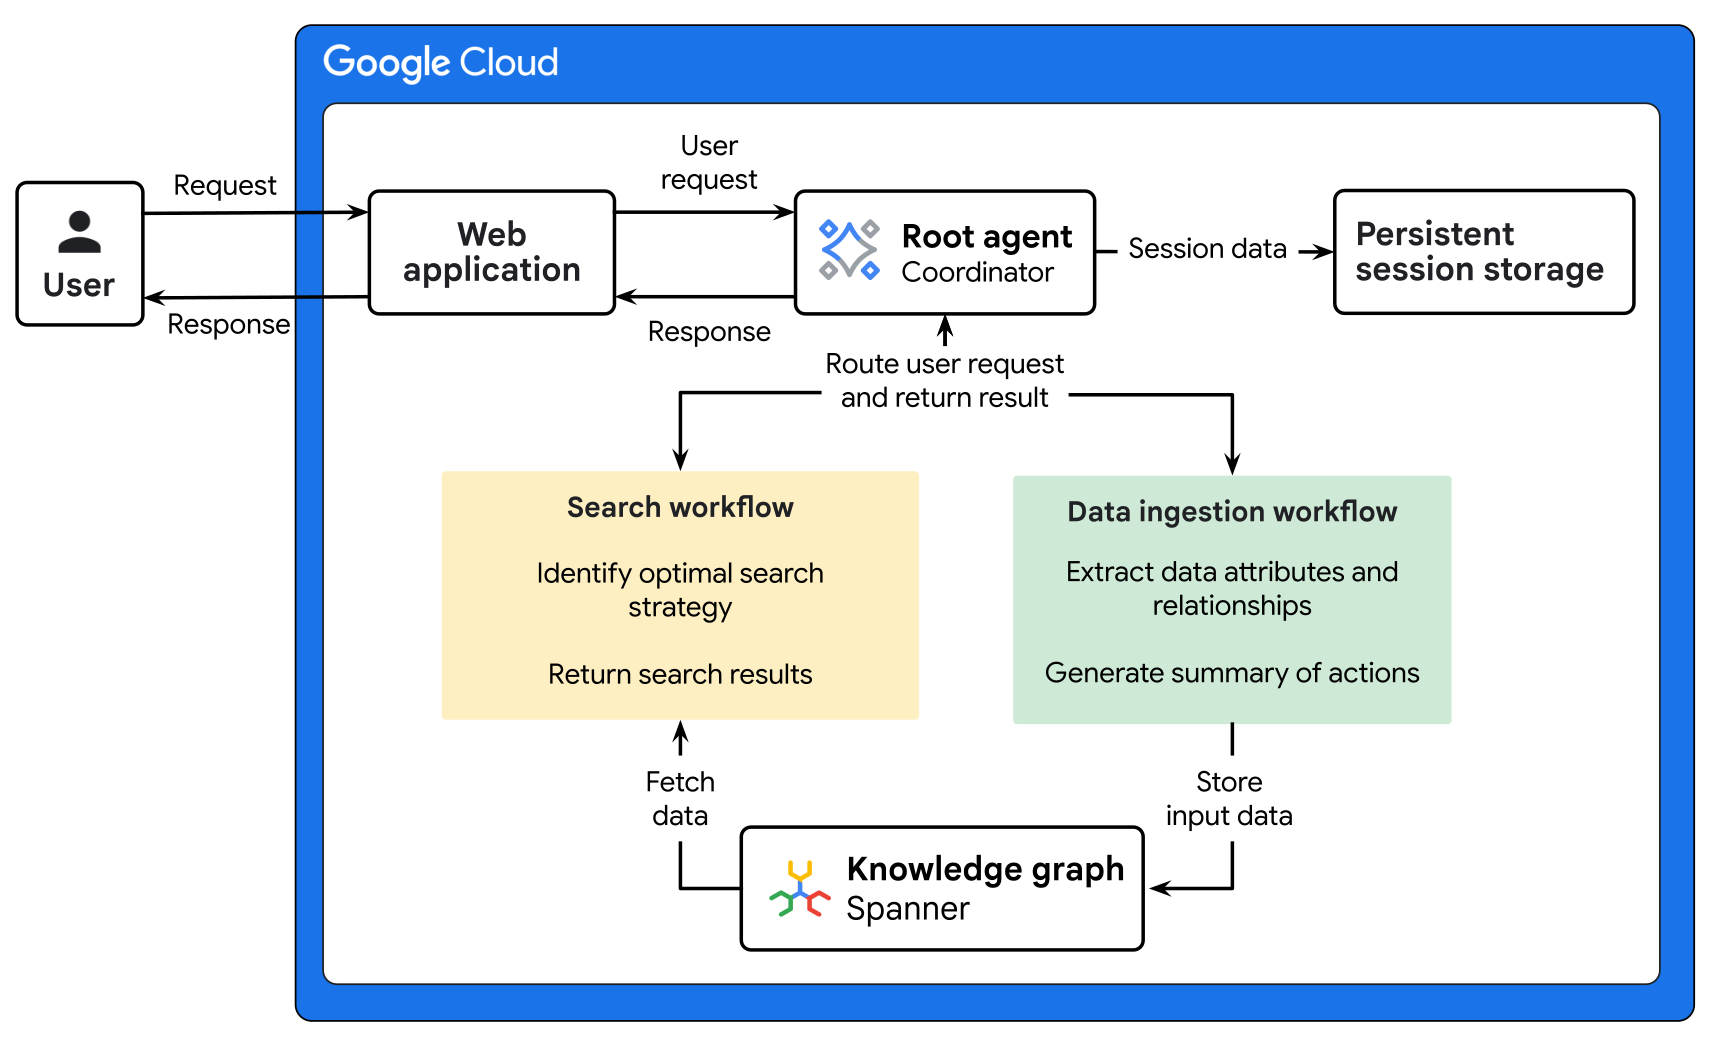
上の図のアーキテクチャには、データ取り込みと検索の 2 つのワークフローがあります。
- データの取り込みワークフローは、断片化されたマルチモーダル レコードを統合ナレッジグラフに統合します。このワークフローでは、順次マルチエージェント パターンを使用して、元データを Cloud Storage にアップロードし、Gemini を使用して複雑な関係を抽出し、Spanner Graph ナレッジグラフを更新して、データを取得できるようにします。
- 検索ワークフローを使用すると、GraphRAG プロセスを通じて分析情報を取得し、レスポンスをグラウンディングできます。このワークフローでは、Gemini と専用のサブエージェントを使用してナレッジグラフをナビゲートし、以前のセッション データに基づいて調査結果を統合します。
次のタブには、データの取り込みと検索のワークフローを示すアーキテクチャ図が表示されます。
データの取り込みワークフロー
次の図は、データ取り込みワークフローの詳細なアーキテクチャを示しています。
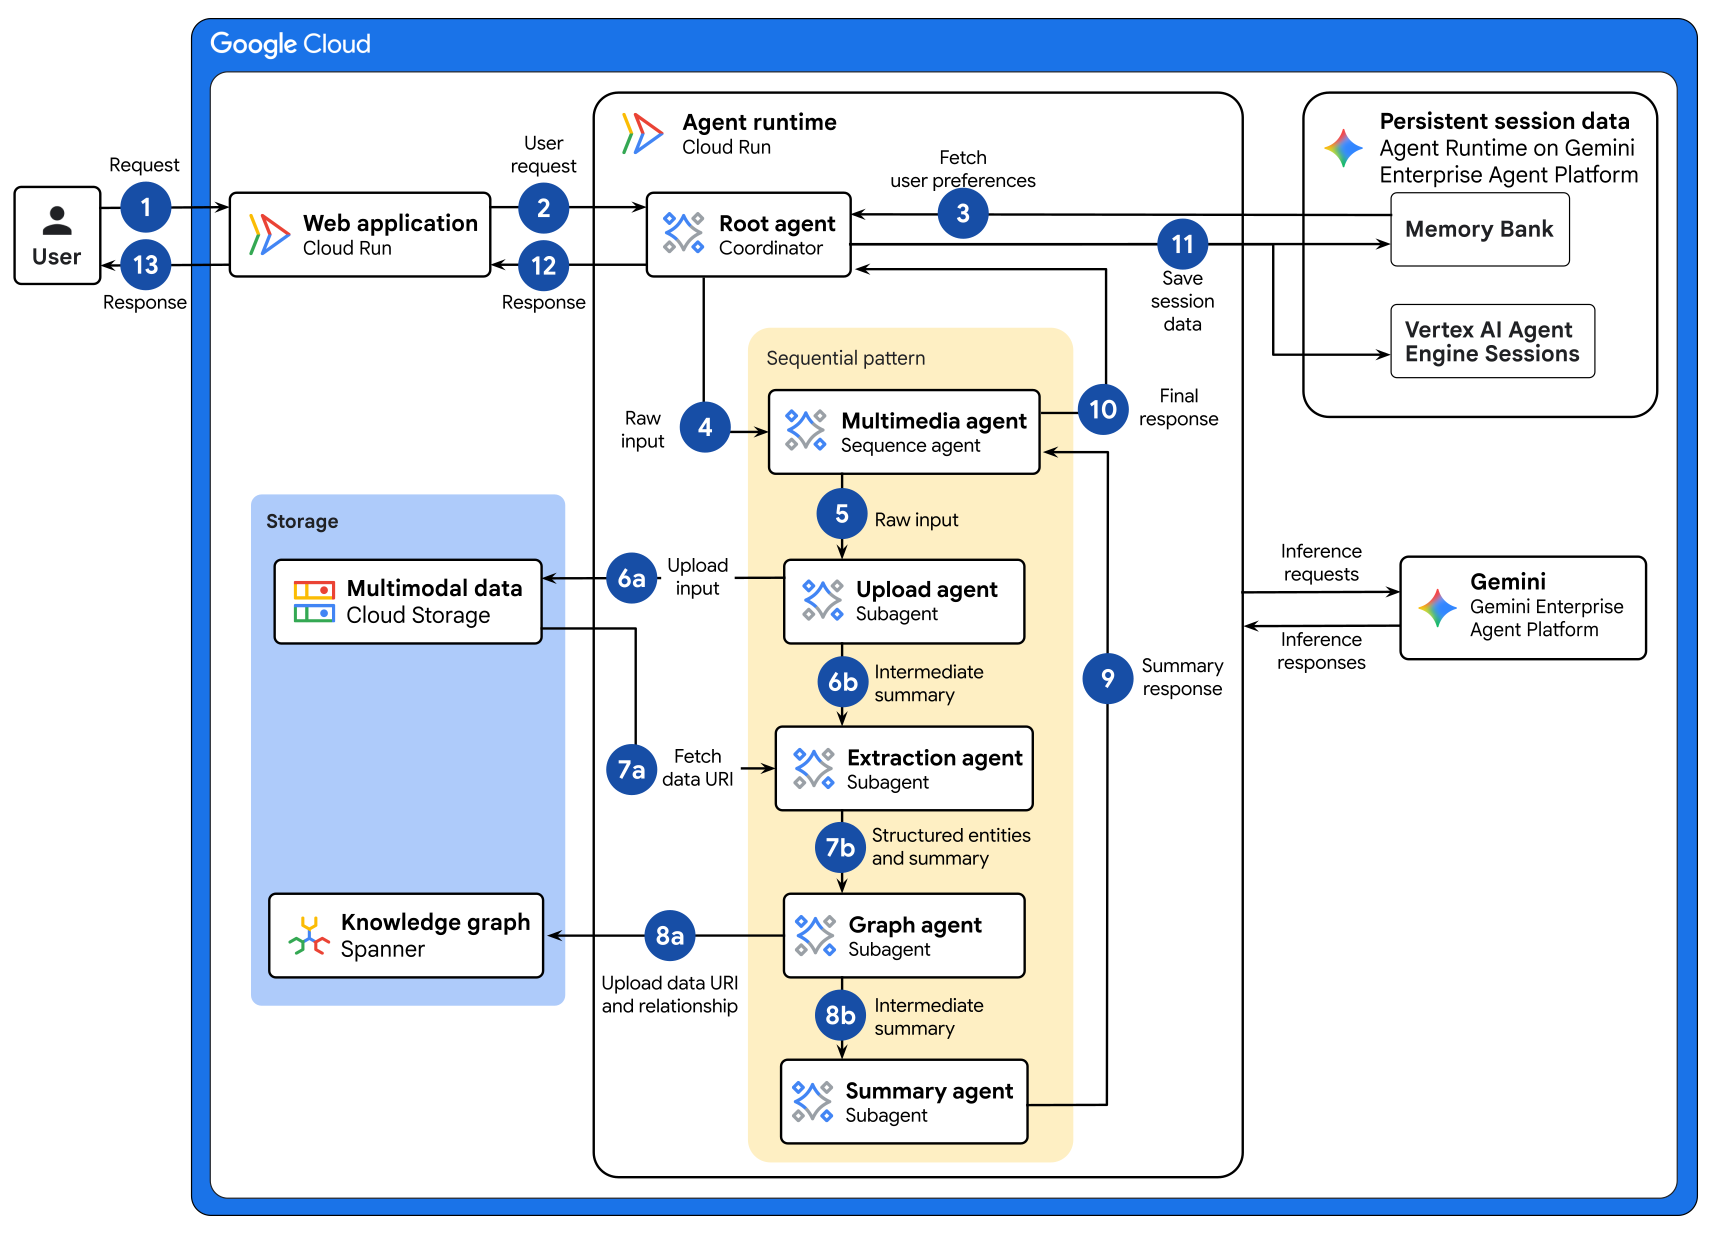
上の図は、次のデータフローを示しています。
- ユーザーがウェブ アプリケーションを操作して新しいデータをアップロードします。たとえば、財務アナリストは、収益の PDF、株主総会の録音、市場パフォーマンスのグラフをアップロードできます。
- ウェブ アプリケーションは、リクエストをルート エージェントに転送します。ルート エージェントは、リクエストを受信して Cloud Run サービスにデプロイされるコーディネーター エージェントです。
- ルート エージェントは、Memory Bank から永続的なセッション データを取得し、過去のセッションのユーザー設定に基づいて検索結果をパーソナライズします。
- ルート エージェントは、Gemini Enterprise Agent Platform の Gemini を使用してリクエストを解釈し、マルチメディア エージェントにタスクを委任して、データの取り込みパイプラインを実行します。
- マルチメディア エージェントは シーケンシャル パターンを開始し、未加工の入力をアップロード エージェントに転送します。
- アップロード エージェントは次のタスクを実行します。
- 未加工ファイルを Cloud Storage バケットに保存し、メディアタイプを検出します。
- 実行したアクションの中間サマリーを抽出エージェントに転送します。
- 抽出エージェントは次のタスクを実行します。
- ストレージ バケットからデータ URI を取得し、Gemini を使用してデータを解析し、構造化エンティティを識別します。たとえば、財務データのエンティティには、企業の子会社、会計四半期、収益センチメントなどがあります。
- 構造化されたエンティティと、実行したアクションの中間サマリーをグラフ エージェントに転送します。
- グラフ エージェントは次のタスクを実行します。
- 構造化エンティティを受け取り、データをナレッジグラフにアップロードします。Spanner Graph は、発行者、ステークホルダー、市場商品を表現するノードを作成またはリンクします。
- 実行したアクションの中間サマリーをサマリー エージェントに転送します。
- サマリー エージェントは、取り込み結果のテキスト サマリーと、すべてのサブエージェントによって実行されたアクションを含むレスポンスを生成します。要約エージェントは、マルチメディア エージェントにレスポンスを送信します。
- マルチメディア エージェントは、要約レスポンスをルート エージェントに転送します。
- ルート エージェントは、 コールバック関数をトリガーして、セッション データを Gemini Enterprise Agent Platform Sessions に保存します。ルート エージェントは、セッションからカスタムの メモリトピックを抽出して、重要な重点分野に関する情報を保存します。たとえば、金融アナリストは、規制フラグやセクターのトレンドを追跡するために記憶トピックを作成できます。
- ルート エージェントは、要約された回答をウェブ アプリケーションに転送します。
- ウェブ アプリケーションがレスポンスをユーザーに転送します。
検索ワークフロー
次の図は、検索ワークフローの詳細なアーキテクチャを示しています。
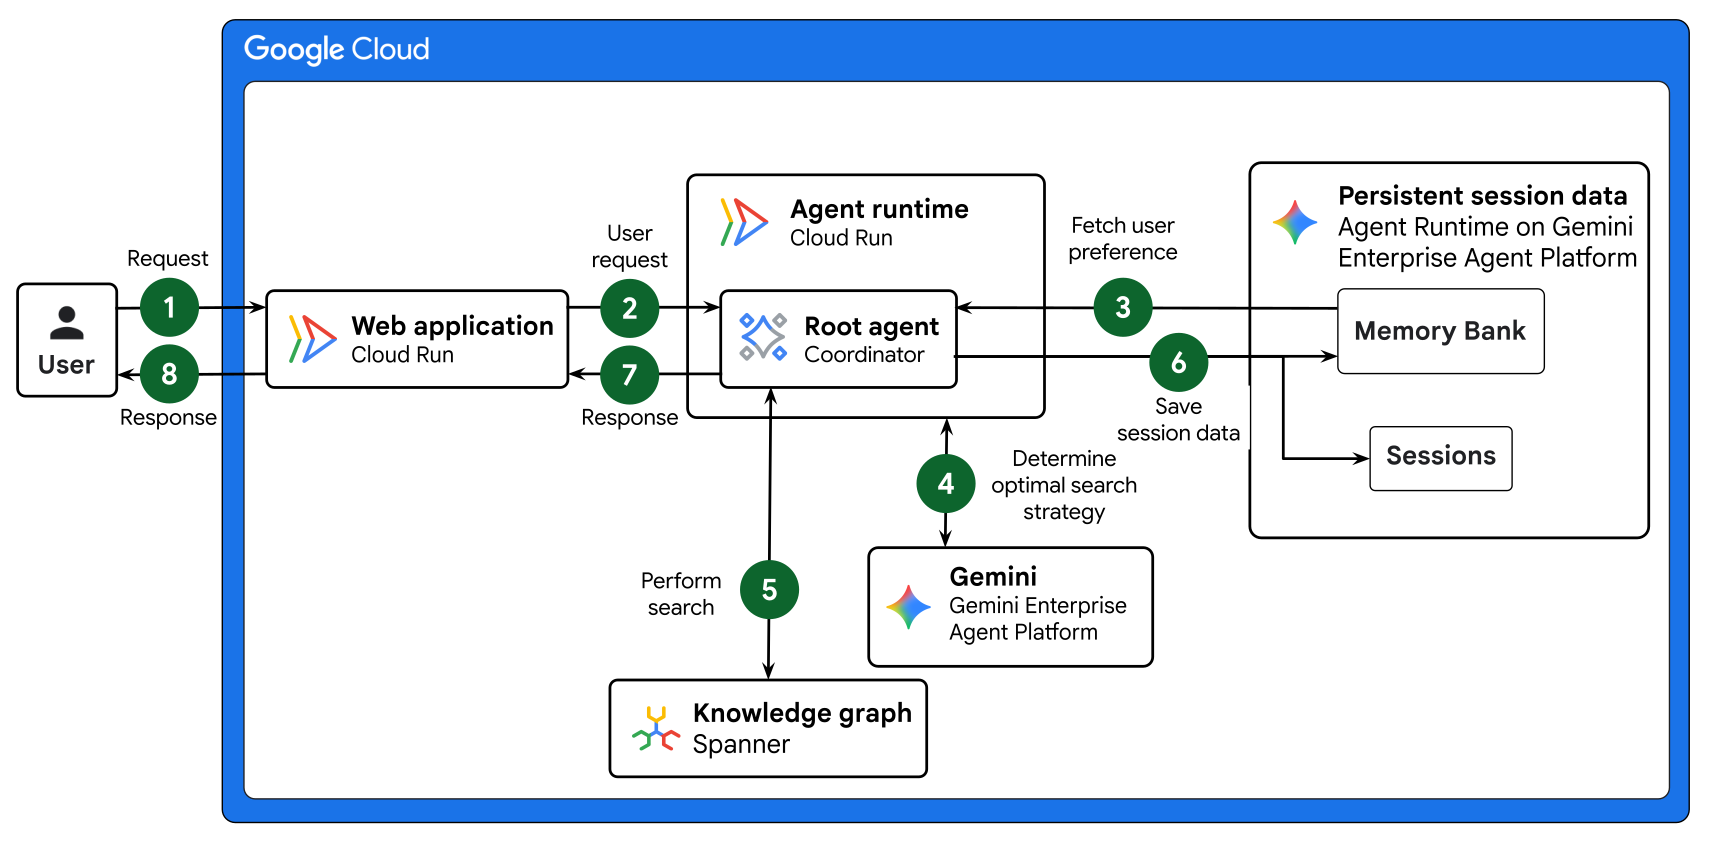
上の図は、次のデータフローを示しています。
- ユーザーがウェブ アプリケーションに検索リクエストを送信します。たとえば、ポートフォリオ マネージャーは、3 つ以上のエンティティが関与し、24 時間以内に合計金額が 100 万ドルを超える循環取引パターンを検出するリクエストを送信します。
- ウェブ アプリケーションは、リクエストをルート エージェントに転送します。ルート エージェントは、リクエストを受信して Cloud Run サービスにデプロイされる コーディネーター エージェントです。
- ルート エージェントは、Memory Bank から永続的なセッション データを取得し、ポートフォリオ マネージャーの過去の設定とコンテキストに基づいて検索結果をパーソナライズします。
- ルート エージェントは、Agent Platform の Gemini を使用して、最適な検索戦略を決定します。
- キーワード検索: SQL の
LIKE句を使用して、正確なカテゴリまたは場所を照合します。 - セマンティック RAG 検索: エンベディング モデルとコサイン距離を使用して、意味的に類似したデータエントリを見つけます。
- ハイブリッド検索: キーワード検索とセマンティック RAG 検索を実行し、Reciprocal Rank Fusion(RRF)を使用して結果を統合することで、高い関連性とカバレッジを確保します。
- キーワード検索: SQL の
- ルート エージェントは、Spanner Graph に保存されているナレッジグラフに対して適切な検索戦略を実行し、検索結果を取得します。
- ルート エージェントは、 コールバック関数をトリガーして、セッション データを Agent Platform Sessions に保存します。ルート エージェントは、セッションからカスタムのメモリトピックを抽出します。たとえば、ポートフォリオ マネージャーは、規制フラグや新たなセクター トレンドを追跡するために、記憶トピックを作成できます。
- ルート エージェントは、要約された回答をウェブ アプリケーションに転送します。
- ウェブ アプリケーションがレスポンスをユーザーに転送します。
使用するプロダクト
このリファレンス アーキテクチャでは、次の Google Cloudプロダクトと機能を使用します。
- Cloud Run: Google のスケーラブルなインフラストラクチャ上でコンテナを直接実行できるサーバーレス コンピューティング プラットフォーム。
- Gemini: Google が開発したマルチモーダル AI モデルのファミリー。
- Gemini Enterprise Agent Platform: エンタープライズ グレードの AI エージェントを構築、スケーリング、管理、最適化できる包括的なプラットフォーム。
- Cloud Storage: 低コストで無制限のオブジェクト ストア。さまざまなデータ型に対応しています。データには Google Cloudの内部および外部からアクセスでき、冗長性を確保するために複数のロケーションに複製されます。
- Spanner Graph: Spanner のスケーラビリティ、可用性、整合性の機能を提供するグラフ データベース。
- Gemini Enterprise Agent Platform Sessions: ユーザーとエージェント間のやり取りの履歴を保存して取得する永続ストレージ サービス。
- Memory Bank: ユーザーとエージェントの会話に基づいて長期記憶を生成、改良、管理、取得する永続ストレージ サービス。
フレームワーク、Agent Runtime、ツール、メモリ、設計パターンなど、エージェント型 AI システムの代替コンポーネントの選択については、エージェント型 AI アーキテクチャ コンポーネントを選択するをご覧ください。
ユースケース
このアーキテクチャは、断片化されたマルチモーダル データを統合して分析し、リソース割り当てと情報検索を最適化するユースケース向けに設計されています。独立したサブエージェントを維持することで、システムはモジュラー アップデートをサポートし、分散リソースが検索要件に高い継続性で一致するようにします。Spanner Graph をナレッジグラフとして統合することで、エージェント型 AI システムは複雑で相互接続されたデータをモデル化できます。この統合により、リレーショナル データベースや NoSQL データベースでは困難または非効率な、豊富なコンテキスト理解と高度なクエリ機能が実現します。
次のユースケースでは、グラフ データベースは、マルチモーダル データから派生した任意の接続や進化する接続を表現するのに優れています。これらの接続では、リレーショナル データベースで複雑で厳格なスキーマ管理が必要になります。
このドキュメントで説明するアーキテクチャのユースケースの例を次に示します。
- エンタープライズ HR の人材流動性: セマンティック拡張により、適格な社内候補者を特定することで、大規模な採用検索のキーワード検索を改善します。このアーキテクチャは、マルチモーダル ポートフォリオと動画の紹介から技術スキルとソフトスキルの評価を抽出し、包括的な人材グラフを構築します。Spanner ナレッジグラフは、従業員、コンピテンシー、プロジェクト履歴の関係をトレースします。トレース結果では、概念的な深さに基づいてエキスパートを特定し、人員不足のプロジェクトにフラグを立てます。
- ソーシャル メディアのコンテンツ分析: ソーシャル メディア プラットフォームで高度なコンテンツ検出とネットワーク分析を実行して、特定の記憶やトレンドを特定します。システムは、動画、ボイスメモ、vlog などのアップロードを処理し、エンティティ、トピック、感情、メンションを抽出します。Spanner ナレッジグラフは、ユーザー、ユーザーのつながり(友だちやフォロワー)、投稿、高評価、コメント、共有トピック、トレンド間の関係をトレースします。
設計上の考慮事項
以降のセクションでは、AI エージェントを設計し、このアーキテクチャを本番環境に実装するための一般的な推奨事項について説明します。
このセクションのガイダンスはすべてを網羅しているわけではありません。設計要素とベスト プラクティスの詳細、およびマルチエージェント AI システムの構築とデプロイに関する推奨事項については、 Google Cloudのマルチエージェント AI システムをご覧ください。
AI エージェントの設計
エージェントの費用とパフォーマンスを改善するには、次の推奨事項を検討してください。
- エージェント システムの設計: 複雑なワークフローを、モノリシックなエージェントではなく、明確に定義された責任を持つ複数の専門エージェントに分解します。この関心の分離により、プロンプト エンジニアリングが簡素化され、指示のドリフトが最小限に抑えられ、きめ細かいモデルのスケーリングが可能になります。このアーキテクチャでは、大量の明確に定義されたタスクをより小さく高速なモデルにルーティングし、複雑な推論を大容量モデルに割り当てます。
- ツールの設計: 1 つのモノリシックなメソッドを使用するのではなく、ツールを複数の焦点を絞ったメソッドに分割します。このアプローチにより、コードベース全体の一貫性が確保され、ロジックの分岐が減り、直接検索メソッドが呼び出されたときにクエリ分析をスキップするなど、特定の最適化パスが可能になります。
- エージェント コンテキスト: ダウンストリーム エージェントがシーケンシャル パイプラインでアップストリーム データに対してクエリを繰り返さないようにするには、エージェントの状態を介して十分なコンテキストを渡します。各エージェントがデータを確実に解析できるように、共有状態には明確に定義された JSON 構造を使用します。
- セッション状態ストレージ: 直近の会話履歴にはセッション状態を使用し、セッションをまたいで抽出された事実にはメモリバンクを使用します。セッションの開始時にメモリ コンテキストを挿入して、エージェントが長い会話履歴を再処理せずに設定を参照できるようにします。
- メモリの品質: ユーザーの好みや役割が時間の経過とともに変化した場合に、古いメモリを消去または更新できるようにします。
セキュリティ、プライバシー、コンプライアンス
AI エージェントに固有のセキュリティ リスクに対処するため、Google は、決定論的なセキュリティ管理と動的な推論ベースの防御を組み合わせたアプローチを推奨しています。
- 人間による監視: ビジネス クリティカルなシステムに人間参加型のフローを組み込み、人間の監督者がアウトプットを確認して、エージェントのアクションを承認、オーバーライド、一時停止できるようにします。
- Agent Identity: 各エージェントにワークロードにバインドされた ID を割り当てて、最小権限のアクセス制御を適用し、外部ツールの認証情報を一元管理します。
- Agent Gateway: Model Armor を使用して、上り(内向き)トラフィックと下り(外向き)トラフィックのガバナンス、デフォルト拒否アクセス ポリシー、インライン プロンプトとツールの検査を適用します。
Agent Registry: エージェントが承認済みのサブエージェントと MCP ツールにのみ接続することを確認します。
きめ細かいアクセス制御を実装する: きめ細かいアクセス制御を使用して、テーブルレベルと列レベルでアクセスを認可します。Cloud Run サービス アカウントのみがアクセスできるように、Cloud Storage バケット ポリシーを制限します。
推論とレスポンスをサニタイズする: Model Armor を使用して、推論リクエストとモデル レスポンスの両方を検査してサニタイズします。このサニタイズにより、ユーザーがアップロードしたマルチモーダル コンテンツからのプロンプト インジェクションのリスクが軽減されます。また、エージェントの出力で個人情報(PII)や機密データが誤って漏洩するのを防ぐこともできます。
信頼性
エージェント構成が信頼性要件を満たすようにするには、次の推奨事項を考慮してください。
- エージェントの再試行ロジックを実装する: 割り当て制限などの一時的なエラーを処理するには、Agent Platform エンドポイントと Spanner への呼び出しに指数バックオフを使用した再試行ロジックを実装します。
- ファイルの上限を設定する: 大きなファイルによる API タイムアウトを回避するには、明示的なアップロード サイズの上限を設定し、データ エンティティが抽出される前に大きな動画をチャンクに分割します。詳細については、動画処理をカスタマイズするをご覧ください。
運用効率
エージェント構成が運用効率の要件を満たすようにするには、次の推奨事項を検討してください。
- 構造化ロギングを使用する: すべてのエージェント ツールの呼び出しとパイプラインの結果を構造化メタデータでログに記録します。構造化ログを使用すると、Cloud Monitoring でログとダッシュボードをクエリできます。
- トレースを実装する: レイテンシのホットスポットを診断するには、Cloud Trace を使用して、エージェント ランナーとツール実行全体でエンドツーエンドのリクエスト トレースをキャプチャします。
- エージェントの品質を評価する: Gen AI Evaluation Service を使用して、エージェントの出力品質を定期的に評価し、ツールの選択軌跡とレスポンスの品質を検証します。
費用の最適化
エージェント構成が費用要件を満たすようにするには、次の推奨事項を考慮してください。
- ストレージ費用: ストレージ費用を削減するには、オブジェクトのライフサイクル管理を使用して、定義された保持期間が経過したファイルを Nearline または Coldline のストレージ クラスに移動します。
- コスト分析と管理: Agent Platform の費用を分析して管理するには、秒間クエリ数(QPS)と秒間トークン数(TPS)のベースライン指標を作成することをおすすめします。デプロイ後にこれらの指標をモニタリングします。費用管理の一環として作成するベースラインは、容量計画の決定に役立ちます。たとえば、ベースラインは、プロビジョンド スループットが必要になるタイミングを判断するのに役立ちます。
パフォーマンスの最適化
エージェント構成がパフォーマンス要件を満たすようにするには、次の推奨事項を検討してください。
- ルート エージェントのルーティング: レイテンシを最小限に抑え、不要なサブエージェントの呼び出しを回避するには、エージェントの指示でルーティング ロジックを明確に定義します。各ツールの目的、入力パラメータ、想定される出力が文字列リテラルで記述されていることを確認します。これにより、モデルが正しいツールを選択できるようになります。
- データベース内 AI モデル: レイテンシを短縮するには、Spanner の
ML.PREDICT関数を使用して、SQL クエリ内でモデルをインラインで呼び出します。ハイブリッド検索ワークロードでは、クエリごとに複数のモデル呼び出しがトリガーされる可能性があるため、Agent Platform の割り当て使用量をモニタリングします。 - リソースの割り当て: パフォーマンス要件に応じて、Cloud Run サービスに割り当てるメモリ上限と CPU 上限を構成します。
デプロイ
このアーキテクチャのサンプル実装をデプロイするには、Way Back Home レベル 2 の Codelab をお試しください。
次のステップ
- Cloud Run で AI エージェントをホストする方法を学習する。
- Agent Platform と Spanner Graph を使用して生成 AI 用の GraphRAG インフラストラクチャを構築する方法を学習する。
- Spanner Graph スキーマを設計するためのベスト プラクティスを確認する。
- マルチモーダル エンベディングを取得する方法を学習する。
- Google Cloudでマルチエージェント AI システムを構築する方法を学習する。
- Gemini Enterprise Agent Ready(GEAR)でエンタープライズ グレードのエージェントを構築してデプロイするための学習リソースをご覧ください。
- Google Cloudの AI ワークロードと ML ワークロードに固有のアーキテクチャ原則と推奨事項の概要について、Well-Architected Framework の AI と ML の視点を確認する。
- Cloud アーキテクチャ センターで、リファレンス アーキテクチャ、図、ベスト プラクティスを確認する。
寄稿者
著者:
- Annie Wang | ソフトウェア エンジニア
- Samantha He | テクニカル ライター
その他の寄稿者:
- Christina Lin | デベロッパー リレーションズ エンジニア マネージャー
- Kumar Dhanagopal | クロス プロダクト ソリューション デベロッパー
- Olivier Bourgeois | デベロッパーリレーションズ エンジニア