


כשמשווים את הביצועים, חשוב להגדיר מראש מה אתם רוצים ללמוד מהבדיקה. לדוגמה:
- מהי התפוקה המקסימלית שהמערכת יכולה להשיג?
- כמה זמן נמשכת שאילתה או עומס עבודה מסוימים?
- איך הביצועים משתנים ככל שכמות הנתונים גדלה?
- איך משווים בין הביצועים של שתי מערכות שונות?
- בכמה זמן מנוע מבוסס-עמודות מקצר את זמן התגובה של ביצועי השאילתה?
- כמה עומס מסד נתונים יכול לשאת לפני שצריך לשקול שדרוג למכונה חזקה יותר?
הבנת היעדים של מחקר הביצועים עוזרת להבין איזה מדד השוואה צריך להריץ, איזו סביבה נדרשת ואילו מדדים צריך לאסוף.
יכולת חזרה
כדי להסיק מסקנות מבדיקת ביצועים, צריך להיות אפשר לחזור על תוצאות הבדיקה. אם יש הבדלים גדולים בתוצאות הבדיקה, יהיה קשה להעריך את ההשפעה של השינויים שביצעתם באפליקציה או בהגדרות האישיות של המערכת. כדי להקטין את השונות, אפשר להריץ בדיקות כמה פעמים או למשך תקופות ארוכות יותר, וכך לקבל יותר נתונים.
מומלץ להריץ בדיקות ביצועים במערכות שמבודדות ממערכות אחרות. אם תפעילו את הבדיקה בסביבה שבה מערכות חיצוניות יכולות להשפיע על ביצועי האפליקציה, אתם עלולים להגיע למסקנות שגויות. בדרך כלל אי אפשר לבודד את הסביבה באופן מלא כשמריצים את הבדיקה בסביבת ענן עם כמה דיירים, ולכן צפויים הבדלים גדולים יותר בתוצאות.
כדי להבטיח את יכולת החזרה, צריך לוודא שעומס העבודה לבדיקה נשאר זהה בין ההרצות. אפשר להשתמש במידה מסוימת של אקראיות בקלט של הבדיקה, כל עוד האקראיות לא גורמת להתנהגות שונה באופן משמעותי של האפליקציה. אם קלט לקוח שנוצר באופן אקראי משנה את השילוב של פעולות קריאה וכתיבה מהרצה להרצה, הביצועים ישתנו באופן משמעותי.
גודל מסד הנתונים, שמירה במטמון ודפוסי קלט/פלט
חשוב לוודא שכמות הנתונים שאתם בודקים מייצגת את האפליקציה שלכם. אם יש לכם מאות ג'יגה-בייטים או טרה-בייטים של נתונים, הרצת בדיקות עם כמות קטנה של נתונים כנראה לא תיתן ייצוג אמיתי של ביצועי האפליקציה. גודל מערך הנתונים משפיע גם על הבחירות שמבצע הכלי לאופטימיזציה של שאילתות. שאילתות על טבלאות בדיקה קטנות עשויות להשתמש בסריקות טבלה שנותנות ביצועים נמוכים בקנה מידה גדול יותר, ולא תזהו אינדקסים חסרים בהגדרה הזו.
כדאי לשאוף לשכפל את דפוסי הקלט/פלט של האפליקציה. היחס בין קריאות לכתיבות חשוב לפרופיל הביצועים של האפליקציה.
משך ההשוואה לשוק
במערכת מורכבת, יש הרבה מידע על מצב המערכת שמתעדכן בזמן שהמערכת פועלת: נוצרים חיבורים למסד הנתונים, המטמון מתמלא, ונוצרים תהליכים ושרשורים. בתחילת בדיקת הביצועים, יכול להיות שהאתחול של הרכיבים האלה ינצל משאבי מערכת וישפיע לרעה על הביצועים שנמדדים, אם זמן הריצה של עומס העבודה קצר מדי.
מומלץ להריץ בדיקות ביצועים למשך 20 דקות לפחות כדי למזער את ההשפעות של חימום המערכת. מודדים את הביצועים במצב יציב אחרי ההפעלה, ולמשך זמן ארוך מספיק כדי לוודא שכל ההיבטים של פעולות מסד הנתונים נכללים. לדוגמה, נקודות ביקורת של מסד נתונים הן תכונה קריטית של מערכות מסדי נתונים, ויכולה להיות להן השפעה משמעותית על הביצועים. אם תריצו בדיקת ביצועים קצרה שמסתיימת לפני מרווח הזמן של נקודת הבדיקה, הגורם החשוב הזה בהתנהגות של האפליקציה יוסתר.
בדיקה שיטתית
כשמשפרים את הביצועים, משנים רק משתנה אחד בכל פעם. אם תשנו כמה משתנים בין הרצות, לא תוכלו לבודד את המשתנה ששיפר את הביצועים. למעשה, יכול להיות ששינויים מרובים יאזנו אחד את השני, כך שלא תראו את היתרון של שינוי מתאים. אם יש שימוש יתר בשרת מסד הנתונים, נסו לעבור למכונה עם יותר ליבות וירטואליות (vCPU) תוך שמירה על עומס קבוע. אם השרת של מסד הנתונים לא מנוצל מספיק, כדאי לנסות להגדיל את העומס תוך שמירה על הגדרת המעבד ללא שינוי.
הטופולוגיה של הרשת וזמני האחזור
טופולוגיית הרשת של המערכת יכולה להשפיע על תוצאות בדיקת הביצועים. זמן האחזור בין אזורים שונים משתנה. כשמבצעים בדיקות ביצועים, חשוב לוודא שהלקוח ואשכול מסד הנתונים נמצאים באותו אזור כדי למזער את זמן האחזור ברשת ולהשיג את הביצועים הטובים ביותר – במיוחד באפליקציות עם תפוקה גבוהה ועסקאות קצרות, כי זמן האחזור ברשת יכול להיות רכיב משמעותי בזמן התגובה הכולל של העסקה.
כשמשווים בין הביצועים של שתי מערכות שונות, חשוב לוודא שהטופולוגיה של הרשת זהה בשתי המערכות. חשוב לזכור שאי אפשר לבטל לחלוטין את השונות בזמן האחזור ברשת, גם באותו אזור יכולים להיות הבדלים בזמן האחזור בגלל הטופולוגיה של הרשת בסיסיות.
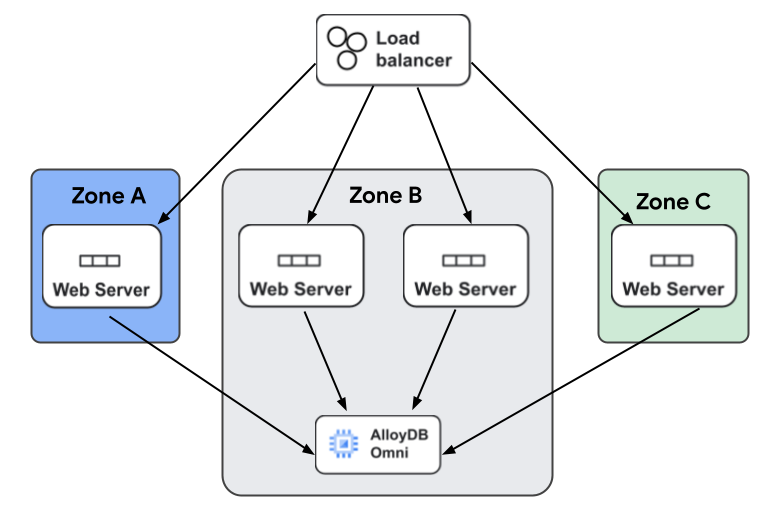
כשפורסים את האפליקציה, כדאי להבין טוב יותר את ההשפעה של השהיות בין אזורים על ידי התייחסות לאפליקציית אינטרנט טיפוסית עם נפח גבוה. לאפליקציה יש מאזן עומסים ששולח בקשות לכמה שרתי אינטרנט שנפרסו בכמה אזורים כדי להבטיח זמינות גבוהה. זמני האחזור עשויים להשתנות בהתאם לשרת האינטרנט שמעבד את הבקשה, בגלל הבדלים בזמני האחזור בין אזורים שונים.
באיור הבא מוצגת הארכיטקטורה האופיינית של אפליקציית אינטרנט שמשתמשת ב-AlloyDB Omni. בקשות של לקוחות מטופלות על ידי מאזן עומסים, שמעביר כל בקשה לאחד משרתי האינטרנט הרבים. כל שרתי האינטרנט מחוברים ל-AlloyDB Omni. חלק מהשרתים נמצאים באזור שונה מזה שבו פועל AlloyDB Omni, וזמן האחזור יהיה ארוך יותר כשהם ישלחו בקשות למסד הנתונים.
מעקב אחרי ניצול המשאבים במערכת
כדי לבצע אופטימיזציה של הביצועים של מערכת מסד הנתונים, צריך לעקוב אחרי השימוש במשאבים של מערכת מסד הנתונים ושל מערכות הלקוח שמשתמשות במערכת מסד הנתונים. מעקב אחרי שתי המערכות מאפשר לוודא שמערכות הלקוח מספקות מספיק עומס עבודה כדי לקבל מדידות משמעותיות במערכת מסד הנתונים. חשוב מאוד לעקוב אחרי ניצול המשאבים של המערכת שאתם בודקים. חשוב גם לעקוב אחרי ניצול המשאבים של מערכות הלקוח שבהן אתם משתמשים כדי להפעיל את עומס העבודה. לדוגמה, אם אתם רוצים לקבוע את מספר הלקוחות המקסימלי שמערכת מסד הנתונים שלכם יכולה לתמוך בו לפני שייגמרו משאבי ה-CPU, תצטרכו מספיק מערכות לקוח כדי ליצור את עומס העבודה הנדרש לניצול כל משאבי ה-CPU במערכת מסד הנתונים. לא תוכלו להעמיס על מערכת מסד הנתונים אם למכונות הלקוח שמייצרות את העומס אין מספיק CPU.
בדיקת מדרגיות
בדיקת יכולת ההתאמה לעומס היא היבט נוסף של בדיקת ביצועים. יכולת ההתאמה (scalability) מתייחסת לשינויים במדדי הביצועים כתוצאה משינוי במאפיין מסוים של עומס העבודה. הנה כמה דוגמאות למחקרים על יכולת התאמה לעומס:
- איך הגדלה של מספר הבקשות המקבילות משנה את התפוקה ואת זמני התגובה?
- איך הגדלת מסד הנתונים משפיעה על קצב העברת הנתונים וזמני התגובה?
בדיקות יכולת ההתאמה כוללות כמה הרצות של עומס עבודה, שבהן משנים מאפיין יחיד בין ההרצות ואוספים ומשרטטים מדד אחד או יותר. הבדיקות האלה עוזרות לקבל החלטות לגבי צווארי בקבוק שקיימים במערכת, עומס העבודה שהמערכת יכולה לטפל בו בהינתן הגדרה ספציפית, עומס העבודה המקסימלי שהמערכת יכולה לתמוך בו וההתנהגות של המערכת כשהעומס גדל מעבר לרמות האלה.
שיקולים לגבי גודל המכונה
AlloyDB Omni כולל הרבה תכונות חדשות ל-Postgres כדי לשפר את המהימנות והזמינות של מסד הנתונים. המעקב שנדרש לצורך כך משתמש במשאבים במכונה שבה פועל AlloyDB Omni. במכונות קטנות מאוד יש מלכתחילה משאבי זיכרון ומעבד מוגבלים, ולכן לצורך השוואה, מומלץ להשתמש במכונות עם לפחות ארבעה מעבדים וירטואליים.