


Casos de uso
Essa arquitetura de referência de disponibilidade é adequada para os seguintes casos de uso:
- Aplicativos essenciais para os negócios que exigem RTO e RPO mais baixos.
- Você quer implantar uma réplica em outra zona ou nó que ofereça alta disponibilidade para seus bancos de dados e proteja contra falhas de instância, servidor e zona.
- Você quer proteção contra erros do usuário e corrupção de dados (usando backups).
Como funciona a arquitetura de referência
A disponibilidade aprimorada complementa a disponibilidade padrão adicionando instâncias de réplica de leitura na região para permitir a alta disponibilidade (HA) que reduz o objetivo do tempo de recuperação (RTO). Essa abordagem também reduz o objetivo do ponto de recuperação (RPO) ao permitir o streaming de mudanças transacionais para a réplica.
A alta disponibilidade no AlloyDB Omni usa pelo menos duas instâncias de banco de dados. Uma instância funciona como o banco de dados principal, que oferece suporte a operações de leitura e gravação. As instâncias restantes servem como réplicas de leitura, operando em um modo somente leitura.
Veja a seguir conceitos importantes de alta disponibilidade:
- Failover é o procedimento durante uma interrupção não planejada em que a instância principal falha ou fica indisponível, e a réplica em espera é ativada para assumir o modo principal (leitura e gravação). Esse processo é chamado de promoção. Normalmente, nesses cenários, quando o servidor ou banco de dados principal volta a ficar on-line, o banco de dados precisa ser recriado e, em seguida, atuar como um banco de dados em espera. Para garantir um alto tempo de atividade, existem mecanismos que automatizam os failovers.
- Uma alternância, também conhecida como reversão de papel, é um procedimento usado para alternar os modos entre o banco de dados principal e um dos bancos de dados em espera, de modo que o principal se torne o em espera e o em espera se torne o principal. As alternâncias normalmente ocorrem de maneira controlada e podem ser iniciadas por vários motivos, por exemplo, para permitir o tempo de inatividade e a aplicação de patches no banco de dados principal anterior. As alternâncias normais precisam permitir uma futura reversão sem a necessidade de reinstanciar o novo modo de espera ou outros aspectos da configuração de replicação.
Opções de alta disponibilidade
Em ambientes do Kubernetes, para oferecer suporte à alta disponibilidade, é possível implantar o AlloyDB Omni usando os operadores do AlloyDB Omni no Kubernetes. Para mais informações, consulte Gerenciar a alta disponibilidade no Kubernetes.
| Observação: o Patroni e o HAProxy são ferramentas de terceiros não comerciais e compatíveis com o AlloyDB Omni. |
|---|
Recomendamos que você tenha pelo menos dois bancos de dados em espera para que a perda de um banco de dados não afete a alta disponibilidade do cluster. Nesse modo, você tem pelo menos um par de alta disponibilidade no caso de um failover ou durante qualquer manutenção planejada de um nó.
Para planejar o armazenamento da implantação do AlloyDB Omni, consulte Planejar o armazenamento do AlloyDB Omni no Kubernetes.Balanceadores de carga
Outro mecanismo importante que ajuda a facilitar os procedimentos de alternância e failover é a presença de um balanceador de carga.
O operador do Kubernetes implanta o próprio balanceador de carga, que se comporta de maneira semelhante, criando um serviço para o banco de dados que aponta para o balanceador de carga para que isso seja transparente para o usuário.
Alta disponibilidade
Os bancos de dados de réplica de leitura implantados em uma região oferecem alta disponibilidade se o banco de dados principal falhar. Quando ocorre uma falha no banco de dados principal, o banco de dados em espera é promovido para substituí-lo, e o aplicativo continua com pouca ou nenhuma interrupção.
Em geral, é recomendável realizar verificações anuais ou semestrais regulares na forma de alternâncias para garantir que todos os aplicativos que dependem desses bancos de dados ainda possam se conectar e responder em um período adequado.
A proteção no nível da zona pode ser alcançada usando qualquer tipo de implantação, colocando uma das réplicas de leitura em espera em uma zona de disponibilidade diferente do banco de dados principal.
Outro benefício de ter réplicas de leitura é a capacidade de transferir operações somente leitura para os bancos de dados em espera, que podem atuar como bancos de dados de relatórios usando dados atualizados. Essa abordagem reduz a carga e a sobrecarga na instância principal de leitura e gravação.
Backups e configuração de alta disponibilidade
As réplicas de leitura podem ser configuradas em várias zonas que oferecem alta disponibilidade. Embora ofereçam RTO e RPO baixos, eles não protegem contra determinadas interrupções, como corrupção lógica de dados, como quedas acidentais de tabelas ou atualizações de dados incorretas. Portanto, é necessário fazer backups regulares, além da configuração de alta disponibilidade. Consulte a documentação sobre a arquitetura de disponibilidade padrão para mais detalhes.
A Figura 1 mostra uma configuração de alta disponibilidade recomendada com dois bancos de dados de espera de réplica de leitura em duas zonas de disponibilidade diferentes.
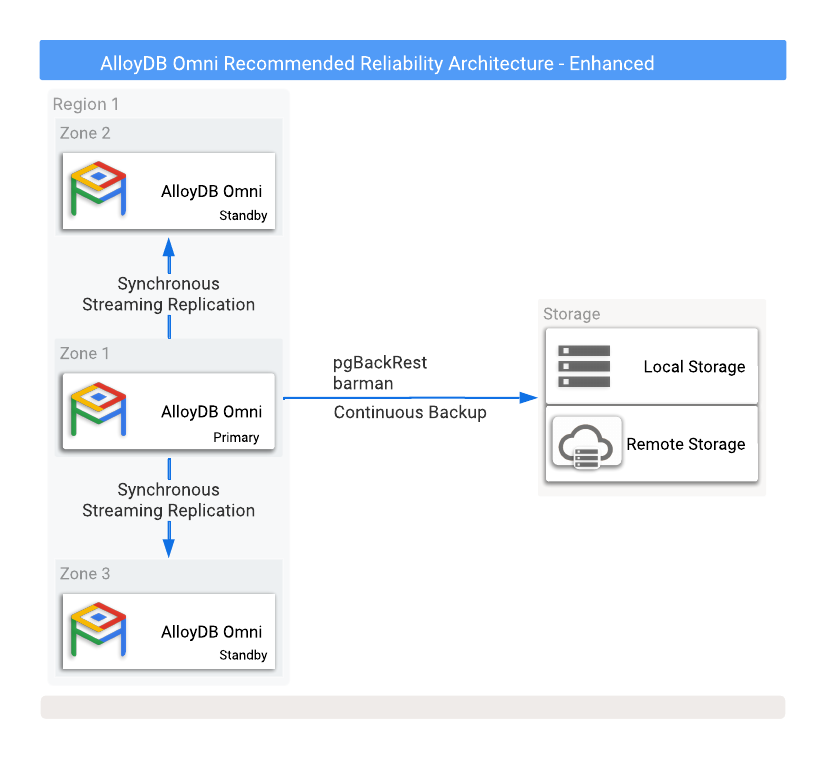
Figura 1. AlloyDB Omni com opções de backups e alta disponibilidade.
Para proteger contra perda de dados se a instância principal falhar, é necessário configurar a replicação no modo síncrono. Embora esse método ofereça uma forte proteção de dados, ele pode afetar o desempenho do banco de dados principal, porque todos os commits precisam ser gravados no banco de dados principal e em todos os bancos de dados de espera sincronizados. Uma conexão de rede de baixa latência entre essas instâncias de banco de dados é crucial para essa configuração.
Implantações de alta disponibilidade do Kubernetes
Para implantações do Kubernetes, use algumas mudanças básicas de atributos e adições ao arquivo de implantação do AlloyDB Omni para adicionar failover em espera ou réplicas de leitura para permitir falhas no banco de dados principal. É possível configurar um failover em espera e uma réplica somente leitura, e o operador cuida do provisionamento e da publicação do serviço. O operador também automatiza muitos dos processos de alta disponibilidade, como a recriação de bancos de dados em espera após um failover, e usa os mecanismos de correção integrados ao mecanismo do AlloyDB Omni no Kubernetes Engine.
Em uma implantação do Kubernetes, a disponibilidade de infraestrutura e aplicativos se beneficia dos recursos integrados do Kubernetes que cuidam de falhas de nós e pods, incluindo:
- kube-controller-manager
- Parâmetros como
node-status-update-frequency,node-monitor-period,node-monitor-grace-periodepod-eviction-timeout.
Além da proteção integrada, o operador expõe os seguintes parâmetros para influenciar a detecção de uma falha no primário ou no standby:
healthcheckPeriodSeconds: o tempo entre as verificações de integridade. O padrão é 30 segundos.autoFailoverTriggerThreshold: o número de verificações de integridade com falha consecutivas antes de iniciar o failover. o padrão é 3;
Para mais informações, consulte Gerenciar a alta disponibilidade no Kubernetes.
Implementação
Ao escolher uma arquitetura de referência de disponibilidade, considere as vantagens, as limitações e as alternativas a seguir.
Vantagens
- Proteção contra falhas de instâncias.
- Protege contra falhas no servidor.
- Protege contra falhas de zona.
- O RTO é drasticamente reduzido em relação à disponibilidade padrão.
Limitações
- Não há proteção extra contra desastres regionais.
- Possível impacto no desempenho da instância principal devido à replicação síncrona.
- A configuração da transmissão do WAL do PostgreSQL no modo síncrono
não causa perda de dados (
RPO=0) durante a operação normal ou failovers típicos. No entanto, essa abordagem não protege contra perda de dados em situações específicas de falha dupla, como quando todas as instâncias em espera são perdidas ou ficam inacessíveis da primária, e isso é imediatamente seguido por uma reinicialização da primária.
Alternativas
- A Arquitetura de Disponibilidade Padrão para opções de backup e recuperação.
- A Arquitetura de Disponibilidade Premium para recuperação de desastres em nível de região, réplicas de leitura adicionais e maior alcance de recuperação de desastres.
A seguir
- Visão geral da arquitetura de referência de disponibilidade do AlloyDB Omni.
- Disponibilidade Padrão do AlloyDB Omni.
- Disponibilidade Premium do AlloyDB Omni.
- Arquitetura de alta disponibilidade do AlloyDB Omni para PostgreSQL.
- Gerenciar a alta disponibilidade no Kubernetes.