


Casi d'uso
Questa architettura di riferimento per la disponibilità è adatta ai seguenti casi d'uso:
- Applicazioni aziendali critiche che richiedono RTO e RPO inferiori.
- Vuoi eseguire il deployment di una replica in un'altra zona o nodo che fornisca l'alta affidabilità per i tuoi database e protegga da errori di istanza, server e zona.
- Vuoi proteggerti da errori degli utenti e danneggiamento dei dati (utilizzando i backup).
Come funziona l'architettura di riferimento
La disponibilità avanzata si aggiunge alla disponibilità standard aggiungendo istanze di replica di lettura all'interno della regione per abilitare l'alta affidabilità (HA) che riduce il Recovery Time Objective (RTO). Questo approccio riduce anche il Recovery Point Objective (RPO) consentendo lo streaming delle modifiche transazionali alla replica.
L'alta affidabilità in AlloyDB Omni utilizza almeno due istanze di database. Un'istanza funge da database primario, supportando le operazioni di lettura e scrittura. Le istanze rimanenti fungono da repliche di lettura, operando in modalità di sola lettura.
Di seguito sono riportati alcuni concetti importanti relativi all'alta affidabilità:
- Il failover è la procedura durante un'interruzione non pianificata in cui l'istanza principale non funziona o non è disponibile e la replica in standby viene attivata per assumere la modalità principale (di lettura/scrittura). Questo processo è chiamato promozione. In genere, in questi scenari, quando il server o il database principale torna online, il database deve essere ricostruito e poi deve fungere da standby. Per garantire un uptime elevato, sono in atto meccanismi per automatizzare i failover.
- Uno switchover, noto anche come inversione dei ruoli, è una procedura utilizzata per cambiare le modalità tra il database principale e uno dei database in standby, in modo che il database principale diventi quello in standby e viceversa. In genere, i cambi avvengono in modo controllato e regolare e possono essere avviati per diversi motivi, ad esempio per consentire il tempo di inattività e l'applicazione di patch al database primario precedente. I cambi di ruolo controllati devono consentire un futuro cambio di ruolo inverso senza dover creare nuovamente un'istanza del nuovo standby o altri aspetti della configurazione della replica.
Opzioni di alta affidabilità
Negli ambienti Kubernetes, per supportare l'HA, puoi eseguire il deployment di AlloyDB Omni utilizzando gli operatori AlloyDB Omni Kubernetes. Per saperne di più, consulta Gestisci l'alta affidabilità in Kubernetes.
| Nota: Patroni e HAProxy sono strumenti di terze parti non commerciali e sono compatibili con AlloyDB Omni. |
|---|
Ti consigliamo di avere almeno due database di standby in modo che la perdita di un database non influisca sull'alta affidabilità del cluster. In questa modalità, hai almeno una coppia ad alta disponibilità in caso di failover o durante qualsiasi manutenzione pianificata di un nodo.
Per pianificare lo spazio di archiviazione per il deployment di AlloyDB Omni, consulta Pianifica lo spazio di archiviazione per AlloyDB Omni su Kubernetes.Bilanciatori del carico
Un altro meccanismo importante che facilita le procedure di switchover e failover è la presenza di un bilanciatore del carico.
L'operatore Kubernetes esegue il deployment del proprio bilanciatore del carico, che si comporta in modo simile, creando un servizio per il database che punta al bilanciatore del carico per renderlo trasparente per l'utente.
Alta affidabilità
I database di replica di lettura di cui è stato eseguito il deployment all'interno di una regione forniscono alta affidabilità se il database primario non funziona. Quando si verifica un errore del database primario, il database di standby viene promosso per sostituire quello primario e l'applicazione continua con un'interruzione minima o nulla.
In genere è buona norma eseguire controlli regolari annuali o semestrali sotto forma di switchover per garantire che tutte le applicazioni che si basano su questi database siano ancora in grado di connettersi e rispondere in un periodo di tempo adeguato.
La protezione a livello di zona può essere ottenuta utilizzando uno dei due tipi di deployment, posizionando una delle repliche di lettura in standby in una zona di disponibilità diversa rispetto al database primario.
Un ulteriore vantaggio di avere repliche di lettura è la possibilità di trasferire le operazioni di sola lettura ai database in standby, che possono fungere da database di reporting utilizzando dati aggiornati. Questo approccio riduce il carico e l'overhead sul nodo primario di lettura/scrittura.
Configurazione di backup e alta affidabilità
Le repliche di lettura possono essere configurate in più zone che offrono alta affidabilità. Sebbene offrano RTO e RPO bassi, non proteggono da determinate interruzioni, come il danneggiamento logico dei dati, ad esempio l'eliminazione accidentale di tabelle o l'aggiornamento errato dei dati. Pertanto, oltre alla configurazione dell'alta disponibilità, è necessario eseguire backup regolari. Per maggiori dettagli, consulta la documentazione sull'architettura di disponibilità standard.
La Figura 1 mostra una configurazione ad alta affidabilità consigliata con due database di replica di lettura in standby in due zone di disponibilità diverse.
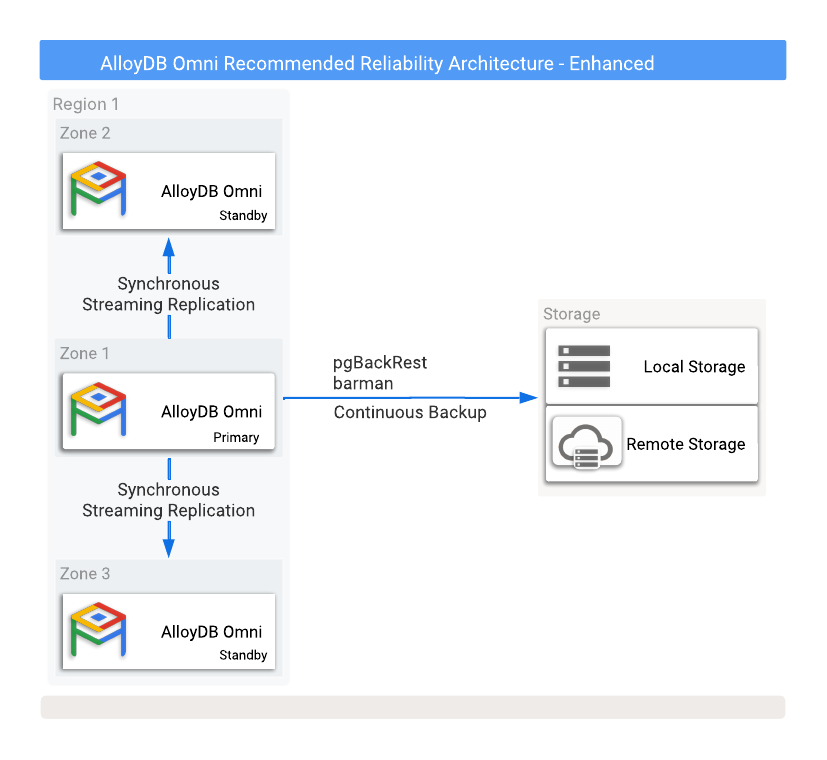
Figura 1. AlloyDB Omni con opzioni di backup e alta affidabilità.
Per proteggerti dalla perdita di dati in caso di errore dell'istanza principale, è necessario configurare la replica in modalità sincrona. Sebbene questo metodo offra una solida protezione dei dati, può influire sulle prestazioni del database primario perché tutti i commit devono essere scritti sia nel database primario sia in tutti i database in standby sincronizzati. Una connessione di rete a bassa latenza tra queste istanze di database è fondamentale per questa configurazione.
Deployment HA di Kubernetes
Per i deployment Kubernetes, utilizzando alcune modifiche e aggiunte di attributi di base al file di deployment di AlloyDB Omni, puoi aggiungere repliche di lettura o di standby di failover per consentire l'errore del database primario. È possibile configurare una replica di failover in standby e di sola lettura e l'operatore si occupa del provisioning e della pubblicazione del servizio. L'operatore automatizza anche molti dei processi di alta affidabilità, come la ricostruzione dei database in standby dopo un failover, e utilizza i meccanismi di riparazione integrati nel motore Kubernetes di AlloyDB Omni.
In un deployment Kubernetes, la disponibilità di infrastruttura e applicazioni trae vantaggio dalle funzionalità integrate di Kubernetes che gestiscono gli errori di nodi e pod, tra cui:
- kube-controller-manager
- Parametri come
node-status-update-frequency,node-monitor-period,node-monitor-grace-periodepod-eviction-timeout.
Oltre alla protezione integrata, l'operatore espone i seguenti parametri per influenzare il rilevamento di un'istanza principale o di standby non riuscita:
healthcheckPeriodSeconds: il tempo tra i controlli di integrità. Il valore predefinito è 30 secondi.autoFailoverTriggerThreshold: il numero di controlli di integrità consecutivi non riusciti prima di avviare il failover. Il valore predefinito è 3.
Per saperne di più, consulta Gestisci l'alta affidabilità in Kubernetes.
Implementazione
Quando scegli un'architettura di riferimento per la disponibilità, tieni presente i seguenti vantaggi, limitazioni e alternative.
Vantaggi
- Protegge dagli errori delle istanze.
- Protegge dagli errori del server.
- Protegge da errori a livello di zona.
- RTO notevolmente ridotto rispetto alla disponibilità standard.
Limitazioni
- Nessuna protezione aggiuntiva per i disastri a livello di regione.
- Potenziale impatto sulle prestazioni dell'istanza principale a causa della replica sincrona.
- La configurazione dello streaming WAL di PostgreSQL in modalità sincrona offre zero perdita di dati (
RPO=0) durante il normale funzionamento o i tipici failover. Tuttavia, questo approccio non protegge dalla perdita di dati in situazioni specifiche di doppio errore, ad esempio quando tutte le istanze in standby vengono perse o diventano irraggiungibili dall'istanza principale e questo evento è immediatamente seguito da un riavvio dell'istanza principale.
Alternative
- L'architettura di disponibilità standard per le opzioni di backup e ripristino.
- L'architettura di disponibilità Premium per il ripristino di emergenza a livello di regione, repliche di lettura aggiuntive e un raggio d'azione di ripristino di emergenza esteso.
Passaggi successivi
- Panoramica dell'architettura di riferimento per la disponibilità di AlloyDB Omni.
- Disponibilità standard di AlloyDB Omni.
- Disponibilità di AlloyDB Omni Premium.
- Architettura ad alta affidabilità per AlloyDB Omni per PostgreSQL.
- Gestisci l'alta affidabilità in Kubernetes.