


תרחישים לדוגמה
ארכיטקטורת הזמינות הזו מתאימה לתרחישים הבאים:
- אפליקציות קריטיות לעסק שדורשות RTO ו-RPO נמוכים יותר.
- אתם רוצים לפרוס רפליקה באזור או בצומת אחרים, כדי להבטיח זמינות גבוהה של מסדי הנתונים ולהגן מפני כשלים במכונות, בשרתים ובאזורים.
- אתם רוצים הגנה מפני טעויות משתמשים ופגיעה בנתונים (באמצעות גיבויים).
איך פועלת ארכיטקטורת ההפניה
הזמינות המשופרת היא תוספת לזמינות הרגילה. היא כוללת מופעים של העתקי קריאה באזור כדי לאפשר זמינות גבוהה (HA) שמקצרת את היעד לזמן השחזור (RTO). הגישה הזו גם מקטינה את היעד להתאוששות מאסון (RPO) בכך שהיא מאפשרת להעביר בסטרימינג שינויים טרנזקציונליים לרפליקה.
זמינות גבוהה ב-AlloyDB Omni מתבססת על לפחות שני מופעי מסד נתונים. מופע אחד משמש כמסד הנתונים הראשי, שתומך בפעולות קריאה וכתיבה. שאר המכונות משמשות כרפליקות לקריאה, שפועלות במצב קריאה בלבד.
אלה מושגים חשובים שקשורים לזמינות גבוהה:
- מעבר לגיבוי (Failover) הוא התהליך שמתבצע במהלך הפסקת שירות לא מתוכננת, שבו המופע הראשי נכשל או הופך ללא זמין, והעותק המשוכפל במצב המתנה מופעל כדי להניח את מצב הראשי (קריאה-כתיבה). התהליך הזה נקרא קידום. בדרך כלל, בתרחישים האלה, כשהשרת הראשי או מסד הנתונים חוזרים למצב אונליין, צריך לבנות מחדש את מסד הנתונים ואז הוא צריך לפעול כגיבוי. כדי לספק זמן פעולה תקינה גבוה, יש מנגנונים שמבצעים יתירות כשל אוטומטית.
- מעבר, שנקרא גם היפוך תפקידים, הוא הליך שמשמש להחלפת המצבים בין מסד הנתונים הראשי לבין אחד ממסדי הנתונים לגיבוי, כך שמסד הנתונים הראשי הופך למסד הנתונים לגיבוי ומסד הנתונים לגיבוי הופך למסד הנתונים הראשי. העברות מתרחשות בדרך כלל באופן מבוקר ומסודר, ויכולות להתבצע מכל מיני סיבות, למשל כדי לאפשר זמן השבתה ותיקון של מסד הנתונים הראשי הקודם. מעברים חלקים צריכים לאפשר מעבר חזרה בעתיד בלי צורך ליצור מחדש את המצב החדש של המתנה או היבטים אחרים של הגדרת הרפליקציה.
אפשרויות לזמינות גבוהה
בסביבות Kubernetes, כדי לתמוך בזמינות גבוהה, אפשר לפרוס את AlloyDB Omni באמצעות אופרטורים של AlloyDB Omni Kubernetes. מידע נוסף זמין במאמר ניהול זמינות גבוהה ב-Kubernetes.
| הערה: Patroni ו-HAProxy הם כלים לשימוש לא מסחרי של צד שלישי, והם תואמים ל-AlloyDB Omni. |
|---|
מומלץ להגדיר לפחות שני מסדי נתונים במצב המתנה, כדי שאובדן של מסד נתונים אחד לא ישפיע על הזמינות הגבוהה של האשכול. במצב הזה, יש לכם לפחות זוג HA אחד במקרה של מעבר לגיבוי או במהלך תחזוקה מתוכננת של צומת.
כדי לתכנן את הגודל והצורה של פריסת AlloyDB Omni, קראו את המאמר תכנון ההתקנה של AlloyDB Omni במכונה וירטואלית.
מאזני עומסים
מנגנון חשוב נוסף שעוזר להליכי מעבר ויתירות כשל חלקים יותר הוא נוכחות של מאזן עומסים.
מפעיל Kubernetes פורס מאזן עומסים משלו שפועל באופן דומה, ויוצר שירות למסד הנתונים שמפנה למאזן העומסים כדי שהתהליך יהיה שקוף למשתמש.
זמינות גבוהה
מסדי נתונים של רפליקות לקריאה שנפרסו באזור מסוים מספקים זמינות גבוהה אם מסד הנתונים הראשי נכשל. אם מתרחש כשל במסד הנתונים הראשי, מסד הנתונים המשני מקודם כדי להחליף את הראשי, והאפליקציה ממשיכה לפעול עם הפסקה קצרה או ללא הפסקה בכלל.
מומלץ לבצע בדיקות קבועות מדי שנה או חצי שנה, בצורה של מעברים, כדי לוודא שכל האפליקציות שמסתמכות על מסדי הנתונים האלה עדיין יכולות להתחבר ולהגיב בפרק זמן מתאים.
כדי להגן על הנתונים ברמת האזור, אפשר להשתמש בכל אחד מסוגי הפריסה ולהציב את אחת מהרפליקות לקריאה במצב המתנה באזור זמינות שונה מזה של מסד הנתונים הראשי.
יתרון נוסף של רפליקות לקריאה בלבד הוא היכולת להעביר פעולות לקריאה בלבד למסדי הנתונים במצב המתנה, שיכולים לשמש כמסדי נתונים לדיווח באמצעות נתונים עדכניים. הגישה הזו מפחיתה את העומס ואת התקורה בשרת הראשי לקריאה וכתיבה.
גיבויים והגדרת זמינות גבוהה
אפשר להגדיר עותקים לקריאה בלבד בכמה אזורים, כדי לספק זמינות גבוהה. הם מספקים RTO ו-RPO נמוכים, אבל לא מגנים מפני הפסקות מסוימות, כמו פגם לוגי בנתונים, למשל מחיקה של טבלה בטעות או עדכוני נתונים שגויים. לכן, בנוסף להגדרת הזמינות הגבוהה, צריך לבצע גיבויים באופן קבוע. פרטים נוספים זמינים במאמר בנושא ארכיטקטורת זמינות רגילה.
איור 1 מציג הגדרת זמינות גבוהה מומלצת עם שתי מסדי נתונים של העתקים לקריאה במצב המתנה בשני אזורי זמינות שונים.
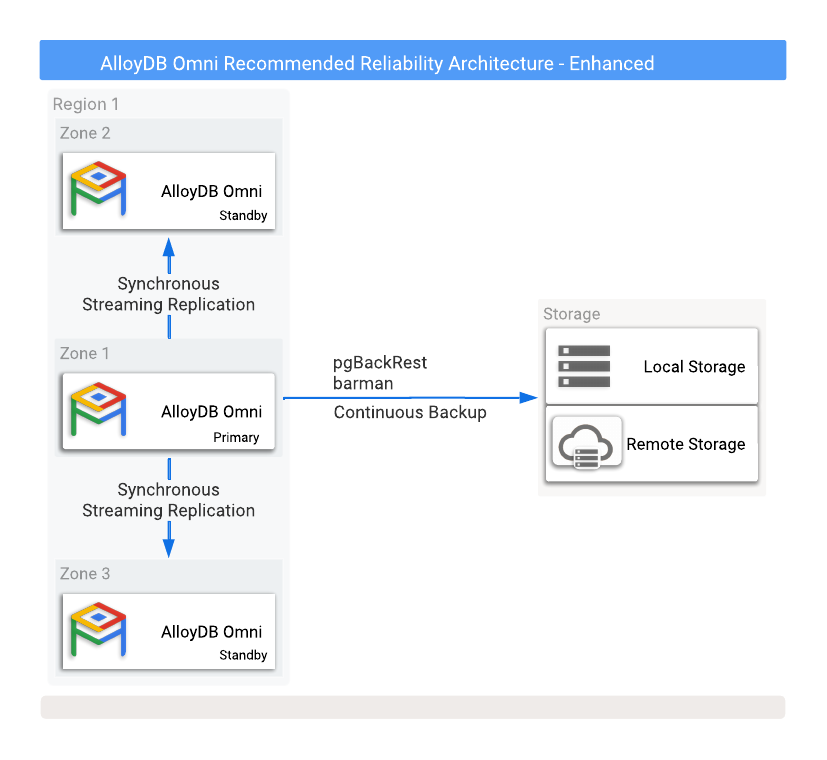
איור 1. AlloyDB Omni עם אפשרויות גיבוי וזמינות גבוהה.
כדי להגן על הנתונים מפני אובדן במקרה של כשל במופע הראשי, צריך להגדיר שכפול במצב סינכרוני. השיטה הזו מספקת הגנה חזקה על הנתונים, אבל היא עלולה להשפיע על הביצועים של מסד הנתונים הראשי כי כל הפעולות צריכות להיכתב גם במסד הנתונים הראשי וגם בכל מסדי הנתונים המשניים המסונכרנים. חיבור רשת עם זמן אחזור קצר בין המכונות של מסדי הנתונים האלה הוא קריטי להגדרה הזו.
פריסות של Kubernetes HA
בפריסות של Kubernetes, אתם יכולים להוסיף רפליקות לקריאה בלבד או רפליקות גיבוי למקרה של כשל במסד הנתונים הראשי. כדי לעשות את זה, אתם צריכים לשנות כמה מאפיינים בסיסיים ולהוסיף מאפיינים אחרים לקובץ הפריסה של AlloyDB Omni. אפשר להגדיר רפליקה לקריאה בלבד ורפליקה לגיבוי במקרה של כשל, והמפעיל דואג להקצאה ולפרסום של השירות. האופרטור גם מבצע אוטומציה של הרבה מתהליכי הזמינות הגבוהה, כמו בנייה מחדש של מסדי נתונים במצב המתנה אחרי יתירות כשל, ושימוש במנגנוני התיקון שמובנים במנוע AlloyDB Omni Kubernetes Engine.
בפריסת Kubernetes, הזמינות של התשתית והאפליקציות נהנית מתכונות מובנות של Kubernetes שמטפלות בכשלים של צמתים ו-Pods, כולל:
- kube-controller-manager
- פרמטרים כמו
node-status-update-frequency,node-monitor-period,node-monitor-grace-period, ו-pod-eviction-timeout.
בנוסף להגנה המובנית, האופרטור חושף את הפרמטרים הבאים כדי להשפיע על הזיהוי של כשל בשרת הראשי או בשרת הגיבוי:
-
healthcheckPeriodSeconds: משך הזמן בין בדיקות התקינות. ברירת המחדל היא 30 שניות. -
autoFailoverTriggerThreshold: מספר בדיקות התקינות הרצופות שנכשלו לפני הפעלת יתירות כשל. ערך ברירת המחדל הוא 3.
מידע נוסף זמין במאמר ניהול זמינות גבוהה ב-Kubernetes.
הטמעה
כשבוחרים ארכיטקטורת זמינות, חשוב לזכור את היתרונות, המגבלות והחלופות הבאים.
יתרונות
- הגנה מפני כשלים במכונות.
- הגנה מפני כשלים בשרת.
- הגנה מפני כשלים באזורים.
- ה-RTO מצטמצם באופן משמעותי בהשוואה לזמינות רגילה.
מגבלות
- אין הגנה נוספת מפני אסונות אזוריים.
- השפעה פוטנציאלית על הביצועים של המכונה הראשית בגלל רפליקציה סינכרונית.
- הגדרת סטרימינג של WAL ב-PostgreSQL במצב סינכרוני מונעת אובדן נתונים (
RPO=0) במהלך פעולה רגילה או יתירות כשל אופיינית. עם זאת, הגישה הזו לא מגנה מפני אובדן נתונים במצבים ספציפיים של כשל כפול, למשל כשכל המופעים במצב המתנה אובדים או שלא ניתן להגיע אליהם מהמופע הראשי, ומיד לאחר מכן מתבצעת הפעלה מחדש של המופע הראשי.
חלופות
- ארכיטקטורת זמינות רגילה לאפשרויות גיבוי ושחזור.
- ארכיטקטורת הזמינות Premium לתוכנית התאוששות מאסון (DR) ברמת האזור, רפליקות קריאה נוספות והיקף תוכנית התאוששות מאסון (DR) מורחב.
המאמרים הבאים
- סקירה כללית על ארכיטקטורת הייחוס של הזמינות ב-AlloyDB Omni
- AlloyDB Omni Standard Availability.
- AlloyDB Omni Premium Availability.
- ארכיטקטורת זמינות גבוהה ל-AlloyDB Omni ל-PostgreSQL.
- ניהול זמינות גבוהה ב-Kubernetes.