


תרחישים לדוגמה
ארכיטקטורת העזר הזו תומכת בתרחישים הבאים:
- יש לכם מסדי נתונים שיכולים לעמוד בפני השבתה מסוימת ואובדן נתונים מאז הגיבוי האחרון.
- אתם רוצים להגן על מסד הנתונים שלכם ב-AlloyDB Omni מפני שגיאות משתמש, נזק או כשלים פיזיים ברמת מסד הנתונים (בניגוד לצילום מצב של שרת או תמונת מכונה וירטואלית).
- אתם רוצים לשחזר את מסד הנתונים במקום או מרחוק, ואולי עד לנקודת זמן ספציפית.
איך פועלת ארכיטקטורת ההפניה
ארכיטקטורת ההפניה של זמינות רגילה כוללת גיבוי ושחזור של מסדי נתונים של AlloyDB Omni, בין אם הם פועלים כמופע עצמאי בשרת מארח, כמכונה וירטואלית (התקנה של AlloyDB Omni) או באשכול Kubernetes (התקנה של AlloyDB Omni ב-Kubernetes).
זמינות רגילה היא הטמעה בסיסית שמצמצמת את הצורך בחומרה או בשירותים נוספים, אבל יעד זמן ההתאוששות (RTO) גדל ככל שמסד הנתונים גדל. ככל שיש יותר נתונים לגיבוי, כך ייקח יותר זמן לשחזר את מסד הנתונים. אובדן הנתונים תלוי בסוג הגיבוי. אם רק קובצי הנתונים מגובים מדי פעם, כשמשחזרים את הנתונים, מאבדים את הנתונים שנוספו מאז הגיבוי האחרון.
הפחתת RPO
התכונה continuous archiving של PostgreSQL מאפשרת להשיג יעד נמוך להתאוששות מאסון (RPO) ולבצע שחזור מערכת מנקודה מסוימת בזמן (PITR) באמצעות גיבויים. התהליך הזה כולל ארכיון של קובצי Write-Ahead Logging (WAL) וסטרימינג של נתוני WAL, שיכול להיות שיישלחו למיקום אחסון מרוחק.
אם קובצי WAL מועברים לארכיון רק כשהם מלאים או במרווחי זמן ספציפיים, אובדן מלא של מסד הנתונים (כולל קובצי WAL הנוכחיים) מגביל את השחזור לקובץ ה-WAL האחרון שהועבר לארכיון. המשמעות היא שצריך להביא בחשבון אובדן נתונים פוטנציאלי ביעד להתאוששות מאסון (RPO). לעומת זאת, העברה רציפה של נתוני WAL ממזערת את הסיכון לאובדן נתונים.
כשמבצעים גיבויים רציפים, אפשר לבצע שחזור לנקודה ספציפית בזמן. שחזור מערכת מנקודה מסוימת בזמן (PITR) מאפשר לשחזר למצב שלפני שגיאה, כמו מחיקה מקרית של טבלה או חבילות עדכונים שגויות. עם זאת, שיטת השחזור הזו משפיעה על יעד נקודת השחזור (RPO), אלא אם משתמשים במסד נתונים זמני.
אסטרטגיות גיבוי
אתם יכולים להגדיר גיבויים ברמת Postgres ב-AlloyDB Omni כך שהם יישמרו באחסון מקומי או באחסון מרוחק. למרות שגיבוי ושחזור של אחסון מקומי יכולים להיות מהירים יותר, אחסון מרוחק בדרך כלל עמיד יותר לטיפול בכשלים כשמארח שלם או מכונה וירטואלית שלמה נכשלים.
גיבויים בסביבות שאינן Kubernetes
בפריסות שאינן Kubernetes, אפשר לתזמן גיבויים באמצעות הכלים הבאים של PostgreSQL:
- pgBackRest. מידע נוסף זמין במאמר בנושא הגדרת pgBackRest ל-AlloyDB Omni.
- ברמן. מידע נוסף זמין במאמר הגדרת Barman ל-AlloyDB Omni.
לחלופין, במסדי נתונים קטנים אפשר לבצע גיבוי לוגי של מסד הנתונים (באמצעות pg_dump למסד נתונים יחיד או pg_dumpall לאשכול כולו). אפשר לשחזר באמצעות pg_restore.
גיבויים ב-Kubernetes באמצעות אופרטור AlloyDB Omni
ב-AlloyDB Omni שנפרס באשכול Kubernetes, אפשר להגדיר גיבויים רציפים באמצעות תוכנית גיבוי לכל אשכול מסד נתונים. מידע נוסף זמין במאמר בנושא גיבוי ושחזור ב-Kubernetes.
אתם יכולים לאחסן את הגיבויים של AlloyDB Omni באופן מקומי או מרחוק ב-Cloud Storage, כולל אפשרויות שכל ספק ענן מציע. מידע נוסף מופיע באיור 1, שמציג יעדי גיבוי פוטנציאליים.
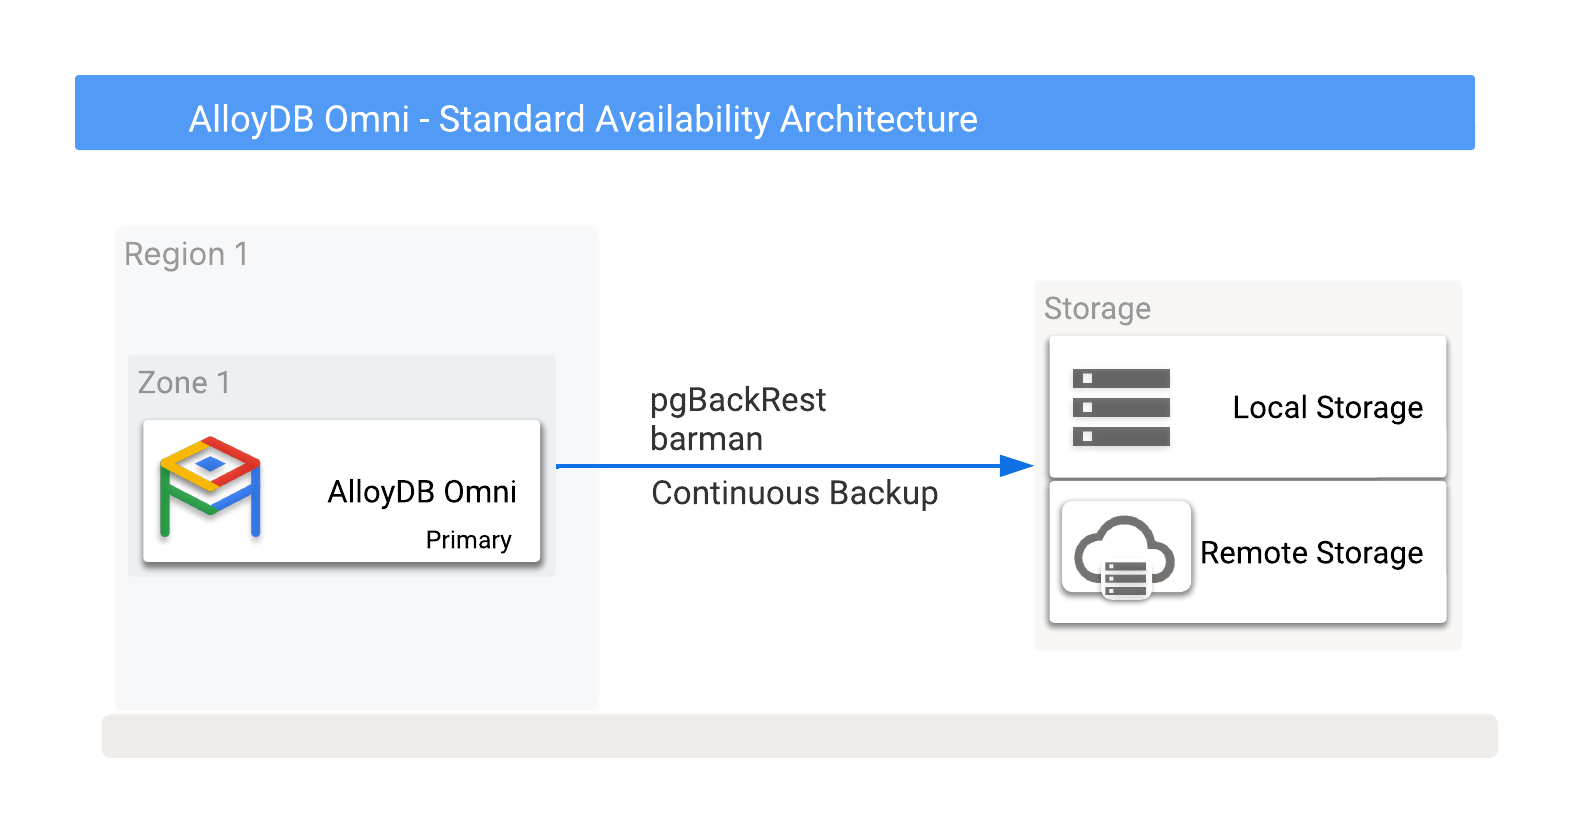
איור 1. AlloyDB Omni עם אפשרויות גיבוי.
אפשר לגבות את הנתונים באפשרויות אחסון מקומיות או מרחוק. גיבויים מקומיים בדרך כלל מהירים יותר כי הם מסתמכים רק על תפוקת קלט/פלט, ואילו לגיבויים מרחוק יש בדרך כלל זמן אחזור ארוך יותר ורוחב פס קטן יותר ברשת. עם זאת, גיבויים מרחוק מספקים הגנה אופטימלית, כולל במקרים של כשלים באזורים.
אתם יכולים גם לפצל את הגיבויים המקומיים לאחסון מקומי או לנפח אחסון משותף. אפשרויות האחסון המקומי מושפעות מהיעדר אפשרויות להתאוששות מאסון כשמארח מסד הנתונים נכשל, אבל אחסון משותף מאפשר להעביר את האחסון הזה לשרת אחר ואז להשתמש בו להתאוששות. המשמעות היא שנפח אחסון משותף יכול להציע RTO מהיר יותר.
בפריסות של אחסון מקומי ונפח אחסון משותף, יכול להיות שסוגי הגיבוי הבאים יתוזמנו או יבוצעו ידנית על פי דרישה:
- גיבויים מלאים: גיבויים מלאים של כל קובצי מסד הנתונים שנדרשים לשחזור נתונים.
- גיבויים דיפרנציאליים: גיבויים של השינויים בקבצים מאז הגיבוי המלא האחרון.
- גיבויים מצטברים: גיבויים של השינויים בקבצים בלבד מאז הגיבוי האחרון מכל סוג שהוא.
שחזור מערכת מנקודה מסוימת בזמן (PITR)
גיבויים רציפים של קובצי הכתיבה מראש ביומן (WAL) של PostgreSQL תומכים בשחזור מערכת מנקודה מסוימת בזמן (PITR). אם אחרי אירוע כשל קובצי ה-WAL תקינים וניתן להשתמש בהם, אפשר להשתמש בקבצים האלה כדי לשחזר את הנתונים בלי לאבד אותם.
כדי לשלוט בכתיבה של קובצי ה-WAL, אפשר להגדיר את הפרמטרים הבאים:
| פרמטר | תיאור |
|---|---|
|
ההגדרה קובעת באיזו תדירות כותב ה-WAL מרוקן את ה-WAL לדיסק, אלא אם הכתיבה מתבצעת מוקדם יותר על ידי טרנזקציה שמתבצעת באופן אסינכרוני. ערך ברירת המחדל הוא 200ms. הגדלת הערך הזה מפחיתה את תדירות הכתיבה, אבל היא עלולה להגדיל את כמות הנתונים שאובדים אם השרת קורס. |
|
כאן מציינים כמה נתוני WAL יכולים להצטבר לפני שכותב ה-WAL יבצע כתיבה לדיסק. ערך ברירת המחדל הוא 1MB. אם הערך הוא אפס, נתוני WAL תמיד נמחקים מהדיסק באופן מיידי. |
|
מציין אם ה-commit מחזיר תשובה למשתמש לפני שנתוני ה-WAL נמחקים מהדיסק. הגדרת ברירת המחדל היא on, שמבטיחה שהעסקה תהיה עמידה. במילים אחרות, ה-commit נכתב בדיסק לפני שהוחזר קוד הצלחה למשתמש. אם הערך מוגדר ל-off, אז יש עד שלוש פעמים wal_writer_delay לפני שהטרנזקציה נכתבת לדיסק. |
מעקב אחרי השימוש ב-WAL
אפשר להשתמש בשיטות הבאות כדי לבחון את השימוש ב-WAL:
| שיטת התצפית | תיאור |
|---|---|
|
בתצוגה הרגילה הזו יש את העמודות wal_write ו-wal_sync, שבהן מאוחסנים מספר הכתיבות ב-WAL ומספר הסנכרונים של WAL. כשהפרמטר track_wal_io_timing מופעל, גם wal_write_time ו-wal_sync_time נשמרים. תמונות מצב רגילות של התצוגה הזו יכולות לעזור להציג את פעילות הכתיבה והסנכרון של WAL לאורך זמן. |
pg_current_wal_lsn() |
הפונקציה הזו מחזירה את המיקום הנוכחי של המספר הסידורי של היומן (LSN). כשמשייכים אותו לחותמת זמן ואוספים אותו כתמונות מצב לאורך זמן, אפשר לקבל את הבייטים לשנייה של WAL שנוצר באמצעות הפונקציה pg_wal_lsn_diff(lsn1, lsn2).
הפונקציה הזו היא מדד שימושי להבנת קצב העסקאות ולביצועים של קובצי ה-WAL. |
העברת נתוני WAL בסטרימינג למיקום מרוחק
כשמשתמשים ב-Barman, אפשר גם להגדיר את נתוני ה-WAL כך שיוזרמו בזמן אמת למיקום מרוחק, כדי להבטיח שלא יהיה אובדן נתונים או שיהיה אובדן נתונים מינימלי בשחזור. למרות הסטרימינג בזמן אמת, יש סיכוי קטן לאבד טרנזקציות שבוצעו, כי כתיבת הסטרימינג לשרת Barman המרוחק היא אסינכרונית כברירת מחדל. עם זאת, אפשר להגדיר הזרמת WAL באמצעות המצב הסינכרוני ששומר את ה-WAL ושולח תגובת סטטוס בחזרה למסד הנתונים המקורי. חשוב לזכור שהגישה הזו עלולה להאט את העסקאות אם הן צריכות להמתין עד שהכתיבה הזו תושלם לפני שהן ממשיכות.
לוחות זמנים לגיבויים
ברוב הסביבות, הגיבויים מתוזמנים בדרך כלל על בסיס שבועי. הטבלה הבאה מציגה לוח זמנים שבועי אופייני לגיבויים:
- יום ראשון: גיבוי מלא
- שני, שלישי: גיבוי
- יום רביעי: גיבוי דיפרנציאלי
- יום חמישי, יום שישי: גיבוי מצטבר
- שבת: גיבוי דיפרנציאלי
לפי לוח הזמנים הזה, כדי לשמור גיבויים שמתעדכנים כל הזמן למשך שבוע, צריך נפח אחסון לגיבוי מלא אחד ועוד גיבויים מצטברים או גיבויים דיפרנציאליים. הגישה הזו תומכת בשחזור במקרה של כשל שמתרחש במהלך הגיבוי המלא ביום ראשון, וצריך להרחיב את שחזור מסד הנתונים ליום ראשון הקודם, לפני תחילת הגיבוי.
כדי למזער את זמן ההתאוששות (RTO) עם פוטנציאל לנקודת התאוששות (RPO) גבוהה יותר, אפשר להפעיל מסדי נתונים נוספים במצב התאוששות רציף. התהליך הזה כולל הפעלה מחדש של גיבויים ועדכון רציף של הסביבה המשנית על ידי העברה לארכיון והפעלה מחדש של קובצי WAL חדשים. ה-RPO בפועל, שמשקף אובדן נתונים פוטנציאלי, תלוי בתדירות הטרנזקציות, בגודל קובץ ה-WAL ובשימוש בסטרימינג של WAL.
שחזור בסביבה שהיא לא Kubernetes
בפריסות שהן לא Kubernetes, כדי לשחזר מסד נתונים של AlloyDB Omni צריך לעצור את מאגר Docker ואז לשחזר את הנתונים, או לשחזר את הנתונים למיקום אחר ולהפעיל מכונה חדשה של Docker באמצעות הנתונים ששוחזרו. אחרי שהקונטיינר מופעל מחדש, אפשר לגשת למסד הנתונים עם הנתונים ששוחזרו.
מידע נוסף על אפשרויות שחזור זמין במאמרים שחזור אשכול AlloyDB Omni באמצעות pgBackRest ושחזור אשכול AlloyDB Omni באמצעות Barman.
שחזור ב-Kubernetes באמצעות Operator
כדי לשחזר מסד נתונים ב-Kubernetes, האופרטור מציע שחזור לאותו אשכול Kubernetes ולמרחב השמות, מגיבוי עם שם או משיבוט מנקודת זמן מסוימת (PIT). כדי לשכפל מסד נתונים לאשכול Kubernetes אחר, משתמשים ב-pgBackRest. מידע נוסף זמין במאמרים גיבוי ושחזור ב-Kubernetes ושיבוט של אשכול מסדי נתונים מגיבוי של Kubernetes – סקירה כללית.
הטמעה
כשבוחרים ארכיטקטורת זמינות, חשוב לזכור את היתרונות, המגבלות והחלופות הבאים.
יתרונות
- קל לשימוש ולניהול, ומתאים למסדי נתונים לא קריטיים עם RTO/RPO גמישים.
- נדרשת חומרה נוספת מינימלית
- תמיד צריך גיבויים כדי להכין תוכנית התאוששות מאסון (DR) מלאה
- אפשר לשחזר לכל נקודת זמן בתוך חלון השחזור
מגבלות
- דרישות אחסון שעשויות להיות גדולות יותר ממסד הנתונים עצמו, בהתאם לדרישות השמירה.
- ההתאוששות יכולה להיות איטית, וזמן ההתאוששות (RTO) עשוי להיות ארוך יותר.
- עלול לגרום לאובדן נתונים מסוים, בהתאם לזמינות של נתוני ה-WAL הנוכחיים אחרי כשל במסד הנתונים, מה שעלול להשפיע לרעה על RPO.
חלופות
- כדאי לשקול את ארכיטקטורת הזמינות המשופרת או פרימיום כדי לשפר את הזמינות ואת אפשרויות ההתאוששות מאסון.
המאמרים הבאים
- סקירה כללית על ארכיטקטורת הייחוס של הזמינות ב-AlloyDB Omni
- זמינות משופרת של AlloyDB Omni.
- זמינות של AlloyDB Omni Premium.
- התקנה של AlloyDB Omni ב-Kubernetes.
- הגדרת pgBackRest ל-AlloyDB Omni
- הגדרת Barman ל-AlloyDB Omni
- גיבוי ושחזור ב-Kubernetes.
- שחזור אשכול AlloyDB Omni באמצעות pgBackRest
- שחזור אשכול AlloyDB Omni באמצעות Barman.
- גיבוי ושחזור ב-Kubernetes.
- סקירה כללית על שכפול של אשכול מסד נתונים מגיבוי של Kubernetes