


בדף הזה מוסבר איך להגדיר זמינות גבוהה ב-AlloyDB Omni. בדף הזה מוסבר רק איך ליצור מכונה חדשה של AlloyDB Omni בהגדרת זמינות גבוהה. הוא לא כולל המרה של מכונות קיימות לזמינות גבוהה.
לפני שמתחילים
אם עדיין אין לכם פרויקט, צרו פרויקט ב- Google Cloud .
מוודאים שהחיוב מופעל בפרויקט.
פותחים את Cloud Shell במסוף Google Cloud .
במסוף Google Cloud , משכפלים את מאגר המקור הבא.
git clone https://github.com/GoogleCloudPlatform/cloud-solutions.git
התקנה
במדריך הזה נסביר איך פורסים אשכול Patroni עם שלושה צמתים באמצעות AlloyDB Omni, ואשכול etcd עם שלושה צמתים כמאגר התצורה. בחלק הקדמי של האשכול, אנחנו משתמשים ב-HAProxy בקבוצת מופעי מכונה מנוהלים בשביל כתובת ה-IP הצפה, כדי שיתירות הכשל תהיה שקופה ללקוחות.
ההגדרה הראשונית של המערך הזה מוצגת בדיאגרמה הבאה:
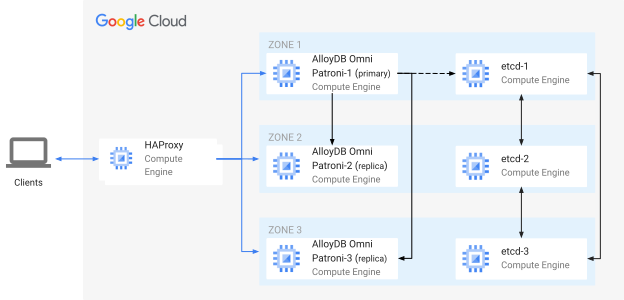
איור 1. הגדרה שבה HAProxy מנהל את החיבור בין הלקוחות לבין הצומת הראשי.
אם מתרחשת הפסקה, ההגדרות משתנות לתרשים הבא:
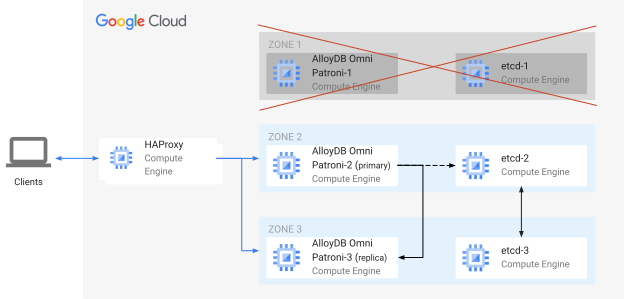
איור 2. הגדרות מעודכנות שבהן הצומת הראשי שנכשל מוחלף בצומת המתנה.
אם מספר הלקוחות שמתחברים למסד הנתונים הופך לבעיה ונתקלים בבעיות בביצועים בגלל מספר גדול של חיבורים בו-זמניים למסד הנתונים, מומלץ להוסיף מאגר חיבורים בצד האפליקציה. אם אתם לא יכולים לעשות את זה, אתם יכולים להוסיף מאגר חיבורים בצד מסד הנתונים באמצעות כלי כמו PgBouncer.
פריסה
ב-Cloud Shell, אחרי שמשכפלים את המאגר של Cloud Solutions, עוברים לספריית Terraform.
cd cloud-solutions/projects/alloydbomni-ha-patroni-etcd/terraform
יוצרים ועורכים קובץ
terraform.tfvars. בקובץ, מגדירים ערכים למשתנים הבאים.project_id = "PROJECT_ID" region = "REGION" zones = "ZONES" node_count = 3 cluster_name = "CLUSTER_NAME" replication_user_password = "REPLICATION_USER_PASSWORD" postgres_super_user_password = "PG_SUPER_USER_PASSWORD"תיאורים של כל משתנה מופיעים ב-GitHub בקובץ התצורה של המשתנים.
מריצים את סקריפט Terraform כדי ליצור את כל המשאבים.
terraform init && terraform apply
הסקריפט הזה יוצר ומגדיר את הדברים הבאים:
שלושה צמתים לאשכול ה-etcd
שלושה צמתים לאשכול Patroni
צומת אחד ל-HAProxy
הגדרת Patroni כסינכרוני
כדי ש-Patroni ישתמש רק ברפליקציה סינכרונית באשכול של שלושת הצמתים, הוסיפו פריטי הגדרה כמו synchronous_mode, synchronous_node_count, synchronous_commit ו-synchronous_standby_names בקטע bootstrap בקובצי התצורה של Patroni. ההגדרות של Patroni מוגדרות בתבנית של סקריפט לטעינה בזמן ההפעלה ובקובץ /alloydb/config/patroni.yml בצמתים של Patroni. כדי להשתמש בשכפול סינכרוני, הגדרת האתחול של Patroni צריכה להיראות כך:
bootstrap:
  dcs:
    ttl: 30
    loop_wait: 10
    retry_timeout: 10
    maximum_lag_on_failover: 1048576
    synchronous_mode: true
    synchronous_node_count: 2
    postgresql:
      use_pg_rewind: true
      use_slots: true
      parameters:
        hot_standby: "on"
        wal_keep_segments: 20
        max_wal_senders: 8
        max_replication_slots: 8
        synchronous_commit: remote_apply
        synchronous_standby_names: '*'
כשההגדרה synchronous_mode מופעלת, Patroni משתמש ברפליקציה סינכרונית בין הרפליקה הראשית לרפליקות האחרות. הפרמטר synchronous_node_count משמש את Patroni לניהול מספר הרפליקות של הגיבוי הסינכרוני. Patroni מנהל מספר מדויק של רפליקות המתנה סינכרוניות על סמך הפרמטר synchronous_node_count, ומתאים את המצב במאגר ההגדרות וב-synchronous_standby_names כשחברים מצטרפים ועוזבים. מידע נוסף על שכפול סינכרוני זמין בקטע מצבי שכפול במסמכי העזרה של Patroni.