


כשמשווים את הביצועים, חשוב להגדיר מראש מה אתם רוצים ללמוד מהבדיקה. לדוגמה:
- מהו קצב העברת הנתונים המקסימלי שהמערכת יכולה להשיג?
- כמה זמן נמשכת שאילתה או עומס עבודה מסוימים?
- איך הביצועים משתנים ככל שכמות הנתונים גדלה?
- איך משווים בין הביצועים של שתי מערכות שונות?
- בכמה זמן מנוע מבוסס-עמודות מקצר את זמן התגובה של ביצועי השאילתה?
- כמה עומס מסד נתונים יכול לשאת לפני שצריך לשקול שדרוג למכונה חזקה יותר?
כדי להבין את המטרות של מחקר הביצועים, צריך לדעת איזה מבחן ביצועים להריץ, איזו סביבה נדרשת ואילו מדדים צריך לאסוף.
יכולת חזרה
כדי להסיק מסקנות מבדיקות ביצועים, תוצאות הבדיקה צריכות להיות ניתנות לשחזור. אם יש שונות רבה בתוצאות הבדיקה, יהיה קשה להעריך את ההשפעה של השינויים שביצעתם באפליקציה או בהגדרות המערכת. כדי להקטין את מידת השונות, מומלץ להריץ את הבדיקות מספר פעמים או למשך תקופות ארוכות יותר כדי לקבל יותר נתונים.
באופן אידיאלי, כדאי להריץ בדיקות ביצועים במערכות שמבודדות ממערכות אחרות. אם תפעילו את הבדיקה בסביבה שבה מערכות חיצוניות יכולות להשפיע על ביצועי האפליקציה, אתם עלולים להגיע למסקנות שגויות. בדרך כלל אי אפשר להשיג בידוד מלא כשמריצים בסביבת ענן עם מספר דיירים, ולכן צפויים הבדלים גדולים יותר בתוצאות
חלק מהחזרה על הבדיקה הוא לוודא שעומס העבודה של הבדיקה נשאר זהה בין ההרצות. אפשר להשתמש במידה מסוימת של אקראיות בקלט של הבדיקה, כל עוד האקראיות לא גורמת להתנהגות שונה באופן משמעותי של האפליקציה. אם קלט לקוח שנוצר באופן אקראי משנה את השילוב של פעולות קריאה וכתיבה מהרצה להרצה, הביצועים ישתנו באופן משמעותי.
גודל מסד הנתונים, שמירה במטמון ודפוסי קלט/פלט
חשוב לוודא שכמות הנתונים שאתם בודקים מייצגת את האפליקציה שלכם. אם יש לכם מאות ג'יגה-בייטים או טרה-בייטים של נתונים, הרצת בדיקות עם כמות קטנה של נתונים כנראה לא תיתן ייצוג אמיתי של ביצועי האפליקציה. גודל מערך הנתונים משפיע גם על הבחירות של הכלי לאופטימיזציה של שאילתות. שאילתות על טבלאות בדיקה קטנות עשויות להשתמש בסריקות טבלה שנותנות ביצועים נמוכים בקנה מידה גדול יותר, ולא תזהו אינדקסים חסרים בהגדרה הזו.
כדאי לשאוף לשכפל את דפוסי הקלט/פלט של האפליקציה. היחס בין פעולות קריאה לפעולות כתיבה חשוב לפרופיל הביצועים של האפליקציה.
משך ההשוואה לשוק
במערכת מורכבת, יש הרבה מידע על המצב שנשמר בזמן שהמערכת פועלת: נוצרים חיבורים למסדי נתונים, מטמונים מתמלאים, תהליכים ושרשורים נוצרים. בתחילת בדיקת הביצועים, יכול להיות שהאתחול של הרכיבים האלה ינצל משאבי מערכת וישפיע לרעה על הביצועים שנמדדים, אם זמן הריצה של עומס העבודה קצר מדי.
מומלץ להריץ בדיקות ביצועים במשך 20 דקות לפחות כדי למזער את ההשפעות של חימום המערכת. מודדים את הביצועים במצב יציב אחרי ההפעלה, ולמשך זמן ארוך מספיק כדי לוודא שכל ההיבטים של פעולות מסד הנתונים נכללים. לדוגמה, נקודות ביקורת במסדי נתונים הן תכונה קריטית של מערכות מסדי נתונים, ויכולה להיות להן השפעה משמעותית על הביצועים. אם תריצו בדיקת ביצועים קצרה שמסתיימת לפני מרווח הזמן של נקודת הבדיקה, הגורם החשוב הזה בהתנהגות של האפליקציה יוסתר.
בדיקה שיטתית
כשמבצעים אופטימיזציה של הביצועים, משנים רק משתנה אחד בכל פעם. אם תשנו כמה משתנים בין הרצות, לא תוכלו לבודד את המשתנה ששיפר את הביצועים. למעשה, יכול להיות ששינויים מרובים יאזנו אחד את השני, כך שלא תראו את היתרון של שינוי מתאים. אם שרת מסד הנתונים מנוצל יתר על המידה, נסו לעבור למכונה עם יותר מעבדי vCPU תוך שמירה על עומס קבוע. אם שרת מסד הנתונים לא מנוצל מספיק, נסו להגדיל את העומס תוך שמירה על הגדרת המעבד (CPU) קבועה.
הטופולוגיה של הרשת וזמני האחזור
הטופולוגיה של הרשת במערכת שלכם יכולה להשפיע על תוצאות בדיקת הביצועים. זמן האחזור בין אזורים שונה. כשמבצעים בדיקות ביצועים, חשוב לוודא שהלקוח ואשכול מסד הנתונים נמצאים באותו אזור כדי למזער את זמן האחזור ברשת ולהשיג את הביצועים הטובים ביותר – במיוחד באפליקציות עם תפוקה גבוהה ועסקאות קצרות, כי זמן האחזור ברשת יכול להיות רכיב משמעותי בזמן התגובה הכולל של העסקה.
כשמשווים בין הביצועים של שתי מערכות שונות, חשוב לוודא שהטופולוגיה של הרשת זהה בשתי המערכות. חשוב לזכור שאי אפשר לבטל לגמרי את השונות בזמן האחזור ברשת, וגם באותו אזור יכולים להיות הבדלים בזמן האחזור בגלל הטופולוגיות של הרשת.
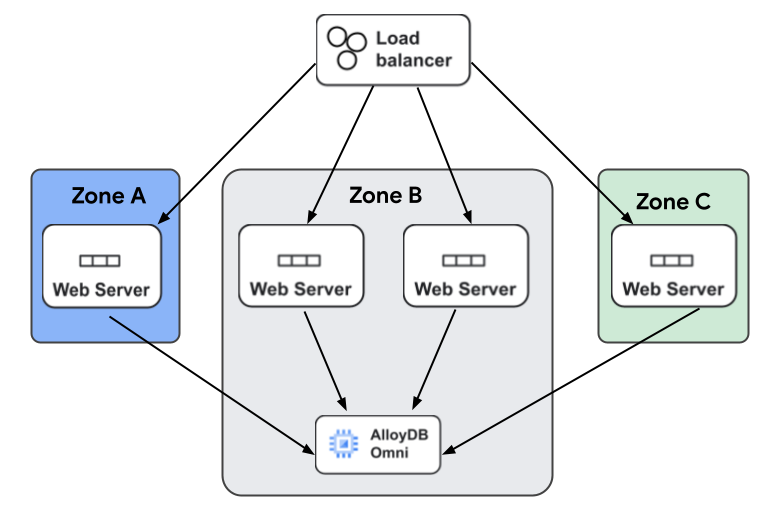
כשפורסים את האפליקציה, כדאי להבין טוב יותר את ההשפעה של השהיות בין אזורים על ידי התייחסות לאפליקציית אינטרנט טיפוסית עם נפח גבוה. באפליקציה יש מאזן עומסים ששולח בקשות לכמה שרתי אינטרנט שנפרסו בכמה אזורים כדי להשיג זמינות גבוהה. זמני האחזור עשויים להשתנות בהתאם לשרת האינטרנט שמעבד את הבקשה, בגלל הבדלים בזמני האחזור בין אזורים שונים.
באיור הבא מוצגת הארכיטקטורה האופיינית של אפליקציית אינטרנט שמשתמשת ב-AlloyDB Omni. בקשות של לקוחות מטופלות על ידי מאזן עומסים, שמעביר כל בקשה לאחד משרתי האינטרנט הרבים. כל שרתי האינטרנט מחוברים ל-AlloyDB Omni. חלק מהשרתים נמצאים באזור שונה מזה שבו AlloyDB Omni פועל, ולכן זמן האחזור יהיה ארוך יותר כשמבצעים בקשות למסד הנתונים.
מעקב אחרי ניצול המשאבים במערכת
כדי לבצע אופטימיזציה של הביצועים של מערכת מסד הנתונים, צריך לעקוב אחרי השימוש במשאבים של מערכת מסד הנתונים ושל מערכות הלקוח שמשתמשות במערכת מסד הנתונים. באמצעות מעקב אחרי שתי המערכות, אפשר לוודא שמערכות הלקוח מספקות עומס עבודה מספיק כדי לקבל מדידות משמעותיות במערכת מסד הנתונים. חשוב מאוד לעקוב אחרי ניצול המשאבים של המערכת שאתם בודקים. חשוב גם לעקוב אחרי ניצול המשאבים של מערכות הלקוח שבהן אתם משתמשים כדי להפעיל את עומס העבודה. לדוגמה, אם אתם רוצים לקבוע את מספר הלקוחות המקסימלי שמערכת מסד הנתונים שלכם יכולה לתמוך בו לפני שייגמרו משאבי ה-CPU, תצטרכו מספיק מערכות לקוח כדי ליצור את עומס העבודה הנדרש לניצול כל משאבי ה-CPU במערכת מסד הנתונים. לא תוכלו להפעיל את מערכת מסד הנתונים בצורה מספיק חזקה אם למכונות הלקוח שיוצרות עומס אין מספיק מעבד (CPU) בעצמן.
בדיקות מדרגיות
בדיקות יכולת הרחבה הן היבט נוסף של בדיקות ביצועים. יכולת התאמה לעומס מתייחסת לשינוי במדדי הביצועים כתוצאה משינוי במאפיין אחד של עומס העבודה. דוגמאות למחקרים בנושא יכולת הרחבה:
- איך עלייה במספר הבקשות המקבילות משנה את התפוקה ואת זמני התגובה?
- איך הגדלת מסד הנתונים משפיעה על קצב העברת הנתונים וזמני התגובה?
בדיקות יכולת ההתאמה כוללות כמה הרצות של עומס עבודה, שבהן משנים מאפיין יחיד בין ההרצות ואוספים ומשרטטים מדד אחד או יותר. סוג כזה של בדיקות עוזר לקבל החלטות לגבי צווארי הבקבוק שקיימים במערכת, מהו עומס העבודה שהמערכת יכולה לטפל בו בהתאם להגדרות ספציפיות, מהו עומס העבודה המקסימלי שהמערכת יכולה לתמוך בו ומהי ההתנהגות של המערכת כשהעומס עולה מעבר לרמות האלה.
שיקולים לגבי גודל המכונה
AlloyDB Omni כולל הרבה תכונות חדשות ל-Postgres כדי לשפר את המהימנות והזמינות של מסד הנתונים. המעקב שנדרש לכך משתמש במשאבים במכונה שבה פועל AlloyDB Omni. במכונות קטנות מאוד יש משאבי זיכרון ומעבד (CPU) מוגבלים מלכתחילה, ולכן מומלץ להשתמש במכונות עם ארבעה מעבדי vCPU לפחות לצורך השוואה.