


הארכיטקטורה לדוגמה הזו מתאימה במיוחד לתרחישי השימוש הבאים:
- אתם צריכים הגנה אזורית בנוסף להגנה ברמת האזור (zone) לאפליקציות קריטיות.
ארכיטקטורת הייחוס הזו לזמינות משלבת עותקים לקריאה בלבד באזור לזמינות גבוהה, ובאזורים שונים להתאוששות מאסון. הפריסה הזו בכמה אזורים מגינה מפני שיבושים משמעותיים, כולל הפסקות חשמל נרחבות ואסונות טבע בקנה מידה גדול.
שיקולים לגבי ארכיטקטורת הפניה לזמינות
כשמעריכים את ארכיטקטורת ההפניה הזו של הזמינות, חשוב להתייחס לגורמים הבאים:
- זמן האחזור ורוחב הפס של הרשת בתוך האזור ובין אזורים שונים
- מיקום גיאוגרפי של מסדי נתונים ושרתי אפליקציות
- אסטרטגיה להעברת עומסי עבודה לקריאה בלבד לרפליקות
- פריסת זמינות גבוהה באזור ה-DR המרוחק
יכול להיות שיהיה צורך באיזון עומסים לקריאה בלבד, במיוחד אם אתם משתמשים בשרתי אפליקציות אזוריים, כדי שהבקשות יועברו למסד הנתונים הקרוב ביותר וזמן התגובה יהיה המהיר ביותר. מידע נוסף זמין במאמר ניתוב בקשות למאזן עומסים של אפליקציות (ALB) קלאסי במספר אזורים.
יכול להיות שתידרש בקרה נוספת על הרפליקציה בין אזורים, כדי לוודא שהעיכוב ברפליקציה לא מתחיל לגדול בגלל עומס טרנזקציות או קיבולת הרשת.
כדי לוודא שה-DR יתבצע בהצלחה, חשוב לבצע בדיקות מקיפות של DR. חשוב לבדוק את הפונקציונליות של האפליקציה ואת קצב העברת הנתונים אם יש חיבורים לרשת עם זמן אחזור גבוה בין שרתי האפליקציות לבין מסד הנתונים.
ארכיטקטורות של זמינות גבוהה באותו אזור ושל התאוששות מאסון באזורים שונים
איור 1 מציג תצורת HA ו-DR מומלצת עם שלוש מסדי נתונים משניים לקריאה במצב המתנה בשלושה אזורי זמינות ובשני אזורים.
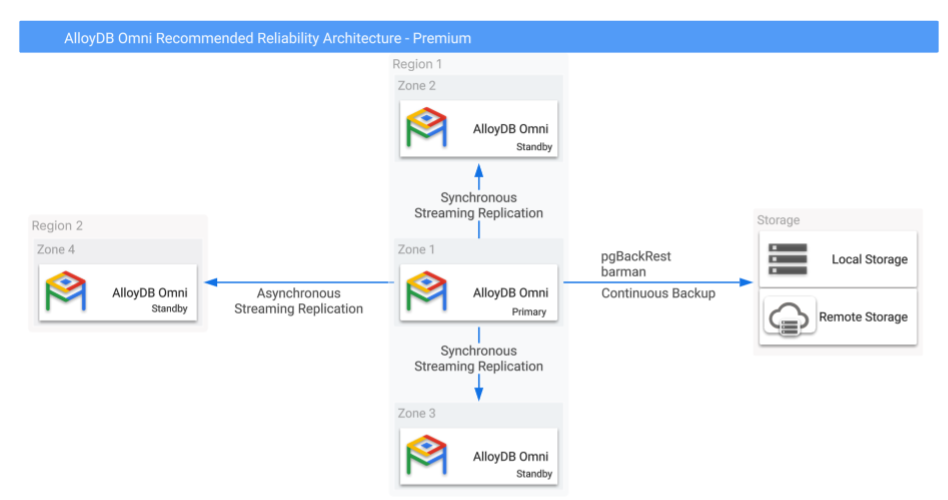
איור 1. AlloyDB Omni עם גיבויים ואפשרויות זמינות גבוהה (HA) בין אזורים.
כפי שמוצג באיור 1, רפליקציה סינכרונית של סטרימינג לרפליקות מקומיות (באותו אזור) מספקת זמינות גבוהה, ואילו רפליקציה אסינכרונית של סטרימינג לרפליקה מרוחקת שמופרדת מבחינה גיאוגרפית מספקת הגנה אזורית של תוכנית התאוששות מאסון. בכל ההגדרה, רק המכונה הראשית יכולה לבצע פעולות קריאה וכתיבה, בעוד שהרפליקות האחרות יכולות להציג שאילתות קריאה.
מגדירים את הרפליקציה מהרפליקה הראשית לרפליקות באותו אזור במצב סינכרוני, ואת הרפליקציה לרפליקות באזורים אחרים במצב אסינכרוני, כדי שהזמן שלוקח להעביר את הנתונים לא ישפיע על ביצועי הכתיבה של הרפליקה הראשית. במקרה של כשל אזורי, ההגדרה הזו עלולה להוביל ל-RPO שאינו אפס. עם זאת, ההגדרה הזו מאפשרת קיצור של זמן ההשבתה במקרה של כשל. הסיבה לכך היא שמסד הנתונים הראשי לא צריך לחכות לאישור ממסדי נתונים מרוחקים במצב המתנה לפני שהוא מבצע טרנזקציות.
אפשר להגדיר גיבויים נוספים באזורים שונים, שיגבו את מסדי הנתונים של הרפליקות לקריאה בלבד, וכך להוסיף יתירות לגיבויים של מסד הנתונים הראשי.
גיבויים של עותקים לקריאה
כשמשתמשים בפריסות שאינן של Kubernetes, אפשר לבחור לפרוס גיבויים בהתאם לצרכים העסקיים.
כמה נקודות שכדאי לחשוב עליהן:
- אם יש סיכוי שהגיבוי מרחוק שלכם יהיה רגיש לכשל באזור, תצטרכו ליזום גיבויים נוספים באזורים החלופיים.
- אם אתם צריכים יתירות בגיבוי, אתם צריכים לבצע גיבויים של עותקים לקריאה אזוריים.
מיקום של רפליקה לקריאה כדי לתמוך בזמינות של כמה אזורים
בפריסות שאינן Kubernetes, אתם יכולים לבחור רפליקות קריאה ספציפיות שיקבלו את התפקיד של הרפליקה הראשית במקרה של כשל ברפליקה הראשית.
העברה מארכיטקטורה של זמינות גבוהה בלבד לארכיטקטורה של זמינות גבוהה והתאוששות מאסון
בפריסות שאינן של Kubernetes, צריך ליצור המתנה חדשה באזור חדש ולהוסיף את ההגדרה הזו להגדרת אשכול Patroni.
הטמעה
כשבוחרים ארכיטקטורת הפניה לזמינות, חשוב לזכור את היתרונות, המגבלות והאפשרויות הבאים.
יתרונות
- הגנה מפני כשלים באזורים ובמכונות
- הגנה מפני כשלים אזוריים
- ה-RTO יורד כשיש כשל אזורי במסד הנתונים
מגבלות
- אפשר להפחית את ה-RPO לשחזור אזורי באמצעות שכפול סינכרוני, אבל הגישה הזו גורמת לזמן אחזור נוסף בביצועי העסקאות. לצורך DR ורפליקציה לאזור מרוחק, מומלץ להשתמש רק ברפליקציה אסינכרונית.
- הגדרת סטרימינג של WAL ב-PostgreSQL במצב סינכרוני מונעת אובדן נתונים (
RPO=0) במהלך פעולה רגילה או יתירות כשל אופיינית. עם זאת, הגישה הזו לא מגינה מפני אובדן נתונים במצבים ספציפיים של תקלה כפולה, למשל כשכל המכונות במצב המתנה אובדות או שאי אפשר להגיע אליהן מהמכונה הראשית, ומיד לאחר מכן המכונה הראשית מופעלת מחדש.
אפשרויות להגנה על הנתונים
- ארכיטקטורת זמינות סטנדרטית לאפשרויות גיבוי ושחזור.
- ארכיטקטורה לזמינות משופרת לאפשרויות של זמינות גבוהה.
המאמרים הבאים
- סקירה כללית של ארכיטקטורת ההפניה לזמינות ב-AlloyDB Omni.
- AlloyDB Omni Standard Availability.
- זמינות משופרת של AlloyDB Omni.
- עבודה עם רפליקציה בין מרכזי נתונים.
- ניתוב בקשות למאזן עומסים קלאסי של אפליקציות (ALB) בכמה אזורים.