


כדי לתת לאפליקציות התפעוליות גישה לנתוני הניתוח עם זמן אחזור קצר, אתם יכולים לסנכרן טבלאות מ-BigQuery למכונה של AlloyDB ל-PostgreSQL. בניגוד למעטפת נתונים זרים (FDW), ששולחת שאילתות לנתונים ב-BigQuery, תכונת הסנכרון מעתיקה את הנתונים לאחסון ב-AlloyDB כדי שהשאילתות יקראו מטבלאות מקומיות, וכך משפרת את הביצועים.
ב-AlloyDB יש כמה דרכים להעביר נתונים מ-BigQuery למכונה:
סנכרון חד-פעמי: יוצר עותק עצמאי של הטבלה ב-BigQuery, שניתן לכתוב בו.
סנכרון או שיקוף תקופתי: יוצר טבלה מקומית לקריאה בלבד שמתרעננת באופן אוטומטי לפי לוח זמנים – לדוגמה, כל 6 שעות או מדי יום.
שיקולים תפעוליים ושיקולי ביצועים
כשמשתמשים בטבלאות סנכרון של BigQuery, חשוב לשים לב לנקודות הבאות:
- שימוש במשאבים: העברת נתונים צורכת מעבד (CPU) וזיכרון. בטבלאות גדולות מאוד, כדאי לתזמן סנכרון בשעות שאינן שעות שיא כדי לא להשפיע על עומס העבודה העיקרי של הטרנזקציות.
- חשיפת הנתונים: במהלך פעולת החלפה, טבלת היעד הקיימת נמחקת ונוצרת מחדש מראש. במהלך הייבוא, השאילתות רואות בהתחלה טבלה ריקה, ואז הנתונים החדשים שיובאו מופיעים בהדרגה ככל שהטרנזקציות של האצווה מתבצעות.
לפני שמתחילים
- מגדירים את הדגל לניהול מסד הנתונים
alloydb_sync.enabled=onבמכונה של AlloyDB. מידע נוסף זמין במאמר הגדרת דגלים לניהול מסד נתונים של מכונה. - חשוב להכיר את האופן שבו
bigquery_fdwמטפל בסוגי הנתונים ובמיפוי העמודות ב-BigQuery, כי התוסףalloydb_syncמשתמש ב-bigquery_fdwכדי להתחבר ל-BigQuery. - נכנסים לחשבון Google Cloud . אנחנו ממליצים למשתמשים חדשים ב- Google Cloud ליצור חשבון כדי שיוכלו להעריך את הביצועים של המוצרים שלנו בתרחישים מהעולם האמיתי. לקוחות חדשים מקבלים בחינם גם קרדיט בשווי 300$ להרצה, לבדיקה ולפריסה של עומסי העבודה.
-
In the Google Cloud console, on the project selector page, select or create a Google Cloud project.
Roles required to select or create a project
- Select a project: Selecting a project doesn't require a specific IAM role—you can select any project that you've been granted a role on.
-
Create a project: To create a project, you need the Project Creator role
(
roles/resourcemanager.projectCreator), which contains theresourcemanager.projects.createpermission. Learn how to grant roles.
-
Verify that billing is enabled for your Google Cloud project.
-
In the Google Cloud console, on the project selector page, select or create a Google Cloud project.
Roles required to select or create a project
- Select a project: Selecting a project doesn't require a specific IAM role—you can select any project that you've been granted a role on.
-
Create a project: To create a project, you need the Project Creator role
(
roles/resourcemanager.projectCreator), which contains theresourcemanager.projects.createpermission. Learn how to grant roles.
-
Verify that billing is enabled for your Google Cloud project.
-
מפעילים את ממשקי ה-Cloud API שנדרשים כדי ליצור את AlloyDB ולהתחבר אליו.
-
כדי לאשר את שם הפרויקט שבו רוצים לבצע שינויים, בשלב Confirm project לוחצים על Next.
-
בשלב Enable APIs, לוחצים על Enable כדי להפעיל את ממשקי ה-API הבאים:
- AlloyDB API
- Compute Engine API
- Cloud Resource Manager API
- Service Networking API
- BigQuery Storage API
צריך את Service Networking API אם רוצים להגדיר קישוריות רשת ל-AlloyDB באמצעות רשת VPC שנמצאת באותו פרויקט ב- Google Cloud כמו AlloyDB.
אם אתם מתכננים להגדיר קישוריות רשת ל-AlloyDB באמצעות רשת VPC שנמצאת בפרויקט אחר ב- Google Cloud , אתם צריכים את Compute Engine API ואת Cloud Resource Manager API.
-
- מוודאים שיש לכם טבלה קיימת ב-BigQuery שממנה אפשר לסנכרן נתונים. מידע נוסף זמין במאמר יצירה ושימוש בטבלאות ב-BigQuery.
התפקידים הנדרשים
כדי לתת לאשכול של AlloyDB גישה למערך הנתונים ב-BigQuery, צריך את ההרשאות הבאות:
- צפייה בנתונים ב-BigQuery (
roles/bigquery.dataViewer) או כל תפקיד בהתאמה אישית עם ההרשאותbigquery.tables.getו-bigquery.tables.getData. כשמקצים את התפקיד הזה לחשבון שירות, הוא נותן הרשאות לקרוא נתונים ומטא-נתונים מהטבלה או מהתצוגה. - BigQuery Read Session User
(
roles/bigquery.readSessionUser) או כל תפקיד בהתאמה אישית עם ההרשאותbigquery.readsessions.createו-bigquery.readsessions.getData. מאפשר ליצור סשנים של קריאה ולהשתמש בהם. - שימוש במשימות BigQuery (
roles/bigquery.jobUser) או כל תפקיד בהתאמה אישית עם ההרשאותbigquery.jobs.create. מאפשר ליצור ולהריץ משימות, כולל משימות של שאילתות. כשמציינים פרויקט נפרד של זמן ריצה, המשימה מופעלת בפרויקט הזה במקום בפרויקט הנתונים. כלומר, צריך להקצות את התפקיד "משתמש במשימות" בפרויקט של סביבת זמן הריצה.
הגדרת התוסף
לפני שמסנכרנים טבלאות מ-BigQuery, צריך להפעיל את התוסף הנדרש ולהגדיר את החיבור ל-BigQuery. אם משתמשים במסוף Google Cloud , השלבים האלה מתבצעים באופן אוטומטי ב-AlloyDB.
יוצרים את התוסף.
- מתחברים למכונה של AlloyDB באמצעות לקוח psql, לפי ההוראות במאמר חיבור לקוח psql למכונה.
מריצים את הפקודה הבאה:
CREATE EXTENSION IF NOT EXISTS alloydb_sync;
כדי לאפשר ל-AlloyDB לבצע אימות מול BigQuery, צריך ליצור את השרת החיצוני ואת מיפוי המשתמשים:
CREATE EXTENSION IF NOT EXISTS bigquery_fdw; CREATE SERVER IF NOT EXISTS bigquery_server FOREIGN DATA WRAPPER bigquery_fdw OPTIONS (runtime_project 'RUNTIME_PROJECT_ID'); CREATE USER MAPPING IF NOT EXISTS FOR USER SERVER bigquery_server;מחליפים את מה שכתוב בשדות הבאים:
-
RUNTIME_PROJECT_ID: אופציונלי. מזהה הפרויקט ב-Google Cloud שמעבד את השאילתה וצובר עלויות מחשוב. אם לא מציינים את הפרויקט, השאילתות מחויבות בפרויקט שבו מאוחסנים הנתונים. -
USER: שם משתמש במסד הנתונים או משתמש IAM שיש לו גישה לטבלה ב-BigQuery.
-
סנכרון טבלה ב-BigQuery לייצוא חד-פעמי
אתם יכולים לסנכרן טבלה ב-BigQuery לייצוא חד-פעמי באמצעות מסוףGoogle Cloud או באמצעות psql.
שימוש במסוף Google Cloud
כדי לסנכרן טבלה ב-BigQuery עם AlloyDB באמצעות מסוףGoogle Cloud :
פותחים את הדף BigQuery במסוף Google Cloud .
בחלונית הימנית, לוחצים על Explorer:
אם החלונית הימנית לא מוצגת, לוחצים על הרחבת החלונית הימנית כדי לפתוח אותה.
בחלונית Explorer, מרחיבים את הפרויקט, לוחצים על Datasets ואז על מערך הנתונים.
לוחצים על Overview > Tables ובוחרים טבלה.
בחלונית הפרטים, לוחצים על More > Export or sync to AlloyDB.
בקטע Choose a project, בוחרים את הפרויקט של אשכול AlloyDB. אם יש לכם את ההרשאות הנדרשות, אתם יכולים לבחור פרויקט אחר, ולא את הפרויקט הנוכחי ב-BigQuery.
בקטע Choose a target cluster, בוחרים אחת מהאפשרויות הבאות:
כדי לייצא את הטבלה ב-BigQuery לאשכול קיים ב-AlloyDB, בוחרים באפשרות Use an existing cluster. לאחר מכן, מבצעים את הפעולות הבאות:
בוחרים את אשכול AlloyDB הראשי.
בוחרים את מסד הנתונים של AlloyDB שאליו רוצים להעביר את הנתונים.
בוחרים את הסכימה של טבלת היעד ב-AlloyDB.
מציינים שם לטבלת היעד ב-AlloyDB.
בקטע Sync frequency, בוחרים באפשרות Just once כדי ליצור עותק של הטבלה ב-BigQuery.
לוחצים על הגדרת ייצוא.
בסיום הגדרת הסנכרון, אתם יכולים להשתמש בהצהרות ה-SQL שסופקו כדי לעקוב אחרי משימת הייבוא ולשלוח שאילתות לטבלאות שיובאו. לוחצים על Query כדי לעבור לטבלה שיובאה ב-AlloyDB Studio.
כדי לייצא את הטבלה ב-BigQuery לאשכול חדש ב-AlloyDB, בוחרים באפשרות Create a new cluster. לאחר מכן, מבצעים את הפעולות הבאות:
לוחצים על הגדרת ייצוא.
בתיבת הדו-שיח Redirect to AlloyDB, לוחצים על Redirect.
בוחרים את סוג האשכול: Free trial cluster או Provisioned cluster.
לוחצים על Continue.
בקטע Sync Configuration, בוחרים את מסד הנתונים של
postgresכיעד ברירת המחדל ב-AlloyDB, את הסכימה שלpublicכברירת המחדל לטבלת היעד ב-AlloyDB, ומציינים שם לטבלת היעד ב-AlloyDB.בקטע Sync frequency, בוחרים באפשרות Just once כדי ליצור עותק של הטבלה ב-BigQuery.
לוחצים על Continue.
מגדירים את האשכול. למידע נוסף על כל שדה, ראו יצירת אשכול חדש ומכונה ראשית.
לוחצים על Create cluster.
בסיום הגדרת הסנכרון, עוברים אל AlloyDB Studio כדי לשלוח שאילתות לטבלאות שיובאו.
סנכרון חד-פעמי של טבלה ב-BigQuery באמצעות psql
כדי ליצור עותק של נתוני BigQuery שאפשר לערוך, משתמשים ב-psql כדי להריץ את הפונקציה alloydb_sync.import_bq_table.
SELECT alloydb_sync.import_bq_table(
  'PROJECT_ID.DATASET_ID.TABLE_ID',
  'ALLOYDB_DESTINATION_TABLE_NAME',
  'ON_EXISTS',
  ARRAY['PRIMARY_KEY_COLUMN']
);
מחליפים את מה שכתוב בשדות הבאים:
-
PROJECT_ID: מזהה הפרויקט שבו נמצא מערך הנתונים ב-BigQuery. -
DATASET_ID: השם של מערך הנתונים ב-BigQuery של הטבלה. בטבלאות Iceberg עם שם בן 4 חלקים, זהו ה-Catalog.Namespace. -
TABLE_ID: השם של הטבלה או התצוגה ב-BigQuery. -
ALLOYDB_DESTINATION_TABLE_NAME: השם של הטבלה המקומית במסד הנתונים של AlloyDB שרוצים ליצור ולייבא אליה נתונים. אפשר לכלול את שם הסכימה, למשלpublic.local_sales. -
ON_EXISTS: האסטרטגיה שבה משתמשים אם טבלת היעד כבר קיימת. -
PRIMARY_KEY_COLUMN: רשימה אופציונלית של שמות עמודות שישמשו כמפתח הראשי.
דוגמה
בדוגמה הבאה מוסבר איך לסנכרן טבלה בשם transactions ממערך נתונים ב-BigQuery לטבלה חדשה ב-AlloyDB בשם public.local_sales:
SELECT alloydb_sync.import_bq_table(
    'my-gcp-project.sales_data.transactions',
    'public.local_sales',
    'replace'
);
פרמטר on_exists
הפרמטר on_exists קובע איך הפונקציה מטפלת בסנכרון אם טבלת היעד כבר קיימת ב-AlloyDB:
-
error: אפשרות ברירת המחדל. הסנכרון ייפסק אם טבלת היעד כבר קיימת. -
skip: דילוג על הסנכרון אם טבלת היעד כבר קיימת. -
replace: החלפת הטבלה המקומית הקיימת בנתונים עדכניים מ-BigQuery.
תמיכה במפתח ראשי
אם מספקים את הפרמטר האופציונלי primary_key כמערך טקסט, AlloyDB יוצר את הטבלה עם העמודות שצוינו כמפתח הראשי.
SELECT alloydb_sync.import_bq_table(
    'my-gcp-project.sales_data.transactions',
    'public.local_sales',
    ARRAY['transaction_id']
);
סנכרון טבלה ב-BigQuery לייצוא תקופתי
אפשר לסנכרן טבלה ב-BigQuery לייצוא תקופתי באמצעות מסוףGoogle Cloud או באמצעות psql.
שימוש במסוף Google Cloud
כדי לסנכרן טבלה ב-BigQuery עם AlloyDB באמצעות מסוףGoogle Cloud :
פותחים את הדף BigQuery במסוף Google Cloud .
בחלונית הימנית, לוחצים על Explorer:
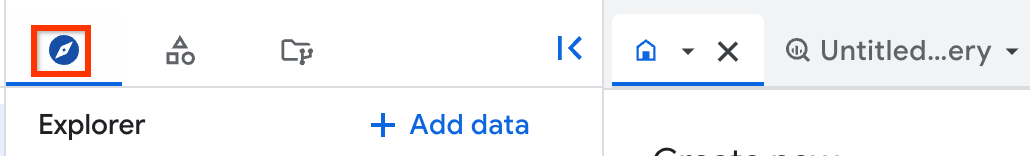
אם החלונית הימנית לא מוצגת, לוחצים על הרחבת החלונית הימנית כדי לפתוח אותה.
בחלונית Explorer, מרחיבים את הפרויקט, לוחצים על Datasets ואז על מערך הנתונים.
לוחצים על Overview > Tables ובוחרים טבלה.
בחלונית הפרטים, לוחצים על More > Export or sync to AlloyDB.
בקטע Choose a project, בוחרים את הפרויקט של אשכול AlloyDB. אם יש לכם את ההרשאות הנדרשות, אתם יכולים לבחור פרויקט אחר, ולא את הפרויקט הנוכחי ב-BigQuery.
בקטע Choose a target cluster, בוחרים אחת מהאפשרויות הבאות:
כדי לייצא את הטבלה ב-BigQuery לאשכול קיים ב-AlloyDB, בוחרים באפשרות Use an existing cluster. לאחר מכן, מבצעים את הפעולות הבאות:
בוחרים את אשכול AlloyDB הראשי.
בוחרים את מסד הנתונים של AlloyDB שאליו רוצים להעביר את הנתונים.
בוחרים את הסכימה של טבלת היעד ב-AlloyDB.
מציינים שם לטבלת היעד ב-AlloyDB.
בקטע Sync frequency, בוחרים מסגרת זמן ליצירת סנכרון תקופתי של הטבלה ב-BigQuery, לדוגמה Every hour או Every six hours.
לוחצים על הגדרת ייצוא.
בסיום הגדרת הסנכרון, אתם יכולים להשתמש בהצהרות ה-SQL שסופקו כדי לעקוב אחרי משימת הייבוא ולשלוח שאילתות לטבלה שיובאה. לוחצים על Query כדי לעבור לטבלה שיובאה ב-AlloyDB Studio.
כדי לייצא את הטבלה ב-BigQuery לאשכול חדש ב-AlloyDB, בוחרים באפשרות Create a new cluster. לאחר מכן, מבצעים את הפעולות הבאות:
לוחצים על הגדרת ייצוא.
בתיבת הדו-שיח Redirect to AlloyDB, לוחצים על Redirect.
בוחרים את סוג האשכול: Free trial cluster או Provisioned cluster.
לוחצים על Continue.
בקטע Sync Configuration, בוחרים את מסד הנתונים של
postgresכיעד ברירת המחדל ב-AlloyDB, את הסכימה שלpublicכברירת המחדל לטבלת היעד ב-AlloyDB, ומציינים שם לטבלת היעד ב-AlloyDB.בקטע Sync frequency, בוחרים באפשרות Just once כדי ליצור עותק של הטבלה ב-BigQuery.
לוחצים על Continue.
מגדירים את האשכול. למידע נוסף על כל שדה, ראו יצירת אשכול חדש ומכונה ראשית.
לוחצים על Create cluster.
בסיום הגדרת הסנכרון, עוברים אל AlloyDB Studio כדי לשלוח שאילתות לטבלאות שיובאו.
יצירת סנכרון תקופתי
כדי לשמור על טבלה לקריאה בלבד שמסונכרנת עם נתוני BigQuery, משתמשים ב-psql כדי להריץ את הפונקציה alloydb_sync.create_bq_sync_table.
SELECT alloydb_sync.create_bq_sync_table(
    'PROJECT_ID.DATASET_ID.TABLE_ID',
    'ALLOYDB_DESTINATION_TABLE_NAME',
    'REFRESH_INTERVAL',
    'ON_EXISTS',
    ARRAY['PRIMARY_KEY_COLUMN']
);
מחליפים את מה שכתוב בשדות הבאים:
-
PROJECT_ID.DATASET_ID.TABLE_ID: השם המלא של הטבלה או התצוגה ב-BigQuery, כולל מזהה הפרויקט, מזהה מערך הנתונים ומזהה הטבלה, מופרדים בנקודות. בטבלאות Iceberg עם שם שמורכב מ-4 חלקים, ה-DATASET_IDמיוצג בתורCatalog.Namespace. לדוגמה,my-gcp-project.sales_data.transactions. -
ALLOYDB_DESTINATION_TABLE_NAME: השם של הטבלה המקומית במסד הנתונים של AlloyDB שרוצים ליצור ולסנכרן אליה נתונים. -
REFRESH_INTERVAL: המרווח שבו AlloyDB מרענן מדי פעם את הנתונים מ-BigQuery, לדוגמה12 hours. -
ON_EXISTS: האסטרטגיה שבה צריך להשתמש אם טבלת היעד כבר קיימת. -
PRIMARY_KEY_COLUMN: רשימה אופציונלית של שמות עמודות שישמשו כמפתח הראשי.
דוגמה
בדוגמה הבאה מוסבר איך ליצור מראה של פרופיל לקוח שמתרעננת כל 12 שעות:
SELECT alloydb_sync.create_bq_sync_table(
    'my-gcp-project.crm_data.profiles',
    'public.customer_mirror',
    '12 hours',
    'replace'
);
מעקב וניהול של משימות
אחרי שמתחילים סנכרון, אפשר לעקוב אחרי ההתקדמות שלו ולנהל את המשימות.
בדיקת סטטוס המשימה
סנכרון של הרבה נתונים יכול לקחת זמן. כדי לעקוב אחרי ההתקדמות, כולל הרשומות שעובדו וזמן הסיום המשוער, אפשר לשלוח שאילתה לתצוגה job_status:
SELECT
    import_id,
    status,
    records_processed,
    total_records,
    error_message
FROM alloydb_sync.job_status;
לדוגמה, כדי לבטל את המשימה, מריצים את הפקודה הבאה:
SELECT alloydb_sync.cancel_import_job('85bb5dfa-dfb9-4017-9153-738f55abe4b1');
איך עוצרים ומוחקים משימת סנכרון
כדי להפסיק את הסנכרון של טבלה ב-BigQuery ולמחוק את הטבלה המקומית, משתמשים בפונקציה alloydb_sync.delete_bq_sync_table:
SELECT alloydb_sync.delete_bq_sync_table('public.customer_mirror');
מיפוי סוגי נתונים
כשמסנכרנים או מייבאים נתונים מ-BigQuery ל-AlloyDB באמצעות התוסף alloydb_sync, המערכת של AlloyDB ממפה את סוגי הנתונים של BigQuery לסוגי הנתונים התואמים של PostgreSQL בטבלת היעד.
מוודאים שהעמודות בטבלה ב-BigQuery משתמשות בסוגי הנתונים הנתמכים שמפורטים בטבלה הבאה:
| סוגי נתונים בטבלה ב-BigQuery | סוגי נתונים של PostgreSQL |
|---|---|
BOOLEAN |
BOOLEAN |
INTEGER (INT64) |
BIGINT |
FLOAT (FLOAT64) |
DOUBLE PRECISION |
STRING |
TEXT |
NUMERIC |
NUMERIC |
BIGNUMERIC |
NUMERIC |
DATE |
DATE |
TIMESTAMP |
TIMESTAMPTZ |
TIME |
TIME |
DATETIME |
TIMESTAMP |
JSON |
JSONB |
BYTES |
BYTEA |
מגבלות
המגבלות הבאות חלות כשמסנכרנים טבלאות מ-BigQuery:
- התכונה הזו נתמכת רק ב-PostgreSQL בגרסה 18.
- כדי להשתמש בתכונה הזו, צריך להגדיר את הדגל לניהול מסד הנתונים
alloydb_sync.enabled=onבמכונה. - כשמגדירים את השרת החיצוני
bigquery_fdwואת מיפוי המשתמשים במסד נתונים, צריך לתת לשרת החיצוני את השםbigquery_server. - אי אפשר לסנכרן סוגי נתונים מורכבים של BigQuery, כמו
ARRAY,STRUCT,VECTOR,GEOGRAPHY,RANGEו-INTERVAL. סוגי נתונים עם פרמטרים ב-BigQuery, כמוSTRING(L),BYTES(L),NUMERIC(P, S)ו-BIGNUMERIC(P, S), ממופים ל-TEXT. למידע נוסף, קראו על סוגי הנתונים הנתמכים ב-BigQuery ומיפוי עמודות. - כשמציינים את הפרמטר
primary_key, הרשימה המופרדת בפסיקים של שמות העמודות של המפתח הראשי לא יכולה לחרוג מ-1,023 בייטים. בנוסף, השמות והערכים של עמודות המפתח הראשי שעברו סריאליזציה ל-JSON בשורה לא יכולים לחרוג מ-255 בייטים. - בטבלאות סנכרון תקופתי שנוצרו באמצעות הפונקציה
alloydb_sync.create_bq_sync_table, הפרמטרrefresh_intervalלא תומך בחודשים או בשנים. מציינים את המרווח כמספר שלם של ימים, שעות (פחות מ-24), דקות (פחות מ-60) או שניות (פחות מ-60). מרווחים עם יחידות מעורבות, כמו1 hour 30 minutesאו90 minutes, נחתכים למספר השלם של יחידת הזמן הגדולה ביותר, כמו1 hour. רק משתמש מסד הנתונים שהפעיל משימת סנכרון או יצר טבלת סנכרון תקופתי יכול לבצע את הפעולות הבאות:
- צפייה במשימה בתצוגה
alloydb_sync.job_status - ביטול המשימה באמצעות הפונקציה
alloydb_sync.cancel_import_job - מחיקת טבלת הסנכרון באמצעות הפונקציה
alloydb_sync.delete_bq_sync_table
- צפייה במשימה בתצוגה
משימות סנכרון שומרות נתונים באופן מצטבר בקבוצות, ולא בטרנזקציה אחת. במהלך פעולת
replace, טבלת היעד נמחקת ונוצרת מחדש לפני טעינת הנתונים, כך ששאילתות בו-זמניות רואות טבלה ריקה או מאוכלסת חלקית עד לסיום המשימה. אם משימת ייבוא נכשלת או מבוטלת לפני שהיא מסתיימת, שורות שיובאו באופן חלקי והגדרה פנימית של טבלה חיצונית נשארות במסד הנתונים. כדי לשחזר, מריצים מחדש את הייבוא כשהפרמטרon_existsמוגדר ל-replace.אם מתרחשת הפרעה במהלך הייבוא הראשוני ברקע של טבלת סנכרון תקופתי שנרשמה לאחרונה, הטבלה נשארת לא שלמה עד למרווח הרענון המתוזמן הבא שלה.
פקודות
DROP DATABASEרגילות נכשלות כש-worker של מעקב אחרי משימות ברקע מחובר למסד נתונים שיש בו טבלאות סנכרון תקופתיות או פעילות סנכרון ב-10 השניות האחרונות.במסדי נתונים שאין בהם טבלאות סנכרון תקופתיות שמוגדרות באמצעות הפונקציה
alloydb_sync.create_bq_sync_table, ה-worker של מעקב המשימות ברקע נסגר אחרי 10 שניות של חוסר פעילות. ה-worker מקצה קטע חדש של זיכרון דינמי משותף בבקשה הבאה להפעלת פונקציהalloydb_sync.import_bq_tableאו כשהתוסףalloydb_syncנמחק ונוצר מחדש. אם מריצים מספר גדול של ייבואים חד-פעמיים מבודדים שמופרדים על ידי תקופות של חוסר פעילות, בלי טבלת סנכרון תקופתית פעילה, יכול להיות שמשבצות הזיכרון המשותף יתמלאו ויהיה צורך להפעיל מחדש את המכונה.
שיטות מומלצות
כדאי לפעול לפי השיטות המומלצות הבאות כשמגדירים ומנהלים סנכרוני טבלאות מ-BigQuery:
- מריצים את ההצהרה
CREATE EXTENSION IF NOT EXISTS alloydb_sync CASCADE;בטרנזקציה ייעודית לפני שקוראים לפונקציות סנכרון. - אל תשנו את טבלת המקור ב-BigQuery במהלך הייבוא. אם טבלת המקור מתעדכנת בו-זמנית, יכול להיות שמשימת הסנכרון תייבא את הנתונים המעודכנים.
- כשקוראים לפונקציות
alloydb_sync.import_bq_table,alloydb_sync.create_bq_sync_tableאוalloydb_sync.delete_bq_sync_table, צריך לציין שם עקבי של טבלת יעד שמתאים לסכימה, כמוpublic.my_table. אל תפעילו כמה משימות סנכרון לאותה טבלת יעד בו-זמנית. אם אתם מסנכרנים טבלאות בכמה מסדי נתונים באותו אשכול, השתמשו בשמות שונים לסכימות או לטבלאות במסדי הנתונים. - כשיוצרים טבלת סנכרון תקופתי באמצעות הפונקציה
alloydb_sync.create_bq_sync_table, מגדירים את הפרמטרon_existsלערךreplaceכדי שרענונים מתוזמנים יעדכנו את טבלת היעד. צריך לציין את הפרמטרrefresh_intervalכיחידה שלמה אחת של ימים, שעות (פחות מ-24), דקות (פחות מ-60) או שניות (פחות מ-60). - כשמייבאים טבלאות גדולות מאוד מ-BigQuery, צריך להגדיל את הערך של הדגל לניהול מסד הנתונים
temp_file_limit, ואם רוצים גם את הערך של הדגלwork_mem, במכונה, כדי שהייבוא לא יחרוג מהמגבלה של גודל הקובץ הזמני. במהלך הייבוא, השורות הנכנסות נשמרות במאגר נתונים זמני בזיכרון עד למגבלה שלwork_mem, ואז נשמרות בקבצים זמניים מקומיים של PostgreSQL לפני השלמת השמירות באצווה. - אל תריצו ידנית את ההצהרה
DROP TABLEבטבלת סנכרון משוכפלת או בטבלה עם ייבוא פעיל. כדי לעצור ייבוא שמתבצע, קודם צריך להריץ את הפונקציהalloydb_sync.cancel_import_jobבתור המשתמש במסד הנתונים שהתחיל את המשימה. כדי להסיר טבלת סנכרון תקופתי ואת לוח הזמנים שלה, משתמשים בפונקציהalloydb_sync.delete_bq_sync_tableומעבירים את השם המדויק של טבלת היעד שבה השתמשתם כשיצרתם את טבלת הסנכרון. - אם ייבוא חד-פעמי נכשל או בוטל לפני שהסתיים, מריצים מחדש את הפונקציה
alloydb_sync.import_bq_tableכשהפרמטרon_existsמוגדר לערךreplace. אם הייבוא הראשוני ברקע של טבלת סנכרון תקופתי שנרשמה לאחרונה נקטע, ואתם רוצים לפתור את הבעיה מיד במקום לחכות לרענון המתוזמן הבא, אתם יכולים למחוק את טבלת הסנכרון באמצעות הפונקציהalloydb_sync.delete_bq_sync_tableוליצור אותה מחדש. אם המשבצות של ה-worker ברקע ב-
max_worker_processesנגמרות כשמשימה מתחילה, או אם מסד הנתונים קורס בזמן שהייבוא בתור או פועל, המטא-נתונים של המשימה עשויים להישאר תקועים במצבQUEUEDאוRUNNINGולחסום ייבוא עתידי לאותה טבלה. כדי לבטל את החסימה של הטבלה, מעדכנים את סטטוס המשימה בתור המשתמש במסד הנתונים שהתחיל את המשימה, באמצעות הפקודה הבאה:UPDATE alloydb_sync.import_job_status SET status = 'FAILED' WHERE status IN ('QUEUED', 'RUNNING');כדי למחוק מסד נתונים שיש בו טבלאות סנכרון תקופתיות או פעילות סנכרון מהזמן האחרון, מריצים את
DROP DATABASE DATABASE_NAME WITH (FORCE)או קודם מוחקים את כל טבלאות הסנכרון וממתינים לפחות 10 שניות עד שה-worker של מעקב הרקע ייסגר. כדי לבדוק אם ה-worker עדיין מחובר למסד הנתונים, אפשר לשלוח שאילתה לתצוגהpg_stat_activity:SELECT pid, datname, backend_type FROM pg_stat_activity WHERE datname = 'DATABASE_NAME' AND backend_type = 'job_tracker';מחליפים את
DATABASE_NAMEבשם של מסד הנתונים.
תמחור
כשאתם מסנכרנים נתונים מ-BigQuery ל-AlloyDB, אתם מחויבים לפי התמחור של קריאות בסטרימינג ב-BigQuery (Storage Read API).
אחרי שהנתונים מיוצאים, אתם מחויבים על אחסון הנתונים ב-AlloyDB. למידע נוסף, קראו את המאמר תמחור של AlloyDB ל-PostgreSQL.
המאמרים הבאים
- מידע נוסף על ייצוא נתונים ל-AlloyDB (תהליך ETL הפוך)
- מידע נוסף על שליחת שאילתות לנתוני BigQuery במקום באמצעות FDW