


ב-AI Hypercomputer נעשה שימוש בשירותי רשת ספציפיים, שנקבעים לפי סוג המכונה של ה-GPU שבחרתם. הבנת השירותים האלה מאפשרת לכם לבצע אופטימיזציה של הביצועים ושל ה-goodput: ההתקדמות בפועל של משימת אימון של למידת מכונה.
רשתות לפי תשתית
ארכיטקטורת הרשת לפריסה תלויה בתשתית שבחרתם: מעבדי GPU כלליים או אשכולות של מעבדי GPU.
רשת VPC רגילה למעבדי GPU כלליים
מעבדי GPU כלליים משתמשים ברשת VPC רגילה של Google Cloud.
- ארכיטקטורה: מבוססת על עיצוב VPC סטנדרטי עם כמה דיירים, לצורך הסקת מסקנות, פרסום המודל ומחקר.
- פרוטוקולים: שימוש ב-TCP/IP דרך Google Virtual NIC (gVNIC).
מארגי תקשורת עם ביצועים גבוהים לאשכולות GPU
בעזרת AI Hypercomputer אתם יכולים לפרוס מכונות GPU שמשתמשות בארכיטקטורת רשת היררכית בארכיטקטורת rail-aligned. הקישוריות הצפויה והביצועים הגבוהים של העיצוב הזה ממזערים את התקורה של התקשורת, מה שמשפר באופן ישיר את התפוקה בכך שהוא מאפשר למעבדי ה-GPU להשקיע יותר זמן בחישוב במקום להמתין לנתונים.
הסידור בארכיטקטורת rail-aligned של אשכולות GPU כולל שלושה רכיבים:
- בלוקי משנה: קבוצה של מארחים שנמצאים פיזית באותו מיקום בבלוק אחד. מתג top-of-rack (ToR) מחבר את המארחים האלה, ומאפשר תקשורת יעילה במיוחד של דילוג יחיד בין כל שני מעבדי GPU בתוך בלוק המשנה. RDMA over Converged Ethernet (RoCE) מאפשר את התקשורת הישירה הזו. ספריית NCCL משופרת, שמותאמת לטופולוגיה בארכיטקטורת rail-aligned של Google, מטפלת בקולקטיבים של תקשורת בין יחידות GPU.
- בלוקים: אוסף של תת-בלוקים שמחוברים ביניהם באמצעות רשת מהירה ללא חסימות, שמספקת רוחב פס גבוה. אפשר להגיע לכל GPU בבלוק בשני דילוגים ברשת לכל היותר. המערכת חושפת את המטא-נתונים של הבלוקים ושל תת-הבלוקים כדי לאפשר מיקום אופטימלי של המשימות.
- אשכולות: אוסף של בלוקים מקושרים שיכולים להתרחב לאלפי מעבדי GPU, וכך להריץ עומסי עבודה גדולים של אימון. התקשורת בין בלוקים שונים מוסיפה רק עוד דילוג אחד, וכך נשמרים הביצועים הגבוהים והיכולת לחזות את הביצועים, גם בקנה מידה עצום. כדי לאפשר הקצאת משימות חכמה בקנה מידה גדול, המטא-נתונים ברמת האשכול זמינים גם למתזמרים.
טכנולוגיות לתקשורת בין יחידות GPU
במכונות GPU נעשה שימוש בשילוב של טכנולוגיות כדי לספק ביצועים גבוהים, תפוקה גבוהה וזמן אחזור קצר לעומסי עבודה. הטכנולוגיות האלה כוללות את RDMA over Converged Ethernet (RoCE), כרטיסי רשת של NVIDIA וטופולוגיית רשת בארכיטקטורת rail-aligned בכל מרכז הנתונים של Google.
טכנולוגיית NVLink של NVIDIA יוצרת נתיבי נתונים ישירים במהירות גבוהה במיוחד בין כרטיסי ה-NIC של NVIDIA בכל מכונה. בנוסף, RoCE מאפשר RDMA יעיל בין יחידות GPU במכונות שונות.
מקבצי רשת (network stack) של GPU
מקבץ רשת (network stack) הוא אוסף של פרוטוקולי תוכנה, מנהלי התקנים ושכבות שפועלים יחד כדי להטמיע תקשורת בין מעבדי GPU. בסוגי מכונות שונים של GPU נעשה שימוש במקבצי רשת שונים. בטבלה הבאה מפורטים מקבצי הרשת וסוגי המכונות שמשויכים אליהם:
| מקבץ רשת (network stack) | תיאור | סוג מכונת GPU |
|---|---|---|
| GPUDirect RDMA | מאפשר נתיב ישיר להעברת נתונים בין GPU למכשיר אחר. במכונות A5X, A4X Max ו-A4X, מקבץ הרשת הזה משתמש ב-RoCE. מידע נוסף זמין במאמר אפשרויות הגדרה של אשכולות עם GPUDirect RDMA. | |
| GPUDirect-TCPXO | משפר את GPUDirect-TCPX על ידי העברת פרוטוקול ה-TCP. באמצעות GPUDirect-TCPXO, סוג המכונה A3 Mega מכפיל את רוחב הפס של הרשת בהשוואה ל-A3 High. למידע על הגדלת רוחב הפס של הרשת באשכולות GKE שמשתמשים ב-GPUDirect-TCPXO, קראו את המאמר הגדלת רוחב הפס של הרשת של ה-GPU באשכולות במצב רגיל ובחרו בכרטיסייה GPUDirect-TCPXO. | |
| GPUDirect-TCPX | משפר את ביצועי הרשת על ידי העברה של מטעני חבילות נתונים ישירות מזיכרון ה-GPU לממשק הרשת. למידע על הגדלת רוחב הפס של הרשת באשכולות GKE שמשתמשים ב-GPUDirect-TCPX, קראו את המאמר הגדלת רוחב הפס של רשת ה-GPU באשכולות במצב רגיל ובחרו בכרטיסייה GPUDirect-TCPX. |
|
| TCP/IP רגיל | פרוטוקול הרשת הבסיסי לעומסי עבודה כלליים (רגילים). הוא מספק אמינות גבוהה ותאימות רחבה לשירותי VPC סטנדרטיים. |
|
רשת מישור הנתונים של המארח והאחסון
במכונות עם כמה מעבדי GPU, צריך להגדיר את הרשת בצורה שונה לתקשורת עם המכונה לעומת עיבוד מידע בין מעבדי GPU.
נתיב רשת נפרד (שנקרא לפעמים גם רשת צפון-דרום או רשת קצה קדמי) מטפל בכל התקשורת עם המכונה. התעבורה הזו כוללת גישה לדיסק, תקשורת בתוך המכונה הווירטואלית, גישה לאינטרנט, גישה ל-Cloud Storage, ניהול ברמת המארח ותקשורת עם שירותי Google Cloudאחרים.
כדי לנהל את התעבורה הזו, סוגי המכונות עם GPU משתמשים ב-Google Virtual NIC (gVNIC) או, במכונות פיזיות מסוג A5X ו-A4X Max, בממשק הרשת Intel Infrastructure Data Path Function (IDPF) דרך Google Titanium NIC. כרטיסי Titanium NIC מעבירים את משימות עיבוד הרשת מהמעבד (CPU), וכך המעבד יכול להתמקד בעומסי העבודה שלכם. ההפרדה הזו עוזרת להבטיח שתעבורת הנתונים של המארח למטרות כלליות ותעבורת הנתונים הייעודית בין GPU ל-GPU משתמשות בממשקים פיזיים שונים, וכך הן לא מתחרות על אותם משאבי מערכת.
סביבה עם כמה רשתות VPC
כל עומסי העבודה פועלים בתוך הענן הווירטואלי הפרטי (VPC) של Google Cloud.
מכונות עם מאיצים בעלי ביצועים גבוהים כוללות עיצוב חומרה מיוחד שמשתמש בכמה ממשקי רשת פיזיים כדי לטפל בסוגים שונים של תנועה. כדי לטפל בתכנון החומרה המיוחד הזה, נדרשת סביבה עם כמה רשתות VPC, גם אם אתם משתמשים ב-Slurm, ב-GKE או ב-Compute Engine כדי להריץ את עומסי העבודה.
ההגדרה הספציפית של כמה רשתות VPC תלויה בסוג המכונה של ה-GPU ובמקבץ הרשת (network stack) שלה:
A5X, A4X Max, A4X, A4 ו-A3 Ultra עם GPUDirect RDMA: המכונות האלה מגובות בשני סוגים של כרטיסי רשת פיזיים: אחד שתומך בתעבורת נתונים למטרות כלליות ואחד שתומך בתעבורת נתונים של RDMA. ממשקי רשת שממופים ל-NIC הפיזי למטרות כלליות (הממשק
nic0וממשק רשת נוסף) מחוברים לרשתות VPC רגילות. ממשקי רשת RDMA שממופים ל-NIC הפיזי שתומך ב-RDMA מחוברים לרשת VPC נפרדת עם פרופיל רשת RDMA, כדי להשתמש ב-GPUDirect RDMA. בסך הכל, סוגי המכונות האלה משתמשים בעד שלוש רשתות VPC. בפריסות של A5X, A4X Max ו-A4X בתוך בלוק משנה יחיד, מארג ה-NVLink עם כמה צמתים מטפל בתקשורת בין יחידות ה-GPU, ולכן רשת ה-VPC של ה-RDMA היא אופציונלית. במאמר יצירת רשתות VPC ורשתות משנה מוסבר איך להגדיר את תשתית הרשת הזו.A3 Mega עם GPUDirect-TCPXO: המכונות האלה דורשות שמונה רשתות VPC נפרדות לכרטיסי ה-NIC של ה-GPU, שמיועדים לתקשורת ברוחב פס גבוה. במאמר יצירת רשתות VPC ורשתות משנה מוסבר איך להשלים את ההגדרה הזו.
A3 High עם GPUDirect-TCPX: המכונות האלה דורשות ארבעה VPC נפרדים לכרטיסי הרשת של ה-GPU, שמיועדים לתקשורת ברוחב פס גבוה. במאמר יצירת רשתות VPC ורשתות משנה מוסבר איך להשלים את ההגדרה הזו.
ההגדרה הזו של כמה רשתות VPC עוזרת לוודא שפעולות האחסון ומשימות מערכת אחרות לא מתחרות על רוחב הפס עם תקשורת קריטית בין יחידות GPU.
ההגדרה הנדרשת של רשתות VPC מרובות משתנה בהתאם לסוג מכונת ה-GPU. במאמר מכונות GPU ורשתות מוסבר בפירוט איך להגדיר את הרשת, מהירויות רוחב הפס וכרטיסי הרשת (NIC) לכל סוגי המכונות עם GPU שנתמכים.
בתרשים הבא מוצגת ארכיטקטורת הרשת של מכונה עם אשכול GPU, ומודגשת ההפרדה של תעבורת נתונים למטרות כלליות ותעבורת נתונים ייעודית בין יחידות GPU למישורי רשת שונים.
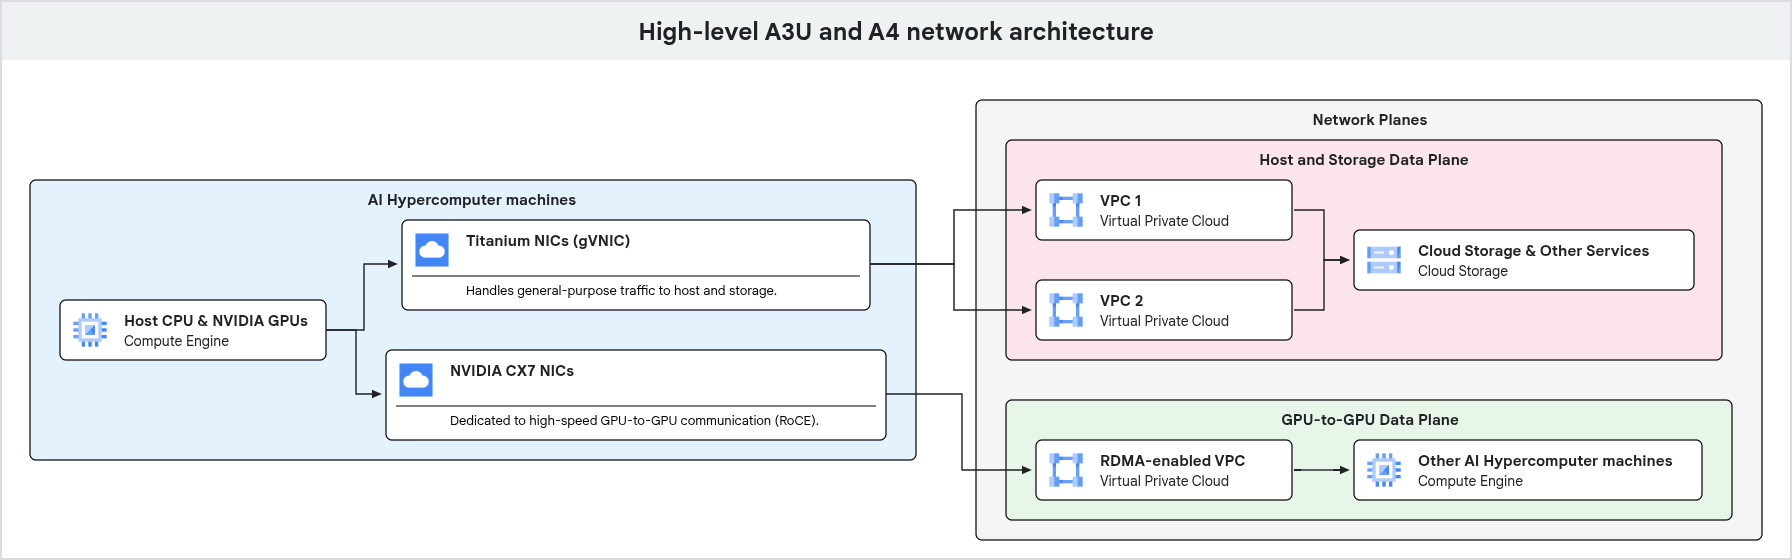 כמו שמוצג בתרשים שלמעלה, מכונות ה-GPU האלה משתמשות בנתיבי רשת ייעודיים לסוגים שונים של תעבורת נתונים. תנועה למטרות כלליות, כולל גישה לניהול ולאחסון, זורמת דרך כרטיסי רשת (NIC) של Google Titanium שמחוברים ל-VPC. תקשורת GPU-to-GPU עם ביצועים גבוהים משתמשת בממשקי רשת וב-VPC נפרדים, שעברו אופטימיזציה באמצעות טכנולוגיות כמו RDMA, כדי להבטיח רוחב פס גבוה וזמן אחזור נמוך לעומסי עבודה של AI ו-ML.
ספריות ורכיבים של רשתות
כדי למקסם את רוחב הפס והביצועים של הרשת, אתם יכולים להשתמש בספריות וברכיבים הבאים של הרשת כדי להשתמש ב-GPU עם מקבץ הרשת (network stack) של Google:
- gVNIC: ממשק הרשת הווירטואלית של Google (gVNIC) הוא ממשק רשת וירטואלית שתוכנן במיוחד בשביל Compute Engine. ממשק gVNIC משפר את הביצועים, מגביר את העקביות ועוזר לצמצם בעיות של שכנים רועשים. מומלץ להשתמש ב-gVNIC בכל משפחות המכונות, וזהו ה-vNIC המומלץ לתקשורת בין מארחים. מידע נוסף מופיע במאמר שימוש ב-Google Virtual NIC.
- NCCL: ספריית NVIDIA Collective Communications Library (NCCL) מספקת פרימיטיבים שעברו אופטימיזציה לפעולות תקשורת קולקטיביות. NCCL תוכננה במיוחד לסביבות עם כמה מעבדי GPU וכמה צמתים, שמשתמשות במעבדי GPU וברשתות של NVIDIA. מריצים בדיקות NCCL כדי להעריך את הביצועים של האשכולות שנפרסו. מידע נוסף זמין במאמר בנושא בדיקת ביצועי הרשת.
- רשתות מרובות ב-GKE: תמיכה ברשתות מרובות ל-Pods מאפשרת ממשקים מרובים בצמתים וב-Pods באשכול GKE. לפרטים על הגדרת ריבוי רשתות בהקשר של GPUDirect, קראו את המאמרים הגדלת רוחב הפס של רשת ה-GPU באשכולות במצב רגיל ואפשרויות להגדרת אשכולות באמצעות GPUDirect RDMA.
לפרטים נוספים על מחסניות התוכנה הזמינות, ראו קובצי אימג' של מערכת ההפעלה ו-Docker.
המאמרים הבאים
- במאמר שיטות מומלצות לשימוש בחשבונות שירות מוסבר איך לאבטח את הפריסות.
- במאמר כללי חומת אש של VPC מוסבר איך להקשיח את הרשת.
- למידע נוסף על קישוריות של מאיצים, קראו את הסקירה הכללית על רשתות GPU.