

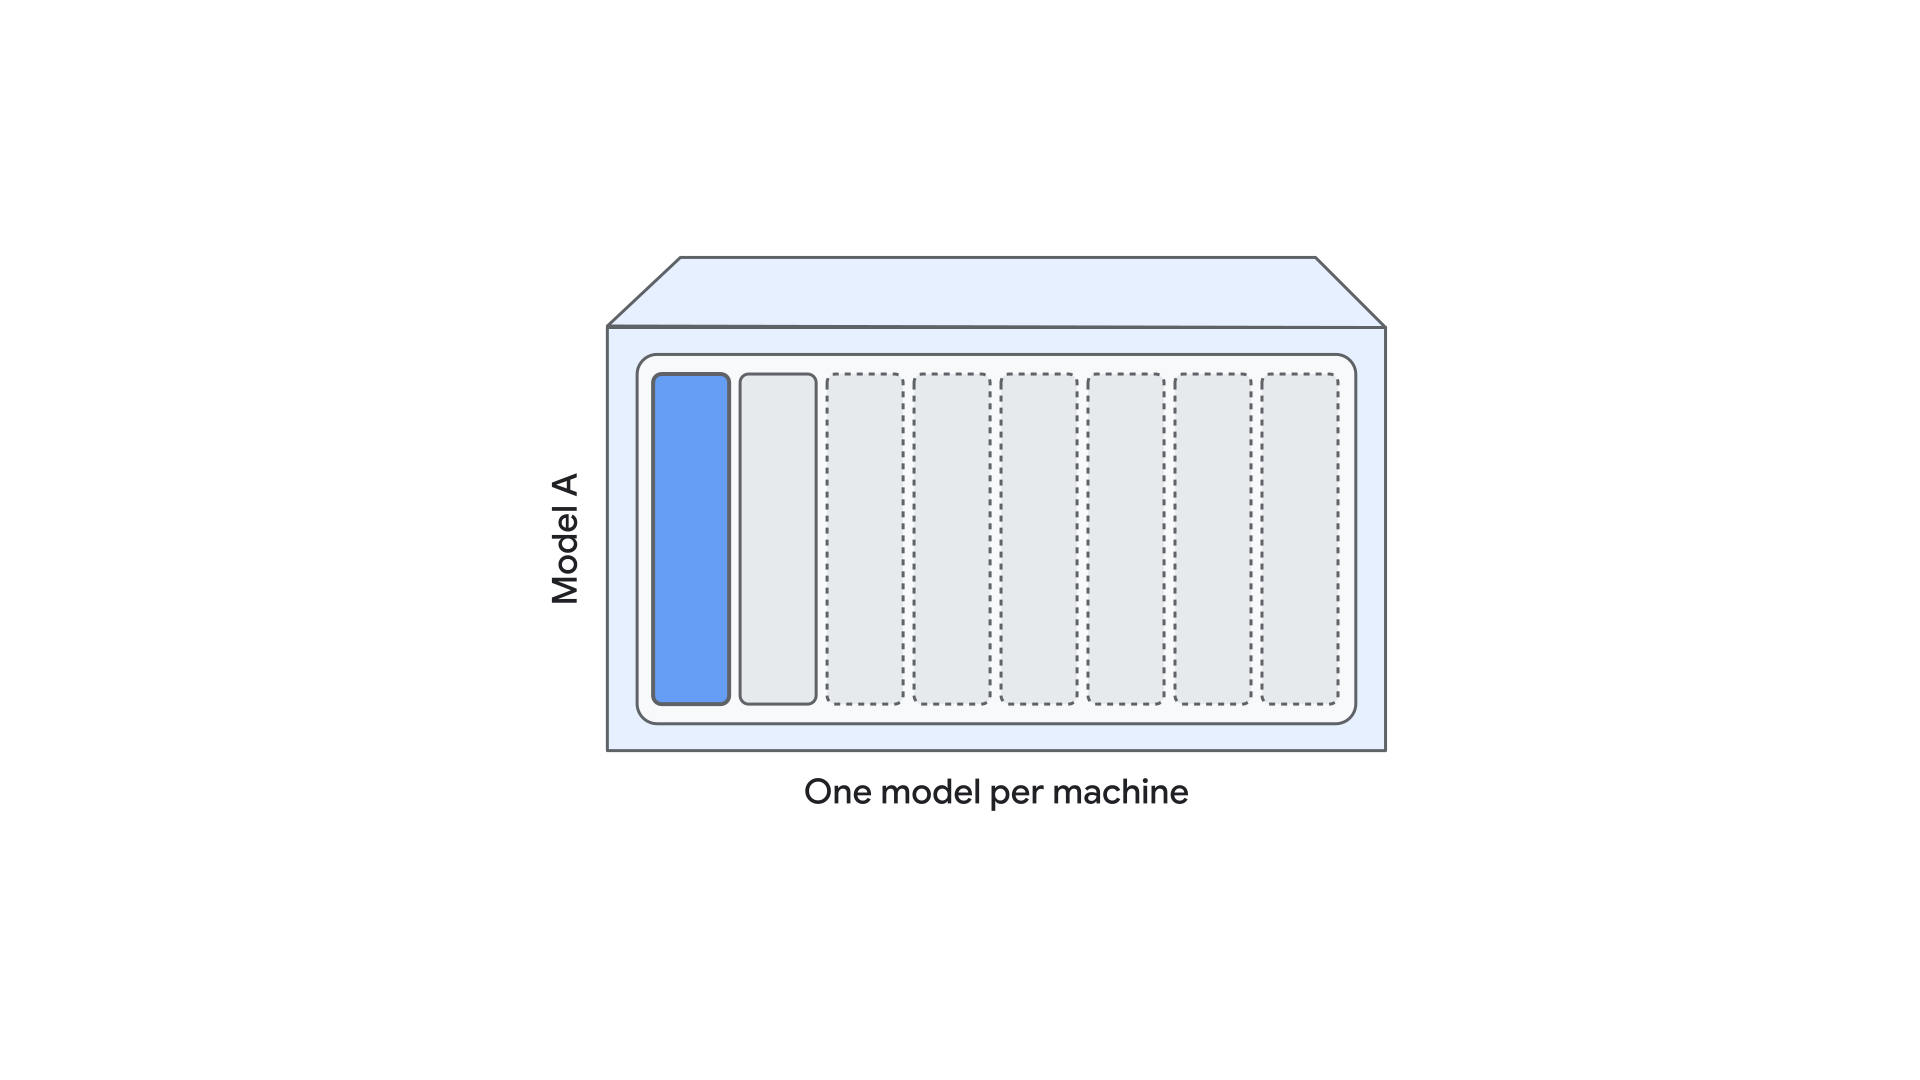
Nel panorama in evoluzione dei modelli linguistici di grandi dimensioni (LLM), il pattern di deployment "un modello per macchina" sta diventando un collo di bottiglia significativo per l'efficienza dei costi di pubblicazione degli LLM nelle aziende. Gli LLM spesso richiedono prenotazioni hardware sostanziali, come nodi GPU 8x H100 completi, per gestire i picchi di carico. Tuttavia, durante le operazioni standard, queste risorse costose spesso rimangono sottoutilizzate, il che comporta un costo totale di proprietà (TCO) elevato.
Fai clic per ingrandire l'immagine
Il co-hosting dei modelli colma questo divario di efficienza consentendo a più istanze di modelli di condividere le stesse risorse di macchine virtuali e GPU. Sono inclusi modelli completamente diversi, come Llama 3.3 e Gemma 3. Utilizzando lo slicing della memoria sub-GPU e il partizionamento intelligente delle risorse, Vertex AI Model Garden trasforma le prenotazioni hardware statiche in pool di computing flessibili e ad alta densità.

Fai clic per ingrandire l'immagine
Questo blog tecnico descrive in dettaglio il processo di Vertex AI Engineering per portare il co-hosting dei modelli in un servizio cloud pronto per la produzione. Condivideremo la nostra metodologia per le strategie di implementazione a livello di container, l'identificazione delle configurazioni di pubblicazione ottimali e i risultati chiave del nostro ampio studio di benchmark multi-modello, consentendoti di massimizzare l'efficienza dei costi di pubblicazione degli LLM.
Informazioni sul co-hosting dei modelli: concetto e architettura
La co-hosting dei modelli è una strategia di distribuzione ad alta densità che consente a più istanze di modelli linguistici di grandi dimensioni (LLM) o a diverse architetture di modelli di condividere le stesse risorse hardware fisiche all'interno di una singola macchina virtuale (VM). A differenza dei modelli di deployment tradizionali che dedicano una VM o una GPU completa a un singolo modello, il co-hosting utilizza il partizionamento granulare delle risorse per massimizzare il ROI dell'hardware e migliorare l'utilizzo della memoria e delle risorse di calcolo.
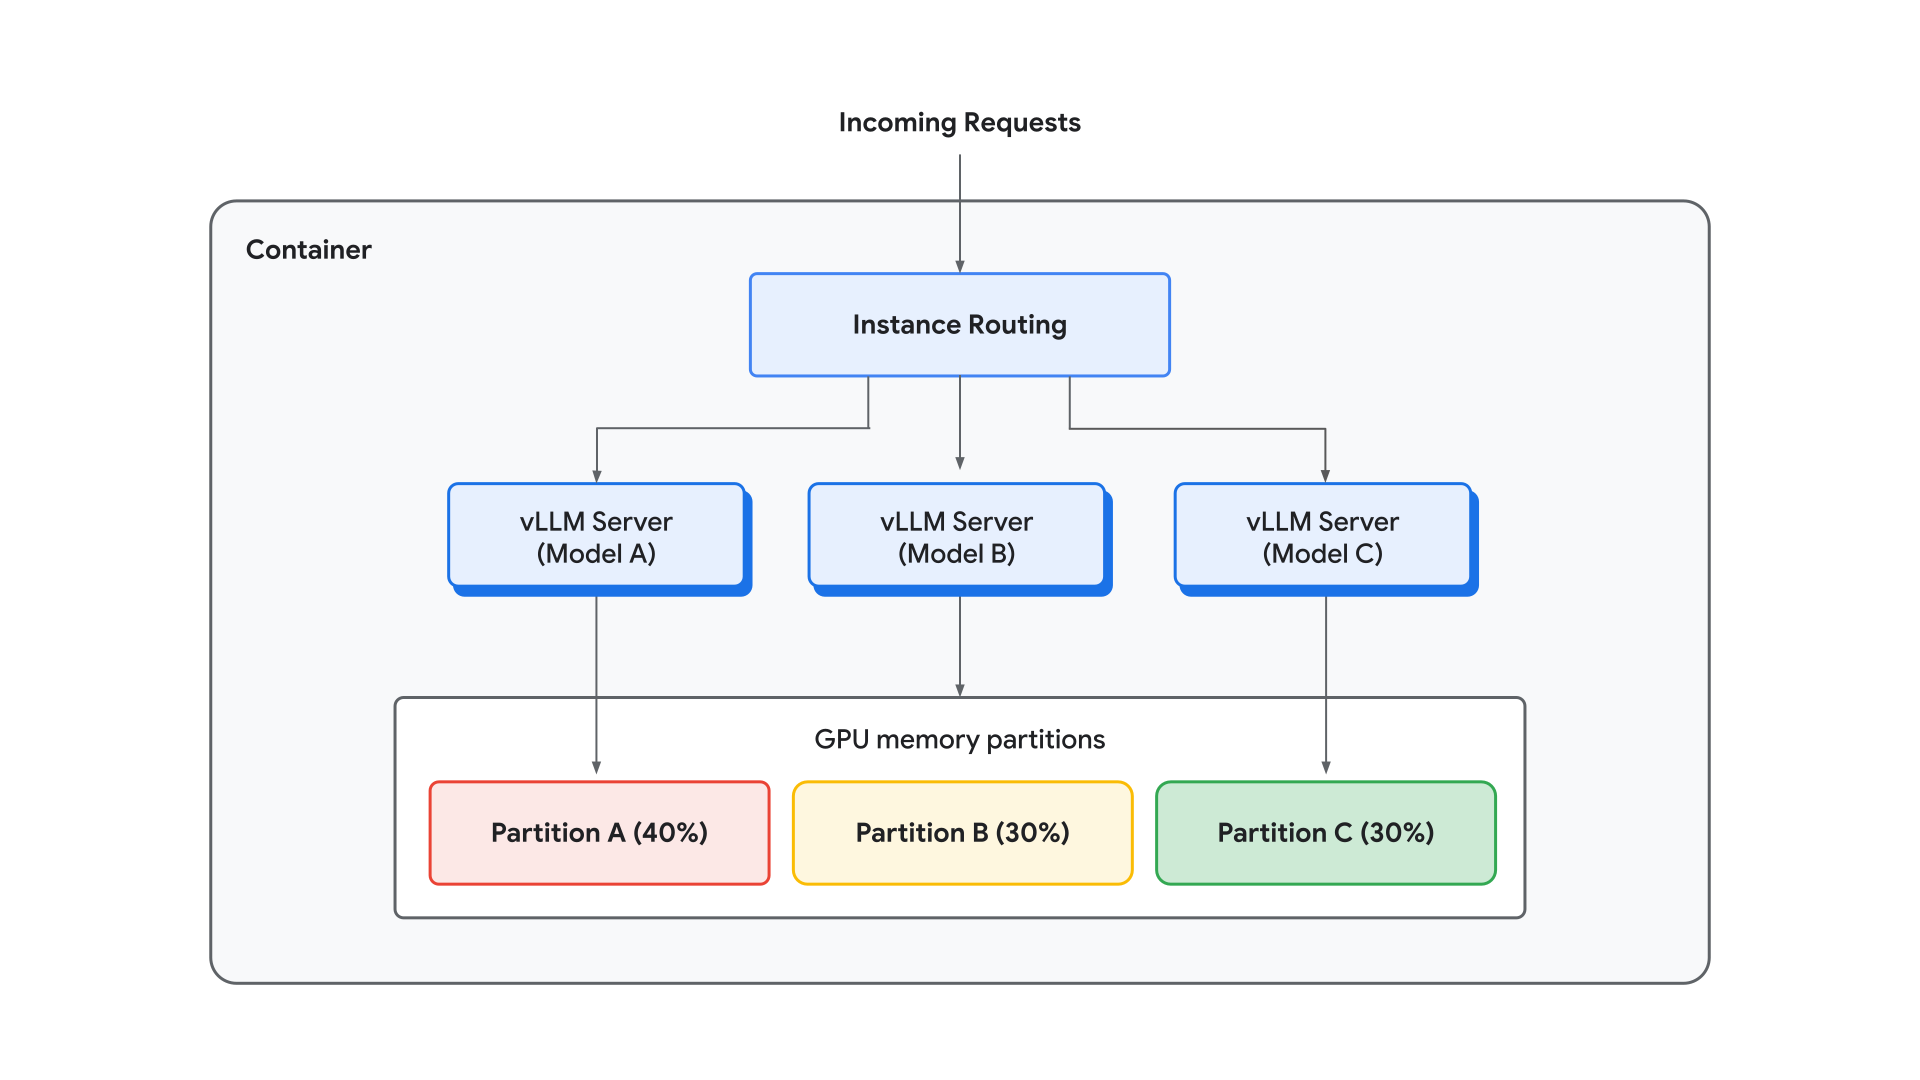
La nostra implementazione si concentra su una soluzione a livello di container che consente la gestione simultanea di più modelli con configurazioni indipendenti. Questa architettura opera attraverso diversi meccanismi tecnici integrati, a partire dal deployment di più istanze di server di modelli indipendenti all'interno di un singolo container. Ognuna di queste istanze funge da copia completa e indipendente del server di modelli, il che consente l'elaborazione simultanea delle richieste nella macchina virtuale. Per gestire questo traffico, abbiamo implementato un livello di routing delle istanze all'interno del container che distribuisce in modo efficiente le richieste in arrivo tra le istanze attive.
Questo design fornisce un parallelismo granulare consentendo a ogni modello in co-hosting di utilizzare una configurazione di distribuzione dedicata, con impostazioni uniche per il parallelismo dei tensori (TP), il parallelismo della pipeline (PP) e il numero specifico di istanze del modello. Questo è integrato dal sezionamento delle risorse, in cui a ogni modello vengono assegnate partizioni di memoria GPU specifiche, ad esempio una partizione di memoria GPU di 0,4 per modello, per garantire che workload diversi coesistano sullo stesso acceleratore senza privarsi l'un l'altro di risorse di memoria critiche. Questo approccio architetturale trasforma una prenotazione hardware statica, come un nodo GPU 8x H100 completo, in un pool di computing flessibile in grado di gestire un portafoglio diversificato, che va da modelli di ragionamento di grandi dimensioni a modelli di chat di piccole dimensioni a bassa latenza.
Fai clic per ingrandire l'immagine
Studio di prototipazione e benchmark
Prima di sviluppare il nostro orchestratore pronto per la produzione, abbiamo condotto uno studio di benchmark completo per convalidare l'efficienza teorica del co-hosting dei modelli. Questa fase mirava a testare a fondo il parallelismo nativo di vLLM e a quantificare con precisione il grado di "interferenza" quando i modelli condividono lo stesso silicio.
Indagine sul parallelismo: trovare il "punto di crossover"
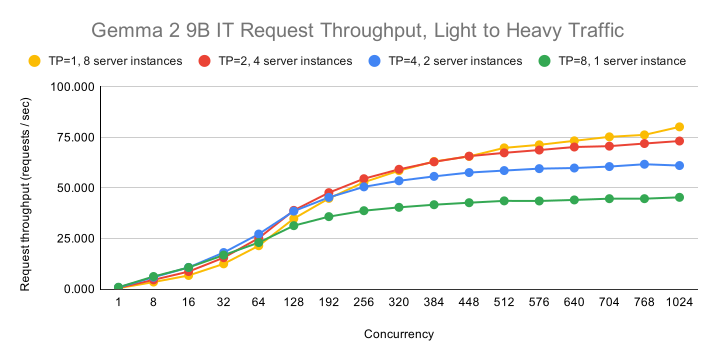
La nostra analisi iniziale si è concentrata sul parallelismo dei tensori (TP) nativo di vLLM e sull'implementazione di Vertex delle istanze del modello come più istanze del server vLLM per determinare in che modo queste strategie interagiscono con carichi di utenti variabili. Abbiamo scoperto che la configurazione ottimale dipende fortemente dalla concorrenza; con concorrenze inferiori, un parallelismo dei tensori elevato (ad es. TP=8) fornisce la latenza più bassa per le singole richieste distribuendo i livelli su tutti gli acceleratori disponibili. Tuttavia, con l'aumento del traffico simultaneo, il collo di bottiglia si sposta. Per massimizzare il throughput in condizioni di carico elevato, la configurazione ottimale passa da TP=8 a TP=4, TP=2 e infine TP=1, aumentando contemporaneamente il numero di istanze di modello indipendenti. Questa transizione definisce un "punto di crossover" in cui i vantaggi della latenza di comunicazione tra GPU ridotta nelle configurazioni con TP basso superano la velocità effettiva dell'esecuzione con TP elevato. Di seguito è riportato un grafico del punto di crossover con il modello Gemma 2 9B IT.
Fai clic per ingrandire l'immagine
Scalabilità ottimale: modello singolo, più repliche
Per stabilire una base di riferimento rigorosa per la scalabilità, abbiamo eseguito il benchmark della distribuzione di più istanze dello stesso modello su un singolo nodo. In condizioni di traffico di saturazione (2048 richieste in parallelo per GPU), l'avvio di otto istanze server vLLM indipendenti su un nodo 8xH100 ha prodotto un miglioramento del throughput di circa 7,8 volte con una regressione della latenza praticamente pari a zero rispetto a una baseline con una singola GPU.
Confronto dell'infrastruttura: container e co-scheduling dei pod
Abbiamo valutato ulteriormente la nostra orchestrazione a livello di container rispetto alle soluzioni native a livello di infrastruttura, in particolare la co-pianificazione dei pod. Sebbene entrambe le soluzioni abbiano fornito prestazioni paragonabili per la pubblicazione di più repliche, alla fine abbiamo scelto l'approccio a livello di container per il nostro minimum viable product (MVP). Questa decisione è stata guidata dalla flessibilità superiore offerta dalla soluzione a livello di container per il co-hosting eterogeneo, che consente agli sviluppatori di gestire diverse architetture di modelli affiancate con partizioni di memoria granulari definite dal software che non sono limitate dai vincoli di pianificazione di Kubernetes sottostanti. Inoltre, l'orchestrazione a livello di container consente di eseguire iterazioni molto più rapidamente ed è più facile da personalizzare e innovare.
Il test di interferenza: co-hosting di modelli diversi
L'ultima fase della prototipazione è stata il "test di interferenza", in cui abbiamo ospitato Gemma-3n-E2B-it e Llama-3.1-8B-Instruct sulla stessa VM. Con ogni modello assegnato a una partizione di memoria GPU di 0,4, le prestazioni di distribuzione sono rimaste quasi identiche ai benchmark di un singolo modello. Ad esempio, Gemma 3n ha raggiunto 30,21 reqs in un ambiente in co-hosting rispetto a 30,96 reqs in isolamento. Questi risultati confermano che l'interferenza di calcolo tra i modelli co-ospitati è minima o nulla, anche in caso di traffico intenso, a condizione che le risorse di memoria siano partizionate in modo appropriato per evitare la mancanza di cache KV.
Implementazione del container MVP
La transizione da un benchmark convalidato a un sistema pronto per la produzione ha richiesto la progettazione di un orchestratore containerizzato solido. Questa fase di sviluppo si è concentrata sulla creazione di un livello software di alto livello in grado di gestire le complessità di più cicli di vita dei modelli, garantendo al contempo l'isolamento deterministico delle risorse.
Design del server di co-hosting dei modelli
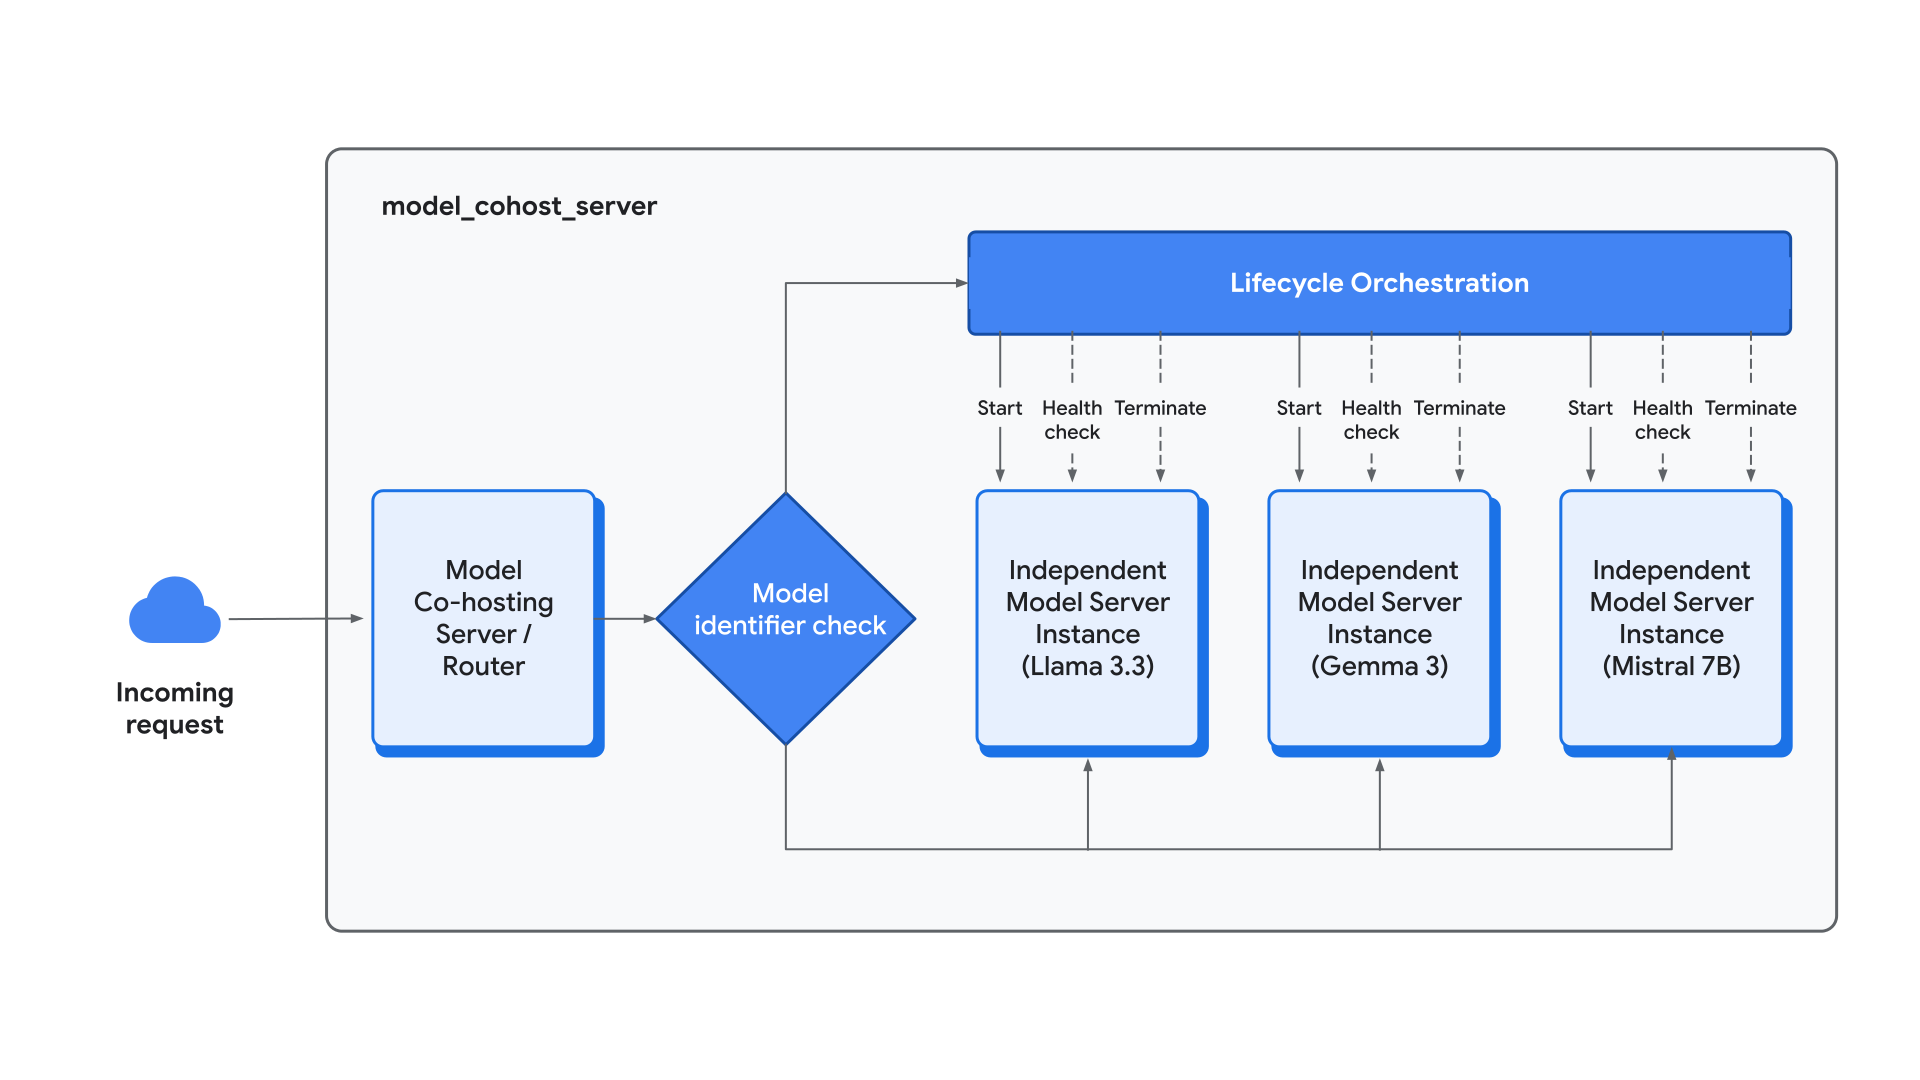
Il fulcro della nostra implementazione è model_cohost_server, un entry point personalizzato progettato per fungere da orchestratore principale all'interno del container. A differenza del modello standard a processo singolo, questo server implementa la gestione dei sottoprocessi, facilitando l'esecuzione simultanea di più istanze di server di modelli indipendenti, come vLLM, come sottoprocessi isolati. Per gestire il traffico in entrata, l'orchestratore utilizza il routing delle richieste di alto livello, identificando le richieste in base ai loro identificatori di modello univoci tramite argomenti come --served-model-name e indirizzandole all'istanza del server interno corrispondente. Oltre al routing, il server fornisce un'orchestrazione del ciclo di vita completa, gestendo l'inizializzazione, il monitoraggio dell'integrità e la terminazione di tutte le istanze in co-hosting. Questa gestione centralizzata fornisce un unico endpoint unificato per il traffico esterno, mantenendo al contempo i confini operativi distinti di ogni processo secondario.
Fai clic per ingrandire l'immagine
Partizionamento delle risorse GPU: suddivisione deterministica
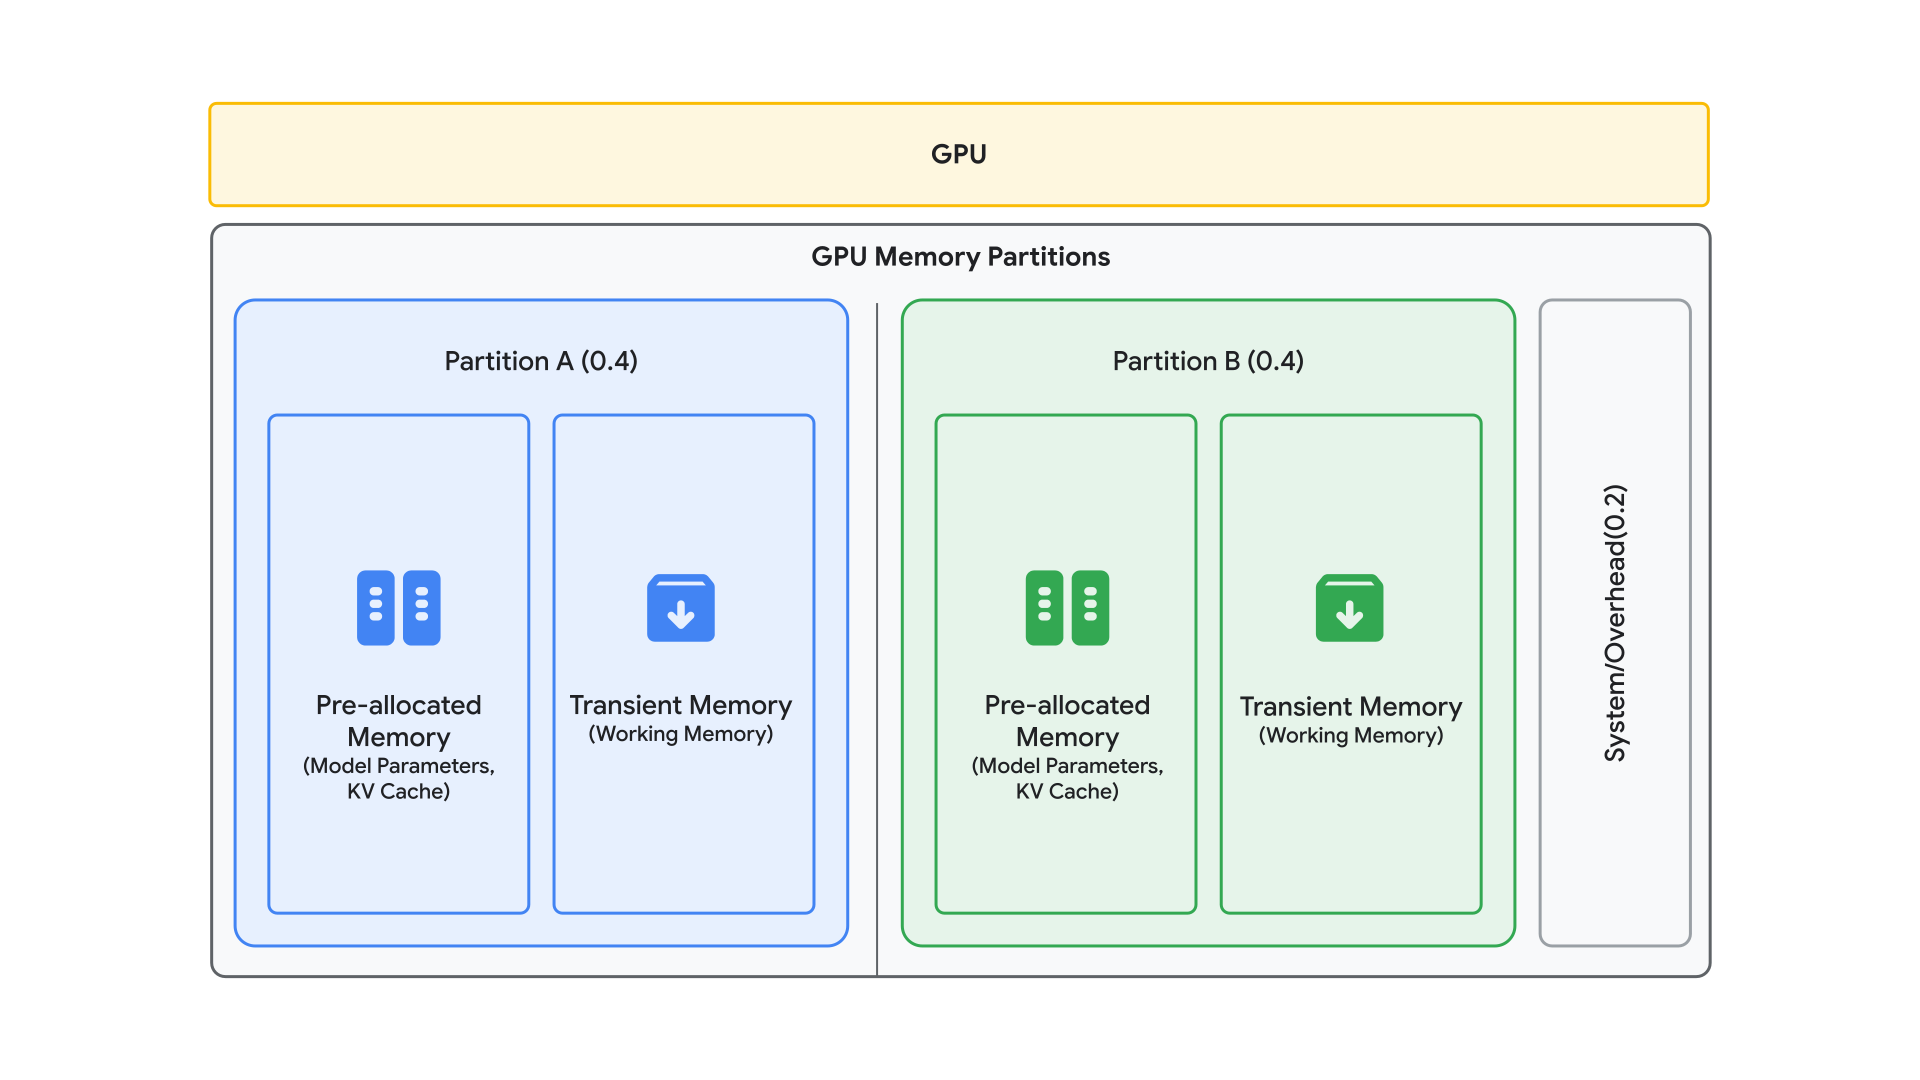
Per eliminare il rischio che il workload di un singolo modello attivi un errore Out-of-Memory (OOM) nell'ambiente in co-hosting, abbiamo implementato un rigido meccanismo di suddivisione delle risorse. Questo viene reso operativo tramite l'argomento gpu-memory-partition, che consente agli sviluppatori di definire rapporti di memoria espliciti (ad es. 0,4, 0,4) per prenotare una percentuale fissa della memoria GPU totale di un nodo per ogni singola istanza del modello.
Per guidare questa allocazione, adottiamo un modello di memoria "Pre-allocata vs. Temporanea", che distingue tra requisiti di risorse statici e dinamici.
La memoria "preallocata" è costituita dalla memoria utilizzata per i pesi del modello e la cache KV. La quantità di memoria utilizzata per i pesi del modello dipende dal numero di parametri e dalla precisione del modello. Ad esempio, un modello con 8 miliardi di parametri in BF16 richiede circa 16 GB di spazio di archiviazione statico. La quantità di memoria utilizzata per la cache KV dipende dalle dimensioni del modello, dalla precisione, dalla finestra contestuale e dal numero di sequenze. La memoria "temporanea" è costituita da calcoli intermedi e memoria di lavoro per l'inferenza. L'argomento gpu-memory-partition tiene conto della memoria "preallocata". Ti consigliamo di lasciare spazio di buffer per la memoria "temporanea" impostando la somma di gpu-memory-partition su un valore inferiore a 1,0.
Fai clic per ingrandire l'immagine
Productization
La fase di produzione della co-hosting dei modelli con Vertex AI è stata dedicata alla creazione di un ambiente fluido e pronto per la produzione per le configurazioni di erogazione di un singolo modello con più repliche e di più modelli. Questa transizione ha tradotto efficacemente i risultati empirici dei benchmark in workflow di deployment semplificati e strutture di supporto dell'infrastruttura profondamente integrate.
Workflow di deployment semplificati
Per ridurre la barriera all'ingresso per l'erogazione ad alta densità, abbiamo standardizzato le configurazioni di co-hosting utilizzando argomenti dei container personalizzati che si integrano in modo nativo con le API Vertex AI esistenti. Per le macchine virtuali con forma completa, come un nodo 8x H100, abbiamo sviluppato un'utilità di benchmark per personalizzare le migliori formule per i tuoi casi d'uso specifici. Queste utilità di benchmark ti consentono di trovare la configurazione che bilancia automaticamente il parallelismo dei tensori (TP), il parallelismo delle pipeline (PP) e il numero di istanze del modello in base al numero di parametri e alla precisione specifici del modello. Questo è supportato da un solido supporto dell'API Deployment, che consente agli sviluppatori di specificare questi parametri granulari, incluse le partizioni esatte della memoria della GPU, direttamente all'interno di una richiesta deployModel standard ed eseguire il deployment dei modelli.
Erogazione dinamica multi-modello
Un progresso significativo nel nostro percorso tecnico è stata la transizione dalle configurazioni statiche a un'architettura di pubblicazione dinamica. Questa funzionalità è fondamentale per gli ambienti di produzione caratterizzati da pattern di traffico in rapida evoluzione, poiché la capacità di caricare o scaricare i modelli senza un riavvio completo del container è essenziale per mantenere l'agilità e l'alta affidabilità dell'infrastruttura.
L'API Dynamic Update (update_models)
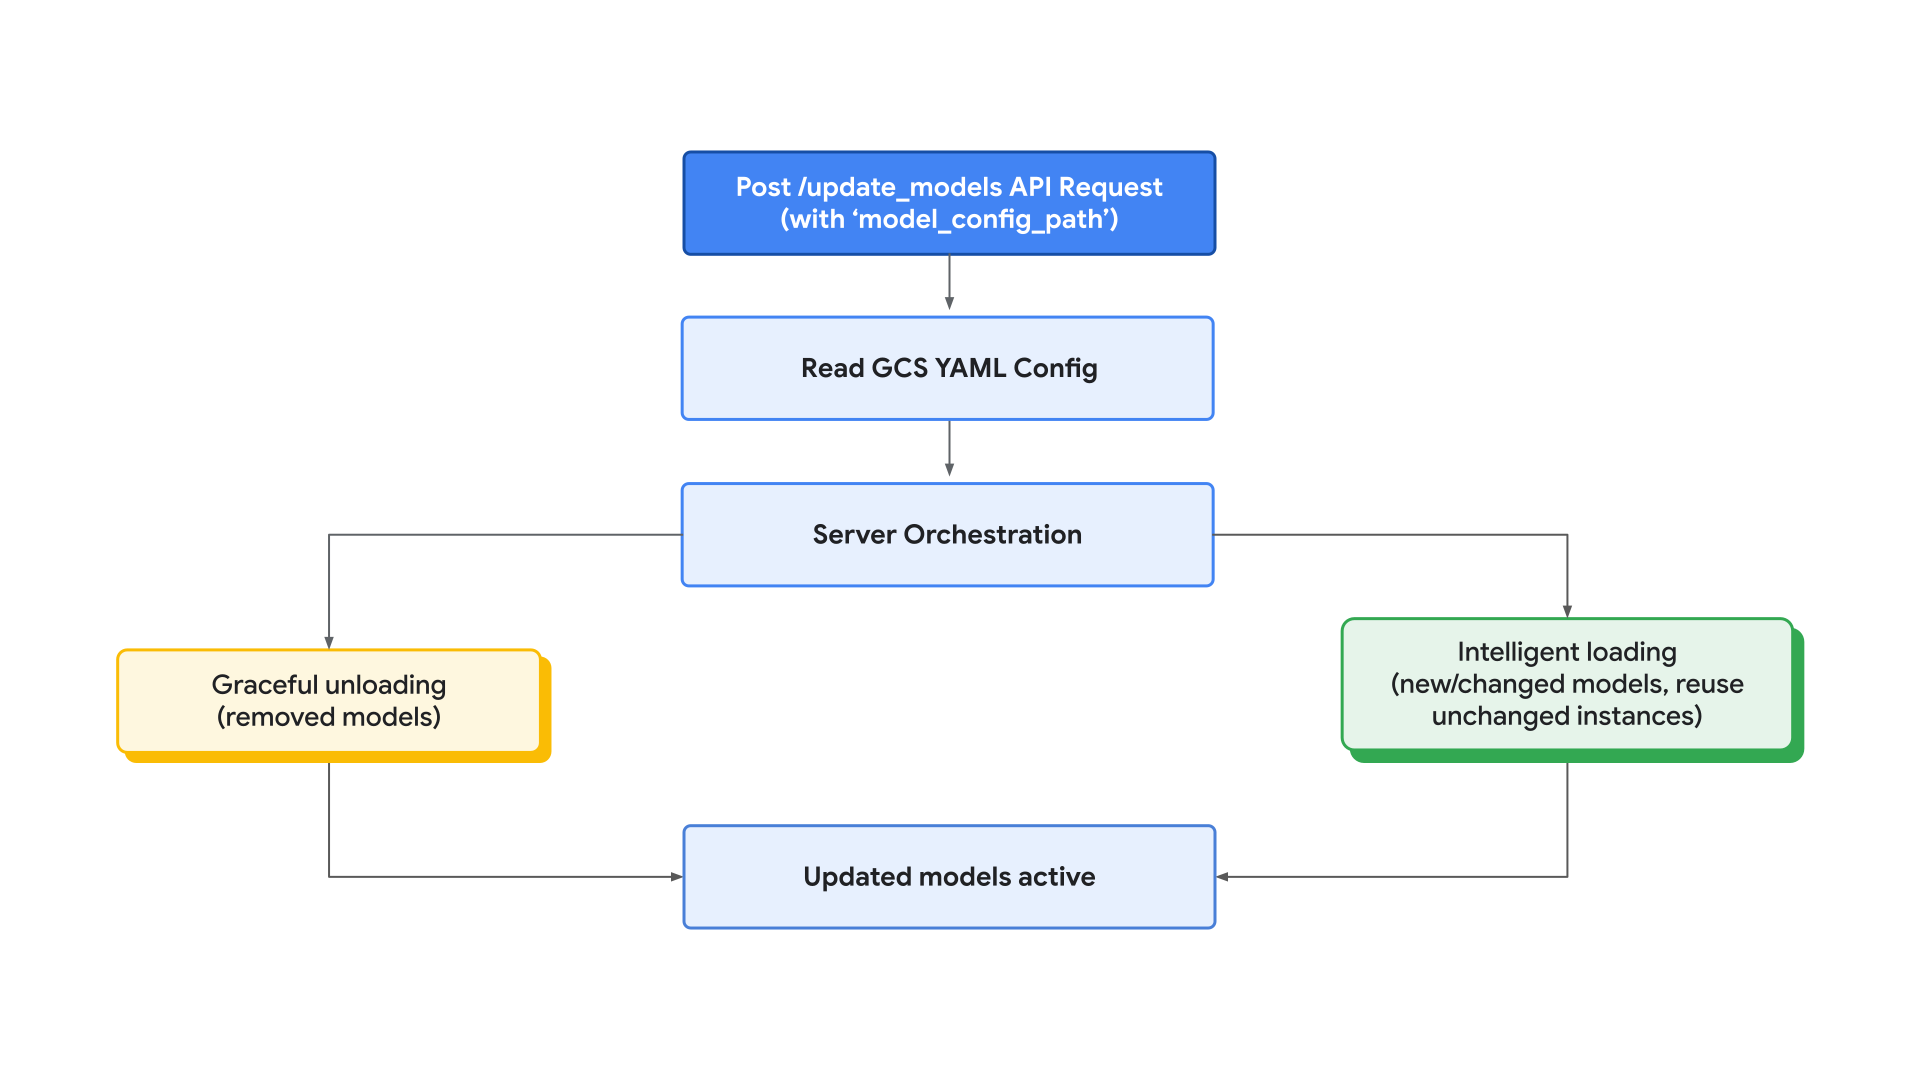
Per ovviare alle limitazioni intrinseche dei deployment immutabili, abbiamo implementato un'API di aggiornamento dei modelli specializzata all'interno del container di co-hosting dei modelli vLLM di Vertex Model Garden. Questa API facilita il ricaricamento a caldo, consentendo al server di modificare al volo il suo portfolio di modelli ospitati in base a un file di configurazione centralizzato archiviato in un bucket Google Cloud Storage (GCS).
La procedura di aggiornamento viene avviata tramite una richiesta POST all'endpoint update_models, che include model_config_path che punta al file YAML di GCS.
Al ricevimento di questa richiesta, il server esegue una sequenza di orchestrazione multifase ottimizzata per ridurre al minimo i tempi di inattività:
- Unloading controllato: il sistema identifica i modelli assenti dalla nuova configurazione e termina prima i relativi sottoprocessi, recuperando immediatamente la memoria della GPU e le risorse di computing.
- Caricamento e riutilizzo intelligenti: il server inizializza quindi nuove istanze del modello. In particolare, se le impostazioni di parallelismo di un modello, come il parallelismo dei tensori (TP) o il parallelismo della pipeline (PP), e la partizione di memoria allocata rimangono invariate, l'orchestratore riutilizza l'istanza in esecuzione esistente. Questa ottimizzazione evita la costosa fase di reinizializzazione, garantendo che i servizi attivi non vengano interrotti durante le modifiche alla configurazione.
Fai clic per ingrandire l'immagine
Analisi della latenza e delle prestazioni
L'analisi empirica di queste strategie di aggiornamento rivela che il ricaricamento a caldo dinamico riduce sostanzialmente la penalità di "avvio a freddo" comunemente associata alla pubblicazione di LLM su larga scala.
Conclusione
Il co-hosting dei modelli con Vertex AI rappresenta un cambiamento di paradigma fondamentale, che passa da deployment monolitici rigidi e con un utilizzo intensivo dell'hardware a un'architettura di distribuzione fluida ed efficiente. Evolvendo oltre lo standard "un modello per VM" in un modello di pool di computing ad alta densità, le organizzazioni possono ridurre significativamente il costo totale di proprietà (TCO) mantenendo, e spesso migliorando, i benchmark delle prestazioni.
Il nostro percorso di progettazione e gli ampi studi di benchmark multi-modello hanno stabilito un insieme definitivo di linee guida di produzione per questa architettura:
- Non esiste una configurazione universale. Sosteniamo la ricerca della migliore formula di distribuzione per un caso d'uso specifico (modello, hardware, traffico) e creiamo strumenti per farlo.
- Scalabilità della velocità effettiva con le repliche.
- Migliora l'utilizzo delle risorse superando i limiti dell'hardware e suddividendo la memoria a un livello più granulare.
Per implementare correttamente un'architettura in co-hosting, consigliamo il seguente flusso di lavoro tecnico:
- Partizionamento esplicito: utilizza l'argomento
--gpu-memory-partitionsper allocare risorse di memoria per i singoli modelli. - Benchmarking iterativo: utilizza l'utilità di benchmark fornita per identificare il punto specifico di "concorrenza incrociata" per il tuo workload, ovvero la configurazione "ottimale" del numero di istanze, TP e PP.
L'implementazione del co-hosting su Model Garden di Google Cloud fornisce un progetto scalabile per la creazione di applicazioni di AI ad alta densità. Invitiamo gli sviluppatori a esplorare queste funzionalità e a riprodurre i nostri benchmark utilizzando il notebook del tutorial fornito per ottimizzare le configurazioni di gestione in base ai requisiti aziendali specifici.
Grazie per l'attenzione
Saremo felici di ricevere il tuo feedback e rispondere alle tue domande su Vertex AI.
Ringraziamenti
Vorremmo esprimere la nostra sincera gratitudine al team di Google Cloud Vertex AI. In particolare, ringraziamo Bo Wu e Ting Yu per la loro leadership e la loro guida, nonché Deborah He, Shawn Ma, Desmond Liu, Yang Pan, Surya K G Tangatur e Luis Rizo per i loro preziosi contributi nel corso di questo progetto.