


Cloud TPU의 PyTorch
Cloud TPU의 PyTorch를 사용하면 표준 PyTorch 시맨틱스 및 분산 API를 사용하여 Cloud TPU 하드웨어에서 개방형 모델을 학습, 미세 조정, 서빙할 수 있습니다. Hugging Face, vLLM, SGLang, llm-d, TorchTitan, TorchRec, Ray 등 이미 사용 중인 생태계 도구와 통합됩니다.
스택의 기반은 Meta의 PyTorch팀과 공동 개발한 오픈소스 PyTorch 네이티브 백엔드인 TorchTPU입니다. TorchTPU는 핵심 런타임 실행 및 커스텀 커널부터 프로덕션 추론, 대규모 학습, 클러스터 조정에 이르기까지 머신러닝 수명 주기의 모든 단계에 필요한 라이브러리, 프레임워크, 도구를 제공합니다.
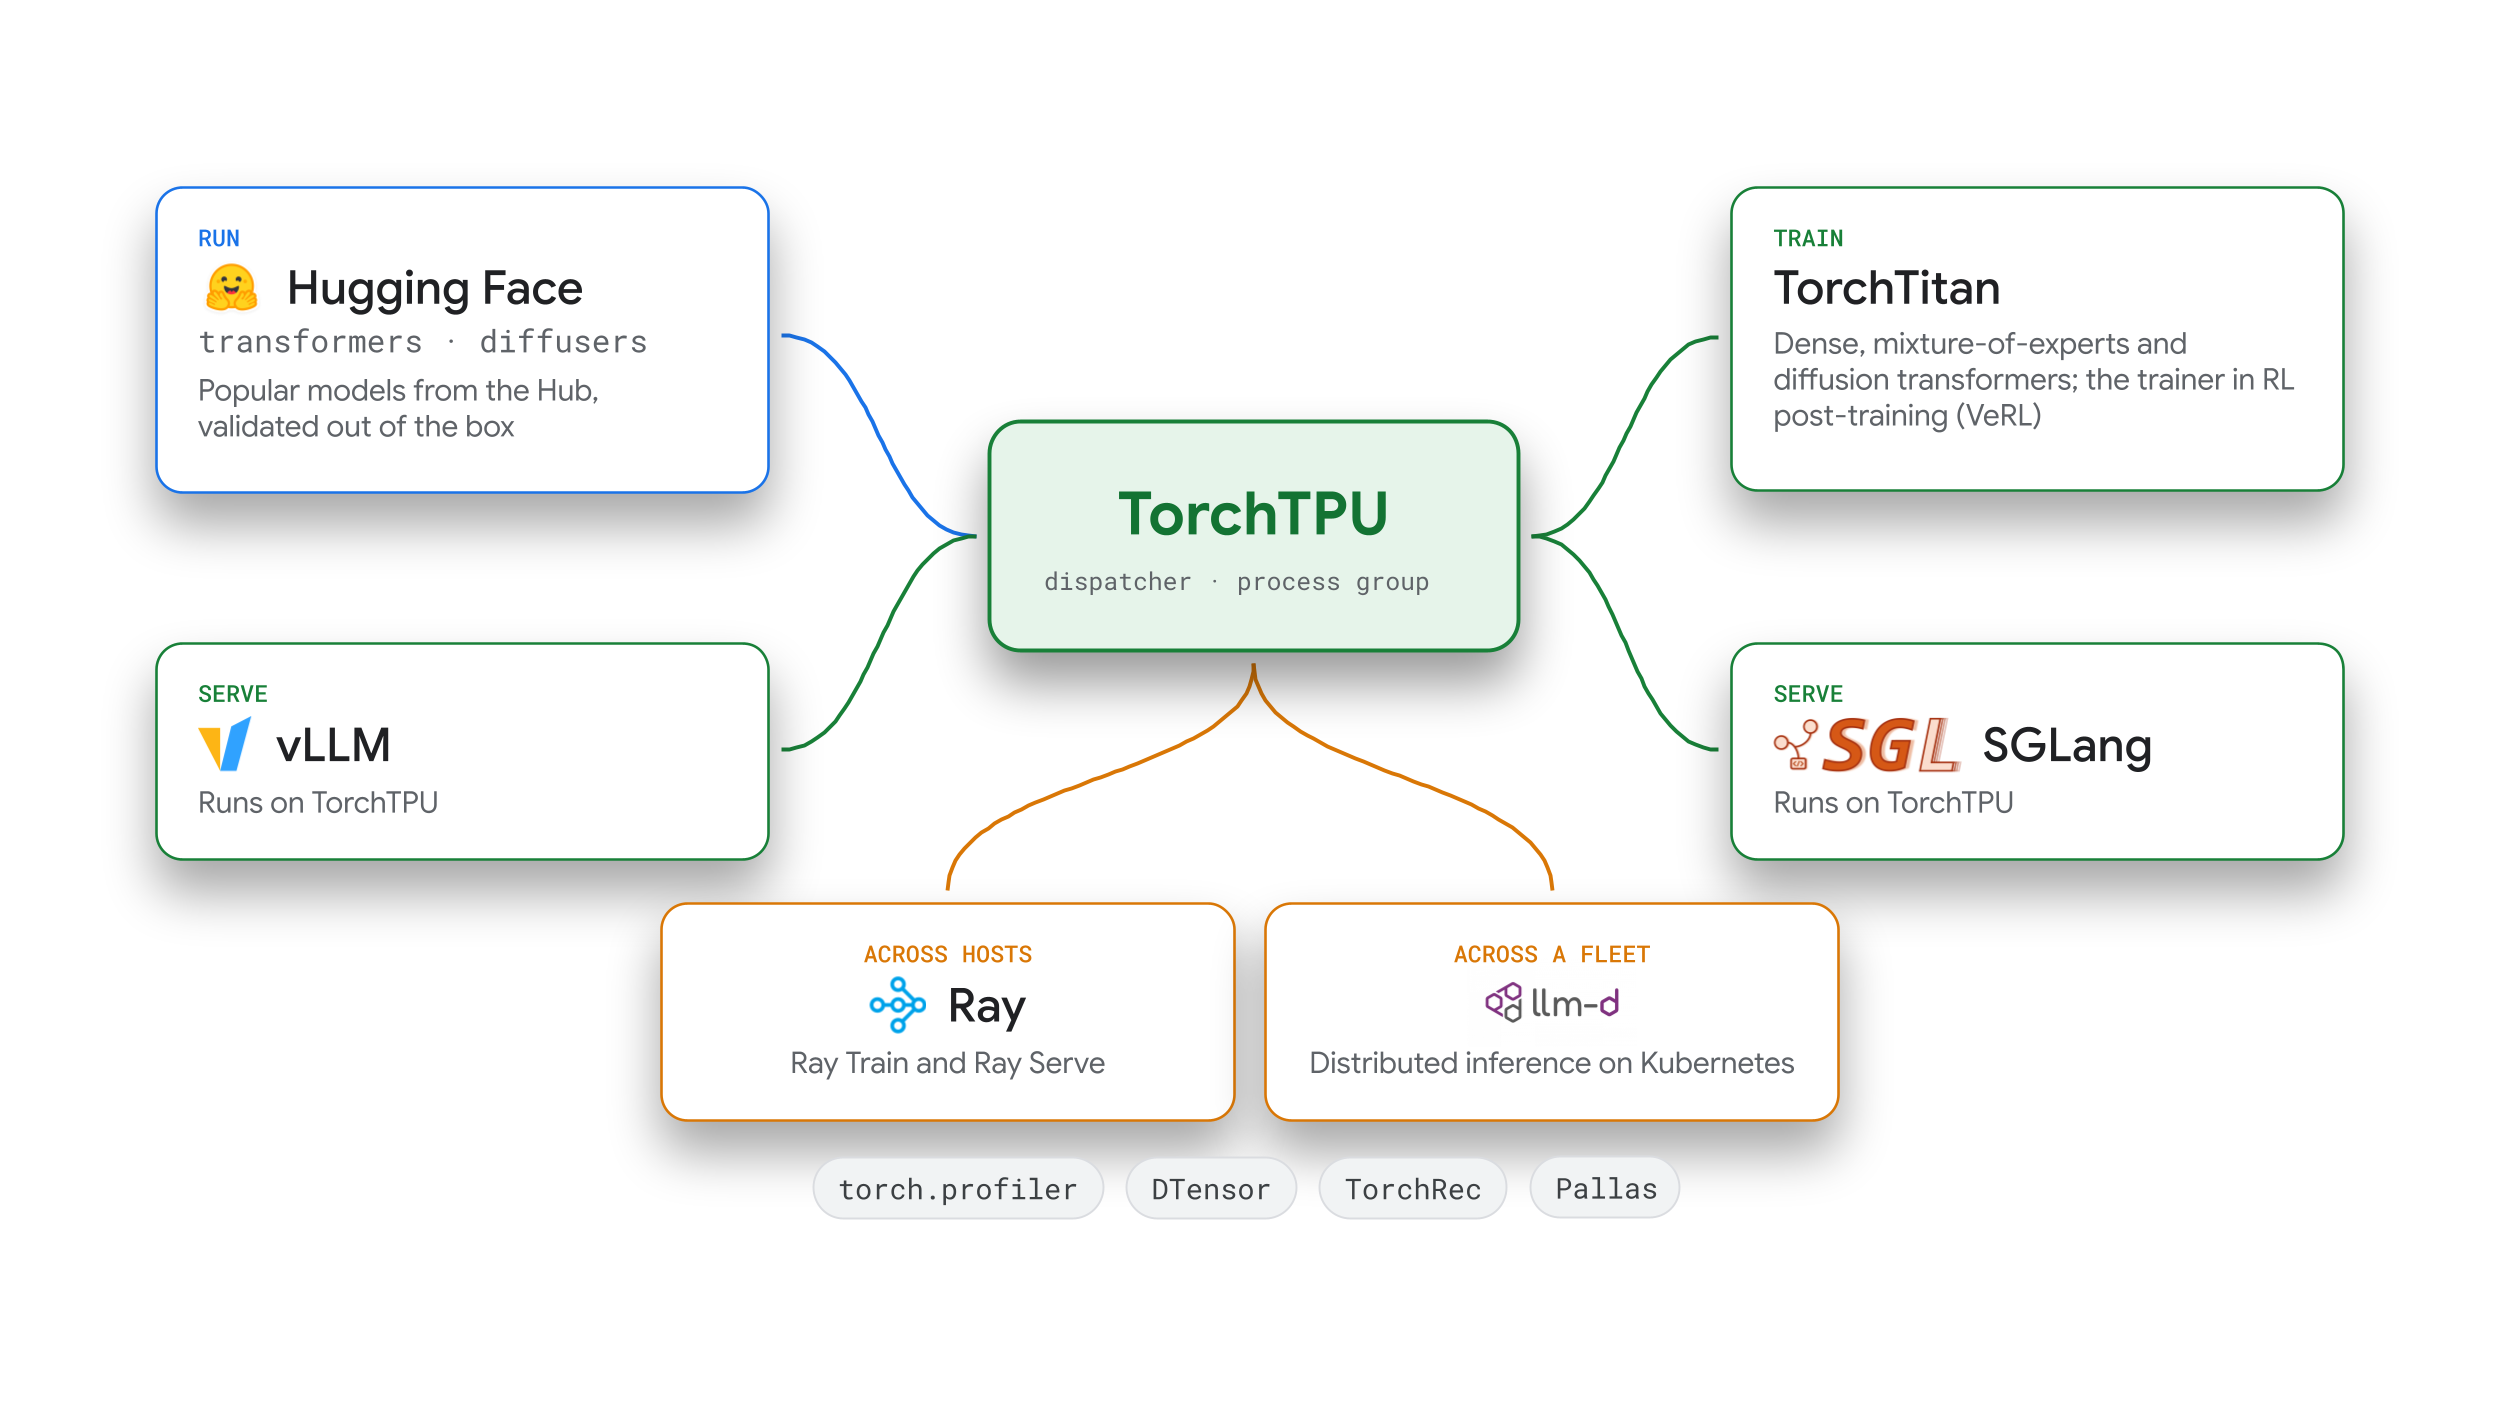
시작하기
- TPU에서 PyTorch 모델 실행: TorchTPU 및 TorchTPU 문서로 시작합니다.
- 대규모 언어 모델 (LLM) 및 멀티모달 모델 서빙: vLLM-TorchTPU 또는 SGLang-TorchTPU를 사용합니다.
- Kubernetes Fleet에서 요청 라우팅: llm-d를 사용합니다.
- 파운데이션 모델 사전 학습 또는 미세 조정: TPU에서 TorchTitan (또는 추천 모델의 경우 TorchRec)을 사용합니다.
- 데이터 처리, 학습, 강화 학습 (RL), 서빙 파이프라인 확장: Ray를 사용합니다.
- 코딩 지원으로 모델 온보딩, 프로파일링, 조정: TPU Agent Suite (프리뷰)를 사용합니다.
TorchTPU: Cloud TPU용 PyTorch 네이티브 백엔드
TorchTPU는 Cloud TPU에서 PyTorch를 위한 기기 백엔드, 그래프 컴파일러 통합, 커스텀 커널 API를 제공합니다. PyTorch팀과 함께 빌드된 TorchTPU를 사용하면 즉시 실행(eager) 모드에서 대화형으로 모델을 디버깅하고, torch.compile로 모델 코드를 컴파일하고, torch.distributed(tpu_dist)를 사용하여 슬라이스 전반에서 확장할 수 있습니다.
TorchTPU를 설치하려면 다음 명령어를 실행합니다.
pip install torch_tpu
Cloud TPU에서 텐서 작업을 실행하려면 다음 Python 코드를 실행합니다.
import torch

device = torch.device("tpu")

x = torch.randn((4, 4), device=device)
y = torch.ones((4, 4), device=device)
result = torch.matmul(x, y).cpu()

print(f"Executed on device: {x.device}")
print(f"Result shape on CPU: {result.shape}, sum: {result.sum():.4f}")
다음 동영상에서는 TorchTPU를 간략하게 설명합니다.
자세한 내용은 TorchTPU 작동 방식을 참조하세요.
동기
Cloud TPU는 이전부터 JAX 및 TensorFlow와 페어링되어 왔지만, 이전에 TPU에서 PyTorch를 실행하려면 지연 텐서 그래프 기록 (PyTorch/XLA)이 필요했으며, 이로 인해 컴파일 가능한 리전을 표시하는 코드를 추가해야 하는 경우가 많았습니다. TorchTPU는 PyTorch의 표준 기기당 단일 프로세스 실행 모델을 사용하여 기본적으로 작업을 즉시 실행하므로 기존 워크로드와 라이브러리가 구조적 재작성 없이 실행됩니다.
디자인
TorchTPU는 세 가지 설계 목표를 중심으로 PyTorch에 PyTorch 네이티브 TPU 지원을 제공합니다.
- 표준 PyTorch 시맨틱스: 기기당 하나의 프로세스를 실행하고 JAX 런타임 종속 항목 없이 PyTorch 텐서 뷰와 인플레이스 변형을 보존합니다.
- 기본적으로 즉시 실행: 대화형 디버깅 및 단계별 검사를 위해 즉시 실행 모드에서 표준 PyTorch 모델을 즉시 실행합니다.
- 컴파일러 및 커널 최적화: 즉시 실행 모드에서 연산자 병합(연산자별 즉시 실행 외에도),
torch.compile동적 형태 경계와의 통합을 제공하여 재컴파일을 줄이고 커스텀 커널 API를 제공합니다.
그래프 컴파일의 경우 torch.compile는 TorchDynamo를 사용하여 PyTorch 연산 그래프를 캡처하고 OpenXLA 및 StableHLO를 통해 TPU 기계어 코드로 컴파일합니다. 수집 작업은 torch.distributed 프로세스 그룹 수준 (tpu_dist)에서 실행됩니다.
주요 강점
- 연산자, 모델, Hugging Face 지원: TorchTPU는 정방향 및 역방향 패스에서 표준 PyTorch (ATen) 연산자를 지원하며 인기 있는 Hugging Face 모델을 대상으로 지속적으로 테스트됩니다.
device_map="tpu"를 전달하여 Transformers v5에서 모델을 배포하고, 즉시 실행 모드,torch.compile, 텐서 동시 로드를 사용하여 Diffusers 파이프라인을 실행하고, TensorBoard 및 XProf에서torch.profiler를 사용하여 워크로드를 프로파일링할 수 있습니다. - 단일 칩에서 멀티슬라이스로 확장:
tpu_dist백엔드는DistributedDataParallel(DDP),FullyShardedDataParallel(FSDP2),DTensor를 지원합니다. 또한torch.tpu.distributed.topology_aware_mesh는 동시 로드 차원을 물리적 TPU 상호 연결에 매핑합니다. - 구성 가능한 즉시 실행 모드: 세 가지 즉시 실행 모드를 제공합니다.
Strict(기본값): 표준 명령형 PyTorch 시맨틱스를 사용하여 연산자를 개별적으로 비동기식으로 전달합니다.Debug: 텐서 경계 검사와 동기식으로 실행됩니다.DeferAndFuse: 고대역폭 메모리 (HBM) 트래픽을 줄이기 위해 즉시 실행 연산자 시퀀스를 융합합니다.
- 전체 그래프 컴파일 및 캐싱:
torch.compile(backend="tpu")는 그래프를 TPU 실행 파일로 컴파일하고 프로세스, 호스트, 작업 재시작 전반에서 캐시합니다. - 커스텀 TPU 커널: 칩 간에 직접 통신하는 커널을 포함한 커스텀 Pallas 커널을 표준 PyTorch 함수로 호출할 수 있습니다. Tokamax 라이브러리의 사전 빌드된 커널을 사용하거나 Helion을 사용하여 이식 가능한 타일 기반 커널을 작성할 수도 있습니다.
자세한 내용은 TorchTPU 문서를 참조하거나 TPU의 PyTorch 토론 포럼에서 질문하거나 TorchTPU Issue Tracker에서 문제를 신고하세요.
프로덕션 추론 및 서빙
프로덕션 배포의 경우 Cloud TPU의 PyTorch는 오픈소스 추론 엔진 및 Kubernetes 기반 분산 서빙 인프라와 통합됩니다.
vLLM-TorchTPU 및 SGLang-TorchTPU: 추론 엔진
vLLM-TorchTPU 및 SGLang-TorchTPU는 vLLM 및 SGLang 추론 엔진의 TorchTPU 백엔드입니다. 두 백엔드 모두 Qwen, DeepSeek, GLM, Kimi, GPT-OSS, Gemma 4와 같은 개방형 모델을 실행합니다.
자세한 내용은 vLLM-TorchTPU 문서 및 TPU의 새로운 vLLM 및 SGLang 추론 엔진 발표를 참조하세요.
동기
추론, 멀티모달, 도구 사용 워크로드를 서빙하려면 커스텀 모델 정의, 추측 디코딩 방법, 양자화 스키마가 필요한 경우가 많습니다. TorchTPU에서 vLLM 및 SGLang 백엔드를 빌드하면 PyTorch에서 직접 서빙 스택을 맞춤설정하고 디버그할 수 있습니다.
디자인
두 백엔드 모두 TorchTPU 실행과 커스텀 Pallas 연산자를 사용하면서 표준 vLLM 및 SGLang 스케줄러, 키-값 (KV) 캐시 관리자, API 서버를 유지합니다. 대부분의 모델은 표준 PyTorch 모델 정의를 실행하는 반면, 컴퓨팅 집약적인 블록은 컴파일된 그래프 내에서 Pallas 커널을 호출하므로 하드웨어별 커널을 독립적으로 업데이트할 수 있습니다.
주요 강점
- 병렬 처리, 양자화, 추측 디코딩: 멀티모달 (이미지 및 동영상) 및 임베딩 입력과 함께 호스트 간에 텐서, 데이터, 전문가, 파이프라인, 컨텍스트 병렬 처리를 지원합니다. 지원되는 추측 디코딩 방법에는 멀티 토큰 예측 (MTP), EAGLE-3, DFlash, DSpark, n-gram 일치가 포함됩니다. 지원되는 양자화 형식에는 8비트(FP8) KV 캐시와 8비트 (FP8) 및 4비트 (MXFP4 및 NVFP4) 부동 소수점 모델 체크포인트가 포함됩니다.
- 2단계 프리픽스 캐싱, 도구 호출, 구조화된 출력: 자동 프리픽스 캐싱은 HBM에 활성 프리픽스를 유지하고 이전 프리픽스를 호스트 메모리로 오프로드하여 멀티턴 요청에서 재계산을 방지합니다. 이 캐싱은 하이브리드 어텐션 및 순환 모델을 지원하며 도구 호출 및 구조화된 출력이 기본 제공됩니다.
- TPU Sync를 사용한 중복 KV 캐시 전송: TPU Sync를 사용하여 호스트 및 호스트 KV 오프로드 전반에서 분리된 프리필 및 디코딩 서빙 (프롬프트 처리 및 토큰 생성을 별도의 워커 풀로 분리)을 지원합니다. TPU Sync는 호스트 CPU 메모리를 통해 데이터를 복사하지 않고 백그라운드 스레드에서 직접 PyTorch 기기 버퍼를 읽는 오픈소스 C++ 라이브러리입니다.
vLLM-TorchTPU에 대한 자세한 내용은 vLLM-TorchTPU 저장소 및 TPU7x용 vLLM-TorchTPU 레시피를 참조하거나 vLLM Slack 채널에서 질문하거나 vLLM-TorchTPU Issue Tracker에서 문제를 신고하세요.
SGLang-TorchTPU에 대한 자세한 내용은 SGLang-TorchTPU 저장소를 참조하거나 SGLang-TorchTPU Issue Tracker에서 문제를 신고하세요.
llm-d: Kubernetes 기반 분산 추론
llm-d는 Kubernetes에서 분산 LLM 추론을 위한 오픈소스 Cloud Native Computing Foundation (CNCF) 샌드박스 프레임워크입니다. Red Hat, IBM, Google Cloud, 500명 이상의 참여자와 35개 조직으로 구성된 커뮤니티와 함께 개발되었습니다.
동기
단일 인스턴스 추론 엔진은 복제본별 실행을 관리하지만 프로덕션 Fleet은 트래픽 급증, 멀티 테넌트 우선순위, Fleet 전체 컨텍스트 공유, 무중단 출시를 처리해야 합니다. llm-d는 추론 서버 Fleet을 조정하는 클러스터 수준 라우팅 및 작업 레이어를 제공합니다.
디자인
llm-d는 Kubernetes에서 vLLM 및 SGLang과 같은 모델 서버 앞에서 실행됩니다. llm-d는 다음을 제공합니다.
- 프리픽스 캐시 상태 및 복제본 부하를 기반으로 요청을 라우팅합니다.
- 분리된 사전 입력 및 디코딩 작업자 풀을 조정합니다.
- 전문가 혼합 (MoE) 샤딩 및 비동기 일괄 추론을 지원합니다.
- 기기 메모리, 호스트 메모리, 스토리지 전반에서 계층화된 KV 캐시 오프로드를 관리합니다.
주요 강점
- 멀티턴 세션 라우팅: 멀티턴 대화를 캐시된 컨텍스트를 보유한 복제본으로 라우팅합니다. 차례 우선순위 예약 및 스테이트풀(Stateful) Responses API 지원을 통해 에이전트는 차례 간에 컨텍스트를 재사용하여 재계산을 줄일 수 있습니다.
- 멀티 테넌트 서비스 품질: 우선순위 및 공정성 흐름 제어를 통해 지연 시간에 민감한 요청과 버스트 에이전트 워크로드가 리소스 부족 없이 Fleet을 공유할 수 있습니다.
- Fleet 작업 및 순차적 업데이트: v1 구성 API, 라우터 고가용성, 사전 입력 및 디코딩 복제본을 단일 논리 단위로 관리하는 조정된 순차적 업데이트를 제공합니다.
- Google Kubernetes Engine (GKE)의 네이티브 TorchTPU 서빙: 하나의 llm-d 엔드포인트 뒤에서 다른 가속기와 함께 Cloud TPU를 서빙하고 표준 Kubernetes 도구를 사용하여 vLLM-TorchTPU 및 SGLang-TorchTPU 복제본을 관리할 수 있습니다.
자세한 내용은 GKE Inference Gateway 정보의 llm-d 라우터 및 llm-d GKE 게이트웨이 가이드를 참조하거나 llm-d Slack 채널에서 질문하거나 llm-d Issue Tracker에서 문제를 신고하세요.
학습, 미세 조정, 도메인 라이브러리
대규모 모델을 사전 학습, 미세 조정, 조정하기 위해 TorchTPU는 TPU 하드웨어에 맞게 조정된 참조 학습 레시피와 도메인별 라이브러리를 제공합니다.
TPU의 TorchTitan: 대규모 학습 참조
TPU의 TorchTitan은 생성형 AI 학습을 위한 PyTorch 모듈식 참조 플랫폼인 TorchTitan을 TPU 샤딩 패스, 커스텀 커널, 학습 레시피로 확장합니다.
동기
멀티 호스트 TPU 슬라이스에서 학습을 확장하려면 칩 상호 연결 전반에서 매개변수를 샤딩하고 통신과 계산을 중첩해야 합니다. Google과 Meta는 TorchTitan 내에서 TPU 샤딩 및 컴파일 패스를 공동 개발했으므로 커스텀 TPU 샤딩 전략을 설계하거나 통신을 수동으로 예약할 필요가 없습니다.
디자인
가속기별 코드 없이 단일 기기 PyTorch로 모델을 작성합니다. TorchTitan은 구성 파일에서 모델 레이어를 구성하므로 모델 정의나 학습 루프를 수정하지 않고도 개별 레이어를 커스텀 Pallas 커널 (예: Splash Attention)로 바꿀 수 있습니다.
TorchTitan의 SimpleFSDP 구현은 컴파일된 그래프 내에 파라미터 샤딩 작업을 직접 배치하므로 XLA 컴파일러가 기기 통신을 연산과 중첩할 수 있습니다. 또한 전체 단계 그래프 컴파일은 전체 학습 단계를 단일 XLA 프로그램으로 캡처합니다. 멀티슬라이스 실행의 경우 하이브리드 샤딩 (HSDP)은 칩 간 상호 연결 (ICI)을 통해 각 슬라이스 내에서 샤딩하고 데이터 센터 네트워크 (DCN)를 통해 슬라이스 간에 복제합니다. 이 레이아웃은 교차 슬라이스 트래픽을 단계당 단일 경사 감소로 제한합니다.
주요 강점
- 사전 학습 및 RL 사후 학습 레시피: 밀집형 LLM (Llama 3, Qwen 3, MuseGlimmer 30B), MoE 모델 (Qwen 3 235B, 최대 8,192개의 TPU7x 칩에서 검증됨), 확산 트랜스포머 (FLUX.1)를 위한 참조 레시피가 포함되어 있습니다. RL 학습 후 (예: 그룹 상대 정책 최적화 또는 GRPO) VeRL(프리뷰)은 파라미터 업데이트를 TorchTitan에 위임합니다. 그런 다음 업데이트된 가중치를 서빙 엔진에 푸시하여 학습 궤적 (출시)을 생성합니다.
- 사전 구성된 컴파일러 및 동시 로드 설정: 레시피 구성에는 사전 구성된 컴파일러 및 동시 로드 설정이 포함되어 있으므로 코드 변경이 아닌 구성 파일을 통해 모델 FLOPs 사용률 (MFU)을 조정할 수 있습니다.
- 새 아키텍처 온보딩: Hugging Face Transformers 모델링 백엔드는 TorchTitan 트레이너를 통해 Hugging Face Hub 모델 체크포인트 (전문가 동시 로드가 없는 MoE 모델 포함)를 실행합니다. 전체 모델 포트의 경우 TorchTitan에는 엔지니어와 코딩 에이전트를 위한 단계별 온보딩 기술이 포함되어 있습니다.
- 독립형 구성요소 재사용: TorchTitan을 엔드 투 엔드로 채택하거나 개별 모듈, 커스텀 연산자, 컴파일러 플래그를 기존 학습 코드베이스로 가져올 수 있습니다.
자세한 내용은 TPU에서 TorchTitan 시작하기 가이드 및 TPU7x용 TorchTitan Qwen3-8B 학습 레시피를 참조하거나, TorchTitan 토론 포럼에서 질문하거나, TorchTitan Issue Tracker에서 문제를 신고하세요.
TorchRec: 추천 시스템
TorchRec는 추천 모델을 위한 분산 임베딩 테이블과 샤딩 프리미티브를 제공하는 PyTorch 도메인 라이브러리입니다. Cloud TPU에서 TorchRec는 TPU TensorCore에서 밀집 행렬 연산을 실행하는 동안 희소 임베딩 테이블 조회를 전용 TPU SparseCore 프로세서로 오프로드합니다.
TorchRec에 대한 자세한 내용은 TorchRec 문서를 참조하거나, TPU의 PyTorch 토론 포럼에서 질문하거나, TorchRec Issue Tracker에서 문제를 신고하세요.
클러스터 조정 및 개발자 도구
멀티 노드 파이프라인을 확장하고 모델 온보딩을 자동화하기 위해 TorchTPU 생태계는 Ray와 통합되며 TPU 문서에 액세스할 수 있는 코딩 에이전트 확장 프로그램을 제공합니다.
Ray: 분산 학습, 서빙, RL
Ray는 Ray Train, Ray Serve, [Ray Data](https://docs.ray.io/en/latest/ray-core/walkthrough.html, Ray Core, VeRL (프리뷰)과 같은 RL 프레임워크를 사용하여 클러스터 전반에서 Python 및 AI 워크로드를 확장합니다.
자세한 내용은 Google Cloud의 Ray 발표를 참조하세요.
동기
멀티슬라이스 학습 및 다단계 파이프라인 (예: 데이터 전처리, 학습, 출시 생성을 결합하는 RL 워크플로)에는 자동화된 슬라이스 프로비저닝, 토폴로지 검색, 내결함성 작업자 조정이 필요합니다. torchrun와 같은 독립형 실행 유틸리티는 TPU 슬라이스를 프로비저닝하거나 다단계 액터 파이프라인을 조정하지 않으므로 Ray는 TorchTPU 워크로드의 클러스터 전체 예약 및 배치를 관리합니다.
디자인
TPU 세대, 토폴로지, 워커 수를 지정하는 작업을 제출하면 Ray는 슬라이스의 모든 워커가 함께 예약되도록 전체 TPU 슬라이스를 예약합니다. 그러면 Ray가 칩 상호 연결 주소를 검색하고 TPU 기기당 PyTorch 워커 하나를 시작합니다. Ray Train의 PyTorch 백엔드는 작업을 시작하기 전에 tpu 기기와 tpu_dist 프로세스 그룹을 자동으로 초기화합니다.
주요 강점
- 토폴로지 일치 배치: 호스트 간 워커 배치를 물리적 TPU 세대 및 슬라이스 레이아웃과 일치시킵니다.
- 자동화된 장애 복구: 워커 또는 슬라이스에 장애가 발생할 때 자동 복구를 통해 GKE의 여러 TPU 슬라이스에서 분산 학습 작업을 실행합니다.
- TPU로 직접 데이터 미리 가져오기: Ray Data의
iter_torch_batches메서드는 배치를 PyTorch 텐서로 TPU 기기 메모리에 직접 미리 가져옵니다. - 멀티 호스트 추론 조정: vLLM-TorchTPU 및 SGLang-TorchTPU의 멀티 호스트 서빙 배포를 관리합니다.
TPU Agent Suite: TPU용 코딩 에이전트 (프리뷰)
TPU Agent Suite는 TPU v6e 및 TPU7x에서 트랜스포머 추론(밀집 대규모 언어 모델 및 MoE 모델)에 중점을 둔 코딩 지원(Claude Code 및 Google Antigravity 포함)을 위한 오픈소스 확장 프로그램입니다.
자세한 내용은 오픈소스 TPU Agent Suite 개요를 참고하세요.
동기
범용 코딩 지원에는 TPU 하드웨어 토폴로지, XLA 컴파일러 플래그, XProf 원격 분석, Pallas 커널 제약 조건에 대한 최신 컨텍스트가 부족한 경우가 많습니다. TPU Agent Suite를 사용하면 어시스턴트가 공식 TPU 문서와 구조화된 워크플로에 액세스할 수 있습니다. 이렇게 하면 잘못된 플래그 추천을 방지하고 반복적인 프로파일링 및 벤치마킹을 자동화할 수 있습니다.
디자인
이 제품군은 기존 코딩 지원에 TPU 기술 자료와 작업별 하위 에이전트 4개를 추가합니다. 라우터 에이전트 (tpu-agent)는 명령어를 직접 실행하지 않고 각 프롬프트를 적절한 하위 에이전트에 위임합니다. TPU VM 또는 GKE 클러스터에서 명령어를 실행하려면 승인이 필요하며, 조정 루프는 기록된 시도를 제한된 횟수만큼 실행한 후 결과를 반환합니다.
주요 강점
- 모델 온보딩 및 정확성 검증:
tpu-model-onboarding에이전트가 지원되지 않는 연산자를 해결하고 서빙 경로(vLLM-TorchTPU 또는 표준 PyTorch)를 선택합니다. 또한 레이어별 출력을 CPU 참조 모델과 비교하여 수치 정확성을 확인합니다. - 비정상 종료 및 병목 현상 진단:
tpu-diagnostics에이전트는 비정상 종료 로그를 분석하고, XProf 프로필과 XLA 컴파일러 trace를 검사하고, 런타임 병목 현상을 격리합니다. - 커스텀 Pallas 커널 개발:
tpu-kernel-development에이전트는 제한된 반복 예산 내에서 커스텀 Pallas TPU 커널을 작성하고 자동 조정하는 데 도움이 됩니다. - 인용을 사용한 문서 조회:
tpu-knowledge-base에이전트는 공식 TPU 문서 및 튜토리얼에 대한 명시적인 인용을 사용하여 기술적인 질문에 답변하고 주제가 다루어지지 않는 경우 이를 명시합니다.
자세한 내용은 TPU Agent Suite 문서를 참고하고, TPU Agent Suite GitHub 토론에서 의견을 공유하고 질문하거나, TPU Agent Suite Issue Tracker에서 문제를 신고하세요.
다음 단계
- TorchTPU 문서 시작하기
- TPU의 TorchTitan 레시피를 사용해 보세요.
- vLLM-TorchTPU 및 SGLang-TorchTPU를 사용하여 추론 워크로드를 배포합니다.
- TPU 토론 포럼의 PyTorch에서 질문하기
- Google 제품 및 엔지니어링팀과 특정 사용 사례를 논의하려면 torchtpu-feedback@google.com으로 이메일을 보내세요.