


Como criar IA de produção em Cloud TPUs com JAX
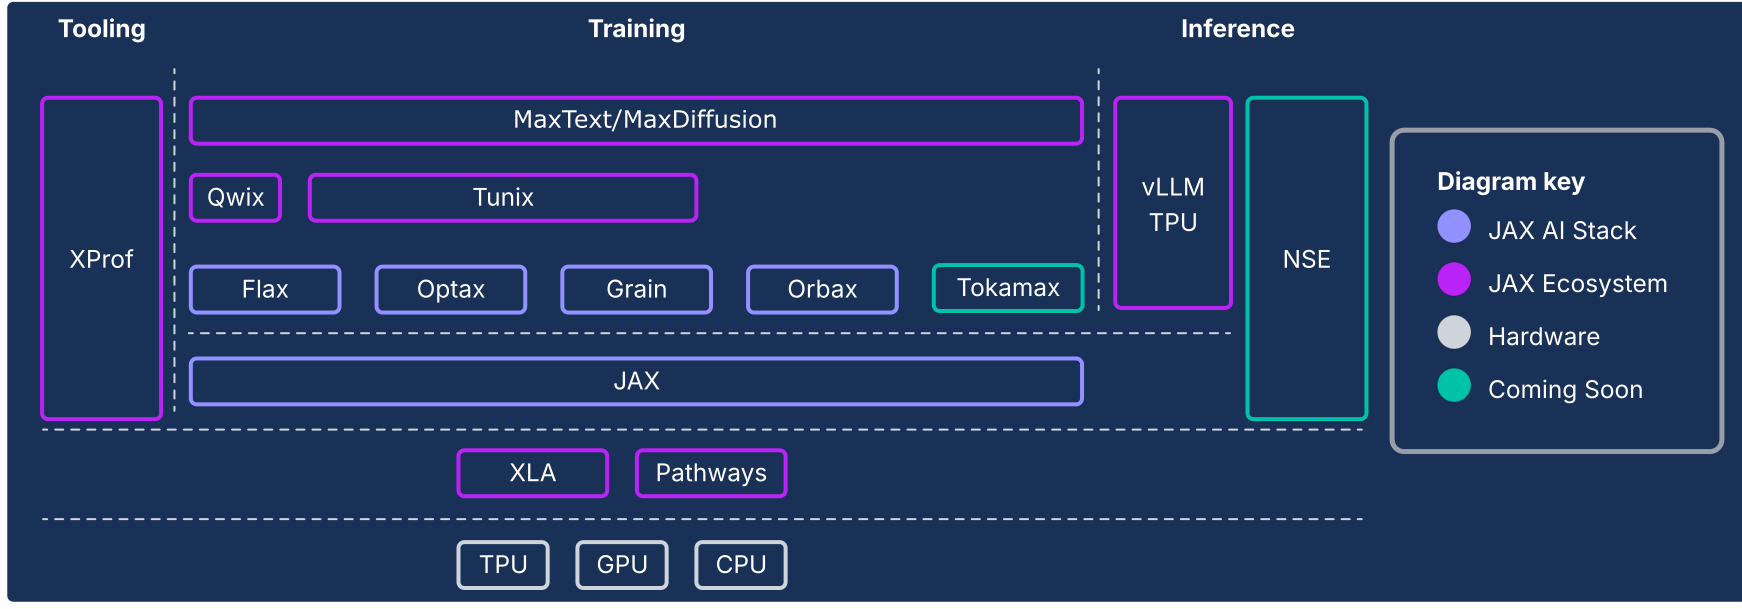
A pilha de IA do JAX estende o núcleo numérico do JAX com uma coleção de bibliotecas combináveis apoiadas pelo Google, transformando-o em uma plataforma completa, robusta e de código aberto para machine learning em escalas extremas. Por isso, a pilha de IA do JAX consiste em um ecossistema abrangente e robusto que aborda todo o ciclo de vida de ML:
Base em escala industrial:a pilha de IA do JAX foi projetada para escala massiva, aproveitando os caminhos de ML para orquestrar o treinamento em dezenas de milhares de chips e o Orbax para checkpoints assíncronos resilientes e de alta capacidade de processamento, permitindo o treinamento de nível de produção de modelos de última geração.
Kit de ferramentas completo e pronto para produção:a pilha de IA do JAX oferece um conjunto abrangente de bibliotecas para todo o processo de desenvolvimento: Flax para criação de modelos flexíveis, Optax para estratégias de otimização combináveis e Grain para os pipelines de dados determinísticos essenciais para execuções reproduzíveis em grande escala.
Desempenho máximo e especializado:para alcançar a utilização máxima do hardware, a JAX AI Stack oferece bibliotecas especializadas, incluindo Tokamax para kernels personalizados de última geração, Qwix para quantização não intrusiva que aumenta a velocidade de treinamento e inferência e XProf para criação de perfil de desempenho profunda e integrada ao hardware.
Caminho completo para produção:a JAX AI Stack oferece uma transição perfeita da pesquisa para a implantação. Isso inclui o MaxText como uma referência escalonável para treinamento de modelo de fundação, o Tunix para aprendizado por reforço (RL) e alinhamento de última geração e uma solução de inferência unificada com o vLLM-JAX e o ambiente de execução de disponibilização do JAX.
A filosofia da pilha de IA do JAX é de componentes acoplado com flexibilidade, cada um dos quais faz uma coisa bem. Em vez de ser um framework de ML monolítico, o JAX tem um escopo restrito e se concentra em operações de matriz e transformações de programas eficientes. O ecossistema é criado com base nesse framework principal para fornecer uma ampla variedade de funcionalidades, relacionadas ao treinamento de modelos de ML e outros tipos de cargas de trabalho, como computação científica.
Esse sistema de componentes acoplado com flexibilidade permite selecionar e combinar bibliotecas da melhor maneira para atender aos seus requisitos. Do ponto de vista da engenharia de software, essa arquitetura também permite atualizar funcionalidades que tradicionalmente seriam consideradas componentes principais do framework (por exemplo, pipelines de dados e checkpoints) de forma iterativa, sem o risco de desestabilizar o framework principal ou ficar preso em ciclos de lançamento. Como a maioria das funcionalidades é implementada em bibliotecas, em vez de mudanças em um framework monolítico, isso torna a biblioteca principal de números mais durável e adaptável a mudanças futuras no cenário tecnológico.
As seções a seguir fornecem uma visão geral técnica do JAX AI Stack, seus principais recursos, as decisões de design por trás deles e como eles se combinam para criar uma plataforma durável para cargas de trabalho modernas de ML.
A pilha de IA do JAX e outros componentes do ecossistema
| Componente | Função / Descrição |
|---|---|
| Núcleo e componentes da JAX AI Stack1 | |
| JAX | Computação de matrizes orientada por acelerador e transformação de programas (JIT, grad, vmap, pmap). |
| Flax | Biblioteca flexível de criação de redes neurais para criação e modificação intuitivas de modelos. |
| Optax | Uma biblioteca de transformações de processamento e otimização de gradiente combináveis. |
| Orbax | Biblioteca de checkpoints distribuídos "em qualquer escala" para resiliência de treinamento em escala heroica. |
| Granulado | Uma biblioteca de pipeline de dados de entrada escalonável, determinista e com checkpoint. |
| JAX AI Stack: infraestrutura | |
| XLA | Compilador de machine learning de código aberto para TPUs, CPUs e GPUs. |
| Pathways | Ambiente de execução distribuído para orquestrar a computação em dezenas de milhares de chips. |
| JAX AI Stack - Adv. Desenvolvimento | |
| Pallas | Uma extensão do JAX para escrever kernels personalizados de baixo nível e alto desempenho implementados em Python. |
| Tokamax | Uma biblioteca selecionada de kernels personalizados de última geração e alto desempenho (por exemplo, Attention). |
| Qwix | Uma biblioteca abrangente e não intrusiva para quantização (PTQ, QAT, QLoRA). |
| JAX AI Stack: aplicativo | |
| MaxText / MaxDiffusion | Frameworks de referência escalonáveis e de ponta para treinar modelos de fundação (por exemplo, LLM e difusão). |
| Tunix | Um framework para pós-treinamento e alinhamento de última geração (RLHF, DPO). |
| vLLM-JAX | Uma solução de inferência de LLM de alto desempenho que usa a integração integrada do framework vLLM. |
| XProf | Um criador de perfil detalhado e integrado ao hardware para análise de desempenho em todo o sistema. |
1Incluído no pacote Python jax-ai-stack.
Figura 1: componentes da pilha e do ecossistema de IA do JAX
O imperativo arquitetônico: desempenho além dos frameworks
À medida que as arquiteturas de modelos convergem, por exemplo, em transformadores multimodais de combinação de especialistas (MoE), a busca pelo desempenho máximo está levando ao surgimento de Megakernels. Um megakernel é, na verdade, todo o passe para frente (ou uma grande parte) de um modelo específico, codificado manualmente usando uma API de nível mais baixo, como o SDK CUDA em GPUs NVIDIA. Essa abordagem alcança o máximo de utilização de hardware ao sobrepor agressivamente computação, memória e comunicação. Trabalhos recentes da comunidade de pesquisa demonstraram que essa abordagem pode gerar ganhos significativos de capacidade, mais de 22% em alguns casos, para inferência em GPUs. Essa tendência não se limita à inferência. Evidências sugerem que alguns esforços de treinamento em grande escala envolveram o controle de hardware de baixo nível para alcançar ganhos substanciais de eficiência.
Se essa tendência se acelerar, todos os frameworks de alto nível como existem hoje correm o risco de se tornarem menos relevantes, já que o acesso de baixo nível ao hardware é o que realmente importa para o desempenho em arquiteturas maduras e estáveis. Isso apresenta um desafio para todas as pilhas de ML modernas: como fornecer controle de hardware de nível especializado sem sacrificar a produtividade e a flexibilidade de um framework de alto nível.
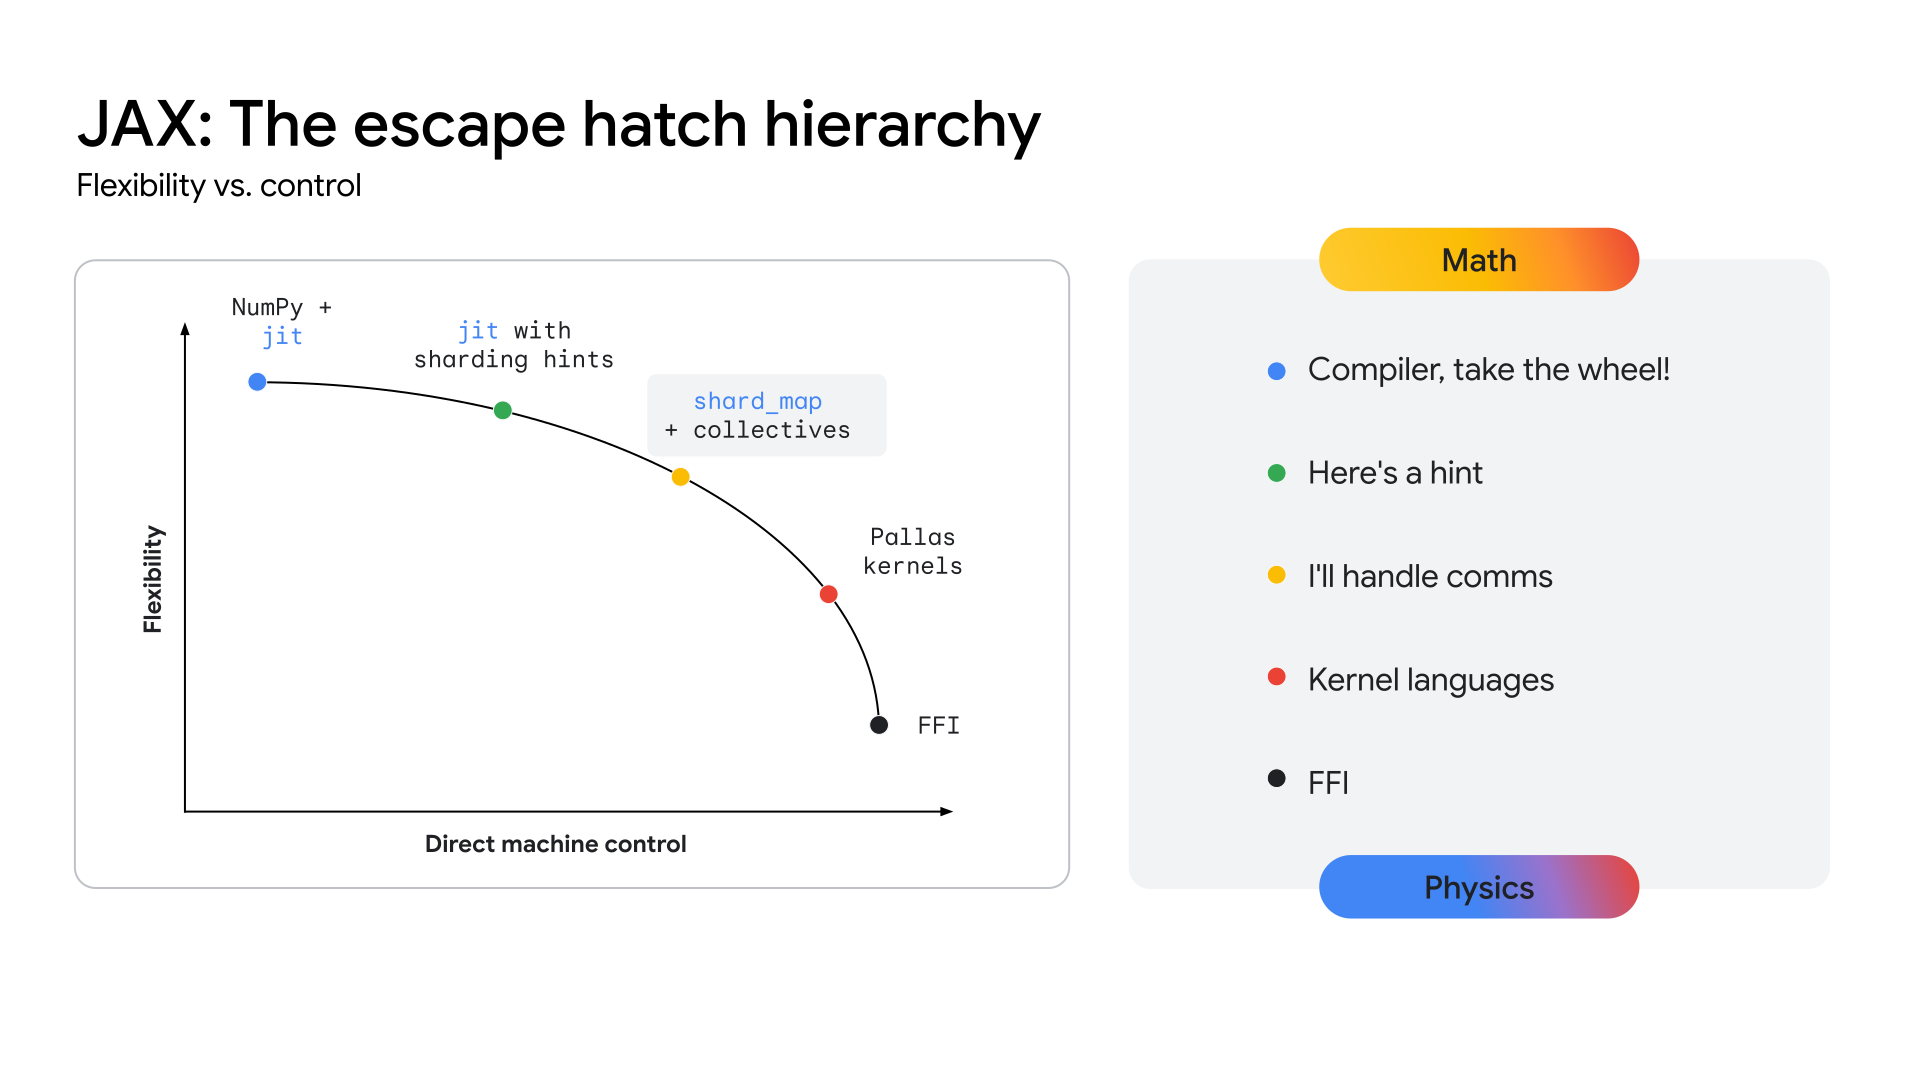
Para que as TPUs forneçam um caminho claro para esse nível de desempenho, o ecossistema precisa expor uma camada de API mais próxima do hardware, permitindo o desenvolvimento desses kernels altamente especializados. A pilha do JAX foi projetada para resolver isso oferecendo um continuum de abstração (consulte a Figura 2), desde as otimizações automatizadas de alto nível do compilador XLA até o controle manual detalhado da biblioteca de criação de kernel Pallas.
Figura 2: o continuum de abstração do JAX
A pilha principal de IA do JAX
O JAX AI Stack principal consiste em cinco bibliotecas principais que fornecem a base para o desenvolvimento de modelos:
JAX: uma base para transformação de programas combinável e de alto desempenho
O JAX é uma biblioteca Python para computação de matrizes orientada por aceleradores e transformação de programas, projetada para computação numérica de alto desempenho e machine learning em grande escala. Com o modelo de programação funcional e a API semelhante ao NumPy, o JAX oferece uma base sólida para bibliotecas de nível mais alto.
Com o design que prioriza o compilador, o JAX promove inerentemente a escalonabilidade ao usar o XLA (consulte a seção sobre o XLA) para análise, otimização e direcionamento de hardware agressivos de todo o programa. A ênfase do JAX na programação funcional (por exemplo, funções puras) torna as transformações principais do programa mais fáceis de gerenciar e, principalmente, combináveis.
Essas transformações principais podem ser combinadas para alcançar alto desempenho e escalonamento de cargas de trabalho em tamanho de modelo, tamanho de cluster e tipos de hardware:
- jit: compilação just-in-time de funções do Python em executáveis XLA otimizados e combinados.
- grad: diferenciação automática, com suporte aos modos direto e reverso, além de derivadas de ordem superior.
- vmap: vetorização automática, que permite o processamento em lote e o paralelismo de dados sem modificar a lógica da função.
- pmap / shard_map: paralelização automática em vários dispositivos (por exemplo, núcleos de TPU), formando a base para o treinamento distribuído.
A integração total com o modelo GSPMD (SPMD de uso geral) do XLA permite que o JAX paralelize automaticamente as computações em grandes pods de TPU com mudanças mínimas no código. Na maioria dos casos, o escalonamento requer apenas anotações de fragmentação de alto nível.
Flax: criação flexível de redes neurais
O Flax simplifica a criação, a depuração e a análise de redes neurais no JAX, oferecendo uma abordagem intuitiva e orientada a objetos para a criação de modelos. Embora a API funcional do JAX seja poderosa, ela oferece uma abstração baseada em camadas mais familiar para desenvolvedores acostumados com frameworks como o PyTorch, sem qualquer penalidade de desempenho.
Esse design simplifica a modificação ou combinação de componentes de modelos treinados.
Técnicas como LoRA e quantização exigem definições de modelo manipuláveis,
que a API NNX do Flax fornece por uma interface Pythonic. NNX encapsula o estado do modelo, reduzindo a carga cognitiva do usuário, e permite a travessia e modificação programáticas da hierarquia do modelo.
Pontos fortes:
- API intuitiva orientada a objetos: simplifica a construção de modelos e permite casos de uso avançados, como substituição de submódulos e inicialização parcial.
- Consistente com o Core JAX: o Flax oferece transformações elevadas que são totalmente compatíveis com o paradigma funcional do JAX, oferecendo todo o desempenho do JAX com maior facilidade para o desenvolvedor.
Optax: estratégias de otimização e processamento de gradiente combináveis
Optax é uma biblioteca de processamento e otimização de gradiente para JAX. Ele foi projetado para fornecer aos criadores de modelos blocos de construção que podem ser recombinados de maneiras personalizadas para treinar modelos de aprendizado profundo, entre outros aplicativos. Ele se baseia nos recursos da biblioteca principal do JAX para fornecer uma biblioteca de alto desempenho bem testada de funções de perda e otimizador e técnicas associadas que podem ser usadas para treinar modelos de ML.
Motivação
O cálculo e a minimização de perdas são fundamentais para o treinamento de modelos de ML. Com suporte para diferenciação automática, a biblioteca principal do JAX oferece os recursos numéricos para treinar modelos, mas não fornece implementações padrão de otimizadores conhecidos (por exemplo, RMSProp ou Adam) ou perdas (por exemplo, CrossEntropy ou MSE). Embora seja possível implementar essas funções (e alguns desenvolvedores avançados optam por fazer isso), um bug em uma implementação de otimizador introduziria problemas de qualidade de modelo difíceis de diagnosticar. Em vez de fazer o usuário implementar essas partes críticas,
o Optax fornece implementações desses algoritmos que são testadas quanto à
correção e ao desempenho.
O campo da teoria da otimização está diretamente no reino da pesquisa, mas o papel central dele no treinamento também o torna uma parte indispensável do treinamento de modelos de ML de produção. Uma biblioteca que desempenha esse papel precisa ser flexível o suficiente para acomodar iterações de pesquisa rápidas e também robusta e eficiente o suficiente para ser confiável para treinamento de modelo de produção. Ele também deve fornecer implementações bem testadas de algoritmos de última geração que correspondam às equações padrão. A biblioteca Optax, com sua arquitetura modular combinável e ênfase em código correto e legível, foi projetada para alcançar isso.
Design
O Optax foi projetado para aumentar a velocidade da pesquisa e a transição da pesquisa para a produção, fornecendo implementações legíveis, bem testadas e eficientes de algoritmos principais. O Optax tem usos além do contexto de aprendizado profundo, mas, nesse contexto, ele pode ser visto como uma coleção de funções de perda, algoritmos de otimização e transformações de gradiente bem conhecidos, implementados de maneira puramente funcional, de acordo com a filosofia do JAX. A coleção de perdas e otimizadores conhecidos permite que os usuários comecem com facilidade e confiança.
A abordagem modular adotada pelo Optax permite encadear vários otimizadores seguidos por outras transformações comuns (por exemplo, truncamento de gradiente) e encapsulá-los usando técnicas comuns, como MultiStep ou Lookahead, para alcançar estratégias de otimização poderosas com algumas linhas de código. A interface flexível permite pesquisar novos algoritmos de otimização e usar técnicas avançadas de otimização de segunda ordem, como shampoo ou muon.
# Optax implementation of a RMSProp optimizer with a custom learning rate
#  schedule, gradient clipping and gradient accumulation.
optimizer = optax.chain(
  optax.clip_by_global_norm(GRADIENT_CLIP_VALUE),
  optax.rmsprop(learning_rate=optax.cosine_decay_schedule(init_value=lr,decay_steps=decay)),
  optax.apply_every(k=ACCUMULATION_STEPS)
)

# The same thing, in PyTorch
optimizer = optim.RMSprop(model_params, lr=LEARNING_RATE)
scheduler = optim.lr_scheduler.CosineAnnealingLR(optimizer, T_max=TOTAL_STEPS)
for i, (inputs, targets) in enumerate(data_loader):
    # ... Training loop body ...
    if (i + 1) % ACCUMULATION_STEPS == 0:
        torch.nn.utils.clip_grad_norm_(model.parameters(), GRADIENT_CLIP_VALUE)
        optimizer.step()
        scheduler.step()
 optimizer.zero_grad()
O snippet de código anterior mostra como configurar um otimizador com uma taxa de aprendizado personalizada, truncamento de gradiente e acúmulo de gradiente.
Pontos fortes
- Biblioteca robusta:oferece uma biblioteca abrangente de perdas, otimizadores e algoritmos com foco na correção e legibilidade.
- Transformações modulares encadeáveis:essa API flexível permite criar estratégias de otimização avançadas e complexas de forma declarativa, sem modificar o loop de treinamento.
- Funcional e escalonável:as implementações puramente funcionais se integram perfeitamente aos mecanismos de paralelização do JAX (por exemplo, pmap), permitindo que você use o mesmo código para escalonar de um único host para clusters grandes.
Orbax / TensorStore: checkpoint distribuído em grande escala
O Orbax é uma biblioteca de checkpoint para o JAX projetada para qualquer escala, desde um único dispositivo até o treinamento distribuído em grande escala. O objetivo é unificar as implementações de checkpoint fragmentadas e oferecer recursos de desempenho essenciais, como checkpoint assíncrono e em vários níveis, para um público mais amplo. O Orbax permite a resiliência necessária para jobs de treinamento massivos e oferece um formato flexível para publicar checkpoints.
Ao contrário dos sistemas generalizados de checkpoint e restauração que capturam todo o estado do sistema, o checkpoint de ML com o Orbax persiste seletivamente apenas as informações essenciais para retomar os pesos do modelo de treinamento, o estado do otimizador e o estado do carregador de dados. Essa abordagem minimiza o tempo de inatividade do acelerador. O Orbax consegue isso sobrepondo operações de E/S com computação, um recurso essencial para grandes cargas de trabalho. O tempo de inatividade dos aceleradores é reduzido à duração da transferência de dados do dispositivo para o host, que pode ser sobreposta à próxima etapa de treinamento, tornando a criação de checkpoints quase sem custo do ponto de vista do desempenho.
Em essência, o Orbax usa o TensorStore para leitura e gravação eficientes e paralelas de dados de matriz. A API Orbax abstrai essa complexidade, oferecendo uma interface fácil de usar para lidar com PyTrees, que são a representação padrão de modelos no JAX.
Pontos fortes:
- Adoção generalizada: com milhões de downloads mensais, o Orbax serve como um meio comum para compartilhar artefatos de ML.
- Simplifica as complexidades: o Orbax abstrai as complexidades do checkpoint distribuído, incluindo salvamento assíncrono, atomicidade e detalhes do sistema de arquivos.
- Flexível: embora ofereça APIs para casos de uso comuns, o Orbax permite personalizar seu fluxo de trabalho para lidar com requisitos especializados.
- Desempenho e escalonabilidade: recursos como checkpoint assíncrono, um formato de armazenamento eficiente (OCDBT) e estratégias inteligentes de carregamento de dados garantem que o Orbax seja escalonado para execuções de treinamento que envolvem dezenas de milhares de nós.
Grain: pipelines de dados de entrada determinísticos e escalonáveis
O Grain é uma biblioteca Python para ler e processar dados para treinar e avaliar modelos JAX. Ele é flexível, rápido e determinista, além de oferecer suporte a recursos avançados, como checkpoints, que são essenciais para treinar grandes cargas de trabalho. Ele é compatível com formatos de dados e back-ends de armazenamento conhecidos e também oferece uma API flexível para estender o suporte a formatos e back-ends específicos do usuário que não são compatíveis de forma nativa. Embora o Grain tenha sido projetado principalmente para funcionar com o JAX, ele é independente de framework, não requer o JAX para ser executado e também pode ser usado com outros frameworks.
Motivação
Data pipelines são uma parte essencial da infraestrutura de treinamento. Eles precisam ser flexíveis para que as transformações comuns possam ser expressas de maneira eficiente e ter desempenho suficiente para manter os aceleradores ocupados o tempo todo. Eles também precisam ser capazes de acomodar vários formatos de armazenamento e back-ends. Devido aos tempos de etapa mais longos, o treinamento de modelos grandes em escala impõe requisitos adicionais ao pipeline de dados além daqueles exigidos por cargas de trabalho de treinamento regulares, principalmente focados em determinismo e reprodutibilidade2. A biblioteca Grain foi projetada com uma arquitetura flexível que atende a essas necessidades.
2Na seção 5.1 do artigo do PaLM, os autores observaram picos de perda muito grandes, mesmo com o truncamento de gradiente ativado. A solução foi remover os lotes de dados ofensivos e reiniciar o treinamento de um checkpoint antes do pico de perda. Isso só é possível com uma configuração de treinamento totalmente determinística e reproduzível.
Design
No nível mais alto, há duas maneiras de estruturar um pipeline de entrada: como um cluster separado de workers de dados ou colocando os workers de dados nos hosts que impulsionam os aceleradores. O Grain escolhe a segunda opção por vários motivos.
Os aceleradores são combinados com hosts potentes que normalmente ficam inativos durante as etapas de treinamento, o que os torna uma escolha natural para executar o pipeline de dados de entrada. Há outras vantagens nessa implementação: ela simplifica a visualização da fragmentação de dados, fornecendo uma visualização consistente da fragmentação na entrada e na computação. Pode-se argumentar que colocar o worker de dados no host acelerador corre o risco de saturar a CPU do host. No entanto, isso não impede o descarregamento de transformações com uso intensivo de computação para outro cluster usando RPCs3.
Na API, com uma implementação pura do Python que oferece suporte a vários processos e uma API flexível, o Grain permite implementar transformações de dados arbitrariamente complexas ao compor etapas de pipeline com base em paradigmas de transformação bem compreendidos.
Por padrão, o Grain oferece suporte a formatos de dados de acesso aleatório eficientes, como
ArrayRecord e Bagz, além de outros formatos de dados conhecidos, como Parquet
e TFDS. O Grain inclui suporte para leitura de sistemas de arquivos locais,
além de leitura do Cloud Storage por padrão. Além de oferecer suporte a formatos de armazenamento e back-ends conhecidos, uma abstração limpa para a camada de armazenamento permite adicionar suporte ou encapsular suas fontes de dados atuais para que sejam compatíveis com a biblioteca Grain.
3É assim que os pipelines de dados multimodais precisam operar: os tokenizadores de imagem e áudio, por exemplo, são modelos que são executados nos próprios clusters em aceleradores próprios, e os pipelines de entrada fazem chamadas RPC para converter exemplos de dados em streams de tokens.
Pontos fortes
- Alimentação de dados determinística:colocar o worker de dados no mesmo local que o acelerador e acoplá-lo a um embaralhamento global estável e a iteradores com checkpoint permite que o estado do modelo e o estado do pipeline de dados sejam salvos juntos em um snapshot consistente usando o Orbax, melhorando o determinismo do processo de treinamento.
- APIs flexíveis para permitir transformações de dados avançadas:uma API de transformações flexível e pura do Python permite realizar transformações de dados extensas no pipeline de processamento de entrada.
- Suporte extensível para vários formatos e back-ends:uma API de fontes de dados extensível é compatível com formatos de armazenamento e back-ends conhecidos e permite adicionar suporte para novos formatos e back-ends.
- Interface de depuração avançada:as ferramentas de visualização de pipeline de dados e um modo de depuração permitem que você faça introspecção, depure e otimize o desempenho dos seus pipelines de dados.
A pilha de IA do JAX estendida
Além da pilha principal, um ecossistema rico de bibliotecas especializadas fornece a infraestrutura, as ferramentas avançadas e as soluções de camada de aplicativo necessárias para o desenvolvimento de ML de ponta a ponta.
Infraestrutura básica: compiladores e ambientes de execução
XLA: o mecanismo independente de hardware e centrado no compilador
Motivação
O XLA ou Accelerated Linear Algebra é o compilador específico de domínio do Google, que é bem integrado ao JAX e oferece suporte a dispositivos de hardware de TPU, CPU e GPU. O XLA foi projetado para ser um gerador de código independente de hardware voltado para TPUs, GPUs e CPUs.
O design do compilador XLA, que prioriza o compilador, é uma escolha arquitetônica fundamental que cria uma vantagem duradoura em um cenário de pesquisa em rápida evolução. Por outro lado, a abordagem centrada em kernel predominante em outros ecossistemas depende de bibliotecas otimizadas manualmente para o desempenho. Embora isso seja altamente eficaz para arquiteturas de modelos estáveis e bem estabelecidas, cria um gargalo para a inovação. Quando novas pesquisas introduzem arquiteturas inovadoras, o ecossistema precisa esperar que novos kernels sejam escritos e otimizados. No entanto, nosso design centrado em compiladores geralmente pode ser generalizado para novos padrões, fornecendo um caminho de alto desempenho para pesquisas de ponta desde o primeiro dia.
Design
O XLA funciona compilando Just-In-Time (JIT) os gráficos de computação que o JAX
gera durante o processo de rastreamento (por exemplo, quando uma função é decorada
com @jax.jit).
Essa compilação segue um pipeline de vários estágios:
- Gráfico de computação do JAX
- Otimizador de alto nível (HLO)
- Otimizador de baixo nível (LLO, na sigla em inglês)
- Código do hardware
- Do grafo JAX para HLO: o grafo de computação JAX é convertido na representação HLO do XLA. Nesse nível alto, são aplicadas otimizações poderosas e independentes de hardware, como fusão de operadores e gerenciamento eficiente de memória. O dialeto StableHLO serve como uma interface durável e com controle de versão para essa etapa.
- De HLO para LLO:após as otimizações de alto nível, os back-ends específicos de hardware assumem o controle, reduzindo a representação de HLO para uma LLO orientada por máquina.
- Do LLO ao código de hardware:o LLO é finalmente compilado em código de máquina altamente eficiente. Para TPUs, esse código é agrupado como pacotes de Very Long Instruction Word (VLIW) que são enviados diretamente para o hardware.
Para escalonamento, o design do XLA é baseado em paralelismo. Ele emprega algoritmos para maximizar o uso das unidades de multiplicação de matriz (MXUs) em um chip. Entre chips, o XLA usa SPMD (Single Program Multiple Data), uma técnica de paralelização baseada em compilador que usa um único programa em todos os dispositivos. Esse modelo avançado é exposto por meio de APIs JAX, permitindo que você gerencie o paralelismo de dados, modelos ou pipelines com anotações de fragmentação de alto nível.
Para padrões de paralelismo mais complexos, também é possível usar o Multiple Program Multiple Data (MPMD), e bibliotecas como PartIR:MPMD permitem que os usuários do JAX também forneçam anotações de MPMD.
Pontos fortes
- Compilação: a compilação just-in-time do gráfico de computação permite otimizações no layout da memória, na alocação de buffer e no gerenciamento de memória. Alternativas como metodologias baseadas em kernel colocam esse fardo no desenvolvedor. Na maioria dos casos, o XLA pode alcançar um excelente desempenho sem comprometer a velocidade do desenvolvedor.
- Paralelismo:o XLA implementa várias formas de paralelismo com SPMD, e isso é exposto no nível do JAX. Isso permite expressar estratégias de fragmentação, permitindo a experimentação e a escalonabilidade de modelos em milhares de chips.
Pathways: um ambiente de execução unificado para computação distribuída em grande escala
O Pathways oferece abstrações para treinamento e inferência distribuídos com tolerância a falhas e recuperação integradas, permitindo que os pesquisadores de ML programem como se estivessem usando uma única máquina poderosa.
Motivação
Para treinar e implantar modelos grandes, são necessários centenas ou milhares de chips. Esses chips estão espalhados por vários racks e máquinas host. Um job de treinamento é um programa síncrono em grande escala que exige que todos esses chips e os respectivos hosts trabalhem em conjunto em computações XLA paralelizadas (fragmentadas). No caso de modelos de linguagem grandes, que podem precisar de mais de dezenas de milhares de chips, esse serviço precisa ser capaz de abranger vários pods em uma estrutura de data center, além de usar estruturas de interconexão entre chips (ICI) e interconexão no chip (OCI) em um pod.
Design
O ML Pathways é o sistema que usamos para coordenar computações distribuídas entre hosts e chips de TPU. Ele foi projetado para escalonabilidade e eficiência em centenas de milhares de aceleradores. Para treinamento em grande escala, ele oferece um único cliente Python para vários jobs de pod, integração com o Megascale XLA, serviço de compilação e Python remoto. Ele também é compatível com paralelismo entre frações e tolerância à preempção, permitindo a recuperação automática de preempções de recursos.
O Pathways incorpora coletivos otimizados entre hosts que permitem que os gráficos de computação do XLA se estendam além de um único pod de TPU. Ele expande o suporte do XLA para paralelismo de dados, modelos e pipelines para funcionar além dos limites de frações de TPU usando a rede de data center (DCN) por meio da integração de um ambiente de execução distribuído que gerencia a comunicação da DCN com as primitivas de comunicação do XLA.
Pontos fortes
A arquitetura de controlador único, integrada ao JAX, é uma abstração importante. Ele permite que os pesquisadores explorem várias estratégias de fragmentação e paralelismo para treinamento e implantação, além de escalonamento para dezenas de milhares de chips com facilidade.
Desenvolvimento avançado: performance, dados e eficiência
Pallas: como escrever kernels personalizados de alto desempenho no JAX
Embora o JAX seja focado no compilador, há situações em que você pode querer um controle
detalhado sobre o hardware para alcançar o desempenho máximo. O Pallas é uma
extensão do JAX que permite escrever kernels personalizados para GPUs e TPUs. O objetivo é
fornecer controle preciso sobre o código gerado, combinado com a ergonomia de alto nível
do rastreamento do JAX e da API jax.numpy.
O Pallas expõe um modelo de paralelismo baseado em grade em que uma função de kernel definida pelo usuário é iniciada em uma grade multidimensional de grupos de trabalho paralelos. Ele permite o gerenciamento explícito da hierarquia de memória, permitindo que você defina como os tensores são divididos e transferidos entre uma memória mais lenta e maior (por exemplo, HBM) e uma memória menor e mais rápida no chip (por exemplo, VMEM na TPU, memória compartilhada na GPU), usando mapas de índice para associar locais de grade a blocos de dados específicos. O Pallas pode reduzir a mesma definição de kernel para execução eficiente nas TPUs do Google e em várias GPUs, compilando kernels em uma representação intermediária adequada para a arquitetura de destino: Mosaic para TPUs ou utilizando tecnologias como Triton para GPUs. Com o Pallas, é possível escrever kernels de alto desempenho que especializam blocos, como atenção, para alcançar o melhor desempenho do modelo no hardware de destino sem precisar depender de kits de ferramentas específicos do fornecedor.
Tokamax: uma biblioteca selecionada de kernels de última geração
Se o Pallas é uma ferramenta para criar kernels, o Tokamax é uma biblioteca de kernels de acelerador personalizados de última geração que oferecem suporte a TPUs e GPUs. O Tokamax é baseado no JAX e no Pallas e permite que você use toda a potência do seu hardware. Ele também oferece ferramentas para criar e ajustar automaticamente kernels personalizados.
Motivação
O JAX, com raízes no XLA, é um framework que prioriza o compilador. No entanto, há um conjunto restrito de casos em que pode ser necessário assumir o controle direto do hardware para alcançar o desempenho máximo4. Os kernels personalizados são essenciais para conseguir o melhor desempenho de recursos caros de aceleradores de ML, como TPUs e GPUs. Embora sejam amplamente empregados para permitir a execução de alto desempenho de operadores importantes, como o Attention, a implementação deles exige um conhecimento profundo do modelo e da arquitetura de hardware de destino. O Tokamax fornece uma fonte autoritativa de kernels selecionados, bem testados e de alto desempenho, em conjunto com uma infraestrutura compartilhada robusta para desenvolvimento, manutenção e gerenciamento do ciclo de vida. Essa biblioteca também pode servir como uma implementação de referência para você criar e personalizar conforme necessário. Isso permite que você se concentre nos esforços de modelagem sem se preocupar com a infraestrutura.
4Esse é um paradigma bem estabelecido e tem precedentes no mundo da CPU, em que o código compilado forma a maior parte do programa, com os desenvolvedores usando intrínsecos ou assembly inline para otimizar seções críticas de desempenho.
Design
Para qualquer kernel, o Tokamax fornece uma API comum que pode ser apoiada por várias implementações. Por exemplo, os kernels de TPU podem ser implementados por redução padrão de XLA ou explicitamente com Pallas/Mosaic-TPU. Os kernels de GPU podem ser implementados por redução de XLA padrão, com Mosaic-GPU ou Triton. Por padrão, a API Tokamax escolhe a implementação mais conhecida para uma determinada configuração, determinada por resultados armazenados em cache de execuções periódicas de ajuste automático e comparativo de mercado, mas é possível escolher implementações específicas, se necessário. Novas implementações podem ser adicionadas ao longo do tempo para aproveitar melhor os recursos específicos em novas gerações de hardware para um desempenho ainda melhor.
Um componente essencial da biblioteca Tokamax, além dos próprios kernels, é a infraestrutura de suporte que permite escrever kernels personalizados. Por exemplo, a infraestrutura de ajuste automático permite definir um conjunto de parâmetros configuráveis (por exemplo, tamanhos de blocos) em que o Tokamax pode realizar uma varredura exaustiva para determinar e armazenar em cache as melhores configurações ajustadas possíveis. As regressões noturnas protegem você contra problemas inesperados de desempenho e numéricos causados por mudanças na infraestrutura do compilador ou em outras dependências.
Pontos fortes
- Experiência do desenvolvedor perfeita:uma biblioteca unificada e selecionada oferece implementações conhecidas e de alto desempenho de kernels importantes, com expressões claras de gerações de hardware compatíveis e desempenho esperado, tanto de forma programática quanto na documentação. Isso minimiza a fragmentação e o desligamento de usuários.
- Flexibilidade e gerenciamento do ciclo de vida:é possível escolher diferentes implementações, até mesmo mudando-as ao longo do tempo, se apropriado. Por exemplo, se o compilador XLA melhorar o suporte para determinadas operações e não exigir mais kernels personalizados, haverá um caminho para descontinuação e migração.
- Extensibilidade:é possível implementar seus próprios kernels e, ao mesmo tempo, aproveitar uma infraestrutura compartilhada bem compatível, o que permite que você se concentre em recursos e otimizações de valor agregado. As implementações padrão claramente criadas servem como ponto de partida para os usuários aprenderem e ampliarem.
Qwix: quantização abrangente e não intrusiva
O Qwix é uma biblioteca de quantização abrangente para a pilha de IA do JAX, que oferece suporte a LLMs e outros tipos de modelo em todas as etapas, incluindo treinamento (treinamento com reconhecimento de quantização (QAT), técnica de quantização (QT), adaptação de classificação baixa quantizada (QLoRA)) e quantização pós-treinamento (PTQ) de inferência, visando ambientes de execução XLA e no dispositivo.
Motivação
As bibliotecas de quantização atuais, principalmente no ecossistema do PyTorch, geralmente atendem a propósitos limitados (por exemplo, apenas PTQ ou apenas QLoRA). Esse cenário fragmentado força você a trocar de ferramenta, impedindo o uso consistente de código e a correspondência numérica precisa entre treinamento e inferência. Além disso, muitas soluções exigem modificações substanciais no modelo, acoplando rigidamente a lógica do modelo à lógica de quantização.
Design
A filosofia de design da Qwix enfatiza uma solução abrangente e, principalmente, a integração de modelos não intrusiva. Ele é arquitetado com um design hierárquico e extensível, baseado em APIs funcionais reutilizáveis.
Essa integração não intrusiva é alcançada por um mecanismo de interceptação meticulosamente projetado que redireciona as funções do JAX para as contrapartes quantizadas. Isso permite integrar seus modelos sem modificações, desacoplando completamente o código de quantização das definições do modelo.
O exemplo a seguir demonstra a aplicação da quantização w4a4 (um peso de 4 bits, ativação de 4 bits) às camadas de MLP de um LLM e da quantização w8 (um peso de 8 bits) ao incorporador. Para mudar a receita de quantização, basta atualizar a lista de regras.
fp_model = ModelWithoutQuantization(...)
rules = [
    qwix.QuantizationRule(
        module_path=r'embedder',
        weight_qtype='int8',
    ),
    qwix.QuantizationRule(
        module_path=r'layers_\d+/mlp',
        weight_qtype='int4',
        act_qtype='int4',
        tile_size=128,
        weight_calibration_method='rms,7',
    ),
]
quantized_model = qwix.quantize_model(fp_model, qwix.PtqProvider(rules))
Pontos fortes
- Solução abrangente:o Qwix é amplamente aplicável em vários cenários de quantização, garantindo o uso consistente do código entre o treinamento e a inferência.
- Integração de modelos não intrusiva:como mostra o exemplo, é possível integrar modelos com uma única linha de código. Isso permite que você use hiperparâmetros em muitos esquemas de quantização para encontrar o melhor equilíbrio entre qualidade e desempenho.
- Integração total com outras bibliotecas:o Qwix se integra perfeitamente à pilha de IA do JAX. Por exemplo, o Tokamax se adapta automaticamente para usar versões quantizadas de kernels, sem código de usuário adicional, quando o modelo é quantizado com o Qwix.
- Foco em pesquisa:as APIs básicas e a arquitetura extensível do Qwix permitem que os pesquisadores explorem novos algoritmos e facilitem comparações diretas com ferramentas integradas de comparativo de mercado e avaliação.
A camada do aplicativo: treinamento e alinhamento
Treinamento de modelo de fundação: MaxText e MaxDiffusion
O MaxText e o MaxDiffusion são os principais frameworks de treinamento de modelo de LLM e difusão do Google, respectivamente. Esses repositórios contêm uma seleção de implementações altamente otimizadas de modelos populares de pesos abertos. Eles têm um duplo propósito: funcionam como uma base de código de treinamento de modelo pronta para uso e como uma referência que os criadores de modelos de fundação podem usar para criar.
Motivação
Há um crescimento rápido do interesse em todo o setor no treinamento de modelos de IA generativa. A popularidade dos modelos abertos acelerou essa tendência, fornecendo arquiteturas comprovadas. O treinamento e a adaptação desses modelos exigem alto desempenho, eficiência, escalonabilidade para um grande número de chips e código claro e compreensível. O MaxText e o MaxDiffusion são soluções abrangentes que podem ser usadas em TPUs ou GPUs e foram projetadas para atender a essas necessidades.
Design
O MaxText e o MaxDiffusion são bases de código de modelo de fundação projetadas com foco na legibilidade e no desempenho. Eles são estruturados com componentes reutilizáveis e bem testados: definições de modelo que usam kernels personalizados (como o Tokamax) para desempenho máximo, um harness de treinamento para orquestração e monitoramento e um sistema de configuração avançado que permite controlar detalhes como fragmentação e quantização (usando o Qwix) por uma interface intuitiva. Recursos avançados de confiabilidade, como pontos de verificação em vários níveis, são incorporados para garantir um bom desempenho sustentado.
O MaxText e o MaxDiffusion usam as melhores bibliotecas JAX da categoria, Qwix, Tunix, Orbax e Optax, para oferecer recursos essenciais. Essas bibliotecas oferecem uma infraestrutura robusta e escalonável, reduzindo a sobrecarga de desenvolvimento e permitindo que você se concentre na tarefa de modelagem. Para inferência, o código do modelo é compartilhado para permitir uma disponibilização eficiente e escalonável.
Pontos fortes
- Desempenho por design:com uma infraestrutura de treinamento configurada para alta "goodput" (capacidade de processamento útil) e implementações de modelo otimizadas para alta MFU (utilização de flops de modelo), o MaxText e o MaxDiffusion oferecem alto desempenho ao escalonar horizontalmente de forma imediata.
- Criados para escalonamento:aproveitando o poder da pilha de IA do JAX (especialmente o Pathways), esses frameworks permitem escalonar de dezenas de chips para dezenas de milhares de chips.
- Base sólida para criadores de modelos de fundação:as implementações legíveis e de alta qualidade servem como um ponto de partida sólido para os desenvolvedores usarem como uma solução completa ou como uma implementação de referência para as próprias personalizações.
Pós-treinamento e alinhamento: o framework Tunix
O Tunix oferece algoritmos de aprendizado por reforço (RL, na sigla em inglês) de código aberto de última geração, além de um framework e uma infraestrutura robustos, fornecendo um caminho simplificado para os desenvolvedores testarem técnicas de pós-treinamento de LLM, incluindo ajuste supervisionado (SFT, na sigla em inglês) e alinhamento usando JAX e TPUs.
Motivação
O pós-treinamento é uma etapa essencial para liberar o verdadeiro potencial dos LLMs. A fase de aprendizado por reforço (RL) é particularmente crucial para o desenvolvimento de recursos de alinhamento e raciocínio. O desenvolvimento de código aberto nessa área tem sido quase exclusivamente baseado em PyTorch e GPUs, deixando uma lacuna fundamental para soluções de JAX e TPU. O Tunix (Tune-in-JAX) é uma biblioteca nativa do JAX de alto desempenho projetada para preencher essa lacuna.
Design
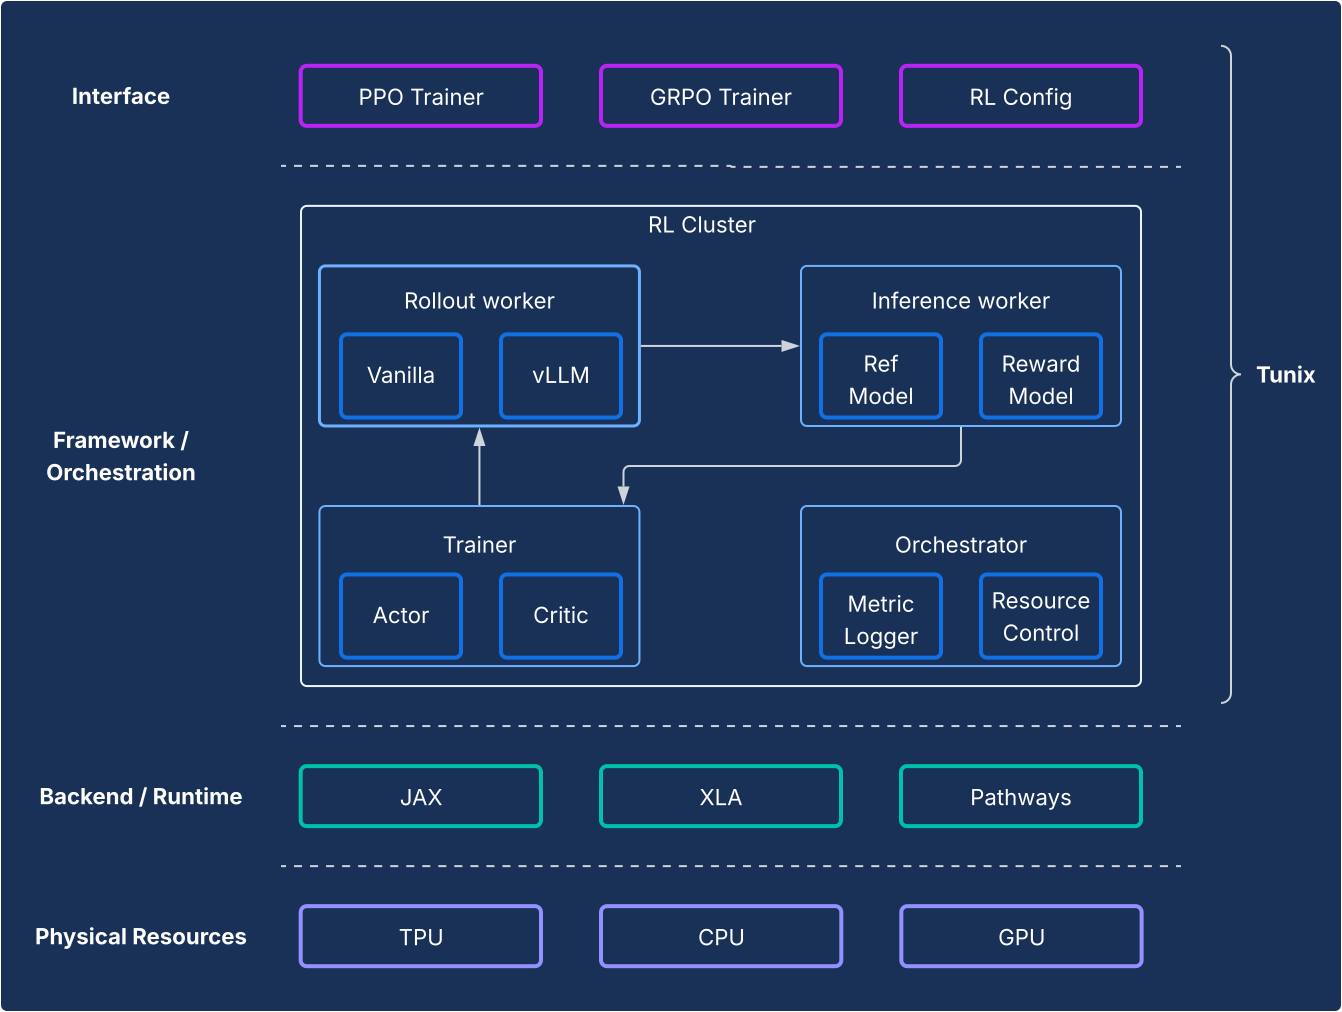
Do ponto de vista do framework, o Tunix permite uma configuração de última geração que separa claramente os algoritmos de RL da infraestrutura. Ela oferece uma API leve, semelhante a um cliente, que oculta a complexidade da infraestrutura de RL, permitindo que você desenvolva novos algoritmos. O Tunix oferece soluções prontas para uso para algoritmos conhecidos, incluindo otimização de política proximal (PPO), otimização de preferência direta (DPO) e outros.
Na infraestrutura, o Tunix tem integração com o Pathways, permitindo uma arquitetura de controlador único que torna o treinamento de RL em vários nós acessível. No treinamento, o Tunix oferece suporte nativo ao treinamento eficiente em parâmetros (por exemplo, LoRA) e usa a fragmentação do JAX e o XLA (General and Scalable Parallelization for ML Computation Graph (GSPMD)) para gerar um grafo de computação de alto desempenho. Ele é compatível com modelos de código aberto conhecidos, como Gemma e Llama, sem precisar de configuração.
Pontos fortes
- Simplicidade:ele fornece uma API de alto nível, semelhante a um cliente, que abstrai as complexidades da infraestrutura distribuída subjacente.
- Eficiência para desenvolvedores:o Tunix acelera o ciclo de vida de pesquisa e desenvolvimento com algoritmos e "receitas" integrados, oferecendo um modelo funcional e permitindo que você faça iterações rapidamente.
- Desempenho e escalonabilidade:o Tunix permite uma infraestrutura de treinamento altamente eficiente e escalonável horizontalmente, aproveitando o Pathways como um controlador único no back-end.
A camada do aplicativo: Production e inferência
Um desafio histórico para a adoção do JAX tem sido o caminho da pesquisa para a produção. A pilha de IA do JAX agora oferece uma história de produção madura e de duas frentes que oferece compatibilidade com o ecossistema e desempenho do JAX.
Inferência de LLM de alto desempenho: a solução vLLM-JAX
O vLLM-JAX é o back-end de inferência de alto desempenho do Google, projetado para executar modelos de linguagem grandes (LLMs) do JAX de maneira eficiente em Cloud TPUs. Ele integra o framework de código aberto vLLM ao ecossistema JAX e TPU do Google. Para disponibilizar modelos do PyTorch com vLLM em TPUs, consulte PyTorch no Cloud TPU.
Motivação
O setor está evoluindo rapidamente, com uma demanda crescente por soluções de inferência integradas, de alto desempenho e fáceis de usar. Os desenvolvedores costumam enfrentar desafios significativos com ferramentas complexas e inconsistentes, desempenho abaixo do esperado e compatibilidade limitada de modelos. A pilha vLLM resolve esses problemas fornecendo uma plataforma unificada, de alto desempenho e intuitiva.
Design
Essa solução estende o framework vLLM, em vez de reinventá-lo. O vLLM-JAX é um mecanismo de disponibilização de LLM de código aberto altamente otimizado, conhecido pela alta capacidade de processamento, alcançada com recursos importantes como PagedAttention (que gerencia caches de KV como memória virtual para minimizar a fragmentação) e Continuous Batching (que adiciona solicitações dinamicamente ao lote para melhorar a utilização).
O vLLM-JAX se baseia nessa base e desenvolve componentes principais para processamento de solicitações, programação e gerenciamento de memória. Ele apresenta um back-end baseado em JAX que atua como uma ponte, traduzindo o gráfico computacional e as operações de memória do vLLM em código executável por TPU. Esse back-end lida com interações de dispositivos, execução de modelos JAX e as especificidades do gerenciamento do cache de KV no hardware da TPU. Ele incorpora otimizações específicas de TPU, como mecanismos de atenção eficientes (por exemplo, usando kernels JAX Pallas para Ragged Paged Attention) e quantização, tudo adaptado para a arquitetura de TPU.
Pontos fortes
- Custo zero de integração/desativação para os usuários:os usuários podem adotar essa solução sem grandes dificuldades. Do ponto de vista da experiência do usuário, o processamento de solicitações de inferência em TPUs deve ser o mesmo que em GPUs. A CLI para iniciar o servidor, aceitar comandos e retornar saídas é compartilhada.
- Aproveitar totalmente o ecossistema:essa abordagem utiliza e contribui para a interface e a experiência do usuário do vLLM, garantindo compatibilidade e facilidade de uso.
- Fungibilidade entre TPUs e GPUs:a solução funciona de maneira eficiente em TPUs e GPUs, oferecendo flexibilidade.
- Econômico (melhor desempenho/$): otimiza o desempenho para oferecer a melhor relação custo-benefício para modelos conhecidos.
Disponibilização do JAX: serialização do Orbax e mecanismo de disponibilização do Neptune
Para modelos que não são LLMs ou para usuários que querem um pipeline totalmente nativo do JAX, a biblioteca de serialização Orbax e o sistema do mecanismo de disponibilização do Neptune (NSE, na sigla em inglês) oferecem uma solução de disponibilização de ponta a ponta e de alto desempenho.
Motivação
Historicamente, os modelos do JAX costumavam depender de um caminho indireto para a produção, como serem encapsulados em gráficos do TensorFlow e implantados usando o TensorFlow Serving. Essa abordagem introduziu limitações e ineficiências significativas, forçando os desenvolvedores a interagir com um ecossistema separado e desacelerando a iteração. Um sistema de disponibilização nativo do JAX dedicado é crucial para a sustentabilidade, a redução da complexidade e o desempenho otimizado.
Design
Essa solução consiste em dois componentes principais, conforme ilustrado no diagrama a seguir.
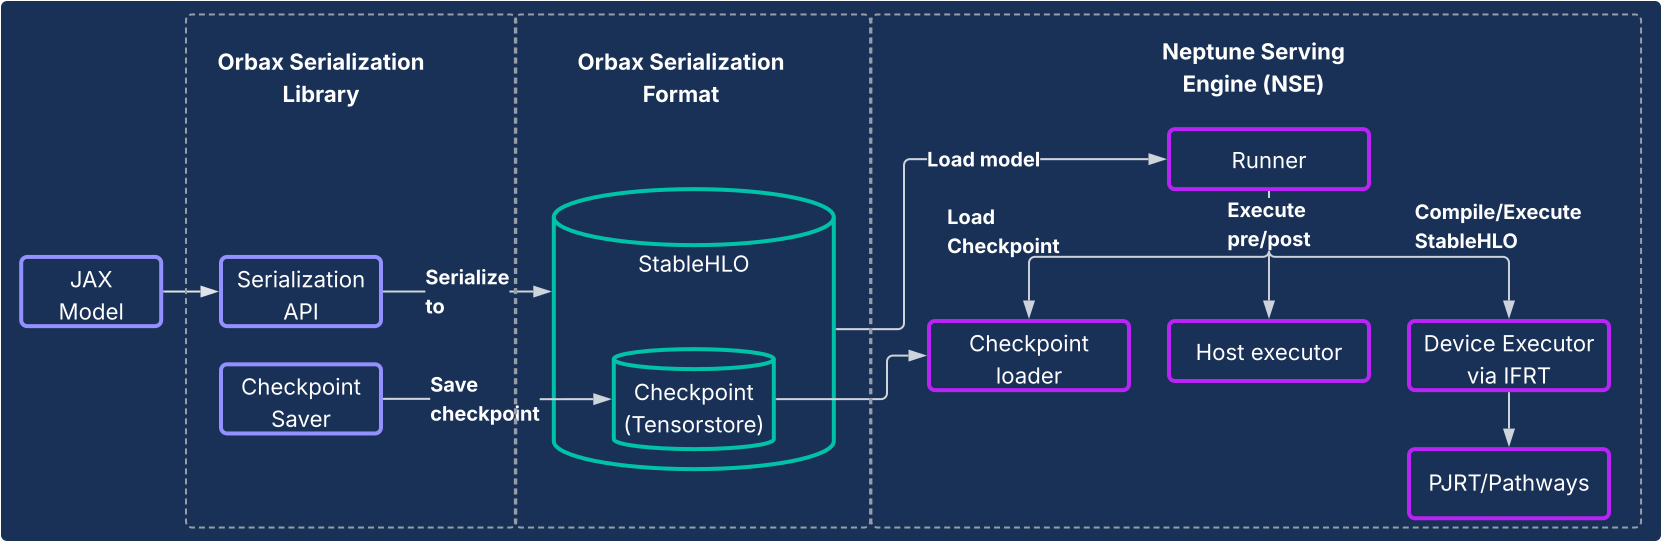
- Biblioteca de serialização do Orbax:oferece APIs fáceis de usar para serializar modelos do JAX em um formato de serialização do Orbax novo e robusto. Esse formato é otimizado para implantação de produção. Ele representa diretamente os cálculos do modelo JAX usando o StableHLO, permitindo que o gráfico de cálculo seja representado de forma nativa. Ele também usa o TensorStore para armazenar pesos, permitindo o carregamento rápido de checkpoints para disponibilização.
- Neptune Serving Engine (NSE): é o mecanismo de exibição flexível e de alto desempenho
que acompanha o Neptune (geralmente implantado como um binário C++) projetado para
executar modelos JAX de forma nativa no formato Orbax. O NSE oferece recursos essenciais para produção,
como carregamento rápido de modelos, disponibilização simultânea de alta capacidade de processamento
com lote integrado, suporte a várias versões de modelos e disponibilização de host único
e múltiplo (com PJRT e Pathways). Use o Neptune
Serving Engine para:
- Modelos que não são LLM: é uma solução de uso geral ideal para cargas de trabalho, como sistemas de recomendação, modelos de difusão e outros modelos de IA.
- LLMs pequenos e exibição "one-shot": ele foi projetado para modelos não autorregressivos ou menores que são exibidos de maneira "unária", em que toda a saída é gerada em uma única passagem, sem a necessidade de gerenciamento de estado complexo, como um cache de KV.
Em resumo, o Neptune Serving Engine preenche a lacuna para disponibilizar uma ampla variedade de modelos que não são modelos de linguagem grandes e autorregressivos, fornecendo uma solução nativa de TPU de alto desempenho para o ecossistema de ML mais amplo.
Pontos fortes
- Disponibilização nativa do JAX:a solução é criada de forma nativa para o JAX, eliminando a sobrecarga entre frameworks na serialização e disponibilização de modelos. Isso garante o carregamento rápido do modelo e a execução otimizada em CPUs, GPUs e TPUs.
- Implantação de produção sem esforço:os modelos serializados fornecem um caminho de implantação hermético que não é afetado por desvios nas dependências do Python e permite verificações de integridade do modelo de ambiente de execução. Isso oferece um caminho simples e intuitivo para a produção de modelos JAX.
- Experiência aprimorada para desenvolvedores:ao eliminar a necessidade de encapsulamento de framework, essa solução reduz significativamente as dependências e a complexidade do sistema, acelerando a iteração para desenvolvedores do JAX.
Análise e criação de perfis em todo o sistema
XProf: criação de perfil de desempenho profunda e integrada ao hardware
O XProf é uma ferramenta de criação de perfil e análise de desempenho que oferece visibilidade detalhada de vários aspectos da execução da carga de trabalho de ML, permitindo depurar e otimizar o desempenho. Ele é totalmente integrado aos ecossistemas do JAX e da TPU.
Motivação
Por um lado, as cargas de trabalho de ML estão cada vez mais complicadas. Por outro lado, há uma explosão de recursos de hardware especializados voltados para essas cargas de trabalho. Combinar os dois de forma eficaz para garantir o máximo de desempenho e eficiência é fundamental, considerando os enormes custos da infraestrutura de ML. Isso requer visibilidade profunda da carga de trabalho e do hardware, apresentada de uma forma que seja rapidamente consumível. O XProf é excelente nisso.
Design
O XProf consiste em dois componentes principais: coleta e análise.
- Coleta:o XProf captura informações de várias fontes: anotações no código JAX, modelos de custo para operações no compilador XLA e recursos de criação de perfil de hardware criados para fins específicos na TPU. Essa coleta pode ser acionada de forma programática ou sob demanda, gerando um artefato de evento abrangente.
- Análise:o XProf pós-processa os dados coletados e cria um conjunto de visualizações avançadas, acessadas com um navegador.
Pontos fortes
O verdadeiro poder do XProf vem da integração profunda com a pilha completa, oferecendo uma amplitude e profundidade de análise que é um benefício tangível do ecossistema JAX/TPU co-projetado.
- Projetado em conjunto com a TPU:o XProf aproveita os recursos de hardware projetados especificamente para a coleta de perfis, permitindo uma sobrecarga de coleta de menos de 1%. Isso permite que a criação de perfil seja uma parte leve e iterativa do desenvolvimento.
- Amplitude e profundidade da análise:o XProf gera análises profundas em vários eixos. As ferramentas incluem:
- Trace Viewer:uma visualização da linha do tempo da operação de execução em diferentes unidades de hardware (por exemplo, TensorCores).
- Perfil de operação de HLO:divide o tempo total gasto em diferentes categorias de operações.
- Memory Viewer:detalha as alocações de memória por diferentes operações durante a janela analisada.
- Análise de roofline:ajuda a identificar se operações específicas estão vinculadas à computação ou à memória e a que distância estão dos recursos de pico do hardware.
- Visualizador de gráficos:mostra o gráfico completo de HLO executado pelo hardware.
Uma perspectiva comparativa: a pilha JAX/TPU como uma escolha interessante
O cenário moderno de machine learning oferece muitos conjuntos de ferramentas excelentes e maduros. A JAX AI Stack apresenta um conjunto único e atraente de vantagens para desenvolvedores focados em ML de alto desempenho e em grande escala, decorrentes diretamente do design modular e do co-design de hardware profundo.
Embora muitos frameworks ofereçam uma ampla variedade de recursos, a JAX AI Stack oferece diferenciais específicos e poderosos em áreas importantes do ciclo de vida de desenvolvimento:
- Uma experiência de desenvolvedor mais simples e poderosa:o paradigma de transformação de gradiente encadeável do Optax permite estratégias de otimização mais eficientes e flexíveis que são declaradas uma vez, em vez de serem gerenciadas de forma imperativa no loop de treinamento. No nível do sistema, a interface de controlador único mais simples do Pathways abstrai a complexidade do treinamento de várias frações, uma simplificação significativa para os pesquisadores.
- Projetado para resiliência em escala heróica:a pilha do JAX foi projetada para treinamento em escala extrema. O Orbax oferece recursos de "resiliência de treinamento em escala heroica", como checkpoints de emergência e de vários níveis. Isso é complementado pelo Grain, que oferece suporte total à reprodutibilidade com embaralhamentos globais determinísticos e carregadores de dados com pontos de verificação. A capacidade de criar checkpoints atômicos do estado do pipeline de dados (Grain) com o estado do modelo (Orbax) é um recurso essencial para garantir a reprodutibilidade em jobs de longa duração.
- Um ecossistema completo de ponta a ponta:a pilha oferece uma solução coesa de ponta a ponta. Os desenvolvedores podem usar o MaxText como uma referência de SOTA para treinamento, Tunix para alinhamento e seguir um caminho duplo claro para a produção com vLLM-JAX (para compatibilidade com vLLM) e NSE (para desempenho do JAX).
Embora muitas pilhas sejam semelhantes do ponto de vista de software de alto nível, o fator decisivo geralmente se resume ao desempenho/TCO, que é onde o co-design do JAX e das TPUs oferece uma vantagem distinta. Esse benefício de desempenho/TCO é um resultado direto da integração vertical entre software e hardware de TPU. A capacidade do compilador XLA de mesclar operações especificamente para a arquitetura da TPU ou para o criador de perfil XProf usar ganchos de hardware para criação de perfil de sobrecarga de <1% são benefícios tangíveis dessa integração profunda.
Para as organizações que adotam essa pilha, a natureza completa da JAX AI Stack minimiza o custo da migração. Para clientes que usam arquiteturas de modelos abertos populares, a mudança de outros frameworks para o MaxText geralmente é uma questão de configurar arquivos de configuração. Além disso, a capacidade da pilha de processar formatos de checkpoint conhecidos, como safetensors, permite que os checkpoints atuais sejam migrados sem a necessidade de um novo treinamento caro.
A tabela a seguir mostra um mapeamento dos componentes fornecidos pela pilha de IA do JAX e os equivalentes em outros frameworks ou bibliotecas.
| Função | JAX | Alternativas/equivalentes em outros frameworks5 |
| Compilador / ambiente de execução | Álgebra linear acelerada (XLA, na sigla em inglês) | Indutor, ansioso |
| Treinamento com vários pods | Pathways | Estratégias do Torch Lightning, Ray Train, Monarch (novo). |
| Framework principal | JAX | PyTorch |
| Criação de modelos | Modelos Flax, Max* | torch.nn.*,
NVidia TransformerEngine, HuggingFace Transformers
|
| Otimizadores e perdas | Optax | torch.optim.*, torch.nn.*Loss |
| Carregadores de dados | Granulação | Ray Data, carregadores de dados do HuggingFace |
| Como estabelecer pontos de verificação | Orbax | Checkpoints distribuídos do PyTorch, checkpoints do NeMo |
| Quantização | Qwix | TorchAO, bitsandbytes |
| Criação de kernel e implementações conhecidas | Pallas / Tokamax | Triton/Helion, Liger-kernel, TransformerEngine |
| Pós-treinamento / ajuste | Tunix | VERL, NeMoRL |
| Criação de perfil | XProf | Criador de perfil do PyTorch, sistemas NSight, NSight Compute |
| Treinamento do modelo de fundação | MaxText, MaxDiffusion | NeMo-Megatron, DeepSpeed, TorchTitan |
| Inferência de LLM | vLLM | SGLang |
| Inferência não LLM | NSE | Servidor de inferência Triton, RayServe |
5Algumas das equivalências aqui nem sempre são comparações verdadeiras porque outros frameworks desenham limites de API de maneira diferente em comparação com o JAX. A lista de equivalentes não é completa, e novas bibliotecas aparecem com frequência.
Conclusão: uma plataforma durável e pronta para produção para o futuro da IA
Os dados fornecidos na tabela anterior ilustram uma conclusão evidente: essas pilhas têm pontos fortes e fracos em um pequeno número de áreas, mas, no geral, são muito semelhantes do ponto de vista do software. As duas pilhas oferecem soluções prontas para pré-treinamento, adaptação pós-treinamento e implantação de modelos de fundação.
A pilha de IA do JAX oferece uma solução atraente e robusta para treinar e implantar modelos de ML em qualquer escala. Ele aproveita a integração vertical profunda entre software e hardware de TPU para oferecer desempenho e custo total de propriedade líderes na categoria.
Com base em sistemas internos testados em batalha, a pilha evoluiu para fornecer confiabilidade e escalonabilidade inerentes, permitindo que os usuários desenvolvam e implantem com confiança até mesmo os maiores modelos. O design modular e combinável, baseado na filosofia da pilha de IA do JAX, oferece aos usuários liberdade e controle sem precedentes, permitindo que eles adaptem a pilha às necessidades específicas sem as restrições de um framework monolítico.
Com o XLA e o Pathways fornecendo uma base escalonável e tolerante a falhas, o JAX fornecendo uma biblioteca numérica expressiva e de alto desempenho, bibliotecas de desenvolvimento principais avançadas, como Flax, Optax, Grain e Orbax, ferramentas de desempenho avançadas, como Pallas, Tokamax e Qwix, e uma camada robusta de aplicativo e produção em MaxText, vLLM e NSE, a pilha de IA do JAX fornece uma base durável para os usuários criarem e levarem rapidamente pesquisas de última geração para a produção.