


PyTorch no Cloud TPU
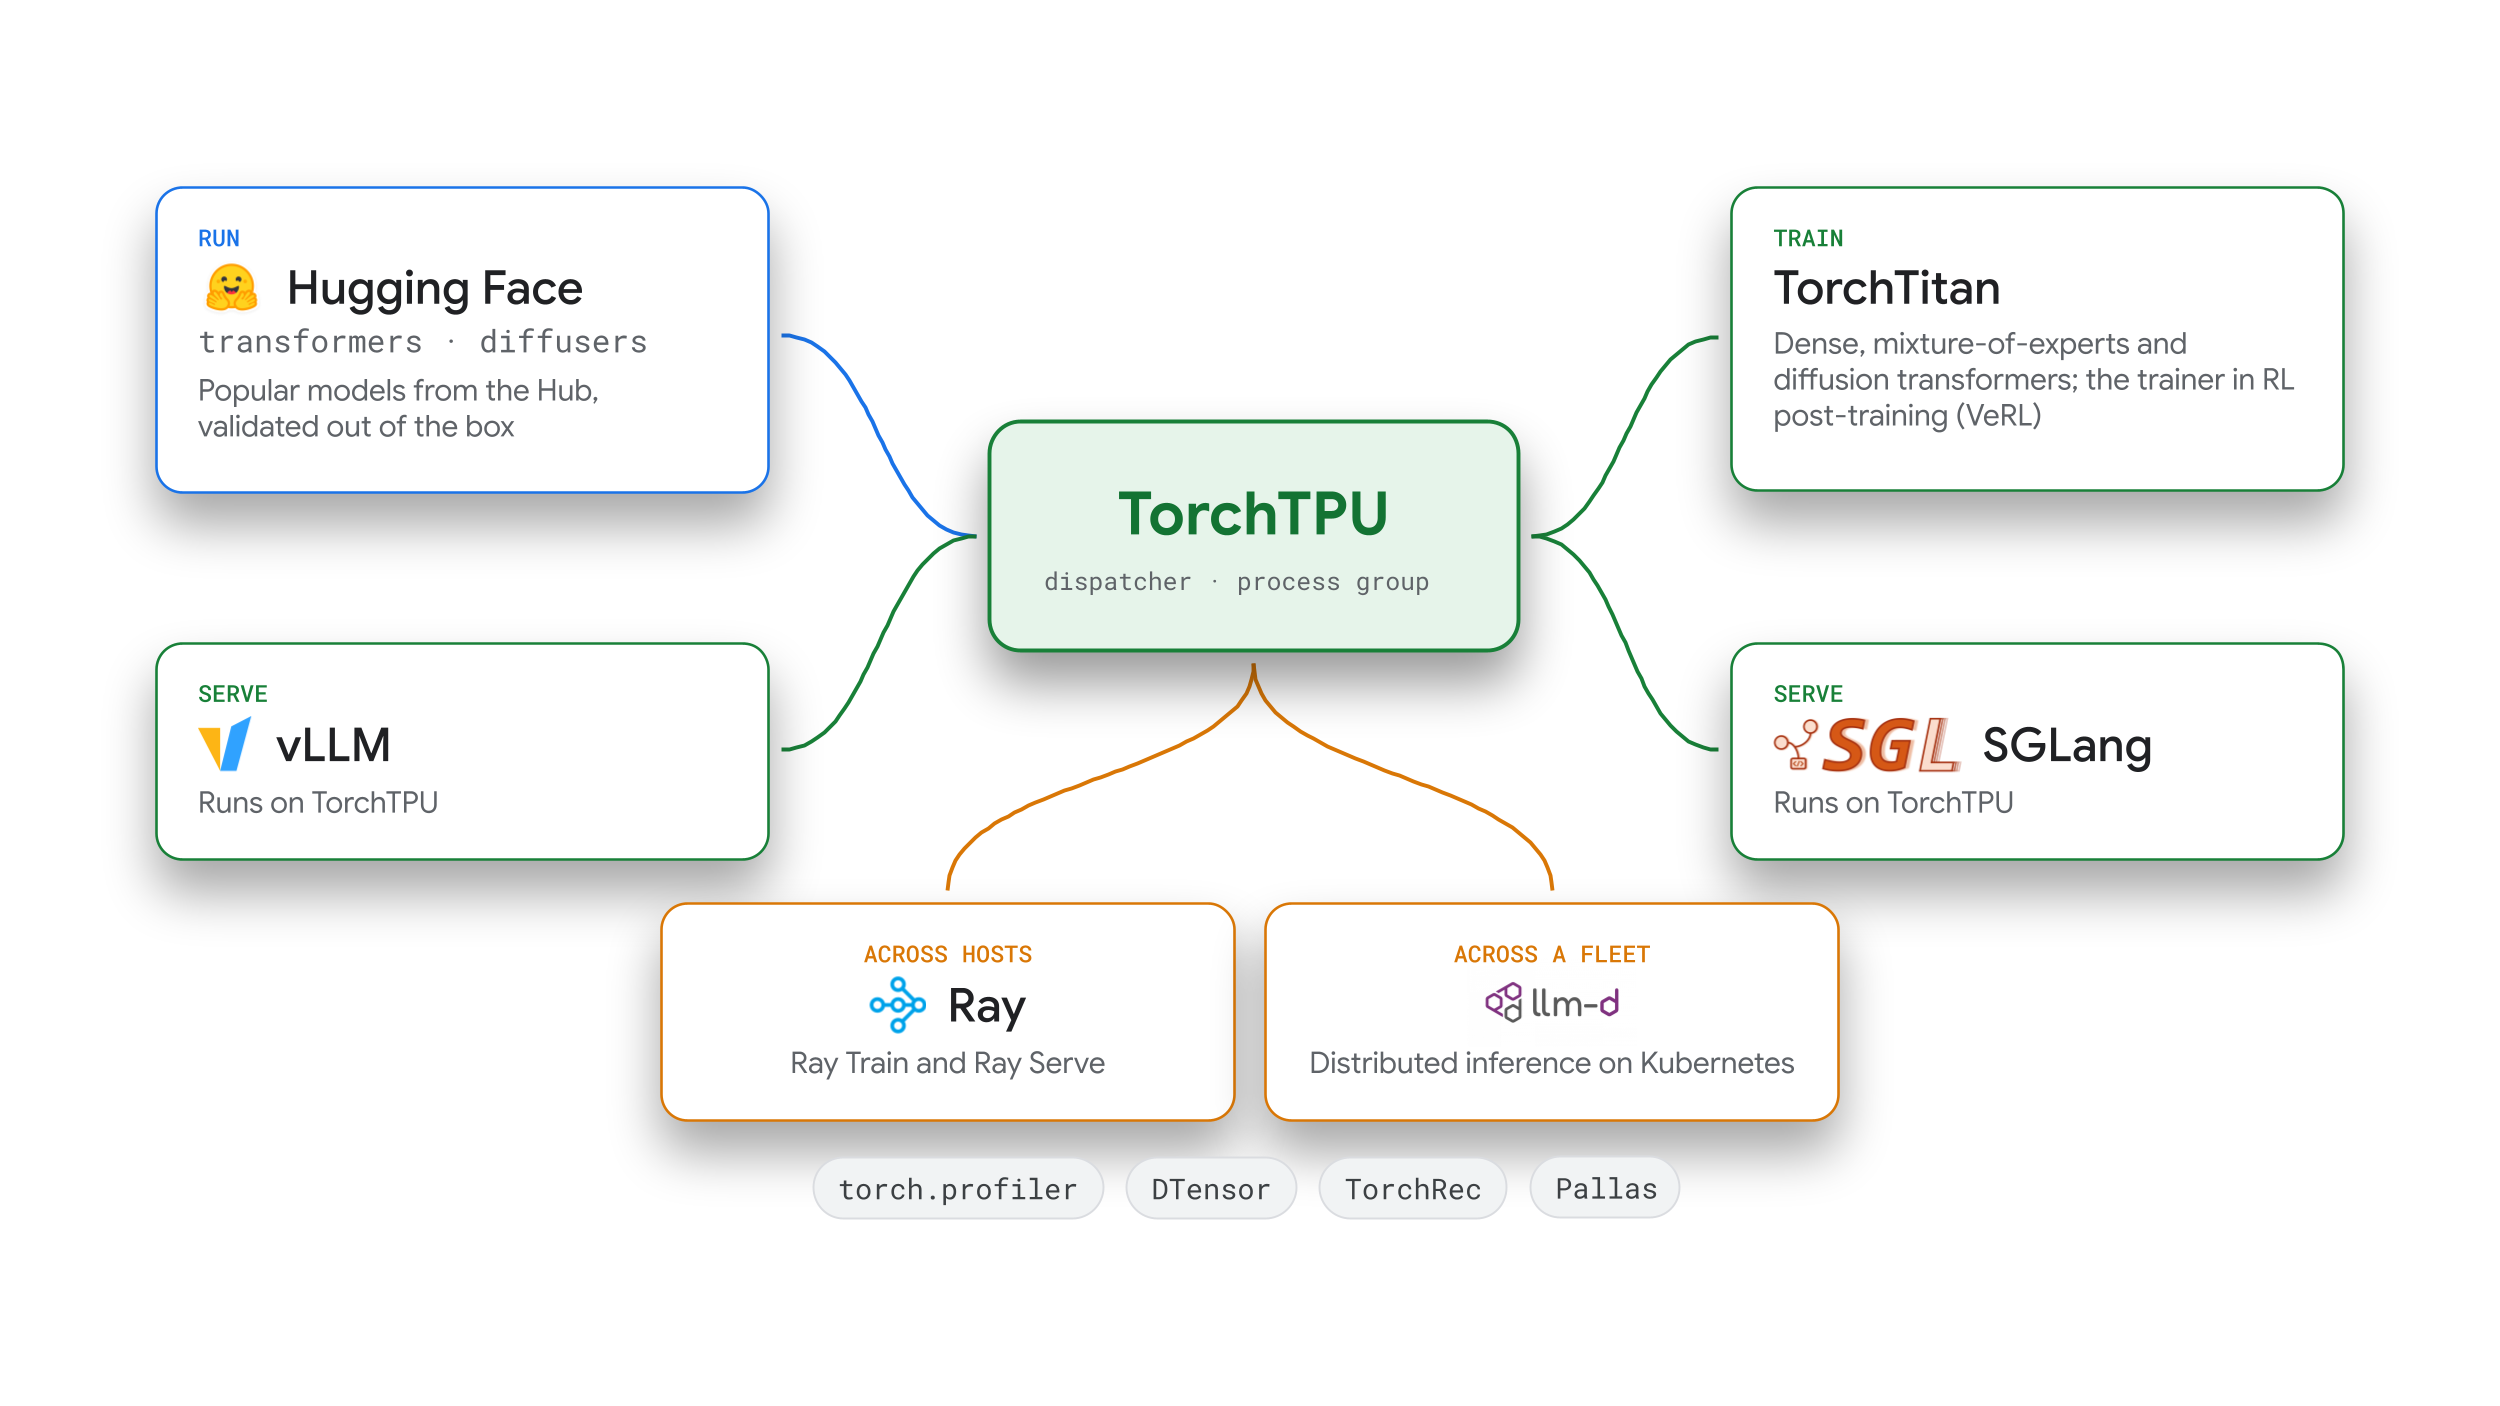
O PyTorch no Cloud TPU permite treinar, ajustar e disponibilizar modelos de código aberto no hardware do Cloud TPU usando a semântica padrão do PyTorch, APIs distribuídas e as ferramentas do ecossistema que você já usa, incluindo Hugging Face, vLLM, SGLang, llm-d, TorchTitan, TorchRec e Ray.
Na base da pilha está o TorchTPU, um back-end de código aberto nativo do PyTorch, desenvolvido em conjunto com a equipe do PyTorch na Meta. O TorchTPU oferece bibliotecas, frameworks e ferramentas para todas as etapas do ciclo de vida do machine learning, desde a execução do ambiente de execução principal e kernels personalizados até a inferência de produção, o treinamento em grande escala e a orquestração de clusters.
Primeiros passos
- Executar modelos do PyTorch em TPUs:comece com o TorchTPU e a documentação do TorchTPU.
- Disponibilizar LLMs e modelos multimodais:use vLLM-TorchTPU ou SGLang-TorchTPU.
- Rotear solicitações em uma frota do Kubernetes:use o llm-d.
- Pré-treinar ou ajustar modelos de fundação:use o TorchTitan na TPU (ou o TorchRec para modelos de recomendação).
- Escalone o processamento de dados, o treinamento, o RL e os pipelines de exibição: use o Ray.
- Integre, crie perfis e ajuste modelos com seu assistente de programação:use o TPU Agent Suite (pré-lançamento).
TorchTPU: back-end nativo do PyTorch para Cloud TPU
O TorchTPU fornece o back-end do dispositivo, a integração do compilador de gráficos e as APIs de kernel personalizadas para o PyTorch no Cloud TPU. Criado com a equipe do PyTorch, o TorchTPU permite depurar modelos
de forma interativa no modo eager, compilar o código do modelo com torch.compile e escalonar
em frações com torch.distributed (tpu_dist).
Para instalar o TorchTPU e executar uma operação de tensor em um Cloud TPU:
pip install torch_tpu
import torch

device = torch.device("tpu")

x = torch.randn((4, 4), device=device)
y = torch.ones((4, 4), device=device)
result = torch.matmul(x, y).cpu()

print(f"Executed on device: {x.device}")
print(f"Result shape on CPU: {result.shape}, sum: {result.sum():.4f}")
Motivação
Embora as Cloud TPUs tenham sido historicamente pareadas com o JAX e o TensorFlow, a execução do PyTorch em TPUs exigia anteriormente a gravação de gráficos de tensor lento (PyTorch/XLA), o que geralmente significava adicionar código para marcar regiões compiláveis. Por padrão, o TorchTPU executa operações de forma antecipada usando o modelo de execução padrão de um processo por dispositivo do PyTorch. Assim, as cargas de trabalho e as bibliotecas atuais são executadas sem reescritas estruturais.
Design
O TorchTPU oferece suporte nativo de TPU ao PyTorch com base em três objetivos de design:
- Semântica padrão do PyTorch: executa um processo por dispositivo e preserva as visualizações de tensor do PyTorch e as mutações no local sem uma dependência de ambiente de execução do JAX.
- Execução adiantada por padrão: os modelos padrão do PyTorch são executados imediatamente no modo adiantado para depuração interativa e inspeção detalhada.
- Otimizações de compilador e kernel: além da execução adiantada operador por operador,
o TorchTPU oferece fusão de operadores no modo adiantado,
integração de
torch.compilecom limites de forma dinâmicos para reduzir recompilações e APIs de kernel personalizadas.
Para a compilação de gráficos, o torch.compile captura o gráfico de computação do PyTorch
com o TorchDynamo e o compila em código de máquina da TPU usando o OpenXLA e o
StableHLO. As operações coletivas são executadas no nível do grupo de processos torch.distributed (tpu_dist).
Pontos fortes
- Suporte a operadores, modelos e Hugging Face: o TorchTPU é compatível com operadores
padrão do PyTorch (ATen) em passagens diretas e reversas e é continuamente
testado com modelos conhecidos do Hugging Face. É possível implantar modelos no
Transformers v5 transmitindo
device_map="tpu", executar pipelines de Diffusers com o modo adiantado,torch.compilee paralelismo de tensor, além de criar perfis de cargas de trabalho comtorch.profilerno TensorBoard e no XProf. - Escalonamento de chip único para várias frações: o back-end
tpu_disté compatível comDistributedDataParallel(DDP),FullyShardedDataParallel(FSDP2) eDTensor. Além disso, otorch.tpu.distributed.topology_aware_meshmapeia as dimensões de paralelismo nas interconexões físicas da TPU. - Modos de execução adiantada configuráveis: oferece três modos de execução adiantada:
Strict(padrão): despacha operadores de forma individual e assíncrona, com semântica imperativa padrão do PyTorch.Debug: é executado de forma síncrona com a verificação de limites de tensor.DeferAndFuse: combina sequências de operadores adiantados para reduzir o tráfego de memória de alta largura de banda (HBM, na sigla em inglês).
- Compilação e armazenamento em cache de gráficos completos: o
torch.compile(backend="tpu")compila gráficos em executáveis de TPU e os armazena em cache em processos, hosts e reinicializações de jobs. - Kernels de TPU personalizados: é possível chamar kernels do Pallas personalizados, incluindo kernels que se comunicam diretamente entre chips, como funções padrão do PyTorch, usar kernels pré-criados da biblioteca Tokamax ou criar kernels portáteis baseados em blocos com o Helion.
Para mais informações, consulte a documentação do TorchTPU, faça perguntas no fórum de discussão do PyTorch na TPU ou relate problemas no GitHub.
Inferência e disponibilização de Production
Para implantação de produção, o PyTorch no Cloud TPU se integra a mecanismos de inferência de código aberto e infraestrutura de exibição distribuída nativa do Kubernetes.
vLLM-TorchTPU e SGLang-TorchTPU: mecanismos de inferência
vLLM-TorchTPU e SGLang-TorchTPU são back-ends do TorchTPU para os mecanismos de inferência vLLM e SGLang. Os dois back-ends executam modelos abertos, como Qwen, DeepSeek, GLM, Kimi, GPT-OSS e Gemma 4. Para mais informações, leia a postagem do blog Anúncio de novos mecanismos de inferência vLLM e SGLang na TPU.
Motivação
A disponibilização de cargas de trabalho de raciocínio, multimodais e que usam ferramentas geralmente exige definições de modelo personalizadas, métodos de decodificação especulativa e esquemas de quantização. Criar os back-ends vLLM e SGLang no TorchTPU permite personalizar e depurar sua pilha de exibição diretamente no PyTorch.
Design
Os dois back-ends mantêm os programadores padrão do vLLM e do SGLang, os gerenciadores de cache de KV e os servidores de API, usando a execução do TorchTPU e os operadores personalizados do Pallas por baixo. A maioria dos modelos executa as definições padrão do PyTorch, enquanto os blocos com uso intensivo de computação invocam kernels do Pallas dentro do grafo compilado para que os kernels específicos do hardware possam ser atualizados de forma independente.
Pontos fortes
- Paralelismo, quantização e decodificação especulativa: oferece suporte ao paralelismo de tensores,
dados, especialistas, pipelines e contextos entre hosts, além de
entradas multimodais (imagem e vídeo) e de embedding. Os métodos de decodificação especulativa
compatíveis incluem previsão de vários tokens (MTP), EAGLE-3, DFlash,
DSpark e correspondência de n-gramas. Os formatos de quantização compatíveis incluem caches KV de 8 bits (
FP8) e checkpoints de modelo de usar pontos flutuantes de 8 bits (FP8) e 4 bits (MXFP4eNVFP4). - Armazenamento em cache de prefixo de dois níveis, chamada de ferramenta e saída estruturada: o armazenamento em cache automático de prefixos (incluindo para atenção híbrida e modelos recorrentes) retém prefixos ativos na HBM e descarrega prefixos mais antigos na memória do host para evitar a recomputação em solicitações de vários turnos. A chamada de ferramentas e a saída estruturada são integradas.
- Transferências de cache KV sobrepostas com o TPU Sync: oferece suporte à disponibilização desagregada de preenchimento prévio e decodificação (separando o processamento de comandos e a geração de tokens em pools de workers distintos) entre hosts e ao descarregamento de KV de host usando o TPU Sync. O TPU Sync é uma biblioteca C++ de código aberto que lê buffers de dispositivos PyTorch diretamente em linhas de execução em segundo plano, sem copiar dados pela memória da CPU do host.
Para mais informações sobre o vLLM-TorchTPU, consulte o repositório do vLLM-TorchTPU, faça perguntas no canal do Slack do vLLM ou informe problemas do vLLM-TorchTPU no GitHub.
Para mais informações sobre o SGLang-TorchTPU, consulte o repositório do SGLang-TorchTPU ou informe problemas do SGLang-TorchTPU no GitHub.
llm-d: inferência distribuída nativa do Kubernetes
O llm-d é um framework de sandbox de código aberto da Cloud Native Computing Foundation (CNCF) para inferência de LLM distribuída no Kubernetes, desenvolvido com a Red Hat, a IBM, o Google Cloude uma comunidade de mais de 500 colaboradores e 35 organizações.
Motivação
Enquanto os mecanismos de inferência de instância única gerenciam a execução por réplica, as frotas de produção precisam lidar com picos de tráfego, prioridades de vários locatários, compartilhamento de contexto em toda a frota e lançamentos sem inatividade. O llm-d fornece a camada de roteamento e operações no nível do cluster para coordenar uma frota de servidores de inferência.
Design
O llm-d é executado na frente de servidores de modelos, como vLLM e SGLang, no Kubernetes. O llm-d oferece o seguinte:
- Encaminha solicitações com base no estado do cache de prefixo e na carga da réplica.
- Coordena pools de workers de pré-preenchimento e decodificação desagregados.
- Oferece suporte à fragmentação de MoE e à inferência em lote assíncrona.
- Gerencia o descarregamento em camadas do cache de chave-valor na memória do dispositivo, na memória do host e no armazenamento.
Pontos fortes
- Roteamento de sessão multiturno: encaminha conversas multiturno para réplicas que mantêm o contexto em cache. A programação com prioridade de turno e o suporte à API Stateful Responses permitem que os agentes reutilizem o contexto entre os turnos para reduzir o recálculo.
- Qualidade de serviço multilocatário: o controle de fluxo de prioridade e imparcialidade permite que solicitações sensíveis à latência e cargas de trabalho de agentes em lote compartilhem uma frota sem escassez de recursos.
- Operações de frota e atualizações graduais: fornece uma API de configuração v1, alta disponibilidade do roteador e atualizações graduais coordenadas que gerenciam réplicas de preenchimento prévio e decodificação como uma única unidade lógica.
- Disponibilização nativa do TorchTPU no GKE: é possível disponibilizar Cloud TPUs com outros aceleradores por trás de um endpoint llm-d e gerenciar réplicas do vLLM-TorchTPU e do SGLang-TorchTPU com as ferramentas padrão do Kubernetes.
Para mais informações, faça perguntas no canal do Slack llm-d ou relate problemas no GitHub.
Bibliotecas de treinamento, ajuste e domínio
Para pré-treinar, ajustar e adaptar modelos grandes, o TorchTPU oferece receitas de treinamento de referência e bibliotecas específicas de domínio ajustadas para hardware de TPU.
TorchTitan na TPU: referência de treinamento em grande escala
O TorchTitan na TPU estende o TorchTitan, a plataforma de referência modular do PyTorch para treinamento de IA generativa, com transmissões de fragmentação de TPU, kernels personalizados e receitas de treinamento. Para mais informações, leia a postagem do blog Como integrar o TorchTPU ao TorchTitan e otimizar modelos para TPU.
Motivação
Para escalonar o treinamento em frações de TPU de vários hosts, é necessário fragmentar parâmetros na interconexão de chips e sobrepor a comunicação com a computação. O Google e a Meta desenvolveram em conjunto a fragmentação de TPU e as passagens de compilação no TorchTitan para que você não precise projetar estratégias personalizadas de fragmentação de TPU ou programar manualmente a comunicação.
Design
Os modelos são escritos em PyTorch de dispositivo único sem código específico do acelerador. O TorchTitan configura as camadas do modelo usando arquivos de configuração, permitindo que você substitua camadas individuais por kernels personalizados do Pallas (como o Splash Attention) sem editar a definição do modelo ou o loop de treinamento.
A implementação de SimpleFSDP do TorchTitan coloca operações de fragmentação de parâmetros
diretamente dentro do grafo compilado para que o compilador XLA possa sobrepor a comunicação
do dispositivo com a computação, enquanto a compilação de grafo de etapa inteira captura toda
a etapa de treinamento como um único programa XLA. Para execuções de várias frações, a fragmentação híbrida (HSDP) fragmenta cada fração pela interconexão entre chips (ICI) e replica entre frações pela rede do data center (DCN). Esse layout
limita o tráfego entre frações a uma única redução de gradiente por etapa.
Pontos fortes
- Receitas de pré-treinamento e pós-treinamento de RL: inclui receitas de referência para LLMs densos (Llama 3, Qwen 3 e MuseGlimmer 30B), modelos de mistura de especialistas (MoE) (Qwen 3 235B, validado em até 8.192 chips TPU7x) e transformadores de difusão (FLUX.1). Para o pós-treinamento de RL (como a otimização de política relativa de grupo, ou GRPO), o VeRL (pré-lançamento) delega atualizações de parâmetros ao TorchTitan e envia pesos atualizados para os mecanismos de exibição para gerar trajetórias de treinamento (rollouts).
- Configurações pré-configuradas de compilador e paralelismo: as configurações de receita incluem configurações pré-configuradas de compilador e paralelismo para que você possa ajustar a utilização de FLOPs do modelo (MFU) por meio de arquivos de configuração, em vez de mudanças no código.
- Integração para novas arquiteturas: o back-end de modelagem do Hugging Face Transformers executa checkpoints de modelo do Hugging Face Hub (incluindo modelos de MoE sem paralelismo de especialistas) pelo treinador TorchTitan. Para portas de modelo completas, o TorchTitan inclui uma habilidade de integração detalhada para engenheiros e agentes de programação.
- Reutilização de componentes independentes: é possível adotar o TorchTitan de ponta a ponta ou importar módulos individuais, operadores personalizados e flags do compilador para uma base de código de treinamento existente.
Para mais informações, consulte o guia de iniciação do TorchTitan na TPU, tire dúvidas no fórum de discussão do PyTorch ou informe problemas no GitHub.
TorchRec: sistemas de recomendação
O TorchRec é uma biblioteca de domínio do PyTorch que fornece tabelas de embedding distribuídas e primitivas de fragmentação para modelos de recomendação. No Cloud TPU, o TorchRec transfere as pesquisas de tabelas de embedding esparsas para processadores SparseCore dedicados da TPU, enquanto executa operações de matriz densa nos TensorCores da TPU.
Para mais informações sobre o TorchRec, consulte a documentação do TorchRec, tire dúvidas no fórum de discussão do PyTorch na TPU ou informe problemas no GitHub.
Orquestração de clusters e ferramentas para desenvolvedores
Para escalonar pipelines de vários nós e automatizar a integração de modelos, o ecossistema TorchTPU se integra ao Ray e fornece extensões de agente de programação com acesso à documentação da TPU.
Ray: treinamento, disponibilização e RL distribuídos
O Ray escalona cargas de trabalho de Python e IA em clusters usando o Ray Train, o Ray Serve, o Ray Data, o Ray Core e frameworks de RL, como o verl.
Motivação
O treinamento de várias frações e os pipelines de vários estágios (como fluxos de trabalho de RL
que combinam pré-processamento de dados, treinamento e geração de lançamento) exigem
provisionamento automatizado de frações, descoberta de topologia e coordenação de workers
tolerante a falhas. Utilitários de inicialização independentes, como torchrun, não provisionam frações de TPU nem coordenam pipelines de atores de vários estágios. Portanto, o Ray gerencia a programação e o posicionamento em todo o cluster para cargas de trabalho do TorchTPU.
Design
Quando você envia um job especificando a geração, a topologia e a contagem de workers da TPU,
o Ray reserva frações completas de TPU para que todos os workers em uma fração sejam programados
juntos, descobre os endereços de interconexão de chips e inicia um worker do PyTorch
por dispositivo de TPU. O back-end do PyTorch do Ray Train inicializa o dispositivo tpu
e o grupo de processos tpu_dist automaticamente antes de iniciar o job.
Pontos fortes
- Posicionamento correspondente à topologia: corresponde o posicionamento do worker entre os hosts à geração física da TPU e ao layout da fração.
- Recuperação automática de falhas: executa jobs de treinamento distribuídos em várias frações de TPU no GKE com recuperação automática quando um worker ou uma fração falha.
- Pré-busca de dados direta para TPU: o método
iter_torch_batchesdo Ray Data pré-busca lotes como tensores do PyTorch diretamente na memória do dispositivo TPU. - Orquestração de inferência de vários hosts: gerencia implantações de exibição de vários hosts para vLLM-TorchTPU e SGLang-TorchTPU.
TPU Agent Suite: (pré-lançamento) agentes de programação para TPU
O TPU Agent Suite é uma extensão de código aberto para assistência de programação, incluindo o Claude Code e o Google Antigravity, com mais agentes de programação a seguir, focada na inferência de transformadores (LLMs densos e modelos MoE) na TPU v6e e na TPU7x.
Motivação
Os assistentes de programação de uso geral geralmente não têm contexto atual sobre topologias de hardware de TPU, flags do compilador XLA, telemetria do XProf e restrições do kernel do Pallas. O TPU Agent Suite dá ao assistente acesso à documentação oficial da TPU e a fluxos de trabalho estruturados. Isso ajuda a evitar sugestões de sinalização inválidas e automatiza a criação de perfis e o comparativo de mercado iterativos.
Design
O pacote adiciona uma base de conhecimento de TPU e seis subagentes específicos para tarefas ao seu assistente de programação atual. Um agente de roteamento delega cada comando ao subagente apropriado sem executar comandos. Qualquer execução de comando na VM de TPU ou no cluster do GKE requer sua aprovação, e os loops de ajuste executam um número limitado de tentativas registradas antes de retornar resultados.
Pontos fortes
- Integração de modelos e verificação de acurácia: o agente de integração de modelos de TPU resolve operadores sem suporte, seleciona um caminho de exibição (vLLM-TorchTPU ou PyTorch padrão) e compara as saídas camada por camada com o modelo de referência da CPU para verificar a acurácia numérica.
- Diagnóstico de falhas e gargalos: o agente de diagnóstico de TPU analisa registros de falhas, inspeciona perfis do XProf e traces do compilador XLA e isola gargalos de ambiente de execução.
- Otimização de kernel, compilador e fragmentação: o agente de desenvolvimento de kernel da TPU ajuda com kernels personalizados do Pallas, o agente de otimização de desempenho da TPU compara combinações de sinalizações do compilador XLA, e o agente de fragmentação da TPU planeja layouts de paralelismo de várias frações.
- Pesquisa de documentação com citações: o agente da base de conhecimento da TPU responde a perguntas técnicas com citações explícitas da documentação e dos tutoriais oficiais da TPU e informa quando um tópico não é abordado.
Para mais informações, consulte a documentação do TPU Agent Suite, compartilhe feedback e faça perguntas nas discussões do GitHub ou informe problemas no GitHub.
A seguir
- Comece a usar a documentação do TorchTPU.
- Teste as receitas do TorchTitan na TPU.
- Implante cargas de trabalho de inferência com vLLM-TorchTPU e SGLang-TorchTPU.
- Faça perguntas no fórum de discussão do PyTorch na TPU.
- Para discutir um caso de uso específico com a equipe de produtos e engenharia do Google, envie um e-mail para torchtpu-feedback@google.com.