


Auf dieser Seite wird erläutert, wie die Architektur von Memorystore for Valkey Hochverfügbarkeit (High Availability, HA) bietet und unterstützt. Auf dieser Seite wird auch beschrieben, wie Sie die Leistung und Stabilität von Instanzen mit von uns empfohlenen HA-Konfigurationen verbessern können.
Hochverfügbarkeit
Memorystore for Valkey basiert auf einer hochverfügbaren Architektur, in der Ihre Clients direkt auf verwaltete Memorystore for Valkey-Knoten zugreifen. Ihre Clients stellen dazu eine Verbindung zu einzelnen Endpunkten her, wie unter Verbindung zu einer Memorystore for Valkey-Instanz herstellen beschrieben.
Die direkte Verbindung zu Shards bietet folgende Vorteile:
Durch die direkte Verbindung werden Zwischen-Hops vermieden, wodurch die Umlaufzeit (Clientlatenz) zwischen Ihrem Client und dem Memorystore for Valkey-Knoten minimiert wird.
Wenn der Clustermodus aktiviert ist, wird durch die direkte Verbindung ein Single Point of Failure vermieden, da jeder Shard so konzipiert ist, dass er unabhängig ausfällt. Wenn beispielsweise der Traffic von mehreren Clients einen Slot (Keyspace-Chunk) überlastet, wird die Auswirkung durch den Shard-Fehler auf den Shard begrenzt, der für die Bereitstellung des Slots verantwortlich ist.
Empfohlene Konfigurationen
Wir empfehlen, hochverfügbare Instanzen mit mehreren Zonen anstelle von Instanzen mit einer einzelnen Zone zu erstellen, da sie eine höhere Zuverlässigkeit bieten. Wenn Sie jedoch eine Instanz ohne Replikate bereitstellen, empfehlen wir, eine Einzelzoneninstanz auszuwählen. Weitere Informationen finden Sie unter Wann sollte eine Einzelzoneninstanz verwendet werden?
Wenn Sie Hochverfügbarkeit für Ihre Instanz aktivieren möchten, müssen Sie für jeden Shard mindestens ein Replikat bereitstellen. Das können Sie beim Erstellen der Instanz tun oder Sie können die Anzahl der Replikate auf mindestens 1 Replikat pro Shard skalieren. Replikate bieten automatisches Failover bei geplanter Wartung und unerwarteten Shard-Fehlern.
Wir empfehlen, Ihren Client gemäß den Best Practices für Clients zu konfigurieren. Wenn Sie die empfohlenen Best Practices verwenden, kann Ihr Kunde die folgenden Elemente für Ihre Instanz automatisch und ohne Ausfallzeiten verwalten:
- Die Rolle (automatische Failovers)
- Der Endpunkt (Knotenersetzung)
- Änderungen bei der Slotzuweisung im Zusammenhang mit dem aktivierten Clustermodus (horizontales Skalieren für Nutzer)
Replikate
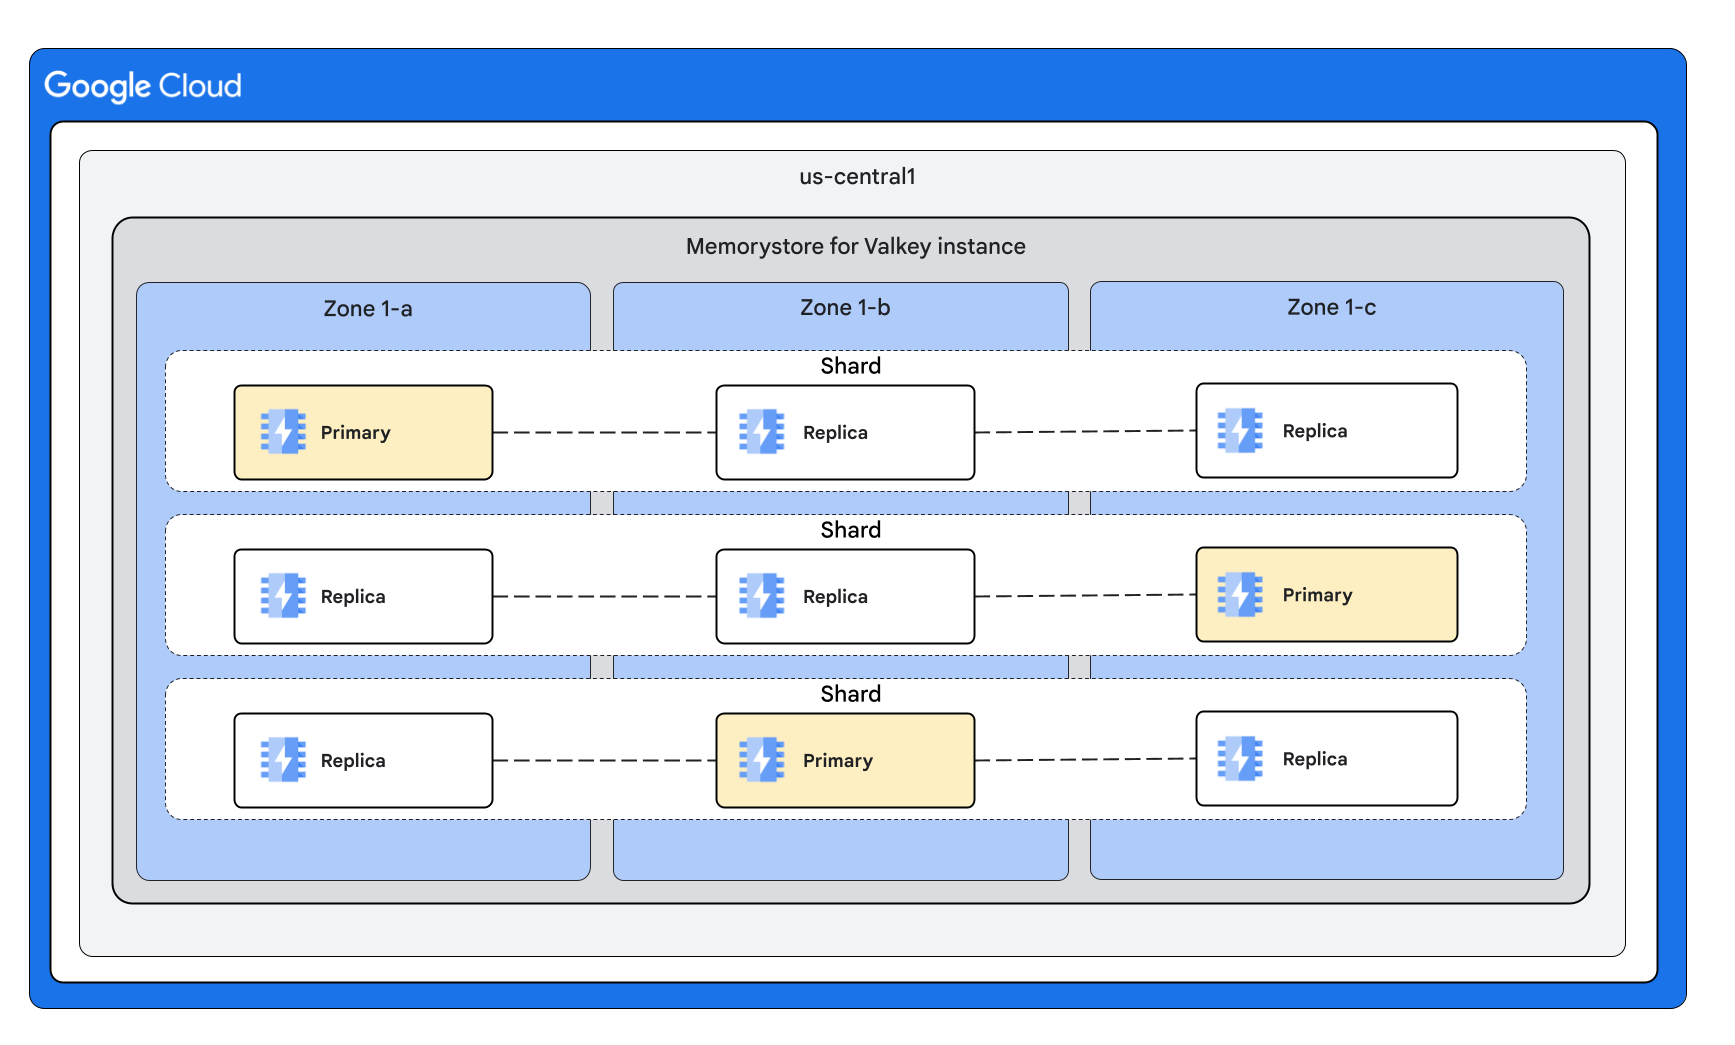
Eine hochverfügbare Memorystore for Valkey-Instanz ist eine regionale Ressource. Bei Memorystore for Valkey werden die primären und Replikat-VMs von Shards auf mehrere Zonen verteilt, um vor einem zonalen Ausfall zu schützen. Memorystore for Valkey unterstützt Instanzen mit 0 bis 5 Replikaten pro Shard.
Mit Replikaten können Sie den Lesedurchsatz erhöhen, allerdings kann es dadurch zu veralteten Daten kommen.
- Clustermodus aktiviert:Verwenden Sie den Befehl
READONLY, um eine Verbindung herzustellen, über die Ihr Client Daten von Replikaten lesen kann. - Clustermodus deaktiviert:Stellen Sie eine Verbindung zum Reader-Endpunkt her, um eine Verbindung zu einer der verfügbaren Replikate herzustellen.
Beispiele für Instanzen mit aktiviertem Clustermodus
Die folgenden Diagramme zeigen Beispiele für Instanzen mit aktiviertem Clustermodus:
Beispiel für eine Instanz mit drei Shards und null Replikaten pro Shard

Beispiel für eine Instanz mit drei Shards und einem Replikat pro Shard

Beispiel für eine Instanz mit drei Shards und mehreren Replikaten pro Shard
Beispiele für Instanzen mit deaktiviertem Clustermodus
Das folgende Diagramm zeigt ein Beispiel für Instanzen mit deaktiviertem Clustermodus:
Beispiel für eine Instanz mit mehreren Replikaten

Automatischen Failover
Automatische Failover innerhalb eines Shards können aufgrund von Wartungsarbeiten oder eines unerwarteten Ausfalls des primären Knotens auftreten. Während eines Failovers wird ein Replikat zum primären Replikat hochgestuft. Sie können Replikate explizit konfigurieren. Der Dienst kann während der internen Wartung auch vorübergehend zusätzliche Replikate bereitstellen, um Ausfallzeiten zu vermeiden.
Automatische Failovers verhindern Datenverlust während Wartungsupdates. Weitere Informationen zum automatischen Failover-Verhalten während der Wartung finden Sie unter Automatisches Failover-Verhalten während der Wartung.
Failover- und Knotenreparaturdauer
Automatische Failovers können bei ungeplanten Ereignissen wie einem Absturz des primären Knotenprozesses oder einem Hardwarefehler mehrere zehn Sekunden dauern. Während dieser Zeit erkennt das System den Fehler und wählt ein Replikat als neue primäre Instanz aus.
Die Reparatur von Knoten kann einige Minuten dauern, bis der Dienst den ausgefallenen Knoten ersetzt. Das gilt für alle primären Knoten und Replikatknoten. Bei Instanzen, die nicht hochverfügbar sind (keine Replikate bereitgestellt), dauert die Reparatur eines ausgefallenen primären Knotens ebenfalls einige Minuten.
Clientverhalten bei einem ungeplanten Failover
Clientverbindungen werden je nach Art des Fehlers wahrscheinlich zurückgesetzt. Nach der automatischen Wiederherstellung können Sie Ihre Verbindungen mit exponentiellem Backoff noch einmal versuchen, um eine Überlastung der primären und Replikatknoten zu vermeiden.
Bei Clients, die Replikate für den Lesedurchsatz verwenden, kann es zu einer vorübergehenden Verringerung der Kapazität kommen, bis der ausgefallene Knoten automatisch ersetzt wird.
Verlorene Schreibvorgänge
Bei einem Failover aufgrund eines unerwarteten Fehlers können bestätigte Schreibvorgänge aufgrund der asynchronen Natur des Valkey-Replikationsprotokolls verloren gehen.
Clientanwendungen können den WAIT-Befehl von Valkey nutzen, um die Datensicherheit in der Praxis zu verbessern.
Auswirkungen eines Ausfalls einer einzelnen Zone auf den Keyspace
In diesem Abschnitt wird beschrieben, wie sich ein Ausfall einer einzelnen Zone auf eine Memorystore for Valkey-Instanz auswirkt.
Instanzen in mehreren Zonen
HA-Instanzen:Wenn eine Zone ausfällt, ist der gesamte Keyspace für Lese- und Schreibvorgänge verfügbar. Da jedoch einige Lesereplikate nicht verfügbar sind, wird die Lesekapazität reduziert. Wir empfehlen dringend, die Clusterkapazität so zu überdimensionieren, dass die Instanz im seltenen Fall eines Ausfalls einer einzelnen Zone genügend Lesekapazität hat. Sobald der Ausfall behoben ist, werden die Replikate in der betroffenen Zone wiederhergestellt und die Lesekapazität des Clusters kehrt zum konfigurierten Wert zurück. Weitere Informationen finden Sie unter Muster für skalierbare und zuverlässige Anwendungen.
Nicht HA-Instanzen (keine Replikate): Wenn eine Zone ausfällt, werden die Daten des Teils des Keyspace, der in der betroffenen Zone bereitgestellt wird, geleert und sind während des Ausfalls nicht für Schreib- oder Lesevorgänge verfügbar. Sobald der Ausfall behoben ist, werden die primären Instanzen in der betroffenen Zone wiederhergestellt und die Kapazität des Clusters erreicht wieder den konfigurierten Wert.
Single-Zone-Instanzen
- Instanzen mit und ohne Hochverfügbarkeit:Wenn die Zone, in der die Instanz bereitgestellt wird, ausfällt, ist der Cluster nicht verfügbar und die Daten werden geleert. Wenn eine andere Zone ausfällt, verarbeitet der Cluster weiterhin Lese- und Schreibanfragen.
Best Practices
In diesem Abschnitt werden Best Practices für Hochverfügbarkeit und Replikate beschrieben.
Replikat hinzufügen
Zum Hinzufügen eines Replikats ist ein RDB-Snapshot erforderlich. Bei RDB-Snapshots wird ein Prozess-Fork und ein Copy-on-Write-Mechanismus verwendet, um einen Snapshot der Knotendaten zu erstellen. Je nach Muster der Schreibvorgänge für Knoten wächst der verwendete Arbeitsspeicher der Knoten, da Seiten, die von den Schreibvorgängen betroffen sind, kopiert werden. Der Speicherbedarf kann bis zu doppelt so groß sein wie die Daten im Knoten.
Damit Knoten genügend Arbeitsspeicher für die Erstellung des Snapshots haben, sollte maxmemory bei 80% der Knotenkapazität liegen, sodass 20% für den Overhead reserviert sind. Dieser Arbeitsspeicher-Overhead hilft Ihnen zusätzlich zu den Überwachungssnapshots, Ihre Arbeitslast so zu verwalten, dass Snapshots erfolgreich erstellt werden. Wenn Sie Replikate hinzufügen, sollten Sie den Schreibtraffic so weit wie möglich reduzieren. Weitere Informationen finden Sie unter Arbeitsspeichernutzung einer Instanz überwachen.