


Auf dieser Seite wird erläutert, wie die Architektur von Memorystore for Redis Cluster Hochverfügbarkeit (High Availability, HA) bietet und unterstützt. Auf dieser Seite wird auch erläutert, wie Sie die Leistung und Stabilität von Clustern mit von uns empfohlenen HA-Konfigurationen verbessern können.
Weitere Informationen zu regionsspezifischen Aspekten finden Sie unter Geografie und Regionen
Hochverfügbarkeit
Memorystore for Redis Cluster basiert auf einer hochverfügbaren Architektur, in der Ihre Clients direkt auf verwaltete Memorystore for Redis Cluster-VMs zugreifen. Ihre Clients stellen dazu eine Verbindung zu den einzelnen Shard-Netzwerkadressen her, wie unter Verbindung zu einer Memorystore for Redis-Clusterinstanz herstellen beschrieben.
Die direkte Verbindung zu Shards bietet folgende Vorteile:
Durch die direkte Verbindung wird ein Single Point of Failure vermieden, da jeder Shard so konzipiert ist, dass er unabhängig ausfällt. Wenn beispielsweise der Traffic von mehreren Clients einen Slot (Keyspace-Chunk) überlastet, wird durch einen Shard-Fehler die Auswirkung auf den Shard begrenzt, der für die Bereitstellung des Slots verantwortlich ist.
Durch die direkte Verbindung werden Zwischen-Hops vermieden, wodurch die Umlaufzeit (Clientlatenz) zwischen Ihrem Client und der Redis-VM minimiert wird.
Empfohlene Konfigurationen
Wir empfehlen, hochverfügbare Multi-Zone-Instanzen anstelle von Single-Zone-Instanzen zu erstellen, da sie eine höhere Zuverlässigkeit bieten. Wenn Sie jedoch eine Instanz ohne Replikate bereitstellen möchten, empfehlen wir, eine Instanz mit einer einzelnen Zone auszuwählen. Weitere Informationen finden Sie unter Wann sollte ein Cluster mit einer Zone verwendet werden?
Wenn Sie Hochverfügbarkeit für Ihre Instanz aktivieren möchten, müssen Sie für jeden Shard mindestens ein Replikat bereitstellen. Das können Sie beim Erstellen der Instanz tun oder Sie können die Anzahl der Replikate auf mindestens 1 Replikat pro Shard skalieren. Replikate bieten automatisches Failover bei geplanter Wartung und unerwarteten Shard-Fehlern.
Wir empfehlen, Ihren Client gemäß den Best Practices für Redis-Clients zu konfigurieren. Wenn Sie die empfohlenen Best Practices verwenden, kann Ihr OSS-Redis-Client die Rollen (automatische Failover) und Änderungen bei der Slotzuweisung (Knotenaustausch, horizontales Skalieren von Consumern) für Ihren Cluster automatisch und reibungslos ohne Ausfallzeiten verarbeiten.
Replikate
Eine hochverfügbare Memorystore for Redis Cluster-Instanz ist eine regionale Ressource. Das bedeutet, dass die primären und die Replikat-VMs von Shards auf mehrere Zonen verteilt werden, um sich vor einem zonenbezogenen Ausfall zu schützen. Memorystore for Redis Cluster unterstützt Instanzen mit 0 bis 5 Replikaten pro Shard.
Mit Replikaten können Sie den Lesedurchsatz durch Skalieren von Lesevorgängen erhöhen.
Dazu müssen Sie mit dem Befehl READONLY eine Verbindung herstellen, über die Ihr Client Daten aus Replikaten lesen kann. Weitere Informationen zum Lesen von Replikaten finden Sie unter Mit Redis-Cluster skalieren.
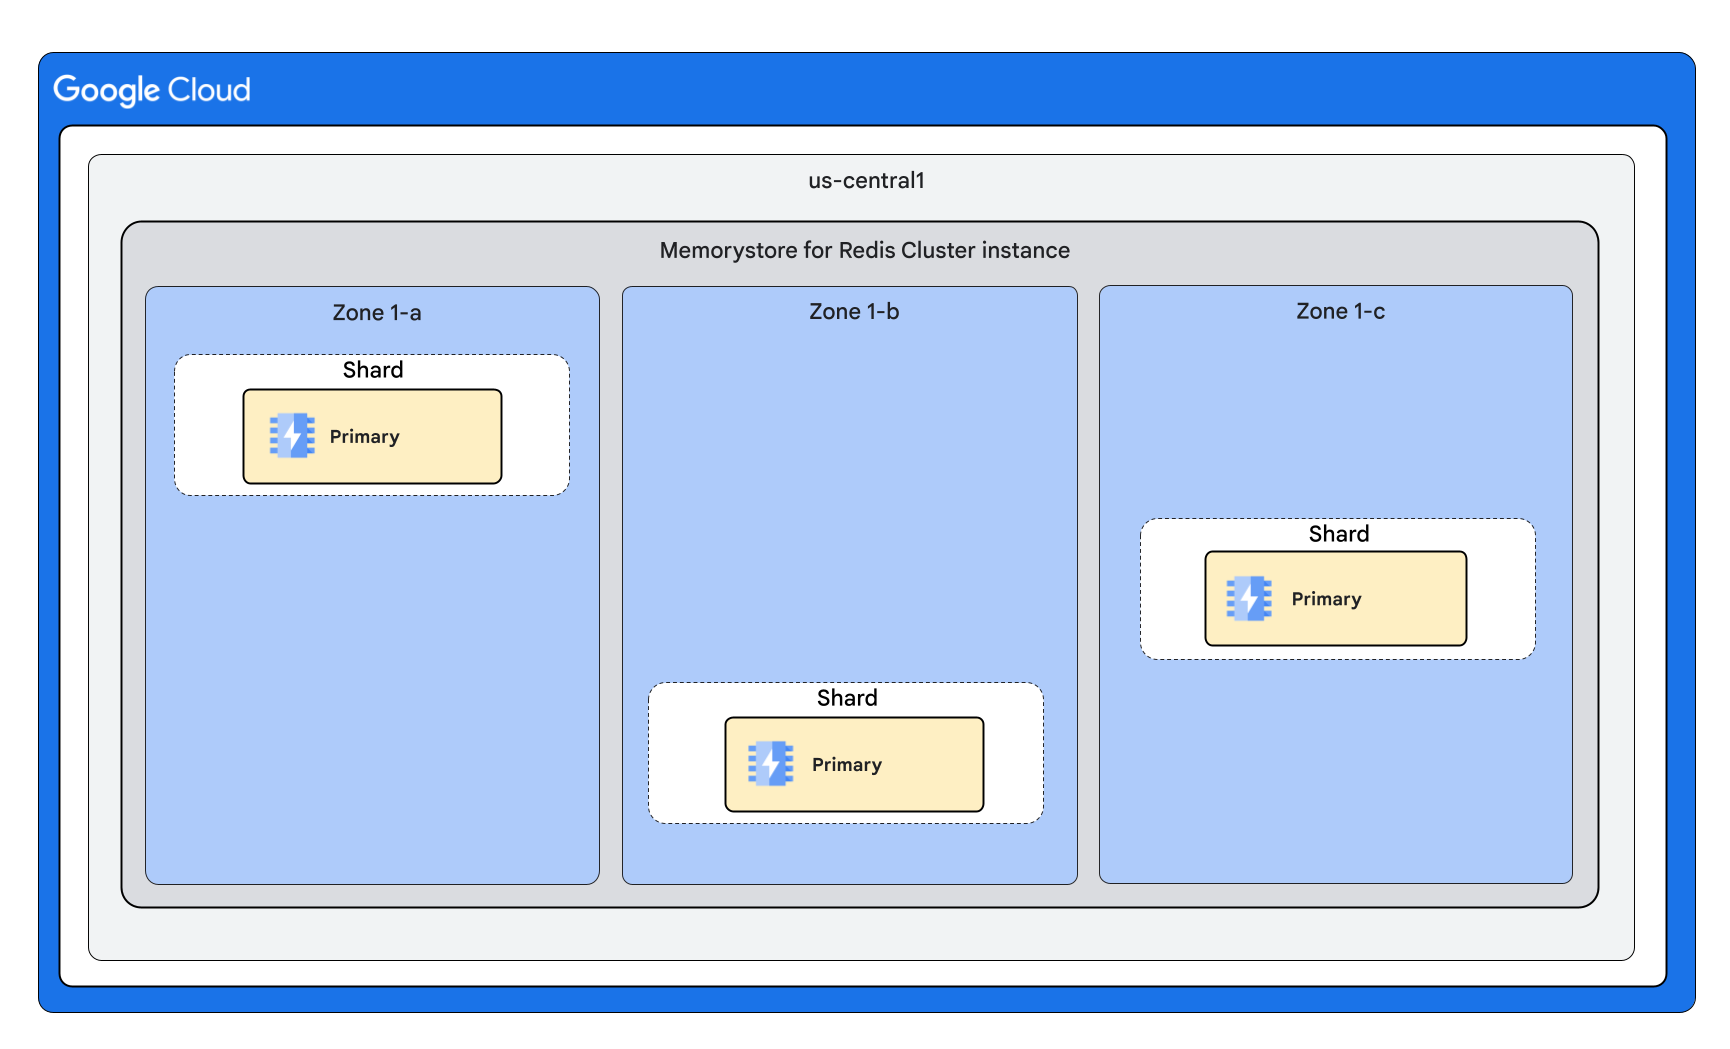
Clusterbeispiel mit 0 Replikaten pro Shard
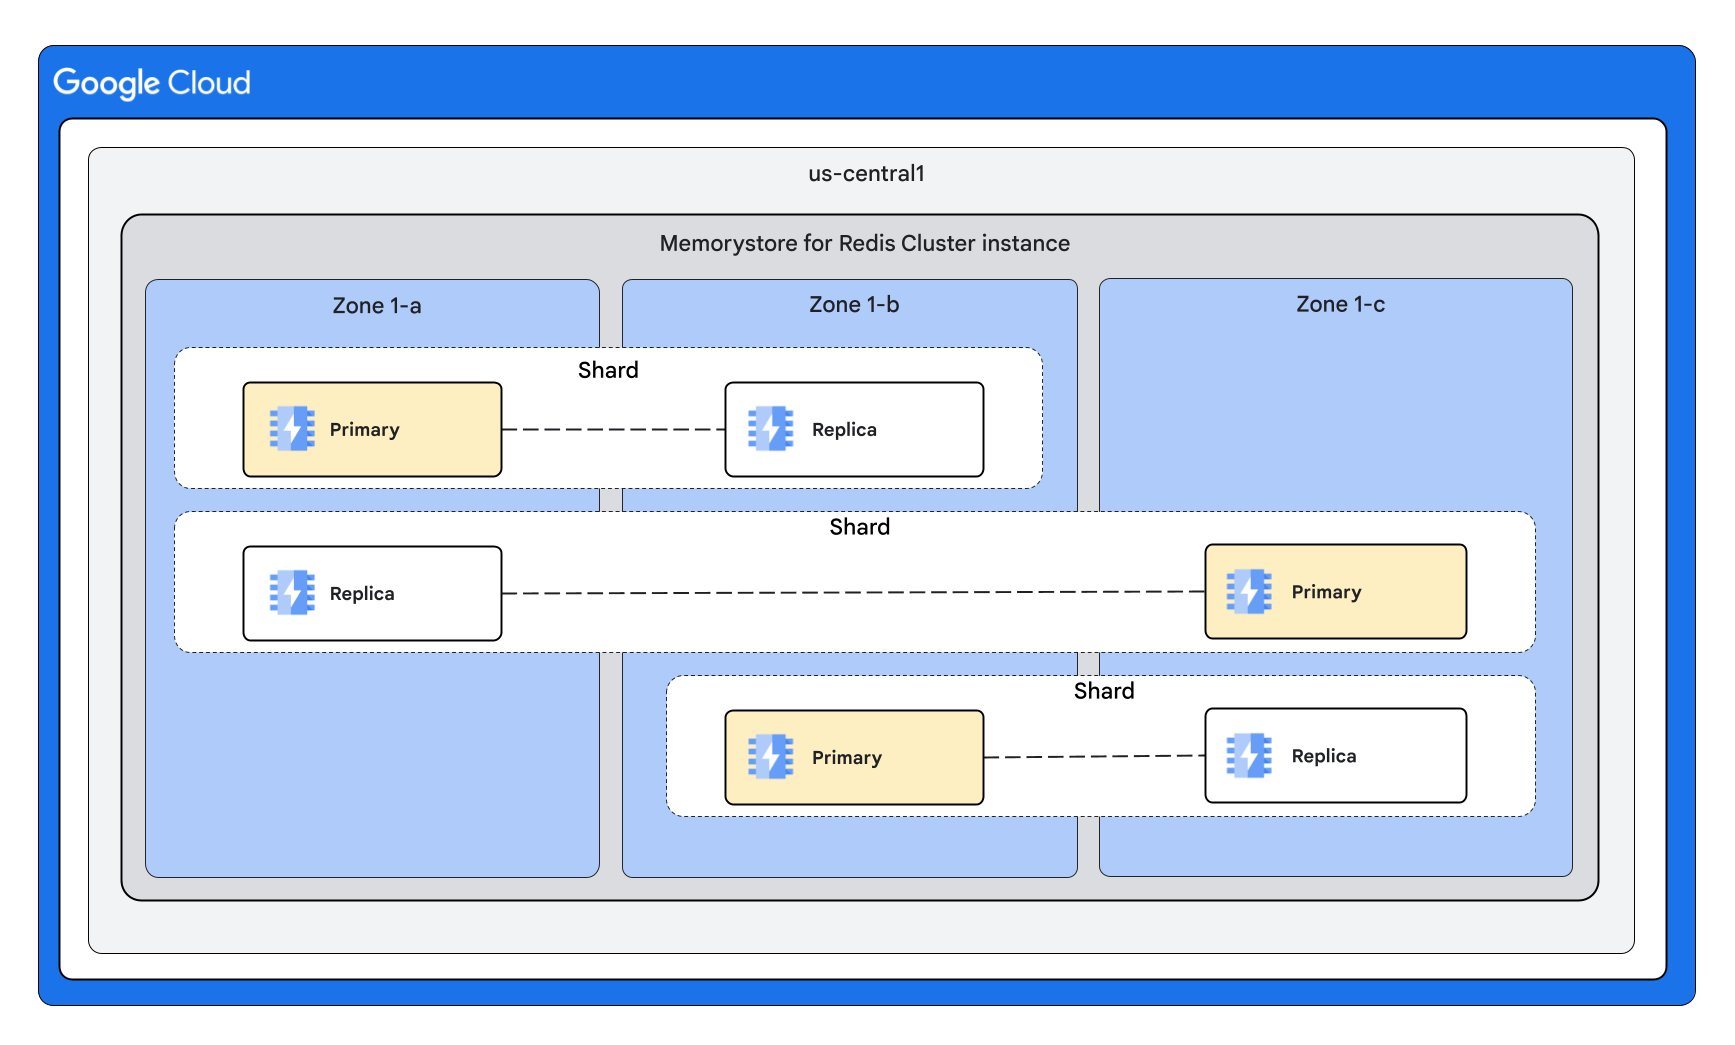
Clusterbeispiel mit 1 Replikat pro Shard
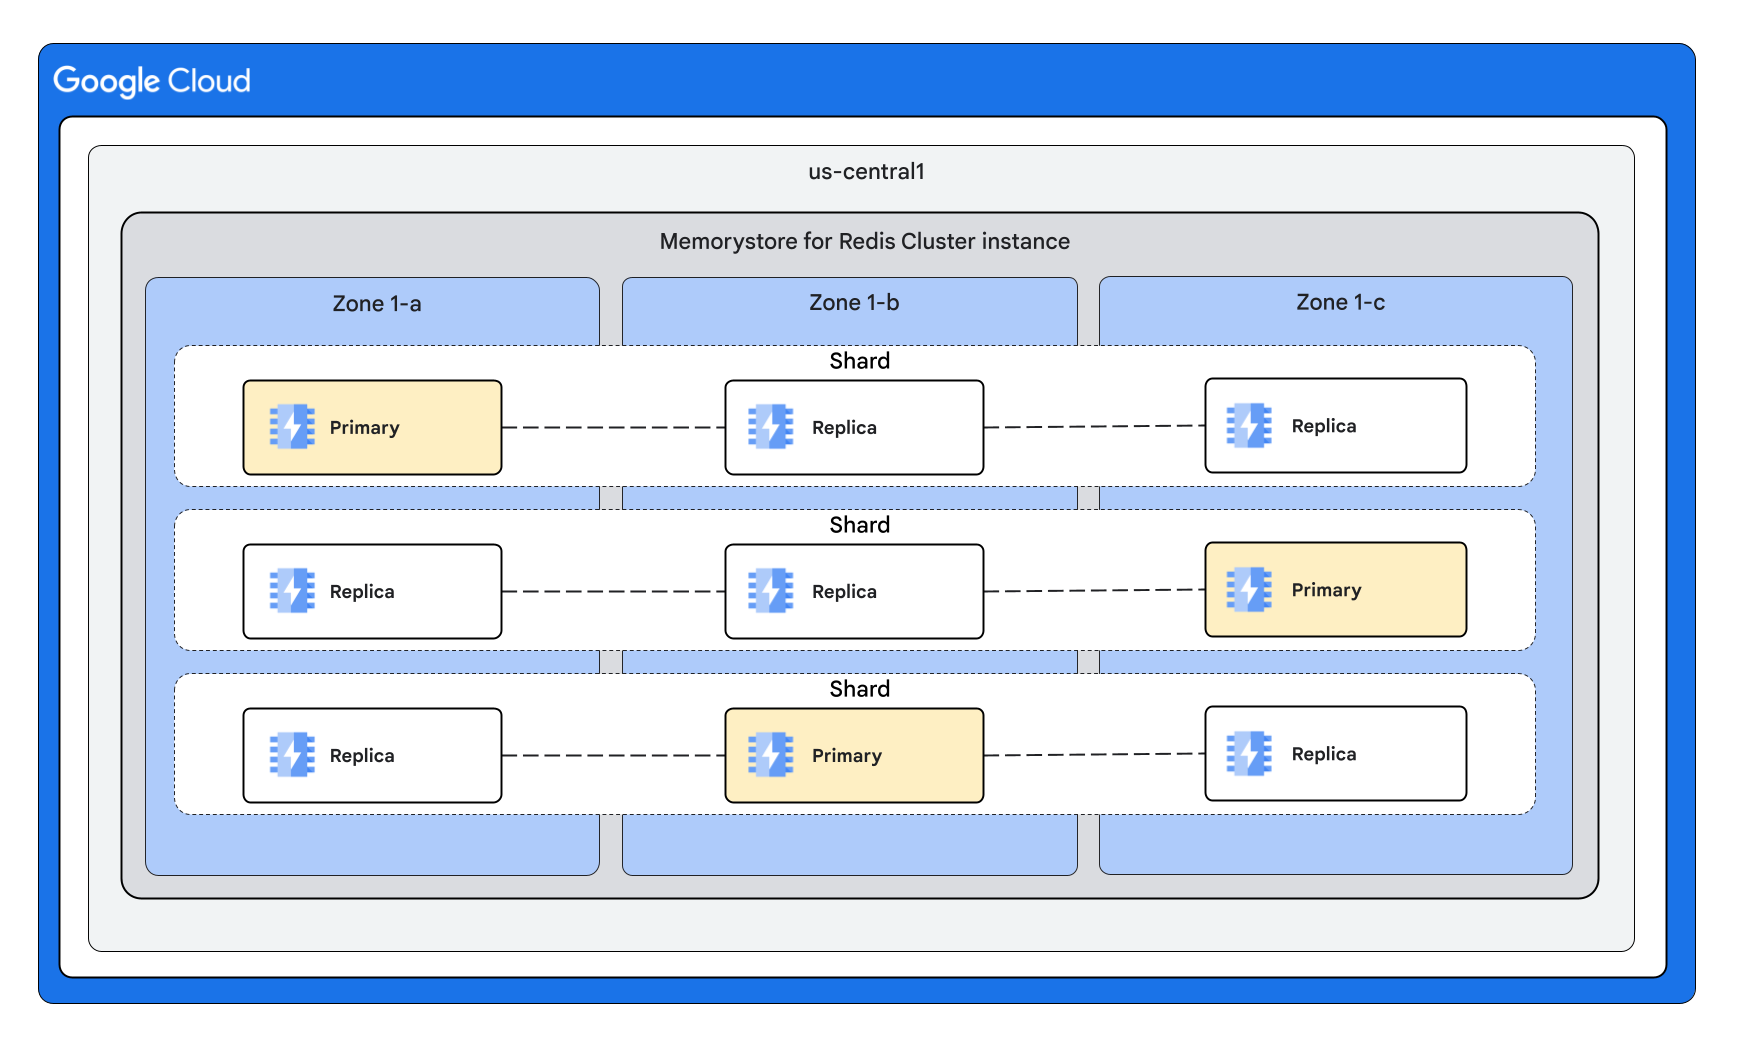
Clusterbeispiel mit mehreren Replikaten pro Shard
Automatischen Failover
Automatische Failover innerhalb eines Shards können aufgrund von Wartungsarbeiten oder eines unerwarteten Ausfalls des primären Knotens auftreten. Während eines Failovers wird ein Replikat zum primären Replikat hochgestuft. Sie können Replikate explizit konfigurieren. Der Dienst kann während der internen Wartung auch vorübergehend zusätzliche Replikate bereitstellen, um Ausfallzeiten zu vermeiden.
Automatische Failovers verhindern Datenverlust während Wartungsupdates. Weitere Informationen zum automatischen Failover-Verhalten während der Wartung finden Sie unter Automatisches Failover-Verhalten während der Wartung.
Failover- und Knotenreparaturdauer
Automatische Failovers können bei ungeplanten Ereignissen wie einem Absturz des primären Knotenprozesses oder einem Hardwarefehler mehrere zehn Sekunden dauern. Während dieser Zeit erkennt das System den Fehler und wählt ein Replikat als neue primäre Instanz aus.
Die Reparatur von Knoten kann einige Minuten dauern, bis der Dienst den ausgefallenen Knoten ersetzt. Das gilt für alle primären Knoten und Replikatknoten. Bei Instanzen, die nicht hochverfügbar sind (keine Replikate bereitgestellt), dauert die Reparatur eines ausgefallenen primären Knotens ebenfalls einige Minuten.
Clientverhalten bei einem ungeplanten Failover
Clientverbindungen werden je nach Art des Fehlers wahrscheinlich zurückgesetzt. Nach der automatischen Wiederherstellung können Sie Ihre Verbindungen mit exponentiellem Backoff noch einmal versuchen, um eine Überlastung der primären und Replikatknoten zu vermeiden.
Bei Clients, die Replikate für den Lesedurchsatz verwenden, kann es zu einer vorübergehenden Verringerung der Kapazität kommen, bis der ausgefallene Knoten automatisch ersetzt wird.
Verlorene Schreibvorgänge
Bei einem Failover aufgrund eines unerwarteten Fehlers können bestätigte Schreibvorgänge aufgrund der asynchronen Natur des Replikationsprotokolls von Redis verloren gehen.
Clientanwendungen können den Redis-Befehl WAIT verwenden, um die Datensicherheit in der Praxis zu verbessern. Es handelt sich um einen Best-Effort-Ansatz, der mit Kompromissen einhergeht, wie in der Dokumentation zum Redis-Befehl WAIT beschrieben.
Auswirkungen eines einzelnen Zonenausfalls auf den Keyspace
In diesem Abschnitt wird beschrieben, welche Auswirkungen ein Ausfall einer einzelnen Zone auf eine Memorystore for Redis Cluster-Instanz hat.
Instanzen in mehreren Zonen
HA-Instanzen:Wenn eine Zone ausfällt, ist der gesamte Keyspace für Lese- und Schreibvorgänge verfügbar. Da jedoch einige Lesereplikate nicht verfügbar sind, wird die Lesekapazität reduziert. Wir empfehlen dringend, die Clusterkapazität zu überdimensionieren, damit die Instanz im seltenen Fall eines Ausfalls einer einzelnen Zone über genügend Lesekapazität verfügt. Sobald der Ausfall behoben ist, werden Replikate in der betroffenen Zone wiederhergestellt und die Lesekapazität des Clusters kehrt zum konfigurierten Wert zurück. Weitere Informationen finden Sie unter Muster für skalierbare und zuverlässige Anwendungen.
Nicht HA-Instanzen (keine Replikate): Wenn eine Zone ausfällt, werden die Daten des Teils des Keyspace, der in der betroffenen Zone bereitgestellt wird, geleert und sind während des Ausfalls nicht für Schreib- oder Lesevorgänge verfügbar. Sobald der Ausfall behoben ist, werden die primären Instanzen in der betroffenen Zone wiederhergestellt und die Kapazität des Clusters erreicht wieder den konfigurierten Wert.
Single-Zone-Instanzen
- Instanzen mit und ohne Hochverfügbarkeit:Wenn die Zone, in der die Instanz bereitgestellt wird, ausfällt, ist der Cluster nicht verfügbar und die Daten werden geleert. Wenn eine andere Zone ausfällt, verarbeitet der Cluster weiterhin Lese- und Schreibanfragen. Sobald der Ausfall vorbei ist, wird die konfigurierte Kapazität des Clusters wiederhergestellt.
Best Practices
In diesem Abschnitt werden Best Practices für Hochverfügbarkeit und Replikate beschrieben.
Replikat hinzufügen
Zum Hinzufügen eines Replikats ist ein RDB-Snapshot erforderlich. Bei RDB-Snapshots wird ein Prozess-Fork und ein Copy-on-Write-Mechanismus verwendet, um einen Snapshot der Knotendaten zu erstellen. Je nach Muster der Schreibvorgänge auf Knoten wächst der verwendete Arbeitsspeicher der Knoten, da die von den Schreibvorgängen betroffenen Seiten kopiert werden. Der Speicherbedarf kann bis zu doppelt so groß sein wie die Daten im Knoten.
Damit Knoten genügend Arbeitsspeicher für die Erstellung des Snapshots haben, sollte maxmemory bei 80% der Knotenkapazität liegen, sodass 20% für den Overhead reserviert sind. Dieser Arbeitsspeicher-Overhead hilft Ihnen zusätzlich zu den Überwachungssnapshots, Ihre Arbeitslast so zu verwalten, dass Snapshots erfolgreich erstellt werden. Wenn Sie Replikate hinzufügen, sollten Sie den Schreibtraffic so weit wie möglich reduzieren. Weitere Informationen finden Sie unter Cluster mit hoher Schreiblast überwachen.