


Auf dieser Seite wird auf den Parameter
typeverwiesen, der Teil eines Messwerts ist.
typekann auch als Teil einer Dimension oder eines Filters verwendet werden, wie auf der Dokumentationsseite Dimensionen, Filter und Parametertypen beschrieben.
typekann auch als Teil einer Dimensionsgruppe verwendet werden, wie auf der Dokumentationsseite zum Parameterdimension_groupbeschrieben.
Nutzung
view: view_name {
  measure: field_name {
    type: measure_field_type
  }
}
|
Hierarchie
type |
Mögliche Feldtypen
Messen
Akzeptiert
Ein Messungstyp
|
Auf dieser Seite finden Sie Details zu den verschiedenen Typen, die einem Messwert zugewiesen werden können. Ein Measure kann nur einen Typ haben. Wenn kein Typ angegeben ist, wird standardmäßig string verwendet.
Einige Measure-Typen haben unterstützende Parameter, die im entsprechenden Abschnitt beschrieben werden.
Kategorien von Measure-Typen
Jeder Messwerttyp fällt in eine der folgenden Kategorien. Diese Kategorien bestimmen, ob der Messwerttyp Aggregationen ausführt, auf welche Feldtypen der Messwerttyp verweisen kann und ob Sie den Messwerttyp mit dem Parameter filters filtern können:
- Aggregierte Messwerte: Mit aggregierten Messwerttypen werden Aggregationen wie
sumundaveragedurchgeführt. Aggregierte Measures können nur Dimensionen referenzieren, keine anderen Measures. Dies ist der einzige Messwerttyp, der mit dem Parameterfiltersfunktioniert. - Nicht aggregierte Messwerte: Nicht aggregierte Messwerte sind, wie der Name schon sagt, Messwerttypen, bei denen keine Aggregationen durchgeführt werden, z. B.
numberundyesno. Bei diesen Messwerttypen werden grundlegende Transformationen ausgeführt. Da keine Aggregationen erfolgen, können nur aggregierte Messwerte oder zuvor aggregierte Dimensionen referenziert werden. Der Parameterfilterskann nicht mit diesen Messarten verwendet werden. - Post-SQL-Messwerte: Post-SQL-Messwerte sind spezielle Messwerttypen, die bestimmte Berechnungen ausführen, nachdem Looker die Abfrage-SQL generiert hat. Sie können nur numerische Messwerte oder numerische Dimensionen referenzieren. Der Parameter
filterskann nicht mit diesen Messarten verwendet werden.
Liste der Typdefinitionen
| Typ | Kategorie | Beschreibung |
|---|---|---|
average |
Aggregieren | Generiert einen Durchschnitt (Mittelwert) der Werte in einer Spalte |
average_distinct |
Aggregieren | Erstellt einen Durchschnitt (Mittelwert) von Werten, wenn denormalisierte Daten verwendet werden. Eine vollständige Beschreibung finden Sie im Abschnitt average_distinct. |
count |
Aggregieren | Generiert die Anzahl der Zeilen |
count_distinct |
Aggregieren | Generiert die Anzahl der eindeutigen Werte in einer Spalte |
date |
Nicht aggregiert | Für Messwerte, die Datumsangaben enthalten |
list |
Aggregieren | Erstellt eine Liste der eindeutigen Werte in einer Spalte |
max |
Aggregieren | Generiert den Maximalwert innerhalb einer Spalte |
median |
Aggregieren | Generiert den Median (Mittelwert) der Werte in einer Spalte. |
median_distinct |
Aggregieren | Generiert einen Medianwert (Mittelwert) der Werte, wenn ein Join zu einem Fanout führt. Eine vollständige Beschreibung finden Sie im Abschnitt median_distinct. |
min |
Aggregieren | Generiert den Mindestwert innerhalb einer Spalte |
number |
Nicht aggregiert | Für Messwerte, die Zahlen enthalten |
percent_of_previous |
Post-SQL | Generiert die prozentuale Differenz zwischen den angezeigten Zeilen |
percent_of_total |
Post-SQL | Generiert den Prozentsatz der Gesamtsumme für jede angezeigte Zeile |
percentile |
Aggregieren | Generiert den Wert am angegebenen Perzentil innerhalb einer Spalte |
percentile_distinct |
Aggregieren | Generiert den Wert am angegebenen Perzentil ordnungsgemäß, wenn ein Join ein Fanout verursacht. Eine vollständige Beschreibung finden Sie im Abschnitt percentile_distinct. |
running_total |
Post-SQL | Generiert die laufende Summe für jede angezeigte Zeile |
period_over_period |
Aggregieren | Verweist auf eine Aggregation aus einem früheren Zeitraum |
string |
Nicht aggregiert | Für Measures, die Buchstaben oder Sonderzeichen enthalten (wie bei der MySQL-Funktion GROUP_CONCAT) |
sum |
Aggregieren | Generiert eine Summe der Werte in einer Spalte |
sum_distinct |
Aggregieren | Generiert eine Summe von Werten, wenn denormalisierte Daten verwendet werden.Eine vollständige Beschreibung finden Sie im Abschnitt sum_distinct. |
yesno |
Nicht aggregiert | Felder, in denen angezeigt wird, ob etwas wahr oder falsch ist |
int |
Nicht aggregiert |
5.4 entfernt
Ersetzt durch type: number |
average
type: average berechnet den Durchschnitt der Werte in einem bestimmten Feld. Sie ähnelt der SQL-Funktion AVG. Im Gegensatz zu Roh-SQL berechnet Looker Durchschnittswerte jedoch auch dann richtig, wenn die Joins Ihrer Abfrage Fanouts enthalten.
Der Parameter sql für type: average-Messwerte kann einen beliebigen gültigen SQL-Ausdruck enthalten, der zu einer numerischen Tabellenspalte, einer LookML-Dimension oder einer Kombination aus LookML-Dimensionen führt.
type: average-Felder können mit den Parametern value_format oder value_format_name formatiert werden.
Mit dem folgenden LookML-Code wird beispielsweise ein Feld namens avg_order erstellt, indem der Durchschnitt der Dimension sales_price berechnet wird. Anschließend wird es im Währungsformat ($1.234,56) angezeigt:
measure: avg_order {
  type: average
  sql: ${sales_price} ;;
  value_format_name: usd
}
average_distinct
type: average_distinct ist für die Verwendung mit denormalisierten Datasets vorgesehen. Es wird der Durchschnitt der nicht wiederholten Werte in einem bestimmten Feld berechnet, basierend auf den eindeutigen Werten, die durch den Parameter sql_distinct_key definiert sind.
Dies ist ein fortgeschrittenes Konzept, das sich am besten anhand eines Beispiels erklären lässt. Betrachten Sie eine denormalisierte Tabelle wie diese:
| Artikel-ID des Bestellpostens | Bestell-ID | Bestellversand |
|---|---|---|
| 1 | 1 | 10,00 |
| 2 | 1 | 10,00 |
| 3 | 2 | 20,00 |
| 4 | 2 | 20,00 |
| 5 | 2 | 20,00 |
In diesem Fall sehen Sie, dass für jede Bestellung mehrere Zeilen vorhanden sind. Wenn Sie also einen einfachen type: average-Messwert für die Spalte order_shipping hinzufügen, erhalten Sie den Wert 16,00, obwohl der tatsächliche Durchschnitt 15,00 beträgt.
 # Will NOT calculate the correct average
measure: avg_shipping {
  type: average
  sql: ${order_shipping} ;;
}
Um ein genaues Ergebnis zu erhalten, können Sie mit dem Parameter sql_distinct_key für Looker definieren, wie jede eindeutige Entität (in diesem Fall jede eindeutige Bestellung) identifiziert werden soll. Damit wird der richtige Betrag von 15,00 € berechnet:
 # Will calculate the correct average
measure: avg_shipping {
  type: average_distinct
  sql_distinct_key: ${order_id} ;;
  sql: ${order_shipping} ;;
}
Jeder eindeutige Wert von sql_distinct_key darf nur einen entsprechenden Wert in sql haben. Anders ausgedrückt: Das Beispiel oben funktioniert, weil jede Zeile mit einem order_id von 1 denselben order_shipping von 10,00 hat und jede Zeile mit einem order_id von 2 denselben order_shipping von 20,00 hat.
type: average_distinct-Felder können mit den Parametern value_format oder value_format_name formatiert werden.
count
type: count führt eine Tabellenzählung durch, ähnlich der SQL-Funktion COUNT. Im Gegensatz zu Roh-SQL berechnet Looker die Anzahl jedoch auch dann richtig, wenn die Joins Ihrer Abfrage Fanouts enthalten.
type: count-Messwerte führen Tabellenzählungen durch, die auf dem Primärschlüssel der Tabelle basieren. Daher unterstützen type: count-Messwerte den Parameter sql nicht.
Wenn Sie eine Tabellenzählung für ein anderes Feld als den Primärschlüssel der Tabelle durchführen möchten, verwenden Sie einen type: count_distinct-Messwert. Wenn Sie count_distinct nicht verwenden möchten, können Sie eine Measure von type: number verwenden. Weitere Informationen finden Sie im Community-Beitrag How to count a non-primary key.
Mit dem folgenden LookML-Code wird beispielsweise das Feld number_of_products erstellt:
view: products {
  measure: number_of_products {
    type: count
    drill_fields: [product_details*]  # optional
  }
}
Es ist sehr üblich, beim Definieren eines type: count-Messwerts einen drill_fields-Parameter (für Felder) anzugeben, damit Nutzer die einzelnen Datensätze sehen können, aus denen eine Anzahl besteht, wenn sie darauf klicken.
Wenn Sie in einem Explore das Measure
type: countverwenden, werden die resultierenden Werte in der Visualisierung mit dem Namen der Ansicht und nicht mit dem Wort „Anzahl“ gekennzeichnet. Um Verwechslungen zu vermeiden, empfehlen wir, den Namen der Ansicht im Plural zu verwenden, in den Visualisierungseinstellungen unter Serie die Option Vollständigen Feldnamen anzeigen auszuwählen oder einenview_labelmit einer Pluralversion des Ansichtsnamens zu verwenden.
Mit dem Parameter filters können Sie einer Messung vom Typ type: count einen Filter hinzufügen.
count_distinct
type: count_distinct berechnet die Anzahl der eindeutigen Werte in einem bestimmten Feld. Dabei wird die SQL-Funktion COUNT DISTINCT verwendet.
Der Parameter sql für type: count_distinct-Messwerte kann einen beliebigen gültigen SQL-Ausdruck enthalten, der eine Tabellenspalte, eine LookML-Dimension oder eine Kombination aus LookML-Dimensionen ergibt.
Mit dem folgenden LookML-Code wird beispielsweise das Feld number_of_unique_customers erstellt, in dem die Anzahl der eindeutigen Kundennummern gezählt wird:
measure: number_of_unique_customers {
  type: count_distinct
  sql: ${customer_id} ;;
}
Mit dem Parameter filters können Sie einem Messwert von type: count_distinct einen Filter hinzufügen.
date
type: date wird mit Feldern verwendet, die Datumsangaben enthalten.
Der Parameter sql für type: date-Messwerte kann einen beliebigen gültigen SQL-Ausdruck annehmen, der ein Datum ergibt. In der Praxis wird dieser Typ selten verwendet, da die meisten SQL-Aggregatfunktionen keine Datumsangaben zurückgeben. Eine häufige Ausnahme ist ein MIN oder MAX einer Datumsdimension.
Measure für maximales oder minimales Datum mit type: date erstellen
Wenn Sie einen Messwert für ein maximales oder minimales Datum erstellen möchten, denken Sie vielleicht zuerst, dass ein Messwert für type: max oder type: min funktionieren würde. Diese Messwerttypen sind jedoch nur mit numerischen Feldern kompatibel. Stattdessen können Sie ein maximales oder minimales Datum erfassen, indem Sie einen Measure vom Typ type: date definieren und das im Parameter sql referenzierte Datumsfeld in eine MIN()- oder MAX()-Funktion einbinden.
Angenommen, Sie haben eine Dimensionsgruppe vom Typ type: time mit dem Namen updated:
dimension_group: updated {
  type: time
  timeframes: [time, date, week, month, raw]
  sql: ${TABLE}.updated_at ;;
}
Sie können einen Messwert für type: date erstellen, um das maximale Datum dieser Dimensionsgruppe zu erfassen:
measure: last_updated_date {
  type: date
  sql: MAX(${updated_raw}) ;;
  convert_tz: no
}
In diesem Beispiel wird anstelle des Messwerts type: max zum Erstellen des Messwerts last_updated_date die Funktion MAX() im Parameter sql angewendet. Für die Messung last_updated_date ist außerdem der Parameter convert_tz auf no festgelegt, um eine doppelte Zeitzonenumrechnung in der Messung zu verhindern, da die Zeitzonenumrechnung bereits in der Definition der Dimensionsgruppe updated erfolgt ist. Weitere Informationen finden Sie in der Dokumentation zum Parameter convert_tz.
In der LookML-Beispieldefinition für den Messwert last_updated_date könnte type: date weggelassen werden. Der Wert würde dann als String behandelt, da string der Standardwert für type ist. Wenn Sie jedoch type: date verwenden, erhalten Sie bessere Filterfunktionen für Nutzer.
Möglicherweise stellen Sie auch fest, dass in der Messwertdefinition für last_updated_date auf den Zeitraum ${updated_raw} anstelle des Zeitraums ${updated_date} verwiesen wird. Da der von ${updated_date} zurückgegebene Wert ein String ist, muss stattdessen ${updated_raw} verwendet werden, um auf den tatsächlichen Datumswert zu verweisen.
Sie können den Parameter datatype auch mit type: date verwenden, um die Abfrageleistung zu verbessern, indem Sie den Typ der Datumsdaten angeben, die in Ihrer Datenbanktabelle verwendet werden.
Maximalen oder minimalen Messwert für eine Datetime-Spalte erstellen
Die Berechnung des Maximums für eine type: datetime-Spalte ist etwas anders. In diesem Fall möchten Sie ein Ergebnis erstellen, ohne den Typ zu deklarieren, wie hier:
measure: last_updated_datetime {
  sql: MAX(${TABLE}.datetime_string_field) ;;
}
list
type: list erstellt eine Liste der eindeutigen Werte in einem bestimmten Feld. Sie ähnelt der GROUP_CONCAT-Funktion von MySQL.
Für type: list-Messwerte müssen Sie keinen sql-Parameter angeben. Stattdessen können Sie mit dem Parameter list_field die Dimension angeben, aus der Sie Listen erstellen möchten.
Die Verwendung ist wie folgt:
view: view_name {
  measure: field_name {
    type: list
    list_field: my_field_name
  }
}
Mit dem folgenden LookML wird beispielsweise ein Messwert name_list auf Grundlage der Dimension name erstellt:
measure: name_list {
  type: list
  list_field: name
}
Beachten Sie Folgendes für list:
- Der Messungstyp
listunterstützt keine Filterung. Sie können den Parameterfiltersnicht für einentype: list-Messwert verwenden. - Auf den Messwerttyp
listkann nicht mit dem Substitutionsoperator ($) verwiesen werden. Sie können die Syntax${}nicht verwenden, um auf einentype: list-Messwert zu verweisen.
Unterstützte Datenbankdialekte für list
Damit Looker type: list in Ihrem Looker-Projekt unterstützen kann, muss es auch von Ihrem Datenbankdialekt unterstützt werden. In der folgenden Tabelle ist zu sehen, welche Dialekte type: list in der aktuellen Looker-Version unterstützen:
| Dialekt | Unterstützt? |
|---|---|
| Actian Avalanche | |
| Amazon Athena | |
| Amazon Aurora MySQL | |
| Amazon Redshift | |
| Amazon Redshift 2.1+ | |
| Amazon Redshift Serverless 2.1+ | |
| Apache Druid | |
| Apache Druid 0.13.x - 0.17.x | |
| Apache Druid 0.18+ | |
| Apache Hive 2.3+ | |
| Apache Hive 3.1.2+ | |
| Apache Spark 3+ | |
| ClickHouse | |
| ClickHouse 26+ | |
| Cloudera Impala 3.1+ | |
| Cloudera Impala 3.1+ with Native Driver | |
| Cloudera Impala with Native Driver | |
| DataVirtuality | |
| Databricks | |
| Denodo 7 | |
| Denodo 8 & 9 | |
| Dremio | |
| Dremio 11+ | |
| Dremio 26+ with Arrow Flight SQL | |
| Exasol | |
| Google BigQuery Legacy SQL | |
| Google BigQuery Standard SQL | |
| Google Cloud AlloyDB for PostgreSQL | |
| Google Cloud PostgreSQL | |
| Google Cloud SQL | |
| Google Spanner | |
| Greenplum | |
| HyperSQL | |
| IBM Netezza | |
| MariaDB | |
| Microsoft Azure PostgreSQL | |
| Microsoft Azure SQL Database | |
| Microsoft Azure Synapse Analytics | |
| Microsoft SQL Server 2008+ | |
| Microsoft SQL Server 2012+ | |
| Microsoft SQL Server 2016 | |
| Microsoft SQL Server 2017+ | |
| MongoBI | |
| MongoSQL | |
| MySQL | |
| MySQL 8.0.12+ | |
| Oracle | |
| Oracle ADWC | |
| PostgreSQL 9.5+ | |
| PostgreSQL pre-9.5 | |
| PrestoDB | |
| PrestoSQL | |
| SAP HANA | |
| SAP HANA 2+ | |
| SingleStore | |
| SingleStore 7+ | |
| Snowflake | |
| Teradata | |
| Trino | |
| Vector | |
| Vertica |
max
Mit type: max wird der größte Wert in einem bestimmten Feld ermittelt. Dabei wird die SQL-Funktion MAX verwendet.
Der Parameter sql für Messwerte vom Typ type: max kann einen beliebigen gültigen SQL-Ausdruck enthalten, der eine numerische Tabellenspalte, eine LookML-Dimension oder eine Kombination aus LookML-Dimensionen ergibt.
Da Messwerte vom Typ type: max nur mit numerischen Feldern kompatibel sind, können Sie einen Messwert vom Typ type: max nicht verwenden, um ein maximales Datum zu finden. Stattdessen können Sie die Funktion MAX() im Parameter sql eines Measures vom Typ type: date verwenden, um ein maximales Datum zu erfassen, wie zuvor in den Beispielen im Abschnitt date gezeigt.
type: max-Felder können mit den Parametern value_format oder value_format_name formatiert werden.
Mit dem folgenden LookML-Code wird beispielsweise ein Feld namens largest_order erstellt, indem die Dimension sales_price herangezogen wird. Anschließend wird es im Währungsformat ($1,234.56) angezeigt:
measure: largest_order {
  type: max
  sql: ${sales_price} ;;
  value_format_name: usd
}
type: max-Messwerte können nicht für Strings oder Datumsangaben verwendet werden. Sie können die Funktion MAX jedoch manuell hinzufügen, um ein entsprechendes Feld zu erstellen, z. B. so:
measure: latest_name_in_alphabet {
  type: string
  sql: MAX(${name}) ;;
}
median
type: median gibt den Mittelwert für die Werte in einem bestimmten Feld zurück. Das ist besonders nützlich, wenn die Daten einige sehr große oder kleine Ausreißerwerte enthalten, die einen einfachen Durchschnitt (Mittelwert) der Daten verzerren würden.
Nehmen wir eine Tabelle wie diese:
| Bestellartikel-ID | Kosten | Midpoint? |
|---|---|---|
| 2 | 10,00 | |
| 4 | 10,00 | |
| 3 | 20,00 | Mittelwert |
| 1 | 80,00 | |
| 5 | 90,00 |
Die Tabelle ist nach Kosten sortiert, was sich jedoch nicht auf das Ergebnis auswirkt. Während der Typ average den Wert 42 zurückgeben würde (alle Werte addiert und durch 5 geteilt), würde der Typ median den Mittelwert zurückgeben: 20,00.
Bei einer geraden Anzahl von Werten wird der Medianwert berechnet, indem der Mittelwert der beiden Werte ermittelt wird, die dem Mittelpunkt am nächsten sind. Nehmen wir eine Tabelle mit einer geraden Anzahl von Zeilen:
| Bestellartikel-ID | Kosten | Midpoint? |
|---|---|---|
| 2 | 10 | |
| 3 | 20 | Am nächsten vor der Routenhälfte |
| 1 | 80 | Nächster nach der Routenhälfte |
| 4 | 90 |
Der Median, also der mittlere Wert, ist (20 + 80)/2 = 50.
Der Median entspricht auch dem Wert beim 50. Perzentil.
Der Parameter sql für type: median-Messwerte kann einen beliebigen gültigen SQL-Ausdruck enthalten, der eine numerische Tabellenspalte, eine LookML-Dimension oder eine Kombination aus LookML-Dimensionen ergibt.
type: median-Felder können mit den Parametern value_format oder value_format_name formatiert werden.
Beispiel
Mit dem folgenden LookML-Code wird beispielsweise ein Feld namens median_order erstellt, indem der Durchschnitt der Dimension sales_price berechnet wird. Anschließend wird es im Währungsformat ($1.234,56) angezeigt:
measure: median_order {
  type: median
  sql: ${sales_price} ;;
  value_format_name: usd
}
Wichtige Punkte für median
Wenn Sie median für ein Feld verwenden, das an einem Fanout beteiligt ist, versucht Looker stattdessen, median_distinct zu verwenden. medium_distinct wird jedoch nur für bestimmte Dialekte unterstützt. Wenn median_distinct für Ihren Dialekt nicht verfügbar ist, gibt Looker einen Fehler zurück. Da median als 50. Perzentil betrachtet werden kann, besagt der Fehler, dass der Dialekt keine unterschiedlichen Perzentile unterstützt.
Unterstützte Datenbankdialekte für median
Damit Looker den Typ median in Ihrem Looker-Projekt unterstützen kann, muss er auch von Ihrem Datenbankdialekt unterstützt werden. In der folgenden Tabelle ist zu sehen, welche Dialekte den Typ median in der neuesten Version von Looker unterstützen:
| Dialekt | Unterstützt? |
|---|---|
| Actian Avalanche | |
| Amazon Athena | |
| Amazon Aurora MySQL | |
| Amazon Redshift | |
| Amazon Redshift 2.1+ | |
| Amazon Redshift Serverless 2.1+ | |
| Apache Druid | |
| Apache Druid 0.13.x - 0.17.x | |
| Apache Druid 0.18+ | |
| Apache Hive 2.3+ | |
| Apache Hive 3.1.2+ | |
| Apache Spark 3+ | |
| ClickHouse | |
| ClickHouse 26+ | |
| Cloudera Impala 3.1+ | |
| Cloudera Impala 3.1+ with Native Driver | |
| Cloudera Impala with Native Driver | |
| DataVirtuality | |
| Databricks | |
| Denodo 7 | |
| Denodo 8 & 9 | |
| Dremio | |
| Dremio 11+ | |
| Dremio 26+ with Arrow Flight SQL | |
| Exasol | |
| Google BigQuery Legacy SQL | |
| Google BigQuery Standard SQL | |
| Google Cloud AlloyDB for PostgreSQL | |
| Google Cloud PostgreSQL | |
| Google Cloud SQL | |
| Google Spanner | |
| Greenplum | |
| HyperSQL | |
| IBM Netezza | |
| MariaDB | |
| Microsoft Azure PostgreSQL | |
| Microsoft Azure SQL Database | |
| Microsoft Azure Synapse Analytics | |
| Microsoft SQL Server 2008+ | |
| Microsoft SQL Server 2012+ | |
| Microsoft SQL Server 2016 | |
| Microsoft SQL Server 2017+ | |
| MongoBI | |
| MongoSQL | |
| MySQL | |
| MySQL 8.0.12+ | |
| Oracle | |
| Oracle ADWC | |
| PostgreSQL 9.5+ | |
| PostgreSQL pre-9.5 | |
| PrestoDB | |
| PrestoSQL | |
| SAP HANA | |
| SAP HANA 2+ | |
| SingleStore | |
| SingleStore 7+ | |
| Snowflake | |
| Teradata | |
| Trino | |
| Vector | |
| Vertica |
Wenn eine Abfrage einen Fanout beinhaltet, versucht Looker, median in median_distinct umzuwandeln. Dies funktioniert nur bei Dialekten, die median_distinct unterstützen.
median_distinct
Verwenden Sie type: median_distinct, wenn Ihr Join einen Fanout beinhaltet. Es wird der Durchschnitt der nicht wiederholten Werte in einem bestimmten Feld berechnet, basierend auf den eindeutigen Werten, die durch den Parameter sql_distinct_key definiert sind. Wenn die Messung keinen sql_distinct_key-Parameter hat, versucht Looker, das Feld primary_key zu verwenden.
Sehen Sie sich das Ergebnis einer Abfrage an, bei der die Tabellen „Order Item“ und „Order“ zusammengeführt werden:
| Bestellartikel-ID | Bestell-ID | Bestellversand |
|---|---|---|
| 1 | 1 | 10 |
| 2 | 1 | 10 |
| 3 | 2 | 20 |
| 4 | 3 | 50 |
| 5 | 3 | 50 |
| 6 | 3 | 50 |
In diesem Fall sehen Sie, dass für jede Bestellung mehrere Zeilen vorhanden sind. Diese Abfrage beinhaltete ein Fanout, da jede Bestellung mehreren Bestellpositionen zugeordnet ist. Bei der Berechnung von median_distinct wird dies berücksichtigt und der Medianwert zwischen den einzelnen Werten 10, 20 und 50 ermittelt. Das Ergebnis ist also 20.
Damit Sie ein genaues Ergebnis erhalten, können Sie in Looker mit dem Parameter sql_distinct_key definieren, wie jede eindeutige Einheit (in diesem Fall jede eindeutige Bestellung) identifiziert werden soll. So wird der richtige Betrag berechnet:
measure: median_shipping {
  type: median_distinct
  sql_distinct_key: ${order_id} ;;
  sql: ${order_shipping} ;;
}
Jeder eindeutige Wert von sql_distinct_key muss genau einen entsprechenden Wert im Parameter sql der Messung haben. Anders ausgedrückt: Das obige Beispiel funktioniert, weil jede Zeile mit einem order_id von 1 denselben order_shipping von 10 hat und jede Zeile mit einem order_id von 2 denselben order_shipping von 20 hat.
type: median_distinct-Felder können mit den Parametern value_format oder value_format_name formatiert werden.
Wichtige Punkte für median_distinct
Der Messwerttyp medium_distinct wird nur für bestimmte Dialekte unterstützt. Wenn median_distinct für den Dialekt nicht verfügbar ist, gibt Looker einen Fehler zurück. Da der median als 50. Perzentil betrachtet werden kann, besagt der Fehlerstatus, dass der Dialekt keine unterschiedlichen Perzentile unterstützt.
Unterstützte Datenbankdialekte für median_distinct
Damit Looker den Typ median_distinct in Ihrem Looker-Projekt unterstützen kann, muss er auch von Ihrem Datenbankdialekt unterstützt werden. In der folgenden Tabelle ist zu sehen, welche Dialekte den Typ median_distinct in der aktuellen Version von Looker unterstützen:
| Dialekt | Unterstützt? |
|---|---|
| Actian Avalanche | |
| Amazon Athena | |
| Amazon Aurora MySQL | |
| Amazon Redshift | |
| Amazon Redshift 2.1+ | |
| Amazon Redshift Serverless 2.1+ | |
| Apache Druid | |
| Apache Druid 0.13.x - 0.17.x | |
| Apache Druid 0.18+ | |
| Apache Hive 2.3+ | |
| Apache Hive 3.1.2+ | |
| Apache Spark 3+ | |
| ClickHouse | |
| ClickHouse 26+ | |
| Cloudera Impala 3.1+ | |
| Cloudera Impala 3.1+ with Native Driver | |
| Cloudera Impala with Native Driver | |
| DataVirtuality | |
| Databricks | |
| Denodo 7 | |
| Denodo 8 & 9 | |
| Dremio | |
| Dremio 11+ | |
| Dremio 26+ with Arrow Flight SQL | |
| Exasol | |
| Google BigQuery Legacy SQL | |
| Google BigQuery Standard SQL | |
| Google Cloud AlloyDB for PostgreSQL | |
| Google Cloud PostgreSQL | |
| Google Cloud SQL | |
| Google Spanner | |
| Greenplum | |
| HyperSQL | |
| IBM Netezza | |
| MariaDB | |
| Microsoft Azure PostgreSQL | |
| Microsoft Azure SQL Database | |
| Microsoft Azure Synapse Analytics | |
| Microsoft SQL Server 2008+ | |
| Microsoft SQL Server 2012+ | |
| Microsoft SQL Server 2016 | |
| Microsoft SQL Server 2017+ | |
| MongoBI | |
| MongoSQL | |
| MySQL | |
| MySQL 8.0.12+ | |
| Oracle | |
| Oracle ADWC | |
| PostgreSQL 9.5+ | |
| PostgreSQL pre-9.5 | |
| PrestoDB | |
| PrestoSQL | |
| SAP HANA | |
| SAP HANA 2+ | |
| SingleStore | |
| SingleStore 7+ | |
| Snowflake | |
| Teradata | |
| Trino | |
| Vector | |
| Vertica |
min
type: min findet den kleinsten Wert in einem bestimmten Feld. Dabei wird die SQL-Funktion MIN verwendet.
Der Parameter sql für Messwerte vom Typ type: min kann einen beliebigen gültigen SQL-Ausdruck enthalten, der eine numerische Tabellenspalte, eine LookML-Dimension oder eine Kombination aus LookML-Dimensionen ergibt.
Da type: min-Messwerte nur mit numerischen Feldern kompatibel sind, können Sie keinen type: min-Messwert verwenden, um ein Mindestdatum zu ermitteln. Stattdessen können Sie die Funktion MIN() im Parameter sql eines Measures vom Typ type: date verwenden, um ein Minimum zu erfassen, genau wie Sie die Funktion MAX() mit einem Measure vom Typ type: date verwenden können, um ein maximales Datum zu erfassen. Dies wurde bereits im Abschnitt date auf dieser Seite gezeigt. Dort finden Sie Beispiele für die Verwendung der Funktion MAX() im Parameter sql, um ein maximales Datum zu finden.
type: min-Felder können mit den Parametern value_format oder value_format_name formatiert werden.
Mit dem folgenden LookML-Code wird beispielsweise ein Feld namens smallest_order erstellt, indem die Dimension sales_price betrachtet und dann im Währungsformat ($1,234.56) angezeigt wird:
measure: smallest_order {
  type: min
  sql: ${sales_price} ;;
  value_format_name: usd
}
type: min-Messwerte können nicht für Strings oder Datumsangaben verwendet werden. Sie können die Funktion MIN jedoch manuell hinzufügen, um ein entsprechendes Feld zu erstellen, z. B. so:
measure: earliest_name_in_alphabet {
  type: string
  sql: MIN(${name}) ;;
}
number
type: number wird mit Zahlen oder Ganzzahlen verwendet. Bei einem Messwert vom Typ type: number wird keine Aggregation ausgeführt. Er ist für die Durchführung einfacher Transformationen anderer Messwerte vorgesehen. Wenn Sie einen Messwert definieren, der auf einem anderen Messwert basiert, muss der neue Messwert vom Typ type: number sein, um Fehler bei verschachtelten Aggregationen zu vermeiden.
Der Parameter sql für type: number-Messwerte kann einen beliebigen gültigen SQL-Ausdruck enthalten, der eine Zahl oder eine Ganzzahl ergibt.
type: number-Felder können mit den Parametern value_format oder value_format_name formatiert werden.
Mit dem folgenden LookML-Code wird beispielsweise ein Messwert namens total_gross_margin_percentage auf Grundlage der aggregierten Messwerte total_sale_price und total_gross_margin erstellt und dann in einem Prozentformat mit zwei Dezimalstellen (12,34%) angezeigt:
measure: total_sale_price {
  type: sum
  value_format_name: usd
  sql: ${sale_price} ;;
}

measure: total_gross_margin {
  type: sum
  value_format_name: usd
  sql: ${gross_margin} ;;
}

measure: total_gross_margin_percentage {
  type: number
  value_format_name: percent_2
  sql: ${total_gross_margin}/ NULLIF(${total_sale_price},0) ;;
}
In diesem Beispiel wird auch die SQL-Funktion NULLIF() verwendet, um die Möglichkeit von Fehlern durch Division durch null auszuschließen.
Wichtige Punkte für type: number
Bei der Verwendung von type: number-Messwerten sind einige wichtige Punkte zu beachten:
- Ein Messwert vom Typ
type: numberkann nur arithmetische Operationen für andere Messwerte, nicht für andere Dimensionen ausführen. - Symmetrische Aggregate von Looker schützen keine Aggregatfunktionen im SQL-Code eines Measures
type: number, wenn sie über einen Join berechnet werden. - Der Parameter
filterskann nicht mittype: number-Messwerten verwendet werden. In der Dokumentation zufilterswird jedoch eine Problemumgehung erläutert. type: numberMaßnahmen liefern Nutzern keine Vorschläge.
percent_of_previous
Mit type: percent_of_previous wird die prozentuale Differenz zwischen einer Zelle und der vorherigen Zelle in ihrer Spalte berechnet.
Der Parameter sql für type: percent_of_previous-Messungen muss auf einen anderen numerischen Messwert verweisen.
type: percent_of_previous-Felder können mit den Parametern value_format oder value_format_name formatiert werden. Die Prozentformate des Parameters value_format_name funktionieren jedoch nicht mit type: percent_of_previous-Messwerten. Bei diesen Prozentformaten werden Werte mit 100 multipliziert, was die Ergebnisse einer Berechnung des Prozentsatzes des vorherigen Werts verzerrt.
In diesem LookML-Beispiel wird ein count_growth-Messwert erstellt, der auf dem count-Messwert basiert:
measure: count_growth {
  type: percent_of_previous
  sql: ${count} ;;
}
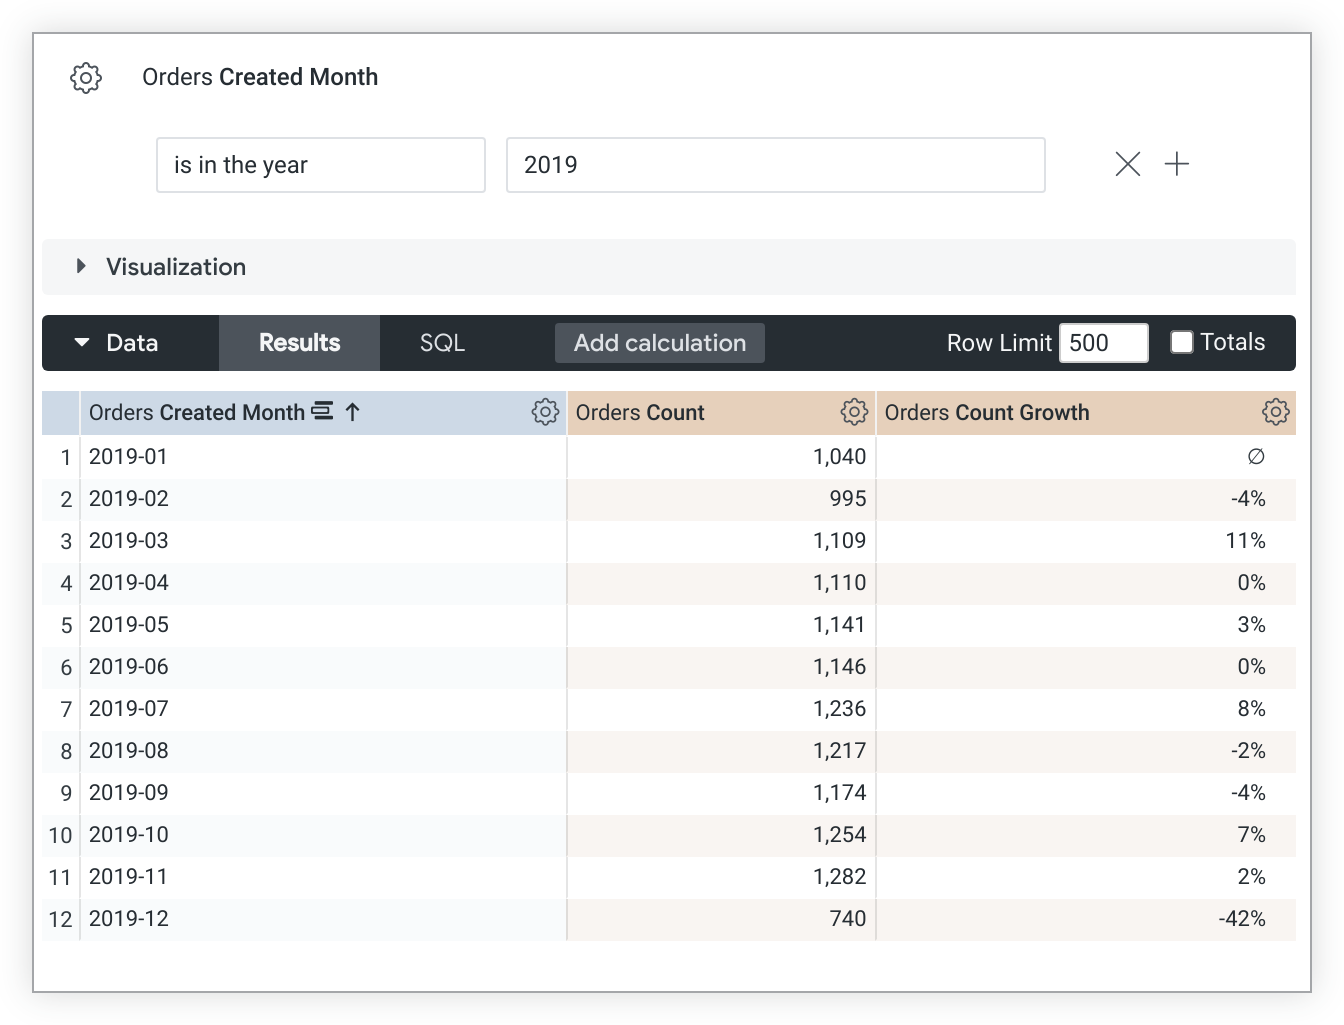
Die percent_of_previous-Werte hängen von der Sortierreihenfolge ab. Wenn Sie die Sortierung ändern, müssen Sie die Abfrage noch einmal ausführen, um die percent_of_previous-Werte neu zu berechnen. Wenn eine Abfrage pivotiert wird, wird percent_of_previous zeilenweise statt spaltenweise ausgeführt. Dieses Verhalten kann nicht geändert werden.
Außerdem werden percent_of_previous-Messwerte berechnet, nachdem Daten aus Ihrer Datenbank zurückgegeben wurden. Das bedeutet, dass Sie nicht auf einen percent_of_previous-Messwert in einem anderen Messwert verweisen sollten, da sie möglicherweise zu unterschiedlichen Zeiten berechnet werden und Sie daher keine genauen Ergebnisse erhalten. Außerdem können percent_of_previous-Messwerte nicht gefiltert werden.
Eine Anwendung für diese Art von Messung ist die Analyse von Zeitraum zu Zeitraum (Period-over-Period, PoP). Dabei wird etwas in der Gegenwart gemessen und mit derselben Messung in einem vergleichbaren Zeitraum in der Vergangenheit verglichen. Weitere Informationen zu PoP finden Sie in den Artikeln How to do Period-over-Period Analysis und Methods for Period Over Period (PoP) Analysis in Looker in der Looker-Community.
percent_of_total
type: percent_of_total berechnet den Anteil einer Zelle an der Spaltensumme. Der Prozentsatz wird anhand der Gesamtzahl der von Ihrer Abfrage zurückgegebenen Zeilen und nicht anhand der Gesamtzahl aller möglichen Zeilen berechnet. Wenn die von Ihrer Abfrage zurückgegebenen Daten jedoch ein Zeilenlimit überschreiten, werden die Werte des Felds als Nullwerte angezeigt, da für die Berechnung des Prozentsatzes der Gesamtsumme die vollständigen Ergebnisse erforderlich sind.
Der Parameter sql für type: percent_of_total-Messwerte muss auf einen anderen numerischen Messwert verweisen.
type: percent_of_total-Felder können mit den Parametern value_format oder value_format_name formatiert werden. Die Prozentformate des Parameters value_format_name funktionieren jedoch nicht mit type: percent_of_total-Messwerten. Bei diesen Prozentformaten werden Werte mit 100 multipliziert, was die Ergebnisse einer percent_of_total-Berechnung verfälscht.
In diesem Beispiel wird mit LookML der Messwert percent_of_total_gross_margin erstellt, der auf dem Messwert total_gross_margin basiert:
measure: percent_of_total_gross_margin {
  type: percent_of_total
  sql: ${total_gross_margin} ;;
}
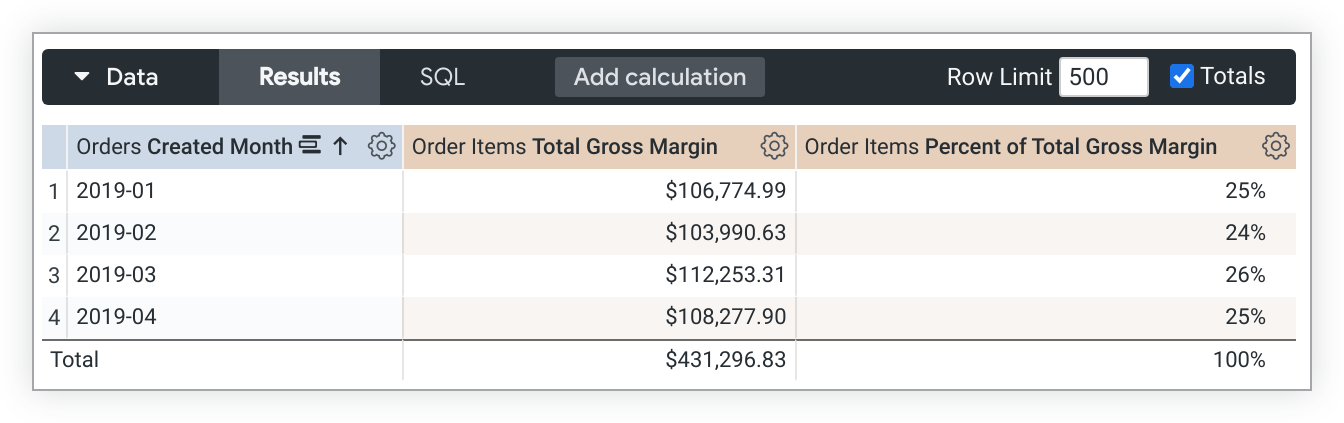
Wenn eine Abfrage pivotiert wird, wird percent_of_total zeilenweise statt spaltenweise ausgeführt. Wenn Sie das nicht möchten, fügen Sie der Definition des Messwerts direction: "column" hinzu.
Außerdem werden percent_of_total-Messwerte berechnet, nachdem Daten aus Ihrer Datenbank zurückgegeben wurden. Das bedeutet, dass Sie nicht auf einen percent_of_total-Messwert in einem anderen Messwert verweisen sollten, da sie möglicherweise zu unterschiedlichen Zeiten berechnet werden und Sie daher keine genauen Ergebnisse erhalten. Außerdem können percent_of_total-Messwerte nicht gefiltert werden.
percentile
type: percentile gibt den Wert am angegebenen Perzentil der Werte in einem bestimmten Feld zurück. Wenn Sie beispielsweise das 75. Perzentil angeben, wird der Wert zurückgegeben, der größer als 75% der anderen Werte im Dataset ist.
Um den zurückzugebenden Wert zu ermitteln, berechnet Looker die Gesamtzahl der Datenwerte und multipliziert das angegebene Perzentil mit der Gesamtzahl der Datenwerte. Unabhängig davon, wie die Daten tatsächlich sortiert sind, identifiziert Looker die relative Reihenfolge der Datenwerte in aufsteigender Reihenfolge. Der von Looker zurückgegebene Datenwert hängt davon ab, ob die Berechnung eine Ganzzahl ergibt oder nicht, wie in den folgenden beiden Abschnitten beschrieben.
Wenn der berechnete Wert keine Ganzzahl ist
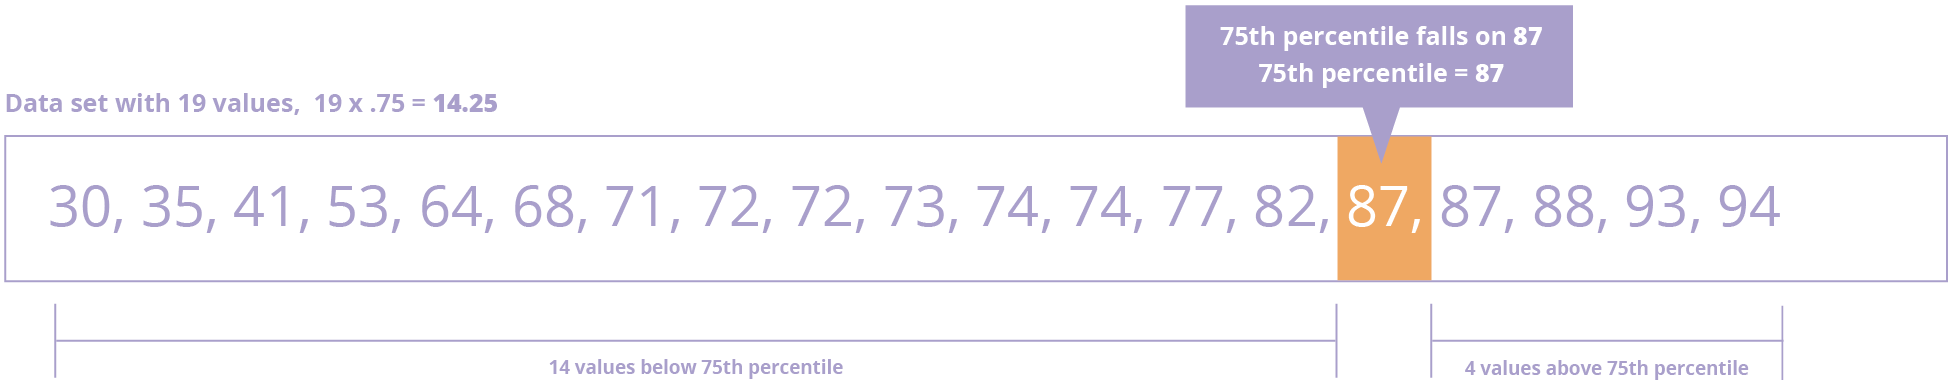
Looker rundet den berechneten Wert auf und verwendet ihn, um den zurückzugebenden Datenwert zu ermitteln. In diesem Beispiel mit 19 Testergebnissen wird das 75. Perzentil durch 19 * 0,75 = 14,25 identifiziert. Das bedeutet, dass 75% der Werte in den ersten 14 Datenwerten liegen, also unter der 15. Position. Daher gibt Looker den 15. Datenwert (87) als größer als 75% der Datenwerte zurück.
Wenn der berechnete Wert eine Ganzzahl ist
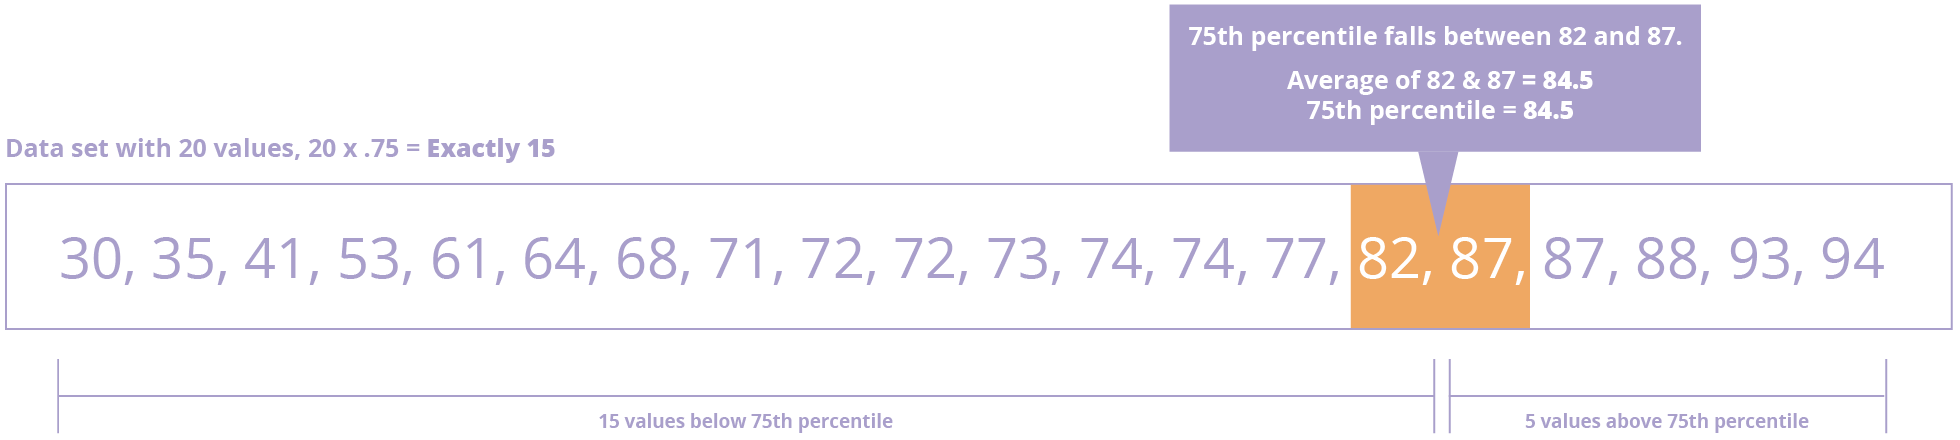
In diesem etwas komplexeren Fall gibt Looker einen Durchschnitt des Datenwerts an dieser Position und des folgenden Datenwerts zurück. Sehen wir uns dazu eine Reihe von 20 Testergebnissen an: Das 75. Perzentil wird durch 20 * 0, 75 = 15 ermittelt. Das bedeutet, dass der Datenwert an der 15. Position zum 75. Perzentil gehört und wir einen Wert zurückgeben müssen, der höher als 75% der Datenwerte ist. Durch die Rückgabe des Durchschnitts der Werte an der 15. Position (82) und der 16. Position (87) stellt Looker sicher, dass 75 % der Werte unter dem Ergebnis liegen. Dieser Durchschnitt (84,5) ist nicht in der Menge der Datenwerte enthalten, wäre aber größer als 75% der Datenwerte.
Erforderliche und optionale Parameter
Mit dem Keyword percentile: geben Sie den Bruchteilswert an, also den Prozentsatz der Daten, der unter dem zurückgegebenen Wert liegen soll. Verwenden Sie beispielsweise percentile: 75, um den Wert am 75. Perzentil in der Reihenfolge der Daten anzugeben, oder percentile: 10, um den Wert am 10. Perzentil zurückzugeben. Wenn Sie den Wert am 50. Perzentil ermitteln möchten, können Sie percentile: 50 angeben oder einfach den Typ median verwenden.
Der Parameter sql für type: percentile-Messwerte kann einen beliebigen gültigen SQL-Ausdruck enthalten, der eine numerische Tabellenspalte, eine LookML-Dimension oder eine Kombination aus LookML-Dimensionen ergibt.
type: percentile-Felder können mit den Parametern value_format oder value_format_name formatiert werden.
Beispiel
Mit dem folgenden LookML-Code wird beispielsweise ein Feld namens test_scores_75th_percentile erstellt, das den Wert des 75. Perzentils in der Dimension test_scores zurückgibt:
measure: test_scores_75th_percentile {
  type: percentile
  percentile: 75
  sql: ${TABLE}.test_scores ;;
}
Wichtige Punkte für percentile
Wenn Sie percentile für ein Feld verwenden, das an einem Fanout beteiligt ist, versucht Looker stattdessen, percentile_distinct zu verwenden. Wenn percentile_distinct für den Dialekt nicht verfügbar ist, gibt Looker einen Fehler zurück. Weitere Informationen finden Sie unter Unterstützte Dialekte für percentile_distinct.
Unterstützte Datenbankdialekte für percentile
Damit Looker den Typ percentile in Ihrem Looker-Projekt unterstützen kann, muss er auch von Ihrem Datenbankdialekt unterstützt werden. In der folgenden Tabelle ist zu sehen, welche Dialekte den Typ percentile in der neuesten Version von Looker unterstützen:
| Dialekt | Unterstützt? |
|---|---|
| Actian Avalanche | |
| Amazon Athena | |
| Amazon Aurora MySQL | |
| Amazon Redshift | |
| Amazon Redshift 2.1+ | |
| Amazon Redshift Serverless 2.1+ | |
| Apache Druid | |
| Apache Druid 0.13.x - 0.17.x | |
| Apache Druid 0.18+ | |
| Apache Hive 2.3+ | |
| Apache Hive 3.1.2+ | |
| Apache Spark 3+ | |
| ClickHouse | |
| ClickHouse 26+ | |
| Cloudera Impala 3.1+ | |
| Cloudera Impala 3.1+ with Native Driver | |
| Cloudera Impala with Native Driver | |
| DataVirtuality | |
| Databricks | |
| Denodo 7 | |
| Denodo 8 & 9 | |
| Dremio | |
| Dremio 11+ | |
| Dremio 26+ with Arrow Flight SQL | |
| Exasol | |
| Google BigQuery Legacy SQL | |
| Google BigQuery Standard SQL | |
| Google Cloud AlloyDB for PostgreSQL | |
| Google Cloud PostgreSQL | |
| Google Cloud SQL | |
| Google Spanner | |
| Greenplum | |
| HyperSQL | |
| IBM Netezza | |
| MariaDB | |
| Microsoft Azure PostgreSQL | |
| Microsoft Azure SQL Database | |
| Microsoft Azure Synapse Analytics | |
| Microsoft SQL Server 2008+ | |
| Microsoft SQL Server 2012+ | |
| Microsoft SQL Server 2016 | |
| Microsoft SQL Server 2017+ | |
| MongoBI | |
| MongoSQL | |
| MySQL | |
| MySQL 8.0.12+ | |
| Oracle | |
| Oracle ADWC | |
| PostgreSQL 9.5+ | |
| PostgreSQL pre-9.5 | |
| PrestoDB | |
| PrestoSQL | |
| SAP HANA | |
| SAP HANA 2+ | |
| SingleStore | |
| SingleStore 7+ | |
| Snowflake | |
| Teradata | |
| Trino | |
| Vector | |
| Vertica |
percentile_distinct
Der type: percentile_distinct ist eine spezielle Form des Perzentils und sollte verwendet werden, wenn Ihr Join einen Fanout umfasst. Dabei werden die nicht wiederholten Werte in einem bestimmten Feld verwendet, die auf den eindeutigen Werten basieren, die durch den Parameter sql_distinct_key definiert werden. Wenn die Messung keinen sql_distinct_key-Parameter hat, versucht Looker, das Feld primary_key zu verwenden.
Sehen Sie sich das Ergebnis einer Abfrage an, bei der die Tabellen „Order Item“ und „Order“ zusammengeführt werden:
| Bestellartikel-ID | Bestell-ID | Bestellversand |
|---|---|---|
| 1 | 1 | 10 |
| 2 | 1 | 10 |
| 3 | 2 | 20 |
| 4 | 3 | 50 |
| 5 | 3 | 50 |
| 6 | 3 | 50 |
| 7 | 4 | 70 |
| 8 | 4 | 70 |
| 9 | 5 | 110 |
| 10 | 5 | 110 |
In diesem Fall gibt es mehrere Zeilen für jede Bestellung. Diese Abfrage beinhaltete ein Fanout, da jede Bestellung mehreren Bestellpositionen zugeordnet ist. Bei percentile_distinct wird dies berücksichtigt und der Perzentilwert wird anhand der eindeutigen Werte 10, 20, 50, 70 und 110 ermittelt. Das 25. Perzentil gibt den zweiten eindeutigen Wert zurück, also 20, während das 80. Perzentil den Durchschnitt des vierten und fünften eindeutigen Werts zurückgibt, also 90.
Erforderliche und optionale Parameter
Verwenden Sie das Keyword percentile:, um den Bruchwert anzugeben. Verwenden Sie beispielsweise percentile: 75, um den Wert am 75. Perzentil in der Reihenfolge der Daten anzugeben, oder percentile: 10, um den Wert am 10. Perzentil zurückzugeben. Wenn Sie den Wert beim 50. Perzentil ermitteln möchten, können Sie stattdessen den Typ median_distinct verwenden.
Um ein genaues Ergebnis zu erhalten, geben Sie mit dem Parameter sql_distinct_key an, wie Looker jede eindeutige Entität (in diesem Fall jede eindeutige Bestellung) identifizieren soll.
Hier ein Beispiel für die Verwendung von percentile_distinct, um den Wert am 90. Perzentil zurückzugeben:
measure: order_shipping_90th_percentile {
  type: percentile_distinct
  percentile: 90
  sql_distinct_key: ${order_id} ;;
  sql: ${order_shipping} ;;
}
Jeder eindeutige Wert von sql_distinct_key darf nur einen entsprechenden Wert im Parameter sql des Messwerts haben. Anders gesagt: Das Beispiel oben funktioniert, weil jede Zeile mit dem order_id-Wert 1 denselben order_shipping-Wert 10 hat und jede Zeile mit dem order_id-Wert 2 denselben order_shipping-Wert 20 hat.
type: percentile_distinct-Felder können mit den Parametern value_format oder value_format_name formatiert werden.
Wichtige Punkte für percentile_distinct
Wenn percentile_distinct für den Dialekt nicht verfügbar ist, gibt Looker einen Fehler zurück. Weitere Informationen finden Sie unter Unterstützte Dialekte für percentile_distinct.
Unterstützte Datenbankdialekte für percentile_distinct
Damit Looker den Typ percentile_distinct in Ihrem Looker-Projekt unterstützen kann, muss er auch von Ihrem Datenbankdialekt unterstützt werden. In der folgenden Tabelle ist zu sehen, welche Dialekte den Typ percentile_distinct in der aktuellen Version von Looker unterstützen:
| Dialekt | Unterstützt? |
|---|---|
| Actian Avalanche | |
| Amazon Athena | |
| Amazon Aurora MySQL | |
| Amazon Redshift | |
| Amazon Redshift 2.1+ | |
| Amazon Redshift Serverless 2.1+ | |
| Apache Druid | |
| Apache Druid 0.13.x - 0.17.x | |
| Apache Druid 0.18+ | |
| Apache Hive 2.3+ | |
| Apache Hive 3.1.2+ | |
| Apache Spark 3+ | |
| ClickHouse | |
| ClickHouse 26+ | |
| Cloudera Impala 3.1+ | |
| Cloudera Impala 3.1+ with Native Driver | |
| Cloudera Impala with Native Driver | |
| DataVirtuality | |
| Databricks | |
| Denodo 7 | |
| Denodo 8 & 9 | |
| Dremio | |
| Dremio 11+ | |
| Dremio 26+ with Arrow Flight SQL | |
| Exasol | |
| Google BigQuery Legacy SQL | |
| Google BigQuery Standard SQL | |
| Google Cloud AlloyDB for PostgreSQL | |
| Google Cloud PostgreSQL | |
| Google Cloud SQL | |
| Google Spanner | |
| Greenplum | |
| HyperSQL | |
| IBM Netezza | |
| MariaDB | |
| Microsoft Azure PostgreSQL | |
| Microsoft Azure SQL Database | |
| Microsoft Azure Synapse Analytics | |
| Microsoft SQL Server 2008+ | |
| Microsoft SQL Server 2012+ | |
| Microsoft SQL Server 2016 | |
| Microsoft SQL Server 2017+ | |
| MongoBI | |
| MongoSQL | |
| MySQL | |
| MySQL 8.0.12+ | |
| Oracle | |
| Oracle ADWC | |
| PostgreSQL 9.5+ | |
| PostgreSQL pre-9.5 | |
| PrestoDB | |
| PrestoSQL | |
| SAP HANA | |
| SAP HANA 2+ | |
| SingleStore | |
| SingleStore 7+ | |
| Snowflake | |
| Teradata | |
| Trino | |
| Vector | |
| Vertica |
period_over_period
Für Dialekte, die periodenübergreifende Messwerte unterstützen, können Sie einen LookML-Messwert vom Typ type: period_over_period erstellen, um einen periodenübergreifenden Messwert zu erstellen. Ein PoP-Messwert bezieht sich auf eine Aggregation aus einem früheren Zeitraum.
Hier ist ein Beispiel für eine PoP-Messung, die die Anzahl der Bestellungen des Vormonats liefert:
  measure: orders_last_month {
    type: period_over_period
    based_on: orders.count
    based_on_time: orders.created_month
    period: month
    kind: previous
  }
Messwerte mit type: period_over_period müssen auch die folgenden Unterparameter haben:
based_onbased_on_timekindperiododer, wenn Sie die PoP-Messung auf einem benutzerdefinierten Kalender basieren,custom_calendar_period
Weitere Informationen und Beispiele finden Sie unter Periodenübergreifende Messwerte in Looker.
running_total
type: running_total berechnet eine kumulative Summe der Zellen in einer Spalte. Sie kann nicht verwendet werden, um Summen entlang einer Zeile zu berechnen, es sei denn, die Zeile ist das Ergebnis einer Pivotierung.
Der Parameter sql für type: running_total-Messwerte muss auf einen anderen numerischen Messwert verweisen.
type: running_total-Felder können mit den Parametern value_format oder value_format_name formatiert werden.
Im folgenden LookML-Beispiel wird das Messwert-cumulative_total_revenue auf Grundlage des Messwerts total_sale_price erstellt:
measure: cumulative_total_revenue {
  type: running_total
  sql: ${total_sale_price} ;;
  value_format_name: usd
}
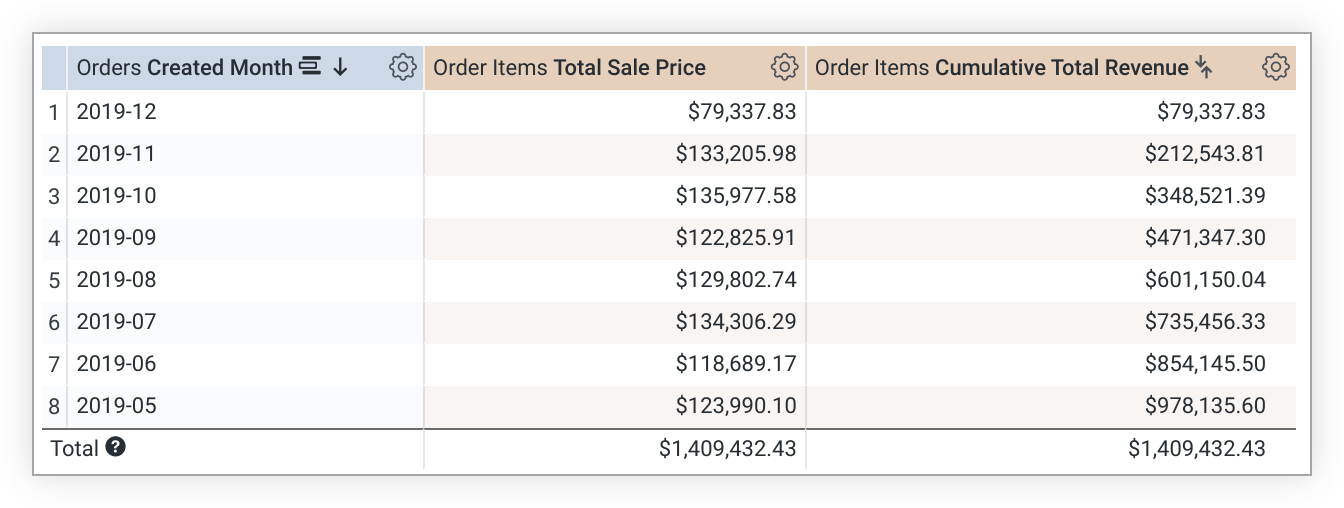
Die Werte für running_total hängen von der Sortierreihenfolge ab. Wenn Sie die Sortierung ändern, müssen Sie die Abfrage noch einmal ausführen, um die running_total-Werte neu zu berechnen. Wenn eine Abfrage pivotiert wird, wird running_total über die Zeile anstatt über die Spalte ausgeführt. Wenn das nicht Ihren Vorstellungen entspricht, fügen Sie der Messwertdefinition direction: "column" hinzu.
Außerdem werden running_total-Messwerte berechnet, nachdem Daten aus Ihrer Datenbank zurückgegeben wurden. Das bedeutet, dass Sie nicht innerhalb eines anderen Measures auf ein running_total-Measure verweisen sollten. Da sie zu unterschiedlichen Zeiten berechnet werden können, erhalten Sie möglicherweise keine genauen Ergebnisse. Das bedeutet auch, dass running_total-Messwerte nicht gefiltert werden können.
string
type: string wird für Felder verwendet, die Buchstaben oder Sonderzeichen enthalten.
Der Parameter sql für type: string-Messwerte kann jeden gültigen SQL-Ausdruck annehmen, der einen String ergibt. In der Praxis wird dieser Typ selten verwendet, da die meisten SQL-Aggregatfunktionen keine Strings zurückgeben. Eine häufige Ausnahme ist die GROUP_CONCAT-Funktion von MySQL. Looker bietet jedoch type: list für diesen Anwendungsfall.
Mit dem folgenden LookML-Code wird beispielsweise ein Feld category_list erstellt, indem die eindeutigen Werte eines Felds mit dem Namen category kombiniert werden:
measure: category_list {
  type: string
  sql: GROUP_CONCAT(${category}) ;;
}
In diesem Beispiel könnte type: string weggelassen werden, da string der Standardwert für type ist.
sum
type: sum addiert die Werte in einem bestimmten Feld. Sie ähnelt der SQL-Funktion SUM. Anders als bei rohem SQL berechnet Looker Summen jedoch auch dann richtig, wenn die Joins Ihrer Abfrage Fanouts enthalten.
Der Parameter sql für type: sum-Messwerte kann einen beliebigen gültigen SQL-Ausdruck enthalten, der eine numerische Tabellenspalte, eine LookML-Dimension oder eine Kombination aus LookML-Dimensionen ergibt.
type: sum-Felder können mit den Parametern value_format oder value_format_name formatiert werden.
Mit dem folgenden LookML-Code wird beispielsweise ein Feld namens total_revenue erstellt, indem die Dimension sales_price addiert wird. Anschließend wird es im Währungsformat ($1.234,56) angezeigt:
measure: total_revenue {
  type: sum
  sql: ${sales_price} ;;
  value_format_name: usd
}
sum_distinct
type: sum_distinct ist für die Verwendung mit denormalisierten Datasets vorgesehen. Dabei werden die nicht wiederholten Werte in einem bestimmten Feld addiert, basierend auf den eindeutigen Werten, die durch den Parameter sql_distinct_key definiert sind.
Dies ist ein fortgeschrittenes Konzept, das sich am besten anhand eines Beispiels erklären lässt. Betrachten Sie eine denormalisierte Tabelle wie diese:
| Artikel-ID des Bestellpostens | Bestell-ID | Bestellversand |
|---|---|---|
| 1 | 1 | 10,00 |
| 2 | 1 | 10,00 |
| 3 | 2 | 20,00 |
| 4 | 2 | 20,00 |
| 5 | 2 | 20,00 |
In diesem Fall gibt es mehrere Zeilen für jede Bestellung. Wenn Sie also einen type: sum-Messwert für die Spalte order_shipping hinzufügen, erhalten Sie insgesamt 80,00, obwohl die gesamten Versandkosten tatsächlich 30,00 betragen.
 # Will NOT calculate the correct shipping amount
measure: total_shipping {
  type: sum
  sql: ${order_shipping} ;;
}
Damit Sie ein genaues Ergebnis erhalten, können Sie in Looker mit dem Parameter sql_distinct_key definieren, wie jede eindeutige Einheit (in diesem Fall jede eindeutige Bestellung) identifiziert werden soll. Damit wird der korrekte Betrag von 30,00 berechnet:
 # Will calculate the correct shipping amount
measure: total_shipping {
  type: sum_distinct
  sql_distinct_key: ${order_id} ;;
  sql: ${order_shipping} ;;
}
Jeder eindeutige Wert von sql_distinct_key darf nur einen entsprechenden Wert in sql haben. Anders gesagt: Das Beispiel oben funktioniert, weil jede Zeile mit einer order_id von 1 dieselbe order_shipping von 10,00 hat und jede Zeile mit einer order_id von 2 dieselbe order_shipping von 20,00 hat.
type: sum_distinct-Felder können mit den Parametern value_format oder value_format_name formatiert werden.
yesno
type: yesno erstellt ein Feld, das angibt, ob etwas wahr oder falsch ist. Die Werte werden in der Explore-Benutzeroberfläche als Ja und Nein angezeigt.
Der Parameter sql für einen type: yesno-Messwert akzeptiert einen gültigen SQL-Ausdruck, der als TRUE oder FALSE ausgewertet wird. Wenn die Bedingung als TRUE ausgewertet wird, wird dem Nutzer Ja angezeigt, andernfalls Nein.
Der SQL-Ausdruck für type: yesno-Messwerte darf nur Aggregationen enthalten, d. h. SQL-Aggregationen oder Verweise auf LookML-Messwerte. Wenn Sie ein yesno-Feld erstellen möchten, das einen Verweis auf eine LookML-Dimension oder einen SQL-Ausdruck enthält, der keine Aggregation ist, verwenden Sie eine Dimension mit type: yesno und keinen Messwert.
Ähnlich wie bei Messungen mit type: number werden bei einer Messung mit type: yesno keine Aggregationen durchgeführt. Es wird nur auf andere Aggregationen verwiesen.
Das folgende Beispiel für den total_sale_price-Messwert ist beispielsweise eine Summe des Gesamtverkaufspreises von Bestellartikeln in einer Bestellung. Ein zweiter Messwert namens is_large_total ist type: yesno. Der Measure is_large_total hat einen sql-Parameter, mit dem geprüft wird, ob der total_sale_price-Wert größer als 1.000 € ist.
measure: total_sale_price {
  type: sum
  value_format_name: usd
  sql: ${sale_price} ;;
  drill_fields: [detail*]
}
measure: is_large_total {
  description: "Is order total over $1000?"
  type: yesno
  sql: ${total_sale_price} > 1000 ;;
}
Wenn Sie in einem anderen Feld auf ein type: yesno-Feld verweisen möchten, sollten Sie das type: yesno-Feld als booleschen Wert behandeln, d. h. so, als ob es bereits einen „true“- oder „false“-Wert enthält. Beispiel:
measure: is_large_total {
  description: "Is order total over $1000?"
  type: yesno
  sql: ${total_sale_price} > 1000 ;;
}
# This is correct:
measure: reward_points {
  type: number
  sql: CASE WHEN ${is_large_total} THEN 200 ELSE 100 END ;;
}
# This is NOT correct:
measure: reward_points {
  type: number
  sql: CASE WHEN ${is_large_total} = 'Yes' THEN 200 ELSE 100 END ;;
}