

Use o Knative serving para gerenciar automaticamente a infraestrutura necessária para hospedar softwares no Google Kubernetes Engine (GKE). Para gerenciar seus aplicativos, o Knative serving usa uma estrutura organizacional chamada modelo de recurso. Esse modelo de recurso consiste em três partes principais: serviços, revisões e instâncias de contêiner.
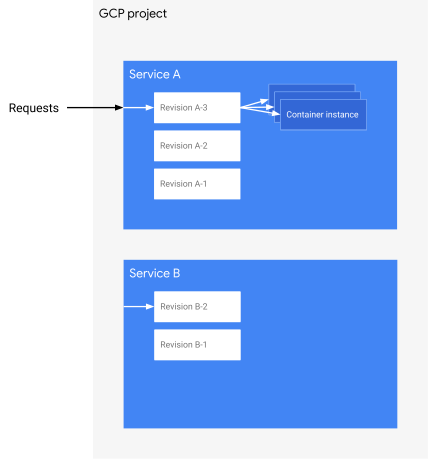
O diagrama a seguir ilustra esses componentes e as interações deles: um Google Cloud projeto contém dois serviços do Knative serving, o Serviço A e o Serviço B, cada um com várias revisões. O Serviço A está processando solicitações com várias instâncias de contêiner em execução, enquanto o Serviço B está inativo.
Serviços do Knative serving
O serviço é o principal recurso do Knative serving. Cada serviço está localizado em um namespace de cluster do GKE específico.
Um determinado Google Cloud projeto pode executar muitos serviços em diferentes regiões ou clusters do GKE.
Cada serviço expõe um endpoint exclusivo e escalona automaticamente a infraestrutura subjacente para manipular solicitações de entrada.
Revisões do Knative serving
Cada implantação em um serviço cria uma revisão. que consiste em uma imagem de contêiner específica, com configurações de ambiente, como variáveis de ambiente, limites de memória ou valor de simultaneidade.
As revisões são imutáveis: depois que uma revisão é criada, ela não pode ser modificada. Por exemplo, quando você implanta uma imagem de contêiner em um novo serviço do Knative serving, a primeira revisão é criada. Se em seguida você implantar uma imagem de contêiner diferente no mesmo serviço, uma segunda revisão será criada. Se, depois, você definir uma variável de ambiente, uma terceira revisão será criada. Cada mudança de configuração subsequente cria uma nova revisão.
As solicitações são roteadas automaticamente o quanto antes para a última revisão de serviço íntegra. É possível dividir o tráfego entre diferentes revisões conforme necessário.
Instâncias de contêiner do Knative serving
Cada solicitação de recebimento de revisão é escalonada automaticamente para o número de instâncias de contêiner necessárias para lidar com todas essas solicitações. Observe que uma instância de contêiner pode receber muitas solicitações ao mesmo tempo. Com a configuração de simultaneidade, é possível definir o número máximo de solicitações que podem ser enviadas em paralelo a uma determinada instância de contêiner.